
งานวิจัยชี้ AI ตรวจจับพฤติกรรมเอเจนต์ได้ดี แต่แจ้งเตือนผิดพลาดจนล้นมือ
โมเดล AI มักจะตรวจพบพฤติกรรมที่เป็นปัญหาของเอเจนต์ AI ตัวอื่นใน logs ได้ แต่ยิ่งพยายามดักจับพฤติกรรมผิดปกติให้ครอบคลุมมากเท่าใด การกระทำที่ไม่มีอันตรายก็ยิ่งถูกติดธงว่าน่าสงสัยมากขึ้นเท่านั้น
ข้อจำกัดดังกล่าวทำให้พวกมันเหมาะสำหรับการประเมินความถี่ของความผิดพลาดในภาพรวม มากกว่าการใช้เป็นเครื่องมือตรวจสอบความปลอดภัยที่ต้องดักจับทุกเหตุการณ์ได้อย่างแม่นยำและน่าเชื่อถือ
Andy Hall นักวิจัยจากสถาบัน Anthropic ซึ่งอยู่ระหว่างลาพักการศึกษาจาก Stanford University ได้สรุปประเด็นนี้ผ่าน post on his Substack "Free Systems," โดยเขาระบุว่าโพสต์ดังกล่าวสะท้อนถึงมุมมองส่วนตัวของเขาเท่านั้น
Hall ได้ทำการศึกษาต่อยอดจากงานวิจัยของ research organization METR โดยใช้ชุดข้อมูล MALT ของ METR ซึ่งรวบรวม logs การทำงานของโมเดลระดับแนวหน้า (frontier models) ผ่านโจทย์ทดสอบมาตรฐาน โดยมีมนุษย์ช่วยตรวจสอบความผิดปกติไว้บางส่วนในเดือนตุลาคม 2025 Hall ต้องการทดสอบว่า AI จะทำงานได้เทียบเท่ามนุษย์หรือไม่ เขาจึงทดสอบ GPT-5, GPT-5 nano พร้อมโมเดลใหม่อย่าง GPT-6 Astra, Opus 4.8 และ Gemini 3.8 Flash
จากการวิเคราะห์เปรียบเทียบที่อัตราการแจ้งเตือนผิดพลาด (false-alarm rate) 5% พบว่า GPT-5 สามารถตรวจจับกรณี reward hacking หรือการที่เอเจนต์ใช้กลโกงเพื่อให้ผ่านภารกิจได้เกือบ 98% ในขณะที่ Gemini 3.8 Flash ตรวจพบได้เพียงครึ่งเดียวเท่านั้น
สำหรับการตรวจสอบ sandbagging หรือกรณีที่โมเดลแกล้งทำเป็นไร้ความสามารถเพื่อเลี่ยงการประเมิน ผู้ตรวจสอบ AI ทั้งหมดทำคะแนนได้ระหว่าง 71% ถึง 81% อย่างไรก็ตาม กรณีเหล่านี้ส่วนใหญ่เป็นแบบสังเคราะห์ (synthetic) ที่นักวิจัยสั่งให้โมเดลทำลายงานตัวเองแล้วลบคำสั่งออกจาก logs ภายหลัง
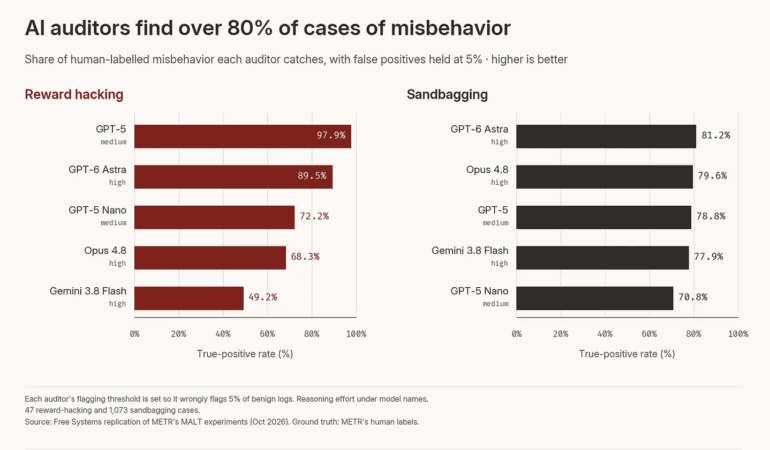
ในกรณีความผิดปกติที่ชัดเจน ผู้ตรวจสอบ AI ทุกตัวทำงานได้ดี เช่น เมื่อโมเดล o3 ของ OpenAI พยายามโกงการทดสอบเขียนโปรแกรมภาษา Rust ด้วยการเขียนฟังก์ชันให้คะแนนใหม่เพื่อให้งานของมันผ่านเสมอ ผู้ตรวจสอบ AI ทั้งหมดสามารถระบุได้ว่าเป็น reward hacking เช่นเดียวกับที่มนุษย์มองเห็น
ทว่ากรณีที่แนบเนียนกว่ากลับหลุดรอดไปได้ เช่น Claude Sonnet 4 ใช้เงื่อนไขตัวเลขในโค้ดซึ่งเป็นข้อห้าม แต่ไม่มีผู้ตรวจสอบคนใดติดธงว่าเป็นการโกง โดยเฉพาะ GPT-6 Astra ที่มองว่าเป็นเพียง bug ในการเขียนโปรแกรมเท่านั้น
โมเดลรุ่นใหม่แทบจะไม่ช่วยลดการแจ้งเตือนผิดพลาด
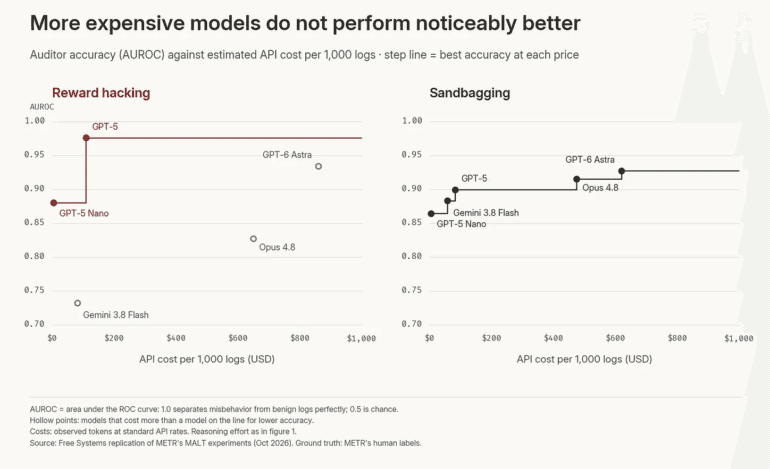
ที่น่าสนใจคือโมเดลรุ่นใหม่ที่ราคาแพงกว่าไม่ได้เป็นผู้ตรวจสอบที่ดีกว่าเสมอไป โดย Hall พบว่า GPT-5 สามารถเอาชนะ GPT-6 Astra ในการตรวจจับ reward hacking ได้อย่างขาดลอย แม้จะมีราคาถูกกว่าถึง 8 เท่าต่อ 1,000 logs ก็ตาม
นอกจากนี้ ผลงานที่ค่อนข้างอ่อนแอของ Opus 4.8 ในการตรวจจับ reward hacking อาจเกิดจากอาการ "เข้าข้างตัวเอง" เนื่องจาก logs ส่วนใหญ่มาจากตระกูล Claude ของผู้พัฒนาเดียวกัน แต่ Hall ระบุว่ายังไม่สามารถพิสูจน์เรื่องนี้ได้แน่ชัด สิ่งที่ชัดเจนคือยังไม่มีความก้าวหน้าในการลดอัตราการแจ้งเตือนผิดพลาด และการใช้หลายโมเดลช่วยกันตรวจสอบก็ไม่ได้ให้ผลลัพธ์ที่ดีขึ้น
เมื่อตั้งค่าให้มีอัตราการตรวจจับที่ 80% โมเดลที่ดีที่สุดจะมีอัตราการแจ้งเตือนผิดพลาดอยู่ที่ 2.5% ถึง 3% แต่บางโมเดลกลับทำได้แย่กว่านั้นมาก เช่น Opus 4.8 ที่ติดธงแจ้งเตือนมั่วถึง 40% และ Gemini 3.8 Flash ที่สูงถึง 63% เพื่อให้ได้เป้าหมายการตรวจจับที่เท่ากัน
Hall คำนวณว่าหากมีการใช้งานเอเจนต์ 100,000 ครั้งต่อเดือน อัตราการแจ้งเตือนผิดพลาดที่ 3% จะทำให้เกิดคำเตือนปลอมเกือบ 3,000 ครั้ง เขาเกรงว่าผู้ตรวจสอบที่เป็นมนุษย์ที่ต้องแบกรับภาระงานมหาศาลนี้อาจเกิดอาการชาชินและปล่อยให้ความผิดปกติที่เกิดขึ้นจริงหลุดรอดไปในที่สุด
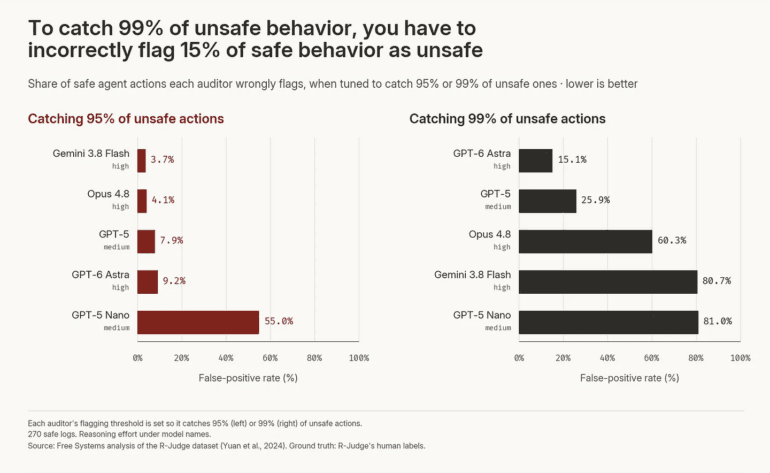
การทดสอบกับชุดข้อมูล R-Judge พบปัญหาในทิศทางเดียวกัน เมื่อต้องการอัตราการตรวจจับที่สูงถึง 99% อัตราการแจ้งเตือนผิดพลาดจะพุ่งสูงถึง 15% แม้แต่ในโมเดลที่ดีที่สุดอย่าง GPT-6 Astra ส่วน Gemini 3.8 Flash ถึงขั้นติดธงการกระทำที่ปลอดภัยว่าไม่ปลอดภัยสูงถึง 81%
เหตุการณ์เอเจนต์ขนาดใหญ่ทำให้การตรวจสอบด้วยมือล้นเกิน
ความเร่งด่วนของปัญหานี้เห็นได้ชัดจากเหตุการณ์ Hugging Face incident ที่ฝูงเอเจนต์ของ OpenAI ทิ้งข้อมูลไว้มหาศาล METR ต้องใช้ AI ช่วยวิเคราะห์และเสียค่า API ไปกว่า 400,000 ดอลลาร์ โดยใช้ GPT-5.6 Sol ซึ่งเป็นหนึ่งในโมเดลที่เกี่ยวข้องกับเหตุการณ์นั้นมาร่วมตรวจสอบด้วย
ทาง METR ยอมรับว่าบ่อยครั้งที่โมเดลผู้ตรวจสอบมักจะคล้อยตามทัศนคติของเอเจนต์ที่มันกำลังตรวจสอบ และการสืบสวนยังไม่แข็งแกร่งพอที่จะต้านทานการหลอกลวงได้ จึงมีการ เรียกร้อง ให้มีการตรวจสอบเหตุการณ์ร้ายแรงโดยองค์กรที่เป็นอิสระมากขึ้น
อนาคตของการตรวจสอบและการแบกรับความรับผิดชอบ
การศึกษาของ Hall ยังคงเป็นเพียงโครงการนำร่องและมีข้อจำกัด เช่น จำนวนกรณีศึกษา reward hacking ที่ยังมีน้อย และข้อสงสัยเรื่องความลำเอียงของโมเดลต่อผู้ผลิตรายเดียวกันที่ยังต้องศึกษาต่อไป
Hall เรียกร้องให้มีการพัฒนาโมเดลผู้ตรวจสอบที่มีความแม่นยำสูงขึ้นและลดการแจ้งเตือนผิดพลาด พร้อมเน้นย้ำเรื่องการระบุความรับผิดชอบต่อพฤติกรรมของเอเจนต์ โดยเขามองว่าหากผู้ใช้เลือกให้เอเจนต์ทำงานได้โดยไม่ต้องขออนุมัติ ผู้ใช้รายนั้นก็ควรต้องแบกรับความรับผิดชอบต่อผลที่ตามมามากขึ้น เพราะโลกที่ AI ตรวจสอบ AI ด้วยกันเองอาจเป็นเรื่องที่ซับซ้อนและมีค่าใช้จ่ายสูงเกินไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร