AI ตัดสินความใหม่ของงานวิจัยได้ดีแค่ไหน? เจาะลึก benchmark ล่าสุดtag: Ai2, Claude Opus, GPT-5, LLMs, Novelty Judge, Research InnovationOct 27, 2026 · By: SirilukPสรุปข่าว 1:25Ai2 เปิดตัวโครงการ Old Ideas, Novel Problems เพื่อศึกษาความเชื่อถือได้ของ LLMs ในการประเมินความแปลกใหม่ของไอเดียงานวิจัย พบผลตัดสินผันผวนหนักแม้เปลี่ยนคำสั่งเพียงเล็กน้อย
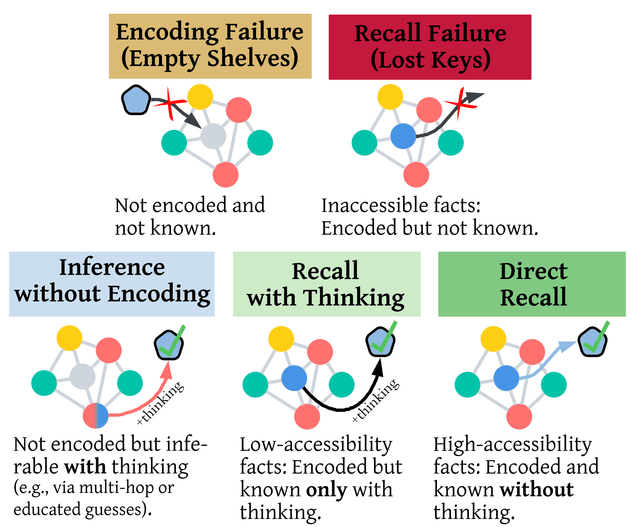
ชั้นวางว่างหรือกุญแจหาย? งานวิจัยเผย 'การระลึกข้อมูล' คือคอขวดสำคัญของความถูกต้องใน LLMstag: Chain of Thought, Gemini, GPT-5, Large Language Models, WikiProfileAug 13, 2026 · By: AttapolKงานวิจัยใหม่ชี้ให้เห็นว่าข้อผิดพลาดทางข้อเท็จจริงใน LLMs ระดับแนวหน้าส่วนใหญ่ไม่ได้เกิดจากการขาดความรู้ แต่เกิดจากความไม่สามารถเข้าถึงข้อมูลที่ถูกบันทึกไว้ในพารามิเตอร์แล้วได้
เผย OpenAI เคยจัดระดับความเสี่ยง GPT-5 ไว้สูงสุด หลังพบผู้ใช้หลายร้อยรายขอสูตรผลิตยาพิษและอาวุธชีวภาพtag: AI Safety, Biosecurity, GPT-5, OpenAI, Wall Street JournalJul 26, 2026 · By: AttapolKเอกสารภายในเผย OpenAI เผชิญความกังวลด้านความปลอดภัยเมื่อ GPT-5 ให้คำแนะนำขั้นตอนการผลิตสารพิษแก่ผู้ใช้ ก่อนจะมีการปรับลดระดับความเสี่ยงลงในภายหลัง