
ชั้นวางว่างหรือกุญแจหาย? งานวิจัยเผย 'การระลึกข้อมูล' คือคอขวดสำคัญของความถูกต้องใน LLMs
ความถูกต้องตามข้อเท็จจริง (Factuality) เป็นหัวใจสำคัญของความน่าเชื่อถือในโมเดลภาษาขนาดใหญ่ (LLMs) เมื่อโมเดลตอบคำถามผิด คำถามสำคัญคือเป็นเพราะข้อเท็จจริงนั้นไม่เคยถูกบันทึก (encoded) ไว้ หรือเป็นเพราะบันทึกไว้แล้วแต่ไม่สามารถดึงออกมาใช้ได้? มาตรวัดความแม่นยำในปัจจุบันมักรวมสองประเด็นนี้เข้าด้วยกัน ทั้งที่วิธีแก้ไขต่างกันอย่างสิ้นเชิง ความล้มเหลวในการบันทึกข้อมูล (Encoding failures) แก้ได้ด้วยการขยายขนาดโมเดล แต่ความล้มเหลวในการระลึกข้อมูล (Recall failures) ต้องใช้การปรับปรุงกระบวนการดึงข้อมูลมาใช้
ในงานวิจัย “Empty Shelves or Lost Keys? Recall Is the Bottleneck for Parametric Factuality” ทีมวิจัยได้นำเสนอ knowledge profiling กรอบการทำงานที่ใช้วัดทั้งการเข้ารหัส (encoding) และการระลึกข้อมูล (recall) เพื่อตรวจสอบคอขวดของความถูกต้องใน LLMs ระดับโลกอย่าง Gemini3 และ GPT-5 ผลการศึกษาพบว่าข้อผิดพลาดส่วนใหญ่ในโมเดลเหล่านี้เปรียบได้กับการ “หากุญแจไม่เจอ” มากกว่า “ชั้นวางของว่างเปล่า”
ทีมวิจัยเปรียบเทียบคำนิยามสามส่วนคือ encoding หมายถึงการแทนค่าข้อเท็จจริงในพารามิเตอร์, recall คือการดึงข้อมูลออกมาโดยไม่มีตัวช่วย และ recognition คือการจำแนกข้อเท็จจริงที่ถูกต้องจากตัวเลือก พร้อมทั้งเปิดตัว WikiProfile ชุดทดสอบข้อเท็จจริง 2,150 รายการจาก Wikipedia เพื่อตรวจสอบสถานะความรู้ของโมเดลอย่างละเอียด
แนวคิดหลัก: การทำโปรไฟล์ความรู้ (Knowledge profiling)
Knowledge profiling เปลี่ยนมุมมองจากการตรวจคำตอบรายข้อ มาเป็นการวิเคราะห์สถานะของข้อเท็จจริง โดยจำแนกออกเป็น 5 โปรไฟล์: (1) ความล้มเหลวในการเข้ารหัส, (2) ความล้มเหลวในการระลึกข้อมูล, (3) การระลึกข้อมูลได้โดยตรง, (4) การระลึกข้อมูลด้วยการคิด และ (5) การอนุมานโดยไม่มีการเข้ารหัส ซึ่งช่วยให้ระบุปัญหาได้แม่นยำกว่าการดูแค่ค่าความแม่นยำรวม
การจำแนกประเภทนี้ขึ้นอยู่กับว่าโมเดลเข้าถึงข้อเท็จจริงได้ระดับใด ตั้งแต่ระลึกไม่ได้เลย ไปจนถึงต้องใช้กระบวนการ “คิด” (thinking) ผ่านเทคนิคอย่าง chain-of-thought หรือการใช้ thinking-optimized LLMs เพื่อช่วยในการประมวลผล
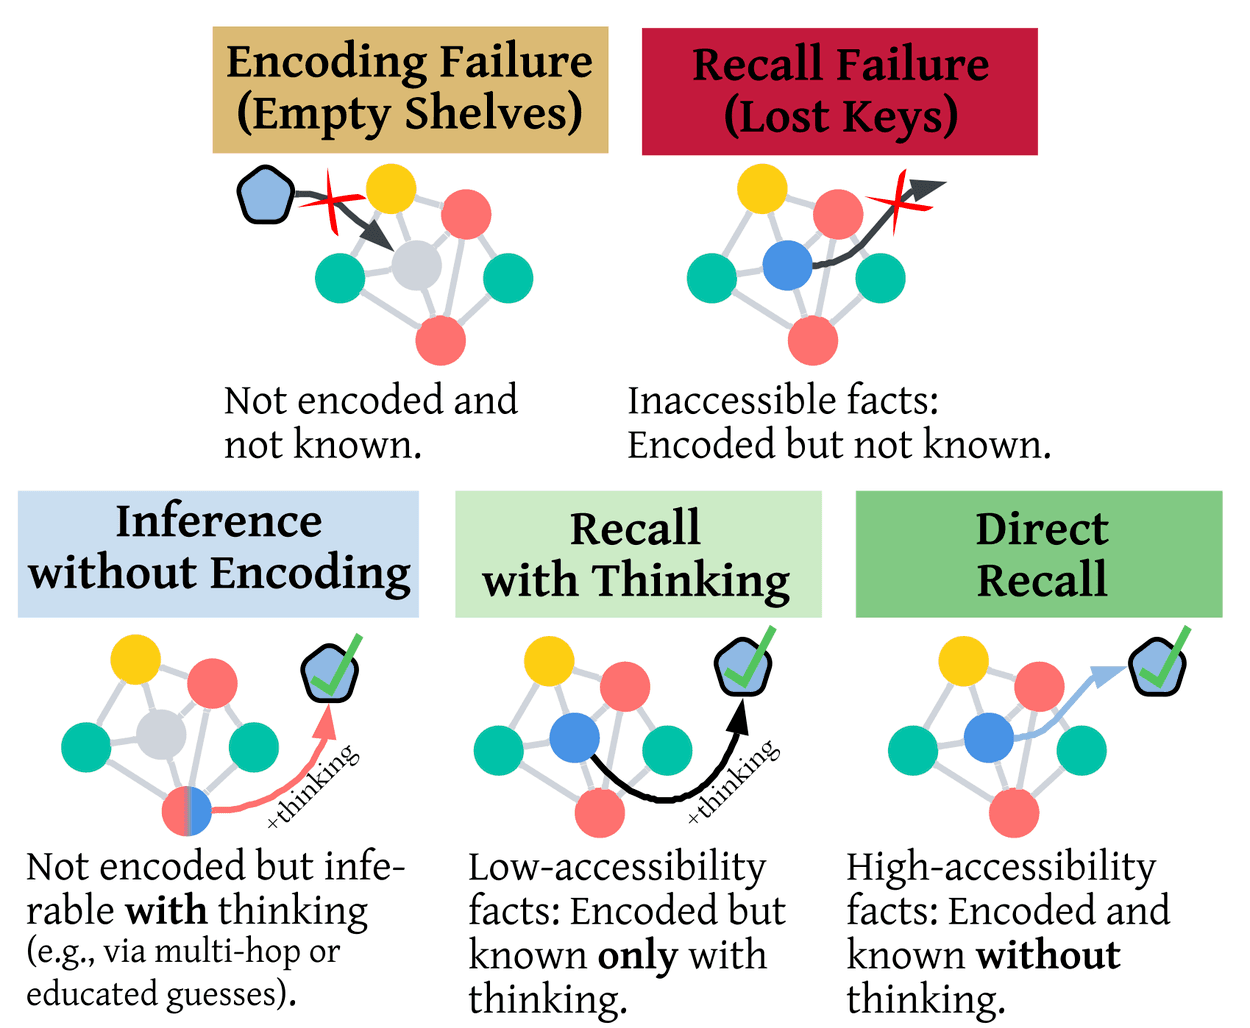
ห้าโปรไฟล์ความรู้ที่ระบุลักษณะของข้อเท็จจริง
ทีมวิจัยวัดผลผ่านนิยามเชิงพฤติกรรม 3 ด้าน:
- การเข้ารหัส (Encoding): โมเดลสร้างข้อเท็จจริงซ้ำในบริบทเดิมได้ผ่านการ กระตุ้น (priming)
- ความรู้ (Knowledge): โมเดลตอบคำถามที่มีความหมายเหมือนกันได้ทั้งแบบตรงและ ย้อนกลับ (reverse)
- การระลึกข้อมูล (Recall): โมเดลเข้าถึงสิ่งที่บันทึกไว้ได้โดยไม่ต้องใช้ตัวช่วยภายนอก
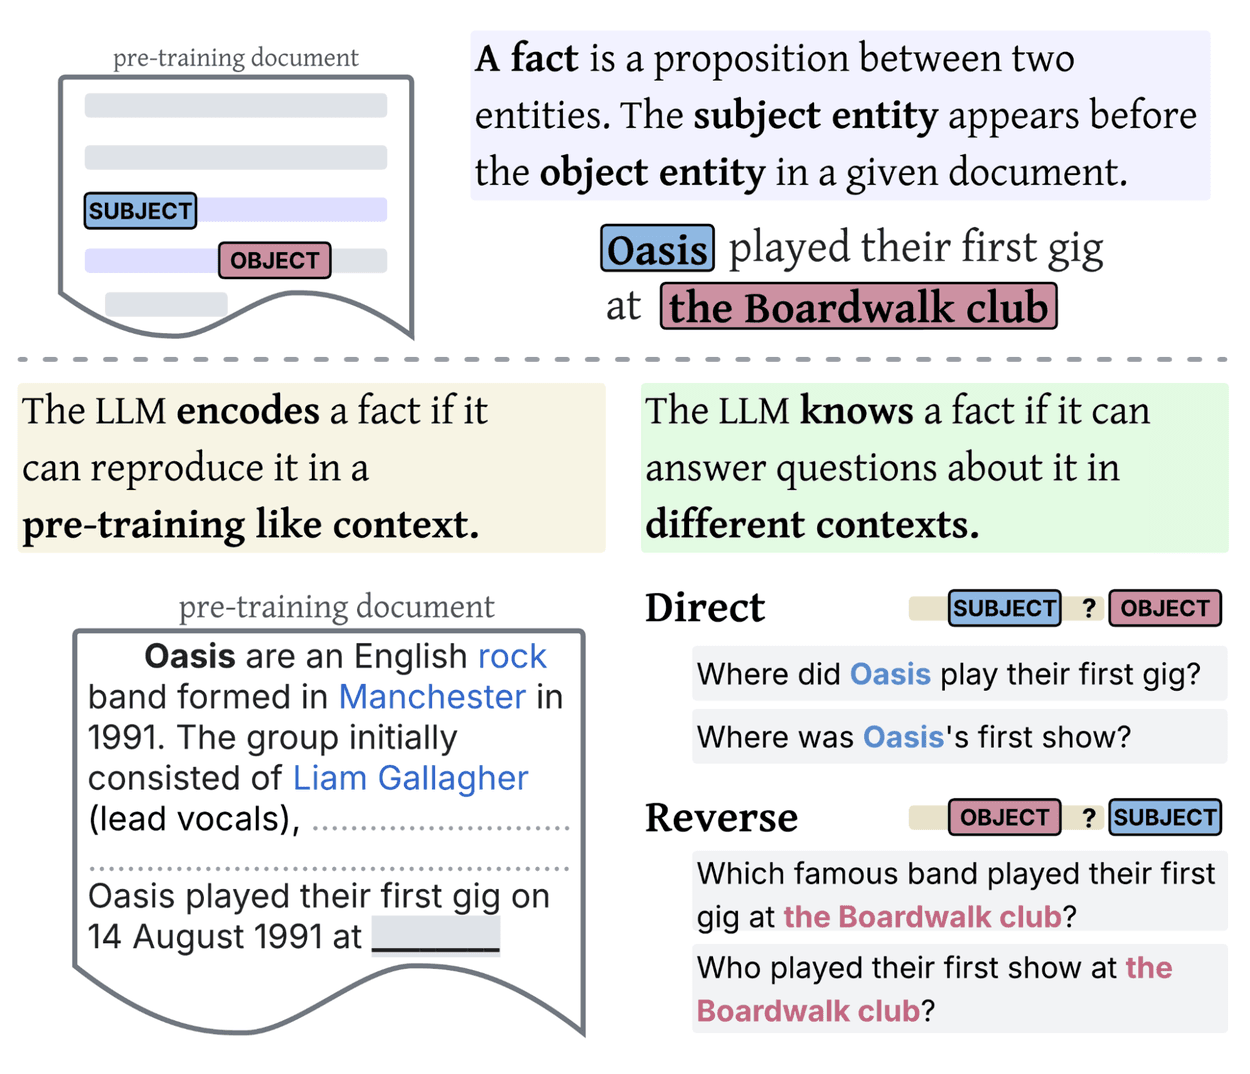
บน: ดึงข้อเท็จจริงจาก Wikipedia แหล่งข้อมูลหลักในการฝึกฝนโมเดล ซ้าย: วัดการเข้ารหัสโดยให้สร้างข้อเท็จจริงซ้ำในบริบทเดิม ขวา: วัดความรู้ด้วยคำถามที่หลากหลายทั้งแบบมีการคิดและไม่มีการคิด
ขอแนะนำ WikiProfile
WikiProfile ถูกสร้างขึ้นด้วยระบบอัตโนมัติที่ขับเคลื่อนโดย Gemini-2.5-Pro เพื่อวัดความถูกต้องตามธรรมชาติ โดยสกัดข้อเท็จจริงจาก Wikipedia และจับคู่กับงาน 10 ประเภท ทั้งการเติมประโยค การตอบคำถาม และการเลือกตอบ
คำถามทั้งหมดผ่านกระบวนการสร้าง ปรับปรุง และกรอง 3 ขั้นตอน เพื่อให้มั่นใจว่ามีความชัดเจนและมีคำตอบที่ถูกต้องเพียงหนึ่งเดียวเท่านั้น โดยมีการตรวจสอบข้ามกับ search engine และการตรวจทานด้วยมนุษย์จนได้ข้อเท็จจริงที่สมบูรณ์ 2,150 รายการ เพื่อใช้ประเมิน LLMs ทั้ง 13 รุ่น
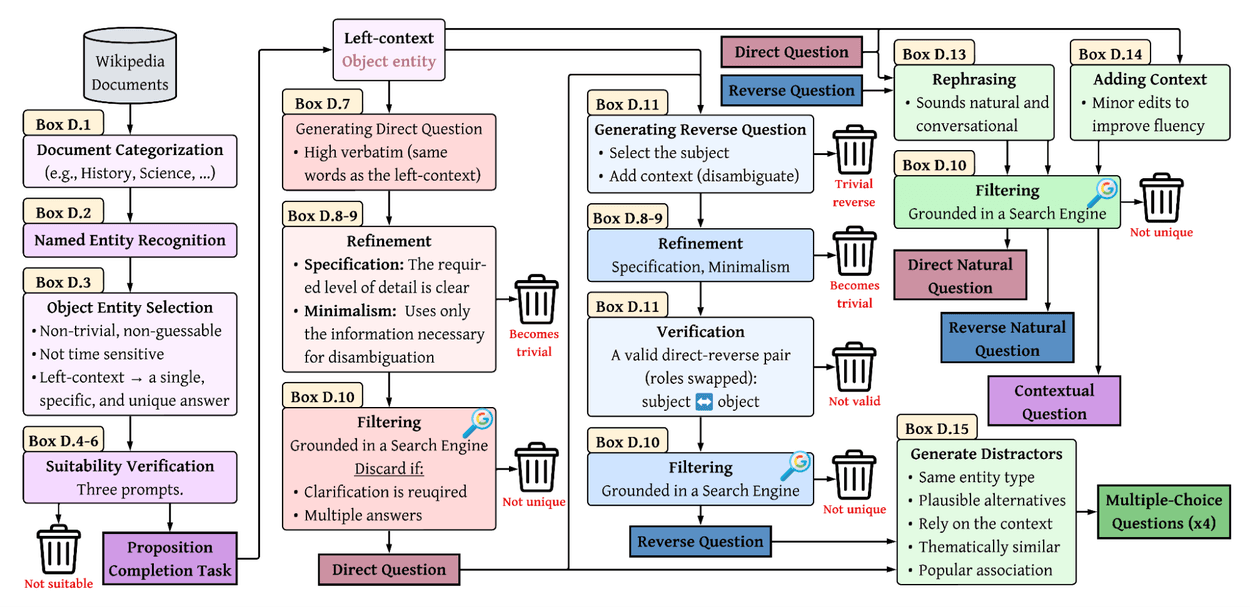
กระบวนการสร้างชุดทดสอบ WikiProfile โดยอัตโนมัติ
ผลลัพธ์หลัก: การระลึกข้อมูลคือคอขวดที่แท้จริง
ในโมเดลระดับท็อปอย่าง Gemini-3-Pro และ GPT-5 พบว่าการเข้ารหัสข้อมูลทำได้เกือบสมบูรณ์ (95–98%) แต่ยังคงประสบปัญหาในการระลึกข้อมูลโดยตรงถึง 26–34% และแม้จะเปิดโหมดการคิด ก็ยังพลาดอยู่ 11–12% นี่พิสูจน์ว่าปัญหาไม่ได้อยู่ที่โมเดลไม่มีความรู้ แต่อยู่ที่โมเดลเข้าถึงสิ่งที่รู้อย่างไม่เสถียร
การขยายขนาดโมเดล (Scaling) แม้จะช่วยให้บันทึกข้อมูลได้มากขึ้น แต่ปัญหาการระลึกข้อมูลยังคงมีอยู่ในสัดส่วนที่สูง การเพิ่มขนาดจึงเป็นการปรับปรุง “สิ่งที่เก็บไว้” ได้ดีกว่าการปรับปรุง “สิ่งที่ดึงออกมาใช้”
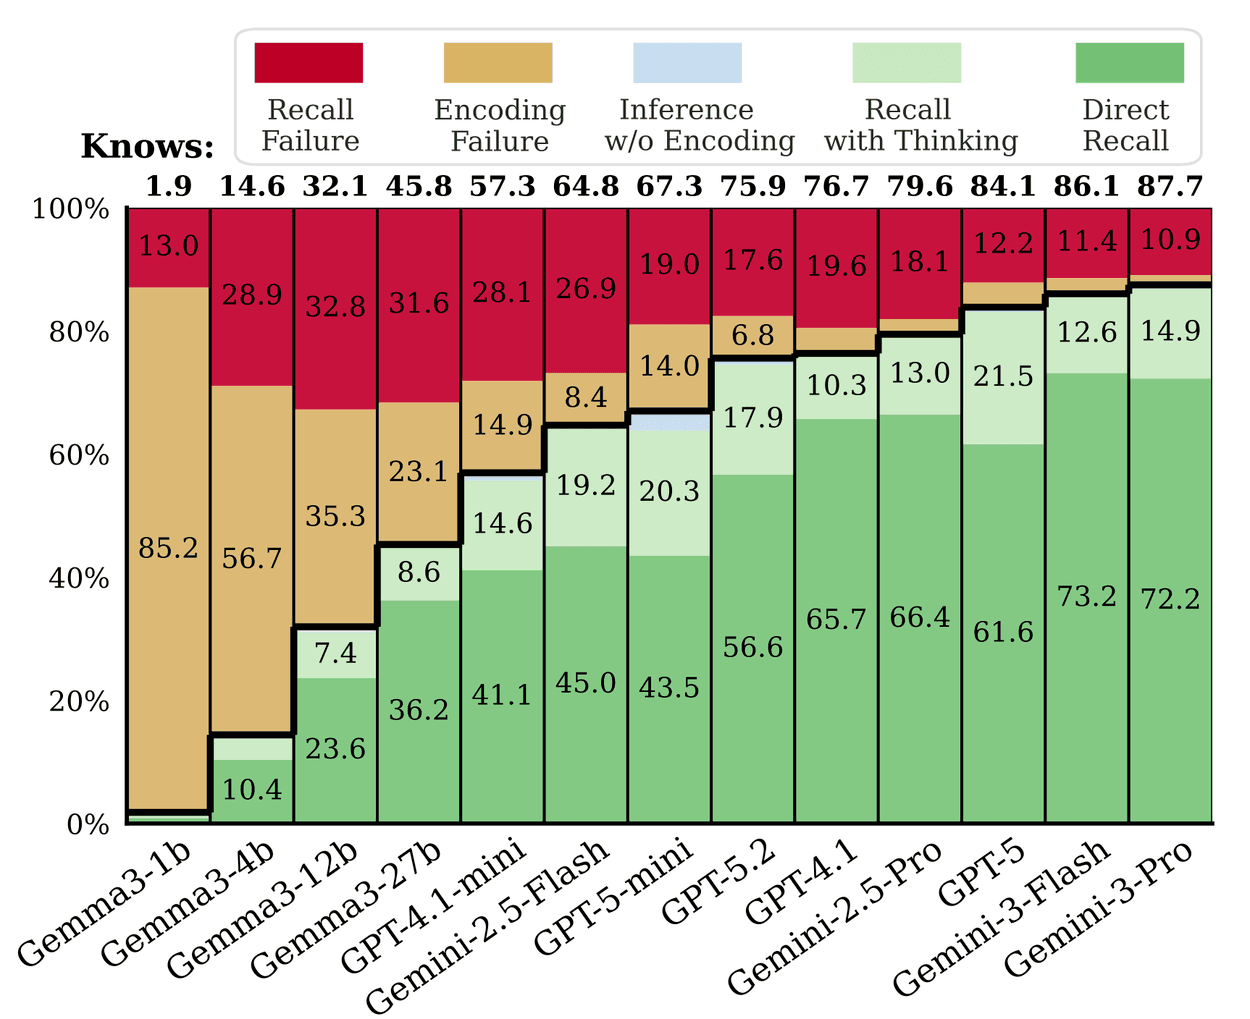
การกระจายโปรไฟล์ความรู้ใน LLMs 13 รุ่น พบว่าความล้มเหลวในการเข้ารหัสลดลงตามขนาด แต่การระลึกข้อมูลยังเป็นปัญหาแม้ในโมเดลใหญ่
ทำไมการระลึกข้อมูลจึงล้มเหลว?
ปัญหาการระลึกข้อมูลมักเกิดขึ้นเมื่อคำถามมีรูปแบบต่างจากสิ่งที่โมเดลเคยพบในช่วงฝึกฝน โดยเฉพาะในสองกรณีสำคัญ:
- ข้อเท็จจริงที่พบยาก (Long-tail): ข้อเท็จจริงเหล่านี้ถูกบันทึกไว้ในพารามิเตอร์เกือบเท่ากับข้อเท็จจริงยอดนิยม แต่กลับดึงออกมาใช้ได้ยากกว่ามาก
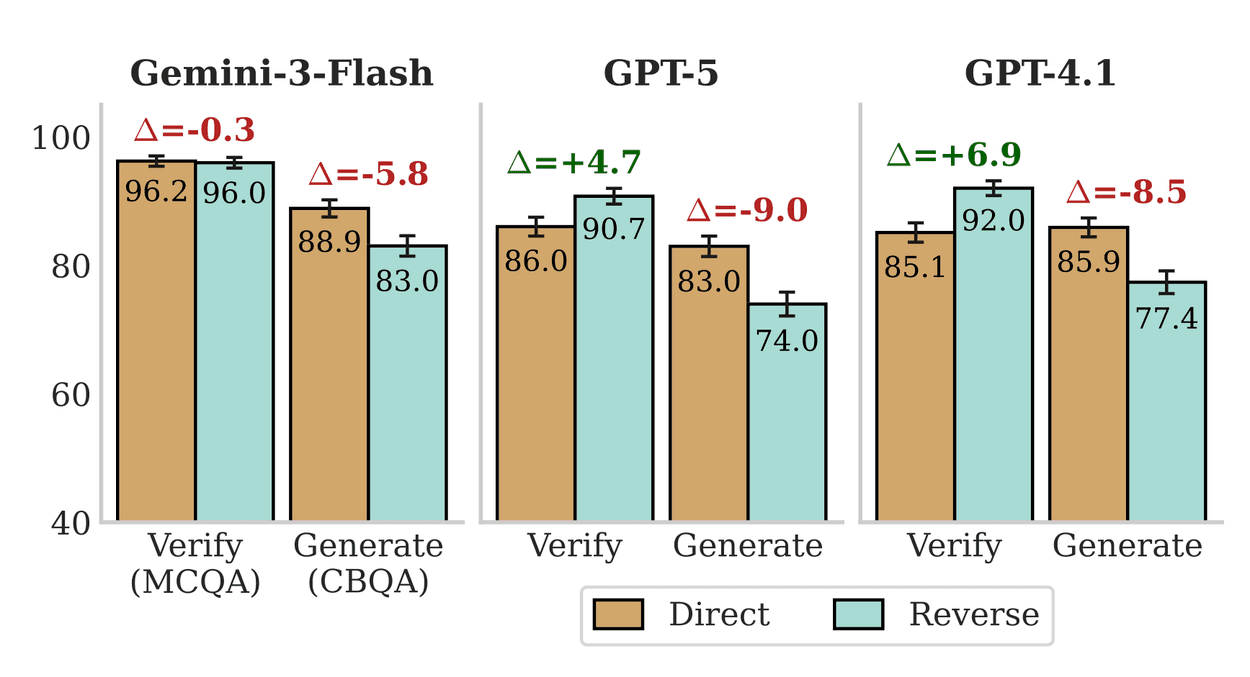
- คำสาปของการย้อนกลับ (Reversal Curse): โมเดลที่รู้ว่า "A คือ B" แต่มักตอบไม่ได้ว่า "B คืออะไร" ในรูปแบบการเขียน แต่หากเปลี่ยนเป็นข้อสอบแบบเลือกตอบ (Recognition) โมเดลจะตอบได้แม่นยำขึ้น ชี้ให้เห็นว่าข้อมูลถูกเก็บไว้แต่ติดปัญหาเรื่องทิศทางการดึงข้อมูล
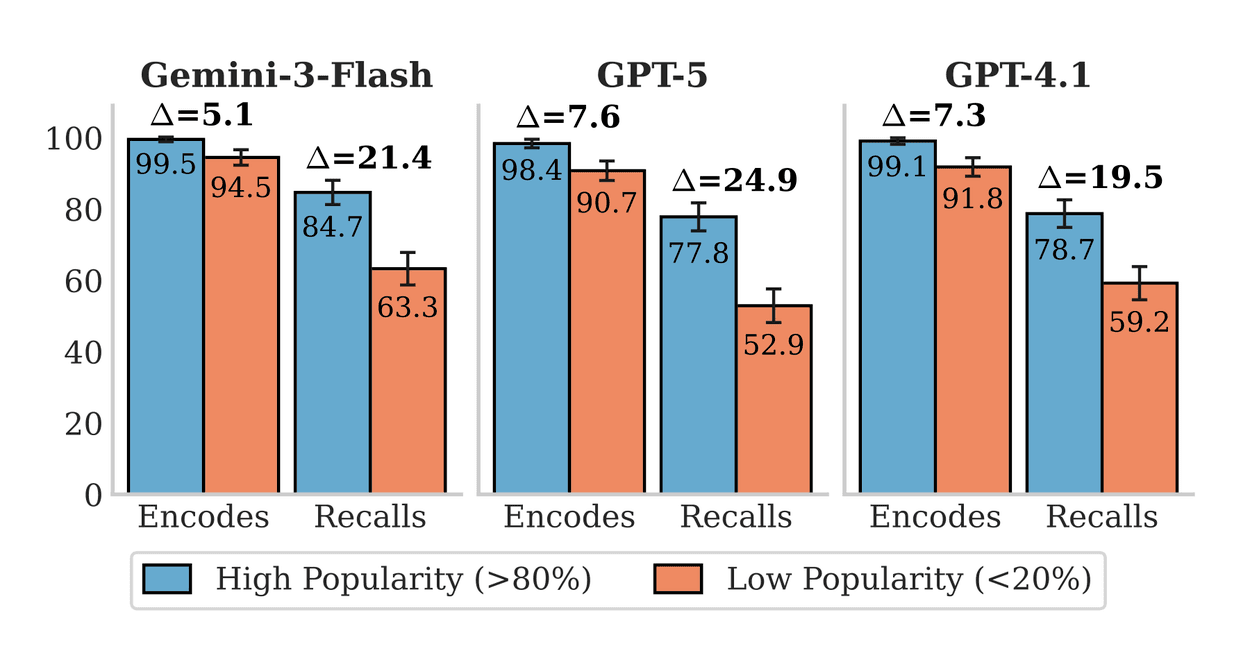
ช่องว่างระหว่างการเข้ารหัสข้อเท็จจริงที่นิยมและไม่นิยมนั้นแคบ แต่ช่องว่างในการระลึกข้อมูลกลับกว้างมาก
การคิดในฐานะกลไกการกู้คืนข้อมูล
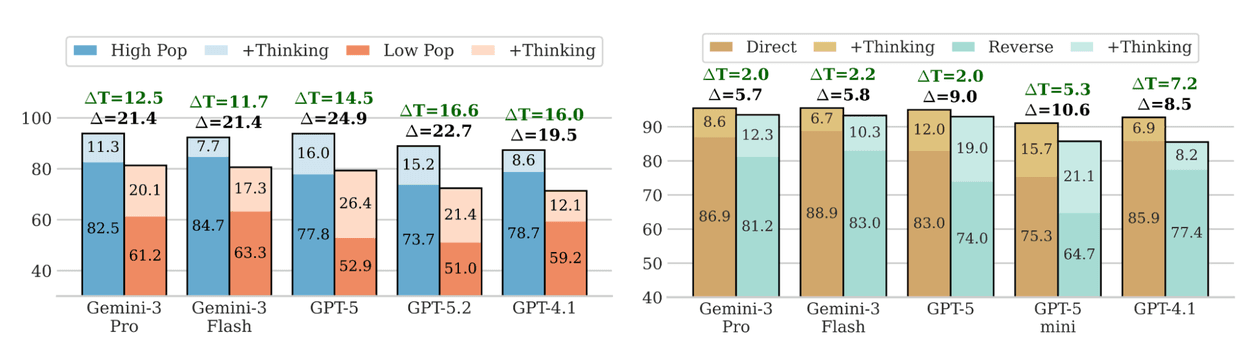
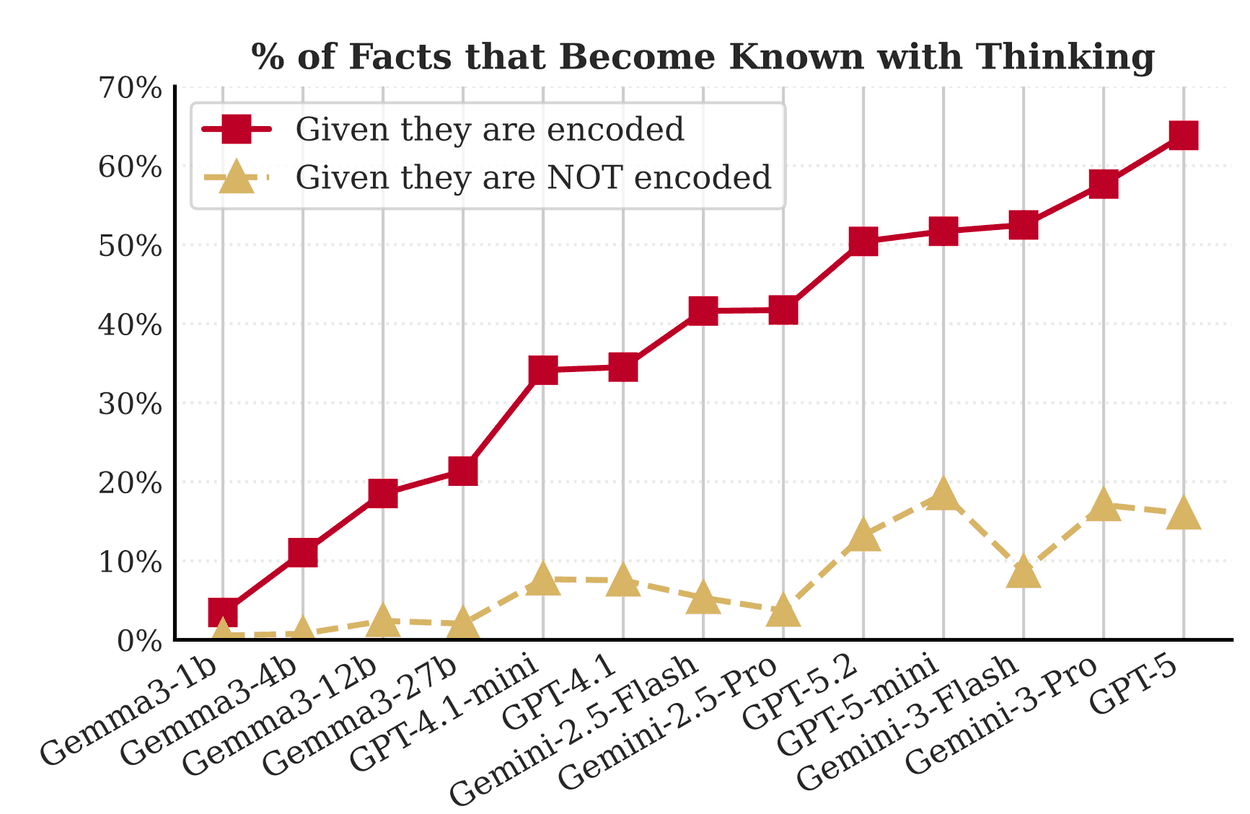
การให้โมเดลมีขั้นตอน "คิด" ก่อนตอบ ช่วยปรับปรุงการระลึกข้อมูลได้อย่างเห็นผล โดยเฉพาะกับข้อเท็จจริงที่พบยากและคำถามแบบย้อนกลับ ในโมเดลที่ปรับแต่งมาเพื่อการคิด (Thinking-optimized) กระบวนการนี้ช่วยกู้คืนข้อมูลที่บันทึกไว้ได้ถึง 40–65% แต่แทบไม่ช่วยเลยหากข้อมูลนั้นไม่ได้ถูกบันทึกไว้ตั้งแต่แรก (Encoding failure)
การคิดช่วยกู้คืนข้อเท็จจริงที่เข้ารหัสไว้ได้สูงถึง 40–65% ในขณะที่ช่วยข้อเท็จจริงที่ไม่เคยเข้ารหัสได้เพียงเล็กน้อย
บทสรุป
งานวิจัย Knowledge profiling ชี้ให้เห็นว่าการพัฒนา LLMs ในอนาคตอาจไม่ต้องพึ่งพาเพียงการเพิ่มขนาดโมเดลหรือข้อมูลอีกต่อไป เพราะคอขวดปัจจุบันอยู่ที่ “การนำความรู้มาใช้” การพัฒนาเทคนิคที่ช่วยให้โมเดลเข้าถึงสิ่งที่มันรู้อยู่แล้วได้ดียิ่งขึ้น จะเป็นกุญแจสำคัญสู่ความถูกต้องที่สูงขึ้นของปัญญาประดิษฐ์
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร