
AI ตัดสินความใหม่ของงานวิจัยได้ดีแค่ไหน? เจาะลึก benchmark ล่าสุด
วันนี้เรากำลังเปิดตัว Old Ideas, Novel Problems ซึ่งเป็นการศึกษาใหม่ว่าโมเดลภาษาขนาดใหญ่ (LLMs) สามารถประเมินความแปลกใหม่ของไอเดียงานวิจัยทางวิทยาศาสตร์ได้น่าเชื่อถือเพียงใด นอกเหนือจากตัวงานวิจัยแล้ว เรายังเผยแพร่ benchmark ข้อมูล และ code สำหรับการทดสอบตัวตัดสินความแปลกใหม่ (novelty judges) พร้อมด้วย pipeline อัตโนมัติให้นักวิจัยใช้สร้างชุดประเมินใหม่ๆ ได้
ที่ Ai2 เราพัฒนาระบบ AI สนับสนุนการค้นพบทางวิทยาศาสตร์ในหลายส่วน ได้แก่ DataVoyager สำหรับวิเคราะห์ข้อมูล, AutoDiscovery สร้างและทดสอบสมมติฐาน และ Theorizer สังเคราะห์วรรณกรรมเป็นทฤษฎี เมื่อรวมกับ Asta โปรเจกต์เหล่านี้ชี้ให้เห็นถึงระบบที่ช่วยนักวิจัยก้าวจากการทำความเข้าใจงานเก่าไปสู่การนำเสนอและปรับปรุงไอเดียใหม่ๆ
แต่การสร้างไอเดียงานวิจัยเป็นเพียงส่วนหนึ่งของความท้าทาย ระบบเหล่านี้ต้องแยกแยะได้ว่าทิศทางใดแปลกใหม่จริง หรือเป็นเพียงการนำงานเดิมมาเรียบเรียงใหม่ ซึ่งหน้าที่นี้มักถูกส่งต่อให้ LLM อีกตัวที่เรียกว่า novelty judge เป็นผู้ประเมินเปรียบเทียบกับงานในอดีต
ปัจจุบันยังไม่มีมาตรฐานในการสร้างระบบนี้ ทีมวิจัยมักเลือกใช้รุ่นโมเดล prompt และงบประมาณการให้เหตุผล (reasoning budget) ที่แตกต่างกัน ซึ่งส่งผลต่อคำตัดสินอย่างมาก ที่น่ากังวลคือตัวตัดสินเหล่านี้มักถูกตรวจสอบความถูกต้องกับงานวิจัยที่เขียนโดยมนุษย์ มากกว่าไอเดียที่สร้างโดย AI ซึ่งเป็นเป้าหมายที่ควรจะประเมินจริงๆ
ผลลัพธ์จาก benchmark ใหม่ชี้ว่าการประเมินความแปลกใหม่ยังห่างไกลจากความน่าเชื่อถือ จากการทดสอบ LLM judges 6 รุ่น ได้แก่ GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5 และ Claude Opus 4.6 พบว่าการเปลี่ยนแปลงเพียงเล็กน้อยในการตั้งค่าทำให้ผลตัดสินต่างกันมหาศาล
ในการทดลองหนึ่ง การเปลี่ยนคำใน prompt เพียงไม่กี่คำทำให้ความแม่นยำในการระบุไอเดียที่แปลกใหม่กว่าเปลี่ยนแปลงไปกว่า 50 เปอร์เซ็นต์ point ขณะที่การใช้ระบบดึงข้อมูล (retrieval) และการเพิ่มการให้เหตุผลไม่ได้ช่วยให้ผลลัพธ์ดีขึ้นอย่างสม่ำเสมอ แถมระบบที่สร้างขึ้นเฉพาะทางบางระบบยังทำงานได้แย่กว่า Claude Opus 4.6 ที่ใช้ prompt แบบง่ายๆ เสียอีก
การสร้าง benchmark สำหรับตัวตัดสินความแปลกใหม่
เราสร้าง pipeline อัตโนมัติโดยใช้การตรวจทานผลงาน (peer reviews) จาก ICLR 2026 เพื่อหาหลักฐานความคิดริเริ่มที่ชัดเจน แทนการดูแค่การตอบรับตีพิมพ์ โดยเราคัดเลือกไอเดียงานวิจัย 154 รายการจากกลุ่มที่ได้รับการยอมรับสูงสุด 10% แรกที่ผู้รีวิวชื่นชมเรื่องความใหม่เป็น กลุ่มความแปลกใหม่สูง (high-novelty pool)
ในทางกลับกัน เราคัดอีก 145 ไอเดียจากงานที่ถูกปฏิเสธในกลุ่ม 10% ล่างสุดซึ่งผู้รีวิวระบุว่าขาดความคิดริเริ่มเป็น กลุ่มความแปลกใหม่ต่ำ (lower-novelty pool) ชุดข้อมูลนี้เรียกว่า Human-Only นอกจากนี้เรายังสร้างชุด Human+Generated โดยนำไอเดียของมนุษย์ไปเปรียบเทียบกับไอเดียที่สร้างโดย LLM generator แบบพื้นฐาน ซึ่งผู้เชี่ยวชาญยืนยันว่าไอเดียจาก AI ในกลุ่มนี้ไม่มีความแปลกใหม่เลย
การเปลี่ยนแปลงเล็กน้อยสามารถสร้างคำตัดสินที่แตกต่างกันมาก
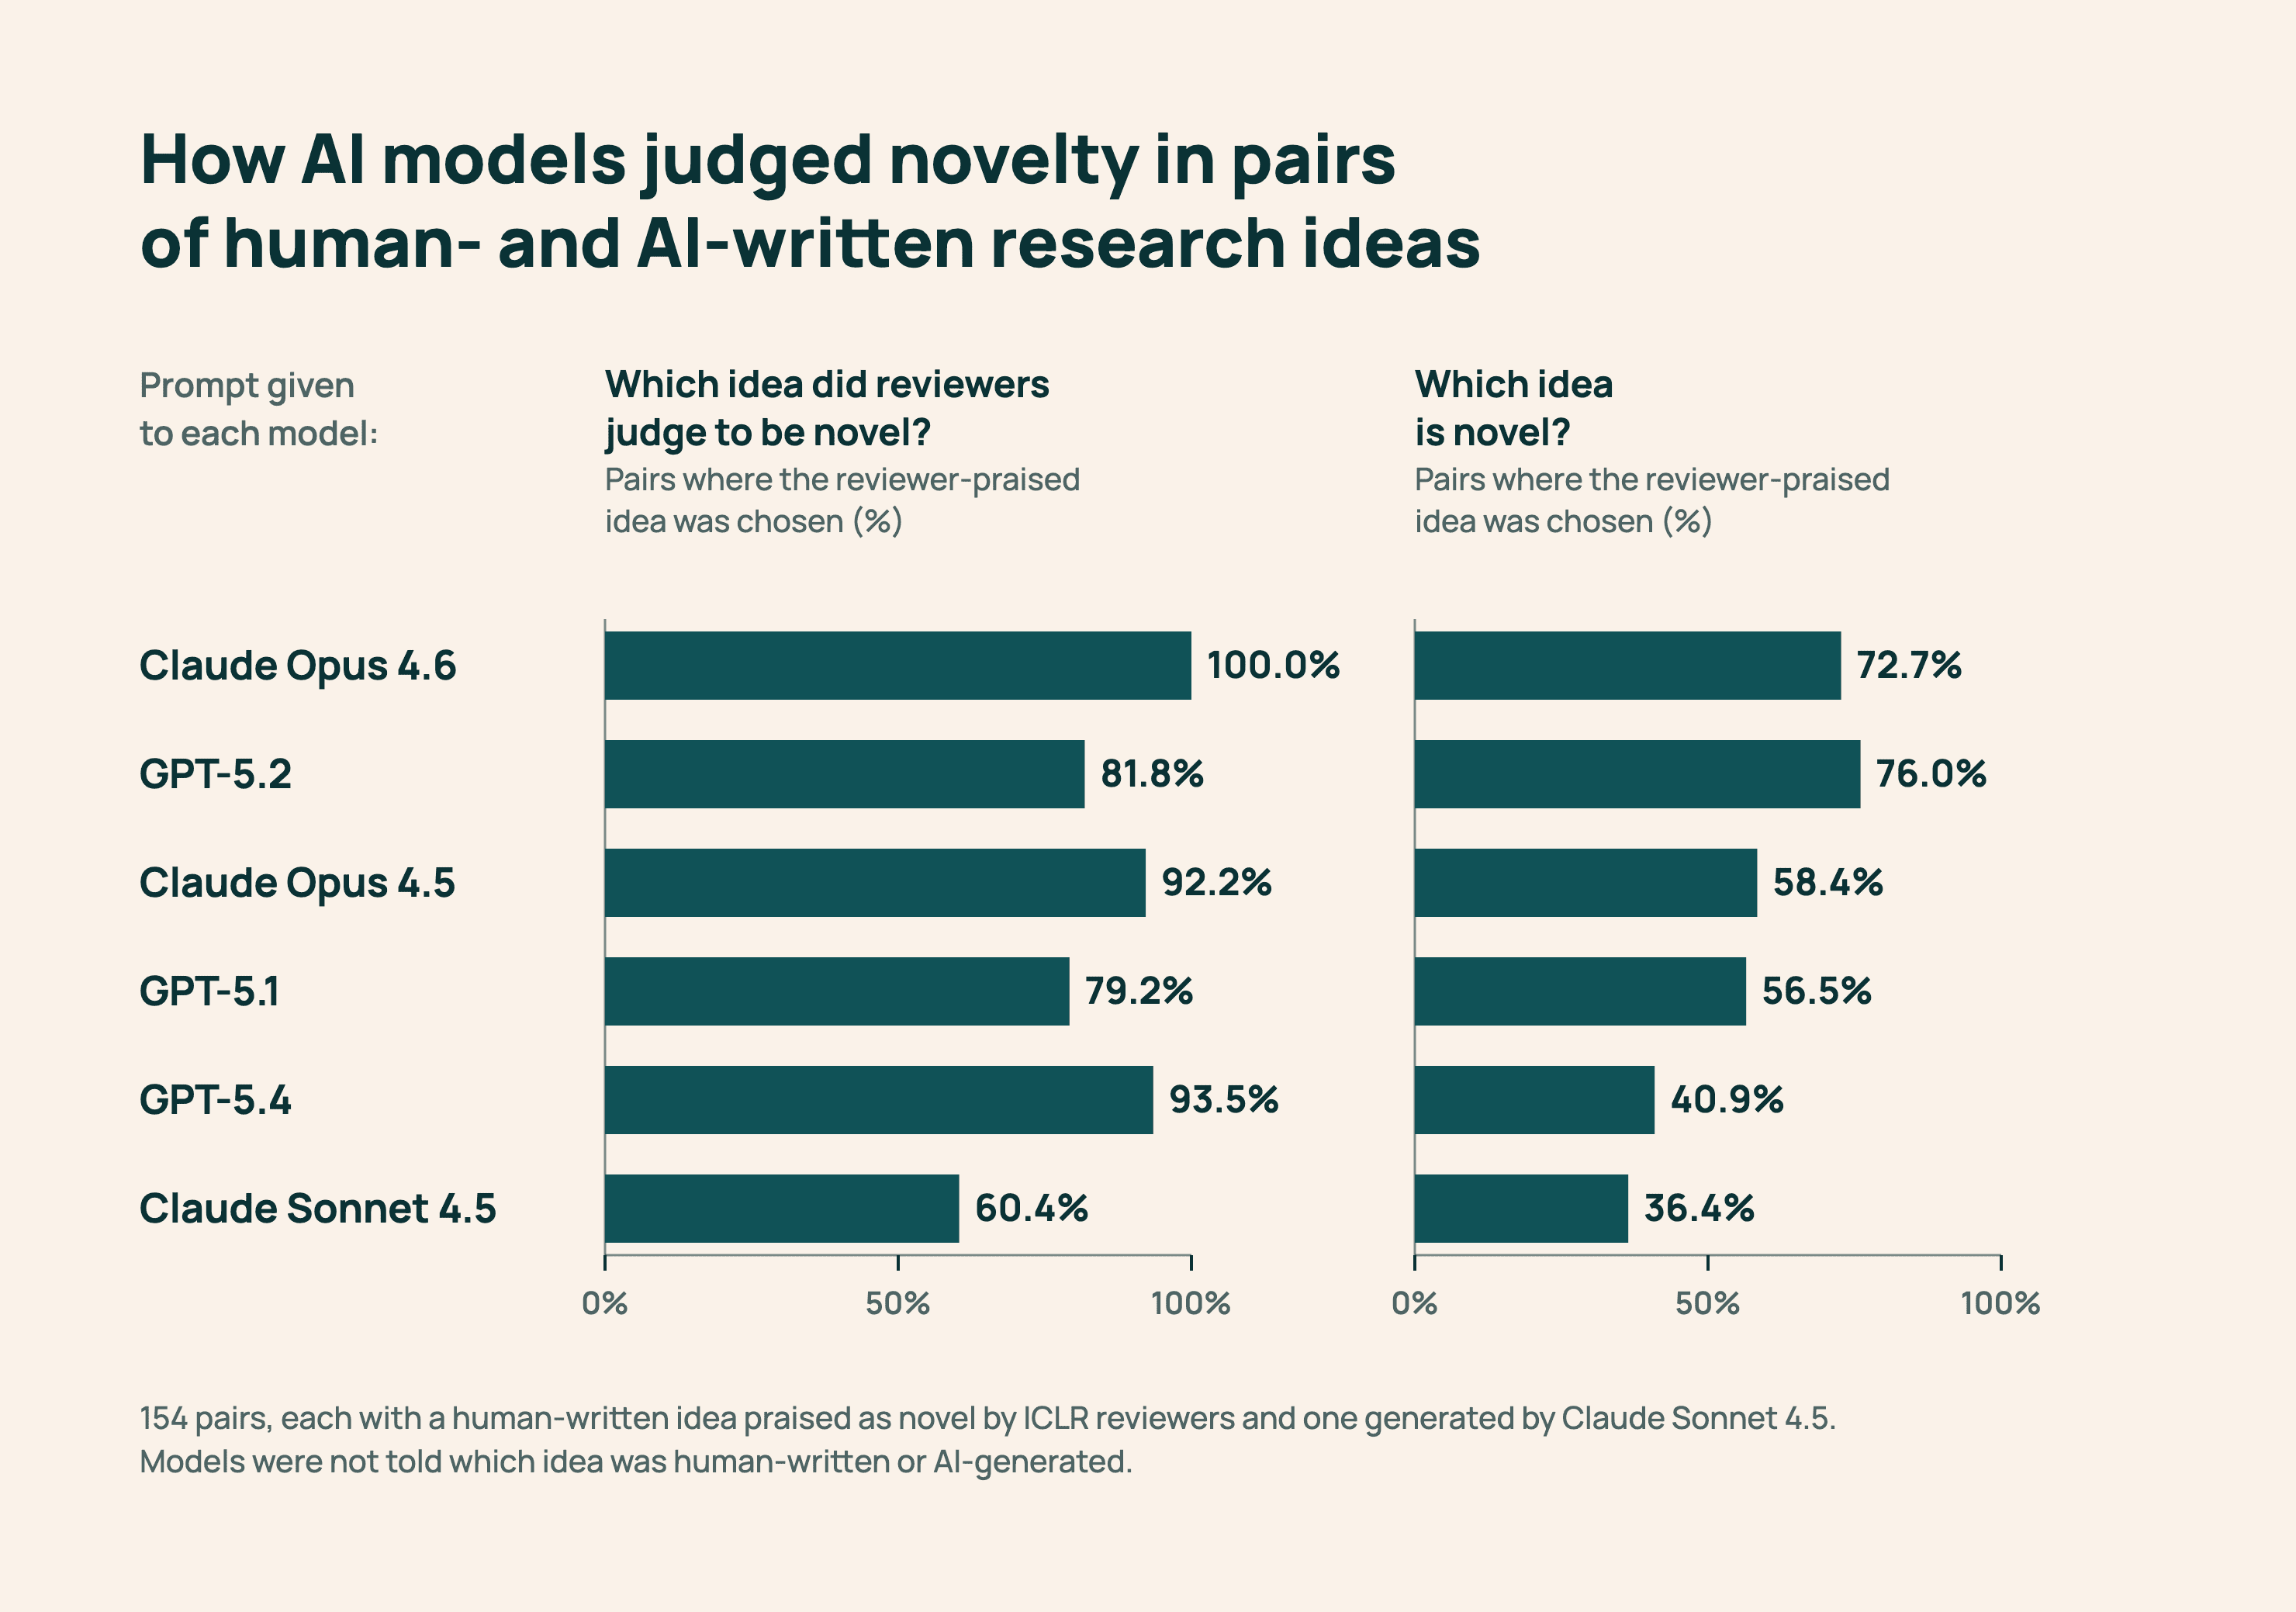
เราทดสอบโมเดลทั้ง 6 รุ่นผ่านการให้คะแนนแบบรายจุดและรายคู่ โดยเปลี่ยนปัจจัยต่างๆ เช่น prompt, งบประมาณการให้เหตุผล และการเข้าถึงงานวิจัยที่เกี่ยวข้อง พบว่าประสิทธิภาพผันผวนมากที่สุดตามวิธีที่ใช้ prompt สั่งการ
ตัวอย่างเช่น เมื่อใช้ GPT-5.4 ตัดสินคู่ Human+Generated การเปลี่ยนจาก prompt ที่ระบุว่ามีเพียงไอเดียเดียวที่แปลกใหม่ เป็น prompt ที่ถามกว้างๆ ว่าไอเดียใดแปลกใหม่ ทำให้ความแม่นยำลดลงจาก 93.5% เหลือเพียง 40.9% ซึ่งแย่ยิ่งกว่าการเดาสุ่ม
นอกจากนี้ยังพบว่าการเพิ่มทรัพยากรคำนวณไม่ได้การันตีผลลัพธ์ที่ดีขึ้น GPT-5.6 Sol ที่มีงบการให้เหตุผลสูงและค้นหาข้อมูลแบบ iterative search ทำคะแนน macro-F1 ได้ 0.78 ซึ่งต่ำกว่า Claude Opus 4.6 ที่ใช้การตั้งค่าแบบเรียบง่าย (0.89) ทั้งที่มีต้นทุนสูงกว่าถึง 10 เท่า
แม้แต่ระบบเฉพาะทางอย่าง AI Scientist ของ Sakana AI ก็ทำคะแนนได้เพียง 0.772 ด้วยต้นทุน 82.05 ดอลลาร์ต่อการตัดสิน เทียบกับ Claude Opus 4.6 ที่ใช้ prompt ธรรมดาซึ่งได้คะแนน 0.854 ในราคาเพียง 2.59 ดอลลาร์ สะท้อนให้เห็นว่าการประเมินความแปลกใหม่ยังเป็นประเด็นที่เปราะบางอย่างมาก
สู่การประเมินงานวิจัยที่แปลกใหม่อย่างน่าเชื่อถือมากขึ้น
งานวิจัยสรุปว่าการประเมินความแปลกใหม่ด้วย LLM ยังเป็นปัญหาเปิด (open problem) ตัวตัดสินที่ดูดีกับงานมนุษย์อาจล้มเหลวเมื่อเจอไอเดียจาก AI ความไว (sensitivity) ต่อ prompt และรุ่นโมเดลทำให้ผลลัพธ์ขาดความเสถียร
เราหวังว่า benchmark และเครื่องมือที่เราเผยแพร่จะเป็นจุดเริ่มต้นให้นักวิจัยพัฒนาระบบประเมินที่แข็งแกร่งขึ้น เพื่อให้การสร้างไอเดียงานวิจัยแบบอัตโนมัติด้วย AI ในอนาคตสามารถนำเสนอสิ่งใหม่ที่ทรงคุณค่าได้อย่างแท้จริง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร