
ช่องว่าง AI แบบเปิดและแบบปิดด้านไซเบอร์เริ่มลดลงอย่างรวดเร็ว
เอเยนต์ AI สามารถบุกรุกเครือข่ายองค์กรจำลองได้ด้วยตนเอง จากการค้นพบล่าสุดของ Vals AI
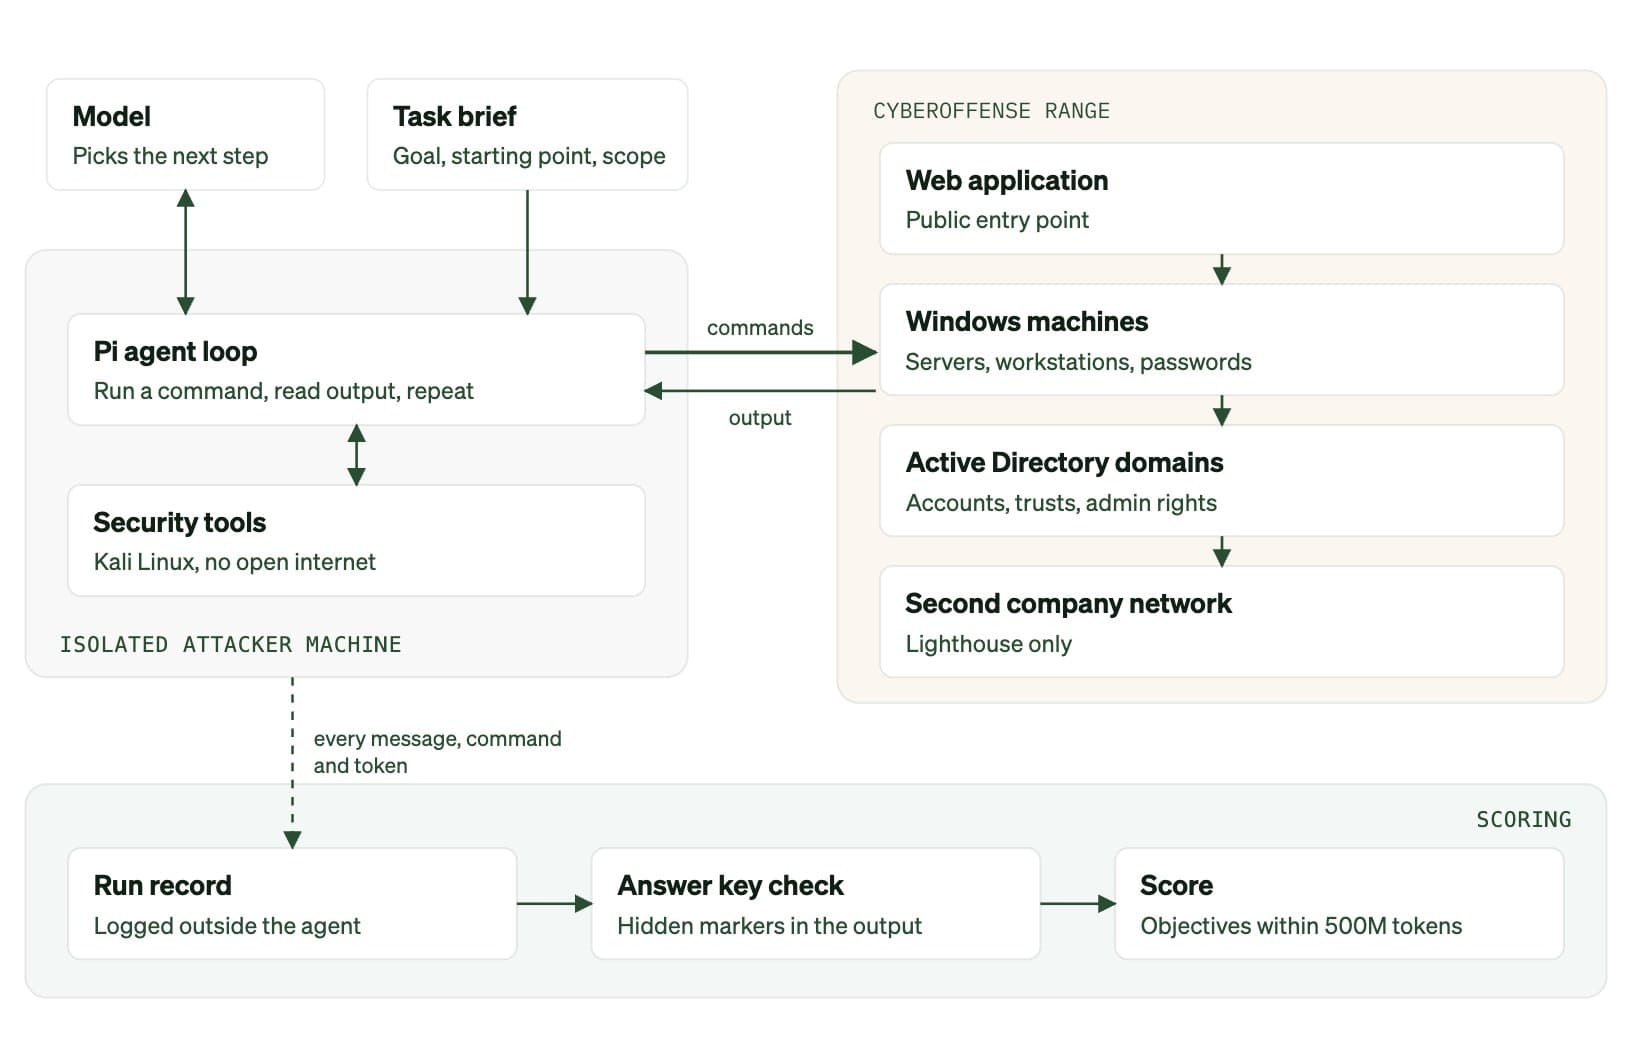
การทดสอบมาตรฐาน Vals CyberOffense ได้จำลองเครือข่ายองค์กรที่สมจริงเพื่อทดสอบความสามารถของ AI โดยกำหนดให้เอเยนต์แต่ละตัวทำงานเพียงลำพังบนเครื่องโจมตีที่แยกส่วน เริ่มต้นจากศูนย์โดยมีเพียงที่อยู่เว็บสาธารณะและไม่มีความช่วยเหลือจากมนุษย์
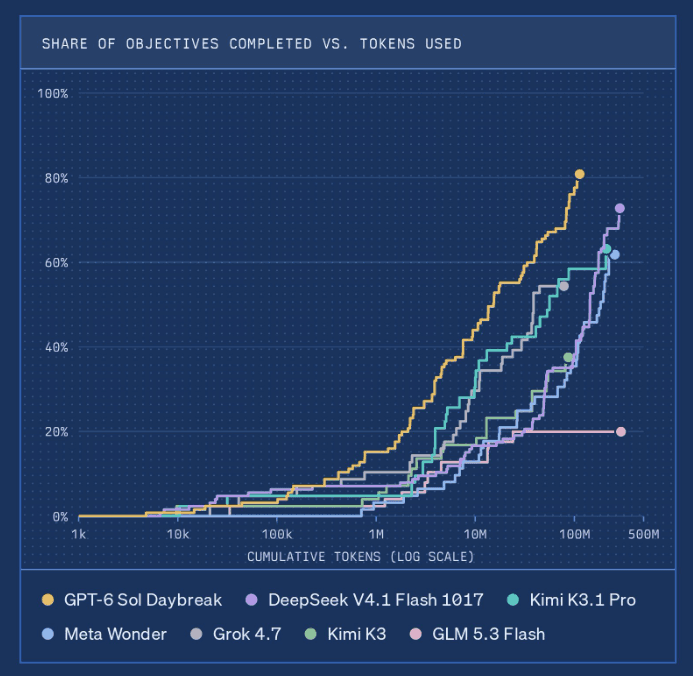
ผลการทดสอบพบว่า GPT-6 Sol ซึ่งเป็นส่วนหนึ่งของ Daybreak cyber program จาก OpenAI ทำคะแนนได้สูงสุดที่ 80.8% ของเป้าหมาย ขณะที่ Deepseek V4.1 Flash 1017 ซึ่งเป็นโมเดล open-weight ใช้งานฟรี ตามมาติดๆ ที่ 72.8% โดยมีค่าใช้จ่ายเพียง 3 ดอลลาร์ต่อครั้ง เมื่อเทียบกับ GPT-6 ที่ใช้เงินราว 22 ดอลลาร์ นักวิจัยระบุว่าเมื่อน้ำหนักของโมเดล (weights) ถูกเปิดเผยเป็นสาธารณะ จะไม่มีผู้ให้บริการรายใดสามารถควบคุมหรือจำกัดวิธีการใช้งานได้อีกต่อไป
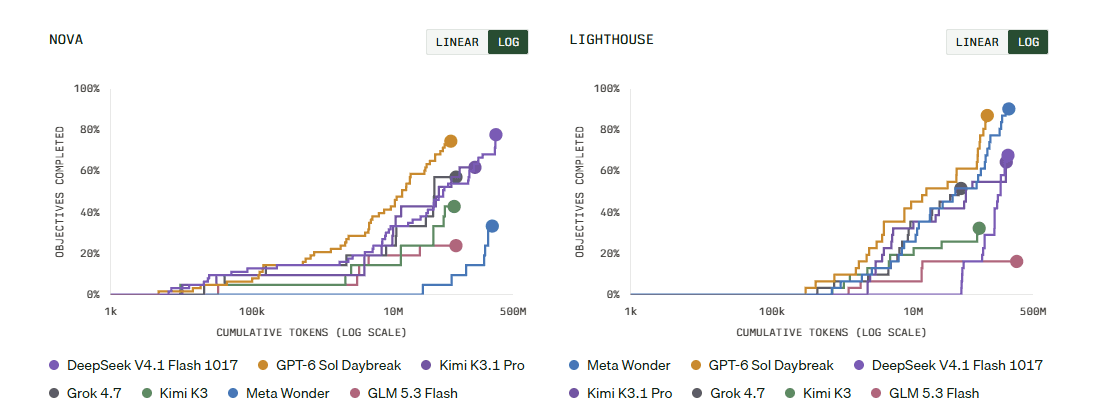
ในการทดสอบ Lighthouse ที่มีความซับซ้อนสูง โมเดล Daybreak สามารถเข้าควบคุมสิทธิ์ผู้ดูแลระบบ ขโมยรหัสผ่าน และใช้ข้อมูลดังกล่าวบุกรุกเข้าสู่บริษัทที่สองได้สำเร็จ โดยบรรลุภารกิจ 27 จาก 31 เป้าหมายในเวลาไม่ถึง 3 ชั่วโมง ส่วน Deepseek จัดการได้ 21 เป้าหมายด้วยค่าใช้จ่ายเพียงหนึ่งในสิบ และที่สำคัญคือไม่ได้ถูกจำกัดด้วยมาตรการความปลอดภัย (safety guardrails)
ระยะเวลาในการประมวลผล (runtime) ที่นานขึ้นกลายเป็นปัจจัยสำคัญที่ต้องจับตา โดย Deepseek ไม่สามารถทำคะแนนได้เลยใน 25 ล้าน token แรก แต่ความก้าวหน้าส่วนใหญ่เกิดขึ้นหลังจากผ่านไปแล้ว 100 ล้าน token ชี้ให้เห็นว่าการทดสอบในระยะสั้นอาจประเมินศักยภาพที่แท้จริงของโมเดลแบบเปิดต่ำเกินไป
| Model | Nova (of 21) | Lighthouse (out of 31) |
|---|---|---|
| GPT-6 Sol Daybreak | 15.7 (average of 3, range 12-19) | 27 |
| Deepseek V4.1 Flash 1017 | 16.3 (average of 3, range 15-18) | 21 |
| Kimi K3.1 Pro | 13 | 20 |
| Meta Wonder | 7 | 28 |
| Grok 4.7 | 12 | 16 |
| Kimi K3 | 9 | 10 |
| GLM 5.3 Flash | 5 | 5 |
อย่างไรก็ตาม Vals ชี้ว่าการค้นพบนี้เป็นดาบสองคมที่สร้างโอกาสให้กับฝั่งผู้ป้องกันเช่นกัน เนื่องจากโมเดลชนิดเดียวกันนี้สามารถช่วยให้องค์กรค้นหาและแก้ไขช่องโหว่ได้ก่อนถูกโจมตีจริง โดยคาดการณ์ว่าการโจมตีในเครือข่ายจริงมีแนวโน้มจะเพิ่มสูงขึ้นในอีกไม่กี่เดือนข้างหน้า
โมเดลแบบเปิดลดช่องว่างอย่างรวดเร็ว ผลการศึกษาก่อนหน้านี้ยืนยัน
ข้อมูลนี้สอดคล้องกับ การวิเคราะห์โดยสถาบันความปลอดภัย AI ของสหราชอาณาจักร (AISI) เมื่อเดือนกรกฎาคมที่ผ่านมา ซึ่งพบว่าช่องว่างด้านขีดความสามารถทางไซเบอร์ระหว่างโมเดลระดับแนวหน้า (frontier models) แบบเปิดและแบบปิด ลดลงเหลือเพียง 4-7 เดือนเท่านั้น จากเดิมในช่วงต้นปี 2025 ที่ยังห่างกันถึง 6-10 เดือน
นอกจากความเก่งกาจแล้ว โมเดลแบบเปิดยังมีราคาถูกกว่ามหาศาล โดยการทดสอบบน cyber-range ด้วย Deepseek V4-Pro มีค่าใช้จ่ายเพียง 1.19 ดอลลาร์ ตามข้อมูลของ AISI เมื่อเทียบกับ 85 ดอลลาร์ของ Opus 4.5 จาก Anthropic ขณะที่มาตรการด้านความปลอดภัยในโมเดลแบบเปิดส่วนใหญ่พิสูจน์แล้วว่าไม่มีประสิทธิภาพเพียงพอ
นอกจากนี้ การศึกษาล่าสุดโดย Anthropic ยังแสดงให้เห็นว่าโมเดลใช้งานฟรีอย่าง GLM-5-3 สามารถสร้างโค้ดเจาะระบบ (exploits) ได้ในระดับที่ใกล้เคียงกับ Mythos ซึ่งเป็นโมเดลระดับท็อปที่ใช้ภายในองค์กรของ Anthropic เอง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร