
Cartesia เปิดตัว Sonic-3.6 โมเดล AI สร้างเสียงพูดระดับท็อป ครองอันดับ 1 ในทุกตารางทดสอบ
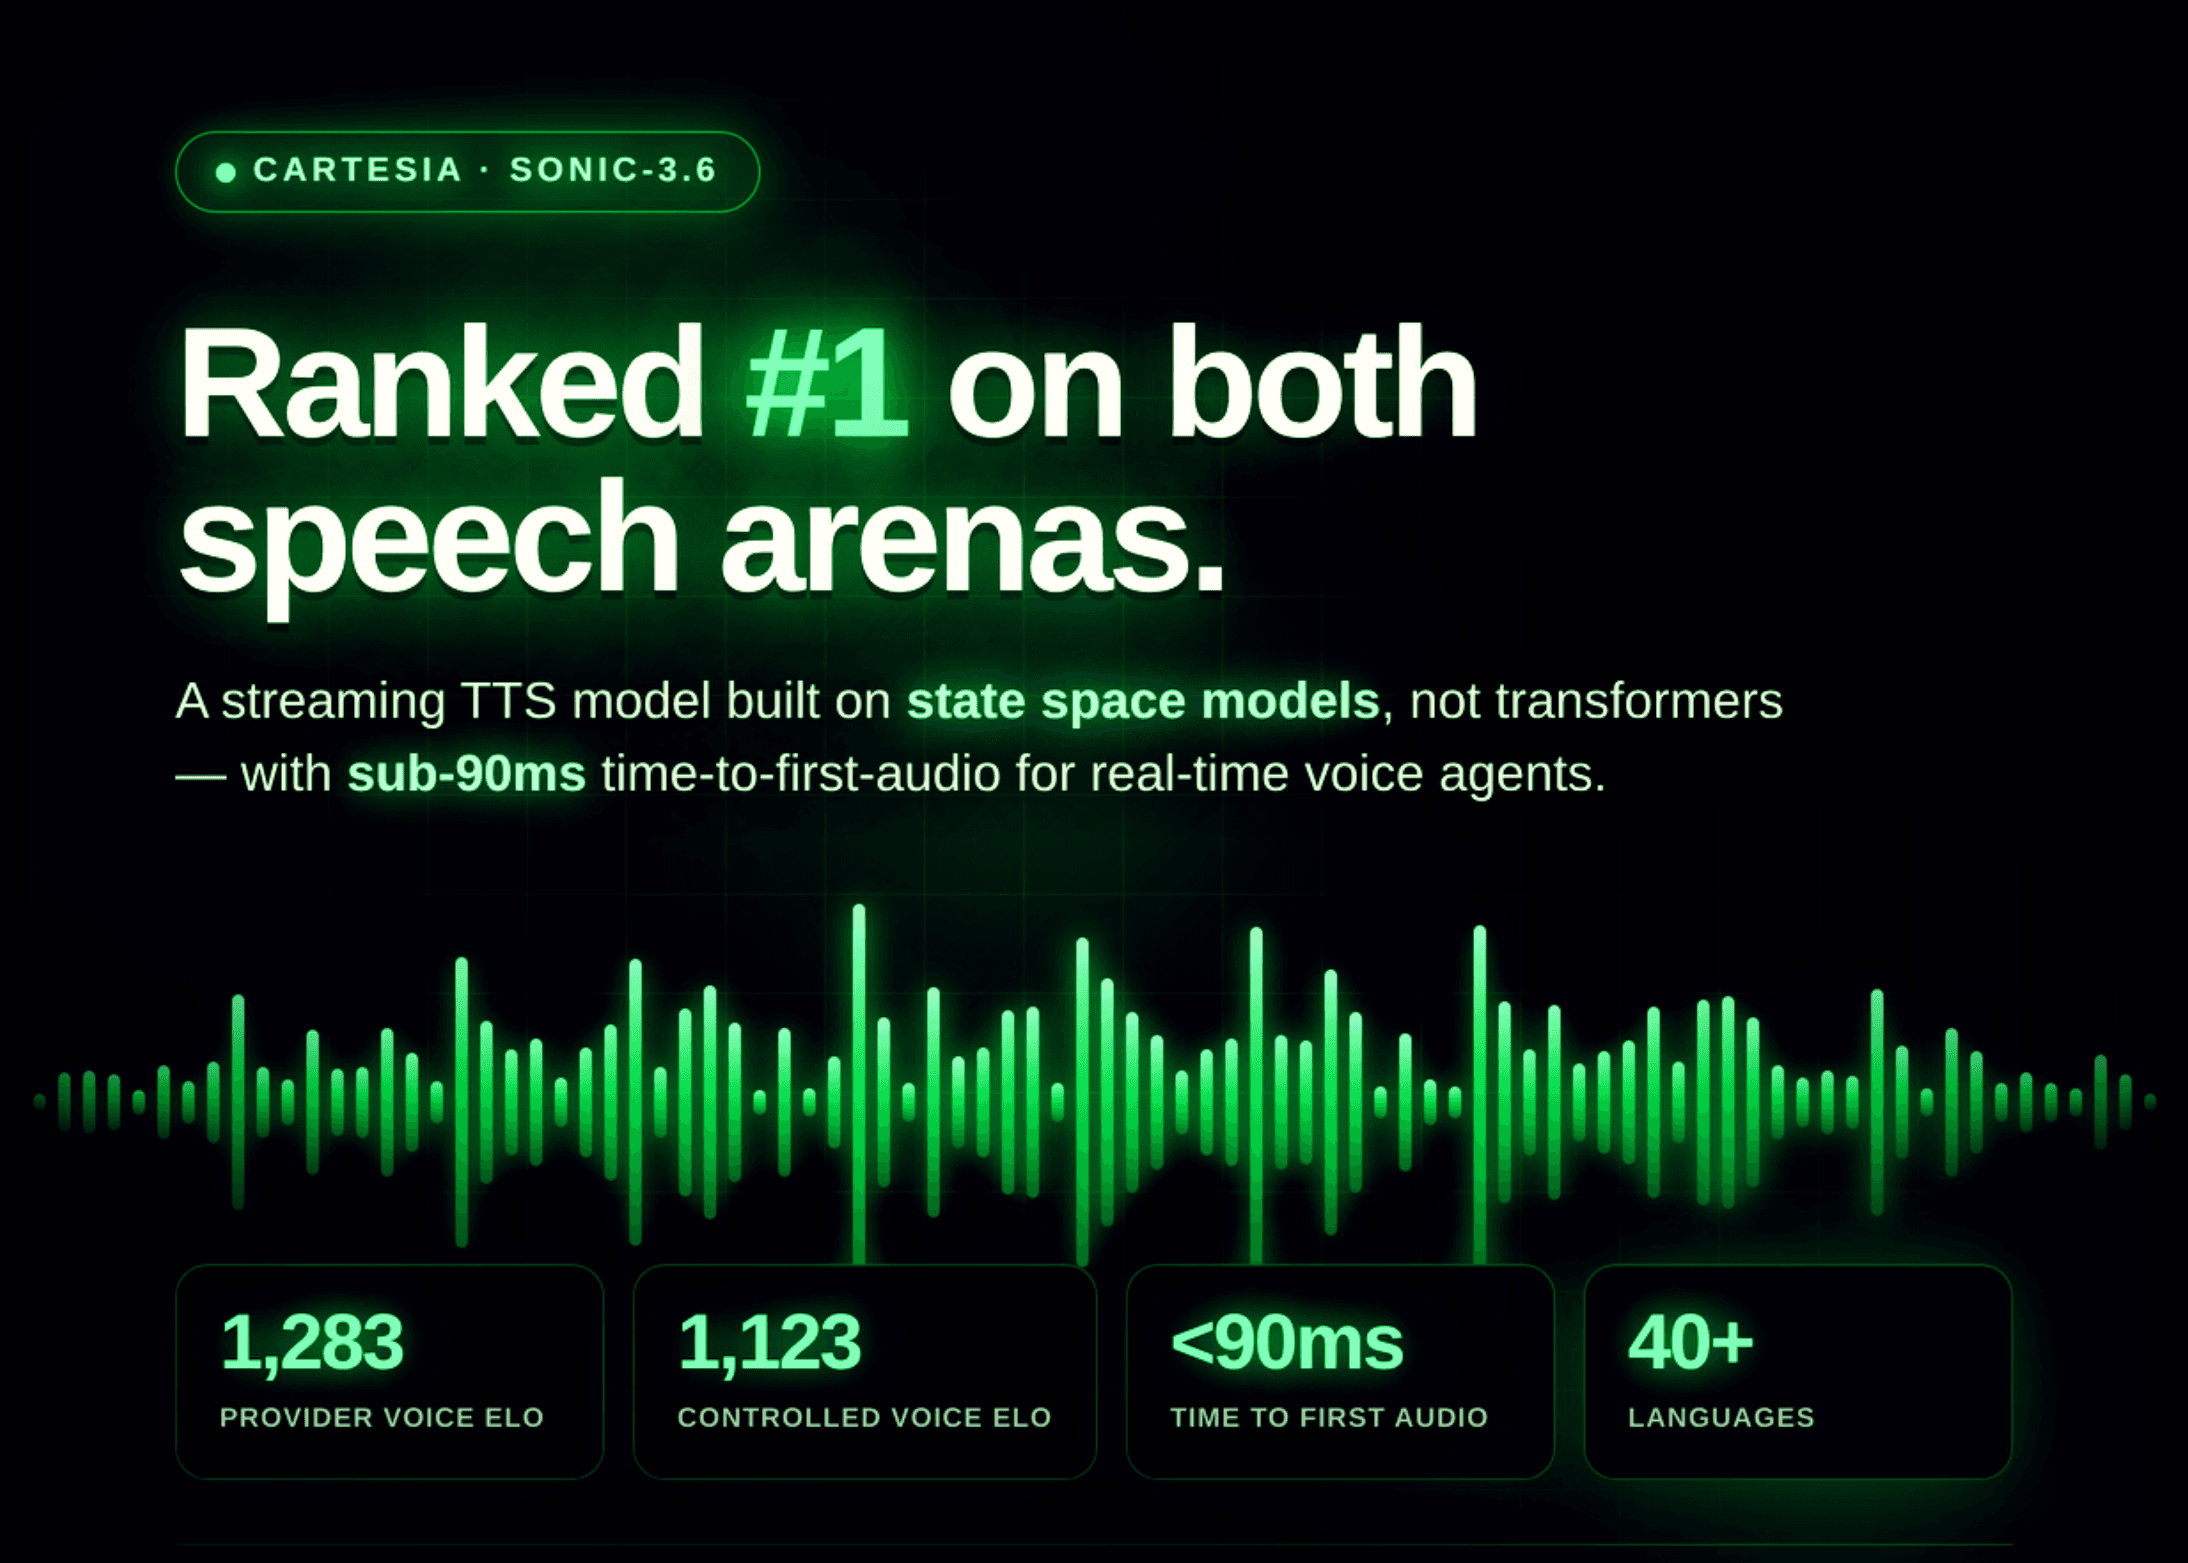
Cartesia ได้ประกาศเปิดตัว Sonic-3.6 ซึ่งเป็นโมเดล Text-to-Speech (TTS) แบบเรียลไทม์เวอร์ชันล่าสุดที่พัฒนาต่อยอดมาจากรุ่น 3.5 ที่เพิ่งเปิดตัวไปเพียงสามเดือนก่อนหน้า โดยรุ่นใหม่นี้เน้นการพัฒนาความเป็นธรรมชาติของเสียงให้สมจริงยิ่งขึ้น ซึ่งได้รับการยืนยันผลการทดสอบจากองค์กรอิสระอย่างชัดเจน
ปัจจุบัน Sonic-3.6 สามารถครอง อันดับ 1 ในตารางผู้นำ Artificial Analysis speech ทั้งสองรายการ ได้สำเร็จ โดยทำคะแนนได้ 1,283 Elo บน Provider Voice board และ 1,123 Elo บน Controlled Voice board
ชัยชนะบนตาราง Controlled Voice มีความสำคัญอย่างยิ่ง เพราะเป็นการทดสอบโดยโคลนทุกโมเดลด้วยเสียงอ้างอิงชุดเดียวกัน 8 เสียง เพื่อแยกวัดประสิทธิภาพของเอนจินการสังเคราะห์เสียงโดยเฉพาะ ผลปรากฏว่า Sonic-3.6 นำเป็นอันดับหนึ่ง ตามด้วย Sonic-3.5 และ ElevenLabs Eleven v3 ในอันดับที่สองและสามตามลำดับ โมเดลนี้รันบน state space models แทนที่จะเป็นสถาปัตยกรรม Transformers ทั่วไป ส่งผลให้มีระยะเวลาสร้างเสียงแรก (time-to-first-audio) ต่ำกว่า 90ms โดยขณะนี้ เปิดให้ใช้งานในเวอร์ชันเบต้า แล้ว
สามารถนำไปใช้งานจริงได้หรือไม่?
คำตอบคือได้ โดยปัจจุบันมีให้บริการในเวอร์ชันเบต้าผ่านรูปแบบ Hosted API แต่จะไม่มีการแจกจ่ายน้ำหนักโมเดล (weights) สำหรับนำไปรันเอง (self-hosted) เนื่องจาก Sonic เป็นโมเดลเชิงพาณิชย์แบบปิด จึงไม่มีการเปิดเผย weights หรือมีคลังบน Hugging Face ผู้ใช้งานต้องเลือกแผนบริการตามขนาดธุรกิจ ตั้งแต่ระดับนักพัฒนาอิสระและสตาร์ทอัพ (Free/Pro $5) ไปจนถึงธุรกิจระดับ Scaleup ที่เน้นศูนย์บริการลูกค้า (Startup $49 / Scale $299) และระดับองค์กรขนาดใหญ่ที่ต้องการความปลอดภัยขั้นสูง
กลุ่มอุตสาหกรรมเป้าหมายครอบคลุมทั้งบริการทางการเงิน การแพทย์ อีคอมเมิร์ซ และโลจิสติกส์ โดยสามารถนำไปประยุกต์ใช้กับเอเจนต์สนับสนุนลูกค้าทั้งขาเข้าและขาออก การแทนที่ระบบตอบรับอัตโนมัติ (IVR) การแจ้งเตือนนัดหมาย ไปจนถึงอินเทอร์เฟซเสียงในผลิตภัณฑ์และงานแปลสื่อต่างๆ
สถาปัตยกรรม (The Architecture)
ความโดดเด่นของ Sonic คือการเลือกใช้ state space models แทน Transformers ซึ่งทาง Cartesia ระบุในหน้า launch page ว่าข้อจำกัดเดิมๆ เช่น การต้องเลือกระหว่างความเร็วกับความเป็นธรรมชาติ หรือความแม่นยำกับต้นทุนนั้น เป็นปัญหาที่แก้ได้ด้วยสถาปัตยกรรมที่ถูกต้อง
ในทางปฏิบัติ โมเดลนี้ทำ Latency ของ TTS ได้ ต่ำกว่า 90ms และเมื่อใช้ร่วมกับโมเดล Speech-to-Text รุ่น Ink-2 จะมี Latency ในการถอดความเพียง 100ms อย่างไรก็ตาม ตัวเลขเหล่านี้เป็นค่า Latency ของตัวโมเดลเองที่ระบุโดยผู้ผลิต ไม่ใช่การวัดผลแบบรวมเวลาเดินทางของข้อมูลไปกลับ (end-to-end round trip)
คำอธิบายแบบโต้ตอบ (Interactive explainer)
ฟีเจอร์ที่มีความสำคัญในการใช้งานจริง
Sonic ถูกออกแบบมาให้ควบคุมได้ละเอียดกว่างานบรรยายทั่วไป เพื่อตอบโจทย์การใช้งานสำหรับเอเจนต์ AI:
- Inline expression tags: สามารถใส่คำสั่งการแสดงออกที่ไม่ใช่คำพูด เช่น
[laughter]ลงในบทอ่านได้ทันที - การโคลนเสียงทันที (Instant voice cloning): สร้างเสียงโคลนที่สมจริงได้โดยใช้ไฟล์เสียงตัวอย่างเพียง 10 วินาที
- พจนานุกรมการออกเสียง (Custom pronunciation dictionaries): รองรับการใช้สัญลักษณ์ IPA เช่น
<<s|ə|ˈ|p|i|n|ə>>สำหรับคำเฉพาะอย่าง subpoena - พารามิเตอร์การควบคุม: ปรับความเร็ว ระดับเสียง และอารมณ์ได้ผ่าน API และรองรับการเชื่อมต่อกับ LiveKit Agents plugin
- ตัวเลขอัลฟานูเมริก (Native alphanumerics): อ่านหมายเลขคำสั่งซื้อ เบอร์โทรศัพท์ และรหัสยืนยันได้อย่างถูกต้องแม่นยำโดยไม่ต้องผ่านกระบวนการเตรียมข้อมูล (preprocessing)
จากเดโมเปิดตัวพบว่าโมเดลสามารถเลียนแบบการหยุดพักหายใจที่เป็นธรรมชาติ มีการใช้คำสร้อย และรองรับการสลับภาษาแบบ Hinglish (ฮินดี-อังกฤษ) ได้อย่างลื่นไหล
ความเป็นจริงของราคา
Artificial Analysis ระบุราคามาตรฐานของ Sonic-3.6 ไว้ที่ $49.00 ต่อ 1 ล้านตัวอักษร ซึ่งถูกกว่า ElevenLabs Eleven v3 ที่ราคา $100.00 ถึงครึ่งหนึ่ง แต่ยังสูงกว่า Speechify Simba 3.2 ที่คิดราคา $10.00 ต่อ 1,240 Elo
การขายของ Cartesia จะใช้ระบบเครดิต โดยระดับ Scale ราคา $299 ต่อเดือน จะครอบคลุมการใช้งานประมาณ 10,667 นาที และรองรับ 15 คำขอพร้อมกัน ส่วนบริการ Line voice agents จะแยกคิดค่าบริการต่างหากที่ $0.06 ต่อนาที
ประเด็นสำคัญ
- Sonic-3.6 ครอง อันดับ 1 ในตารางทดสอบหลักทั้งสองแห่ง ของ Artificial Analysis ทั้งในด้านผู้ให้บริการ (Provider) และการควบคุมเสียง (Controlled)
- การชนะในตาราง Controlled พิสูจน์ว่า เอนจินสังเคราะห์เสียงถูกพัฒนาให้เก่งขึ้นจริง ไม่ใช่แค่มีคลังเสียงที่คุณภาพดี
- ปัจจุบันให้บริการในรูปแบบ Hosted API เท่านั้น โดยเอกสารทางการยังระบุว่า 3.5 เป็นรุ่นเสถียร (Stable) และรุ่น 3.6 อยู่ในขั้นเบต้า
- คำกล่าวอ้างเรื่อง Latency ที่ ต่ำกว่า 90ms (TTFA) คือค่าเฉพาะตัวโมเดล ผู้ใช้งานควรทดสอบ Latency ของระบบจริง (round trip) ด้วยตนเองอีกครั้ง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร