NVIDIA เปิดตัว Nemotron 3.5 Transcribe ถอดความเสียงอัจฉริยะtag: Granary v2, Nemotron 3.5 Transcribe, Nvidia, Open-weight, Speech-to-TextOct 28, 2026 · By: SirilukPสรุปข่าว 1:22NVIDIA เปิดตัว Nemotron 3.5 Transcribe โมเดล Open-weight สำหรับถอดความ ระบุตัวตนผู้พูด และตอบคำถามจากเสียง พร้อมเปิดตัว Granary v2 ไปป์ไลน์ข้อมูลสำหรับปรับแต่งโมเดลเฉพาะทาง
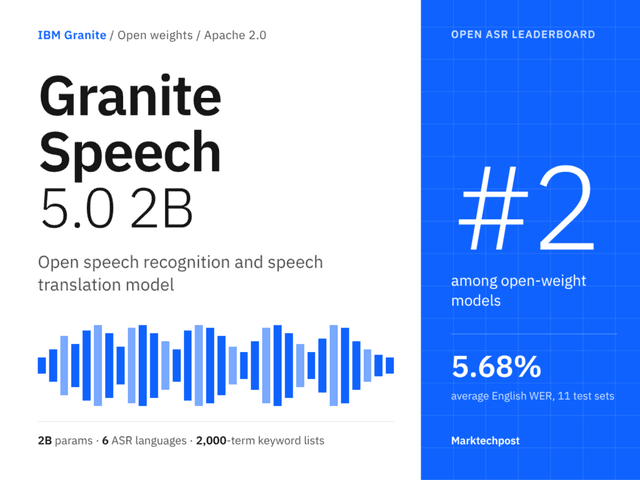
IBM เปิดตัว Granite Speech 5.0 2B โมเดลถอดความและแปลภาษา AItag: Apache 2.0, ASR, Granite Speech, IBM, Speech-to-TextOct 22, 2026 · By: AttapolKสรุปข่าว 1:19IBM เปิดตัว Granite Speech 5.0 2B โมเดลรู้จำเสียงและการแปลแบบ open-weight ภายใต้สัญญาอนุญาต Apache 2.0 ซึ่งคว้าอันดับ 2 บน Open ASR Leaderboard ด้วยความแม่นยำสูง
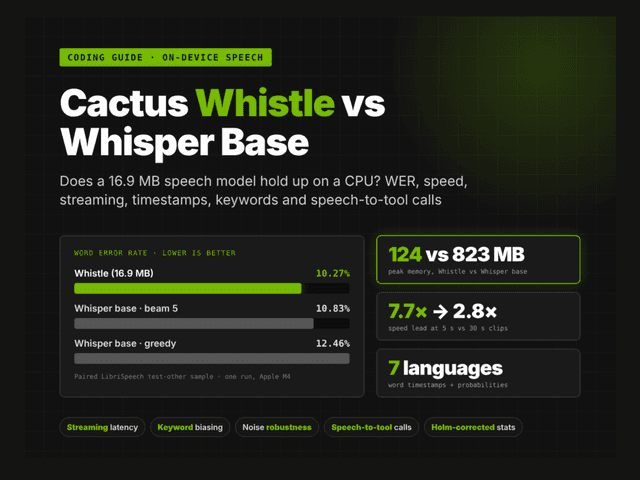
เจาะลึก Cactus Whistle: โมเดลเสียง 16.9 MB เล็กพริกขี้หนูสู้ Whisper ได้ไหม?tag: Cactus Compute, Needle 3, OpenAI, Speech-to-Text, Whisper, WhistleOct 22, 2026 · By: TanasakPสรุปข่าว 1:23คู่มือทดสอบโมเดลเสียงขนาดจิ๋ว Cactus Whistle เทียบกับ Whisper Base ครอบคลุมทั้งความเร็วบน CPU, Word Error Rate และการใช้งานแบบ Streaming พร้อมโค้ดตัวอย่างประกอบการทดลอง
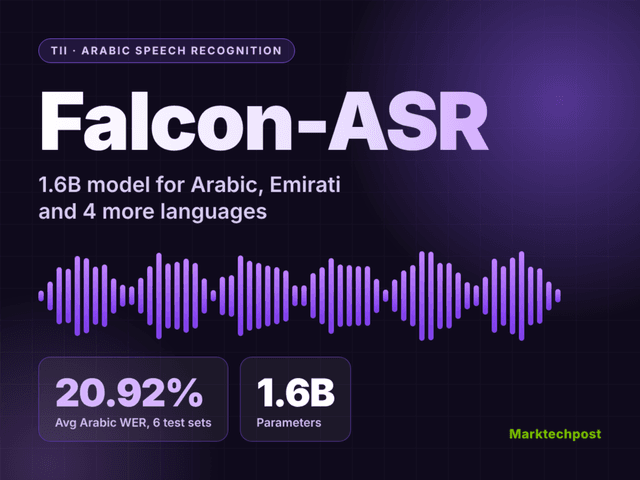
TII เปิดตัว Falcon-ASR โมเดลรู้จำเสียงภาษาอาหรับระดับ 1.6Btag: Arabic ASR, Falcon3-Audio, Falcon ASR, Speech-to-Text, TIIOct 12, 2026 · By: TanasakPสรุปข่าว 1:34Technology Innovation Institute (TII) เปิดตัว Falcon-ASR โมเดลการรู้จำเสียงภาษาอาหรับขนาด 1.6B ชูจุดเด่นสำเนียงเอมิเรตส์พร้อมสถิติ WER ที่ 20.92% แต่ปัจจุบันยังไม่เปิดเผยน้ำหนักโมเดล
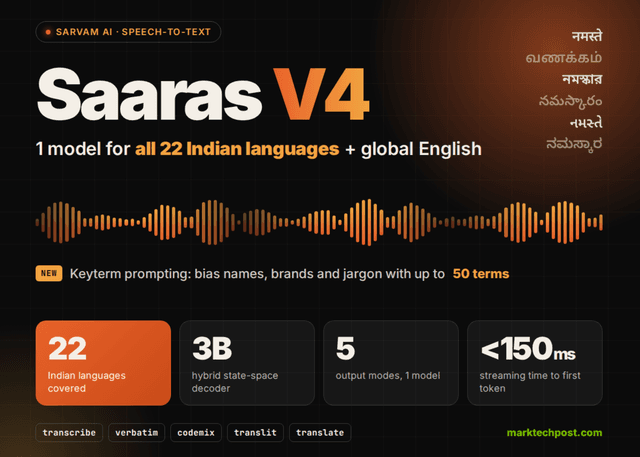
Sarvam AI เปิดตัว Saaras V4 โมเดลแปลงเสียงรองรับ 22 ภาษาอินเดียtag: AI Model, Indic Languages, Saaras V4, Sarvam AI, Speech-to-TextSep 27, 2026 · By: NatapolKสรุปข่าว 1:19Sarvam AI เปิดตัว Saaras V4 โมเดล Speech-to-Text ประสิทธิภาพสูงที่รองรับ 22 ภาษาของอินเดียและภาษาอังกฤษสากล ชูจุดเด่นด้วยความหน่วงต่ำและโหมดการแสดงผล 5 รูปแบบในโมเดลเดียว
Google เปิดตัว Gemini 3.5 Transcribe โมเดลแปลงเสียงเป็นข้อความความแม่นยำสูง รองรับกว่า 85 ภาษาtag: Artificial Intelligence, Gemini 3.5 Transcribe, Gemini API, Google, Speech-to-TextAug 29, 2026 · By: TanasakPGoogle เปิดตัว Gemini 3.5 Transcribe โมเดล Speech-to-Text รุ่นใหม่ที่ทำสถิติอัตราข้อผิดพลาดต่ำสุดเพียง 2.6% โดยแบ่งการทำงานเป็นสองรูปแบบเพื่อรองรับทั้งการสตรีมแบบเรียลไทม์และการประมวลผลไฟล์เสียงย้อนหลังที่มีประสิทธิภาพสูงกว่าเดิม 70%
เจาะลึกวิศวกรรมการสร้าง Voice AI Agent: เมื่อเสียงเป็นมากกว่าแค่การพิมพ์tag: AssemblyAI, Large Language Model, OpenAI, Speech-to-Text, Text-to-Speech, Voice AgentJul 31, 2026 · By: SirilukPสรุปกระบวนการสร้างเอเจนต์ AI ควบคุมด้วยเสียง ตั้งแต่การถอดความสตรีมมิ่ง การตรวจจับรอบสนทนา ไปจนถึงการจัดการระบบพูดแทรก เพื่อมอบประสบการณ์การสื่อสารที่เป็นธรรมชาติและลดความหน่วง