
NVIDIA เปิดตัว Nemotron 3.5 Transcribe ถอดความเสียงอัจฉริยะ
โมเดลแบบเปิดรุ่นเดียวสำหรับการถอดความหลายภาษา, การระบุตัวตนผู้พูด (speaker attribution), การแปลภาษา และการตอบคำถามจากเสียง (audio Q&A) พร้อมผลลัพธ์อันดับต้นๆ บนลีดเดอร์บอร์ด เสริมด้วย Granary v2 ไปป์ไลน์ข้อมูลแบบเปิดและสูตรการ fine-tuning เพื่อปรับแต่งโมเดล
การถอดความในปัจจุบันยังคงมีข้อจำกัดในการระบุว่าใครเป็นคนพูด การแปล หรือการจัดรูปแบบคำศัพท์เฉพาะทาง โดยเฉพาะในงานที่ต้องการความแม่นยำสูงอย่างการประชุมหลายภาษาหรือการจดบันทึกทางการแพทย์ที่ต้องการการระบุตัวตนผู้พูดและคำศัพท์ที่ถูกต้อง
NVIDIA Nemotron 3.5 Transcribe เป็นโมเดล open-weight ที่สั่งการด้วยพรอมต์ (promptable) ซึ่งเปลี่ยนเสียงบันทึกให้เป็นข้อความที่นำไปใช้งานต่อได้ทันที พร้อมใช้งานแล้วบน Hugging Face และ ModelScope โดยรวมความสามารถทั้งการถอดความ, การระบุตัวตนผู้พูด (diarization), การแปล และการตอบคำถามจากเสียงไว้ใน checkpoint เดียว รองรับการถอดความ 40 ภาษา แปลภาษาได้ 31 ภาษา และระบุตัวตนผู้พูดได้ 13 ภาษา สำหรับเสียงยาวสูงสุดหนึ่งชั่วโมง
โมเดลนี้ครองอันดับหนึ่งในกลุ่มโมเดล open-weight บน Hugging Face Open ASR Leaderboard สำหรับภาษาอังกฤษ และมีความแม่นยำสูงสุดตามรายงานของ Artificial Analysis นอกจากนี้ยังทำคะแนนอัตราข้อผิดพลาดต่ำที่สุดในลีดเดอร์บอร์ดของ David AI และ VoiceArena โดยสามารถทำงานบน NVIDIA GPU ตั้งแต่ DGX Spark ไปจนถึง Blackwell
นอกจากนี้ยังมี Granary v2 (พร้อมใช้งานบน Hugging Face และ ModelScope) ซึ่งเป็นไปป์ไลน์ข้อมูลแบบเปิดพร้อม เครื่องมือ fine-tuning ของ NeMo Speech ที่ช่วยให้นักพัฒนสามารถปรับแต่งโมเดลให้เข้ากับคำศัพท์เฉพาะทางได้ เช่นในกรณีศึกษาทางการแพทย์ที่ช่วยลดอัตราข้อผิดพลาดของคำ (WER) ลงถึง 45.8%
แนะนำการถอดความและการวิเคราะห์ด้วยภาษาธรรมชาติ
checkpoint เดียวกันนี้สามารถจัดการเสียงบันทึกเดียวให้ได้ผลลัพธ์ที่หลากหลายตามคำสั่ง เช่น "ถอดความและระบุชื่อผู้พูด", "แปลเป็นภาษาอังกฤษ" หรือ "สรุปการตัดสินใจในการประชุม"
ตัวอย่างความสามารถของโมเดลถูกแสดงผ่านวิดีโอฉากจากภาพยนตร์ His Girl Friday (1940) ที่มีบทสนทนารวดเร็วและพูดทับซ้อนกันอย่างหนัก
Nemotron 3.5 Transcribe ใส่คำบรรยายใต้ภาพฉากจาก His Girl Friday (1940) และระบุตัวตนผู้พูด รวมถึงบทสนทนาที่พูดทับซ้อนกัน
สำหรับการใช้งานเฉพาะทาง เช่น ด้านการแพทย์ นักพัฒนาสามารถใช้พรอมต์ระบุบริบทได้ เช่น:
Transcribe this medical discussion in the original language. Possible terms: HbA1c, metformin. Use these terms only when supported by the audio. Preserve standard medical spelling and write numbers in conventional written form.
ใน model card จะมีค่าตั้งล่วงหน้า (presets) และคู่มือการใช้พรอมต์ฉบับเต็ม รวมถึงการรองรับการระบุเวลาในระดับคำ (Word-level timestamps) เพื่อนำไปประยุกต์ใช้ในงานต่างๆ เช่น แพลตฟอร์มการเรียนออนไลน์ของ Agora ที่ใช้แสดงบทถอดความควบคู่ไปกับวิดีโอการสอน
ชัยชนะบนลีดเดอร์บอร์ดตั้งแต่การถอดความไปจนถึงการระบุตัวตนผู้พูด
Transcribe นำโด่งในกลุ่มโมเดล open-weight ทั้งในแง่เนื้อหาที่พูดและการระบุตัวผู้พูดในเบนช์มาร์กสำคัญ
Hugging Face Open ASR Leaderboard วัดผลผ่านอัตราข้อผิดพลาดของคำ (WER) โดย Transcribe ได้อันดับหนึ่งในภาษาอังกฤษด้วย WER 5.33% และทำผลงานได้ดีที่สุดในกลุ่มหลายภาษาและรูปแบบยาว
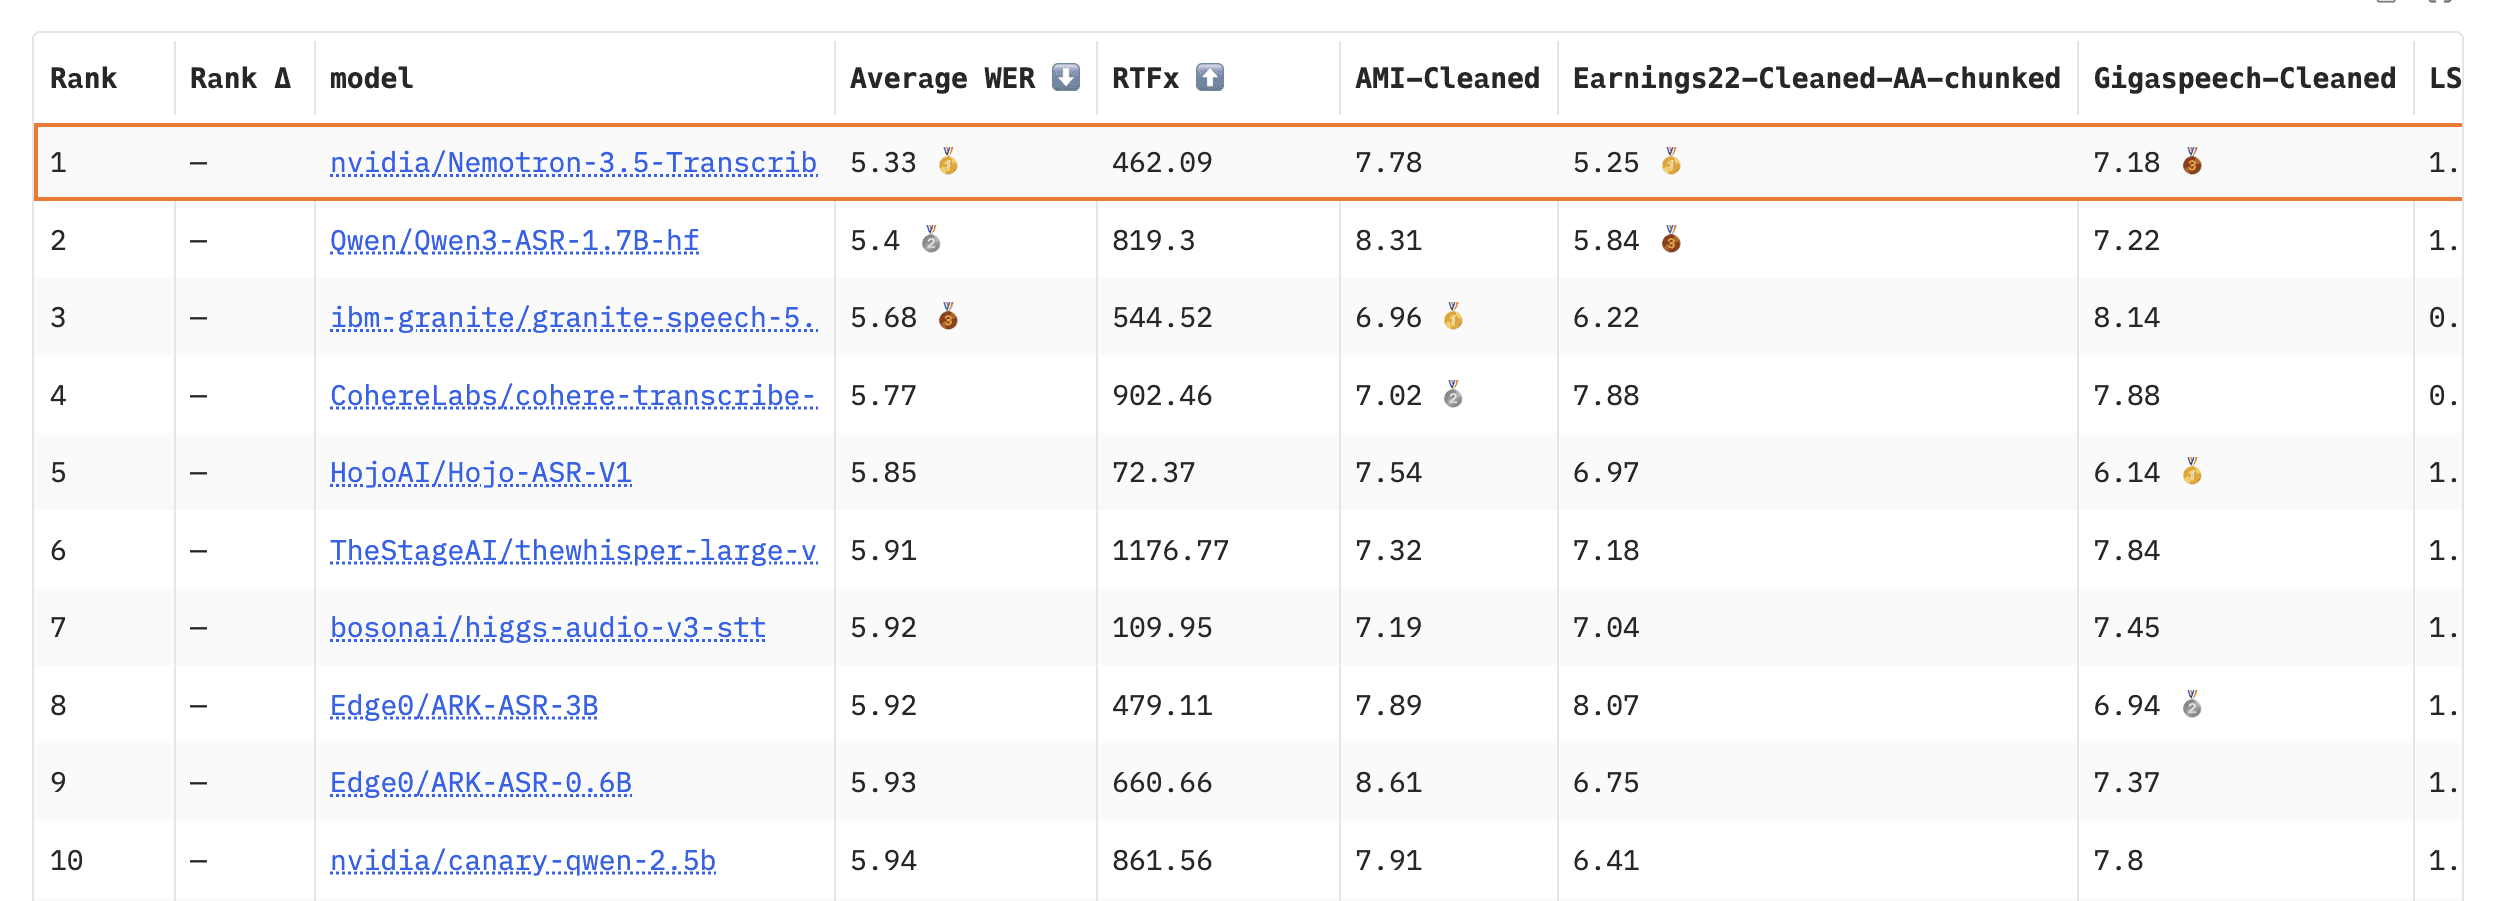
รูปที่ 1. Nemotron 3.5 Transcribe ครองอันดับหนึ่งในบรรดาโมเดล open-weight บน Hugging Face Open ASR Leaderboard
Artificial Analysis Speech-to-Text Leaderboard ในดัชนี AA-WER นั้น Transcribe ครองอันดับหนึ่งร่วมด้วย WER 2.8% โดยใช้พารามิเตอร์ขณะทำงานเพียง 4B จากทั้งหมด 30B ด้วยสถาปัตยกรรมไฮบริด Mamba - Transformer mixture-of-experts ทำให้มีความแม่นยำสูงเมื่อเทียบกับทรัพยากรที่ใช้ และทำผลงานได้ดีกว่า speech API แบบปิดหลายตัว
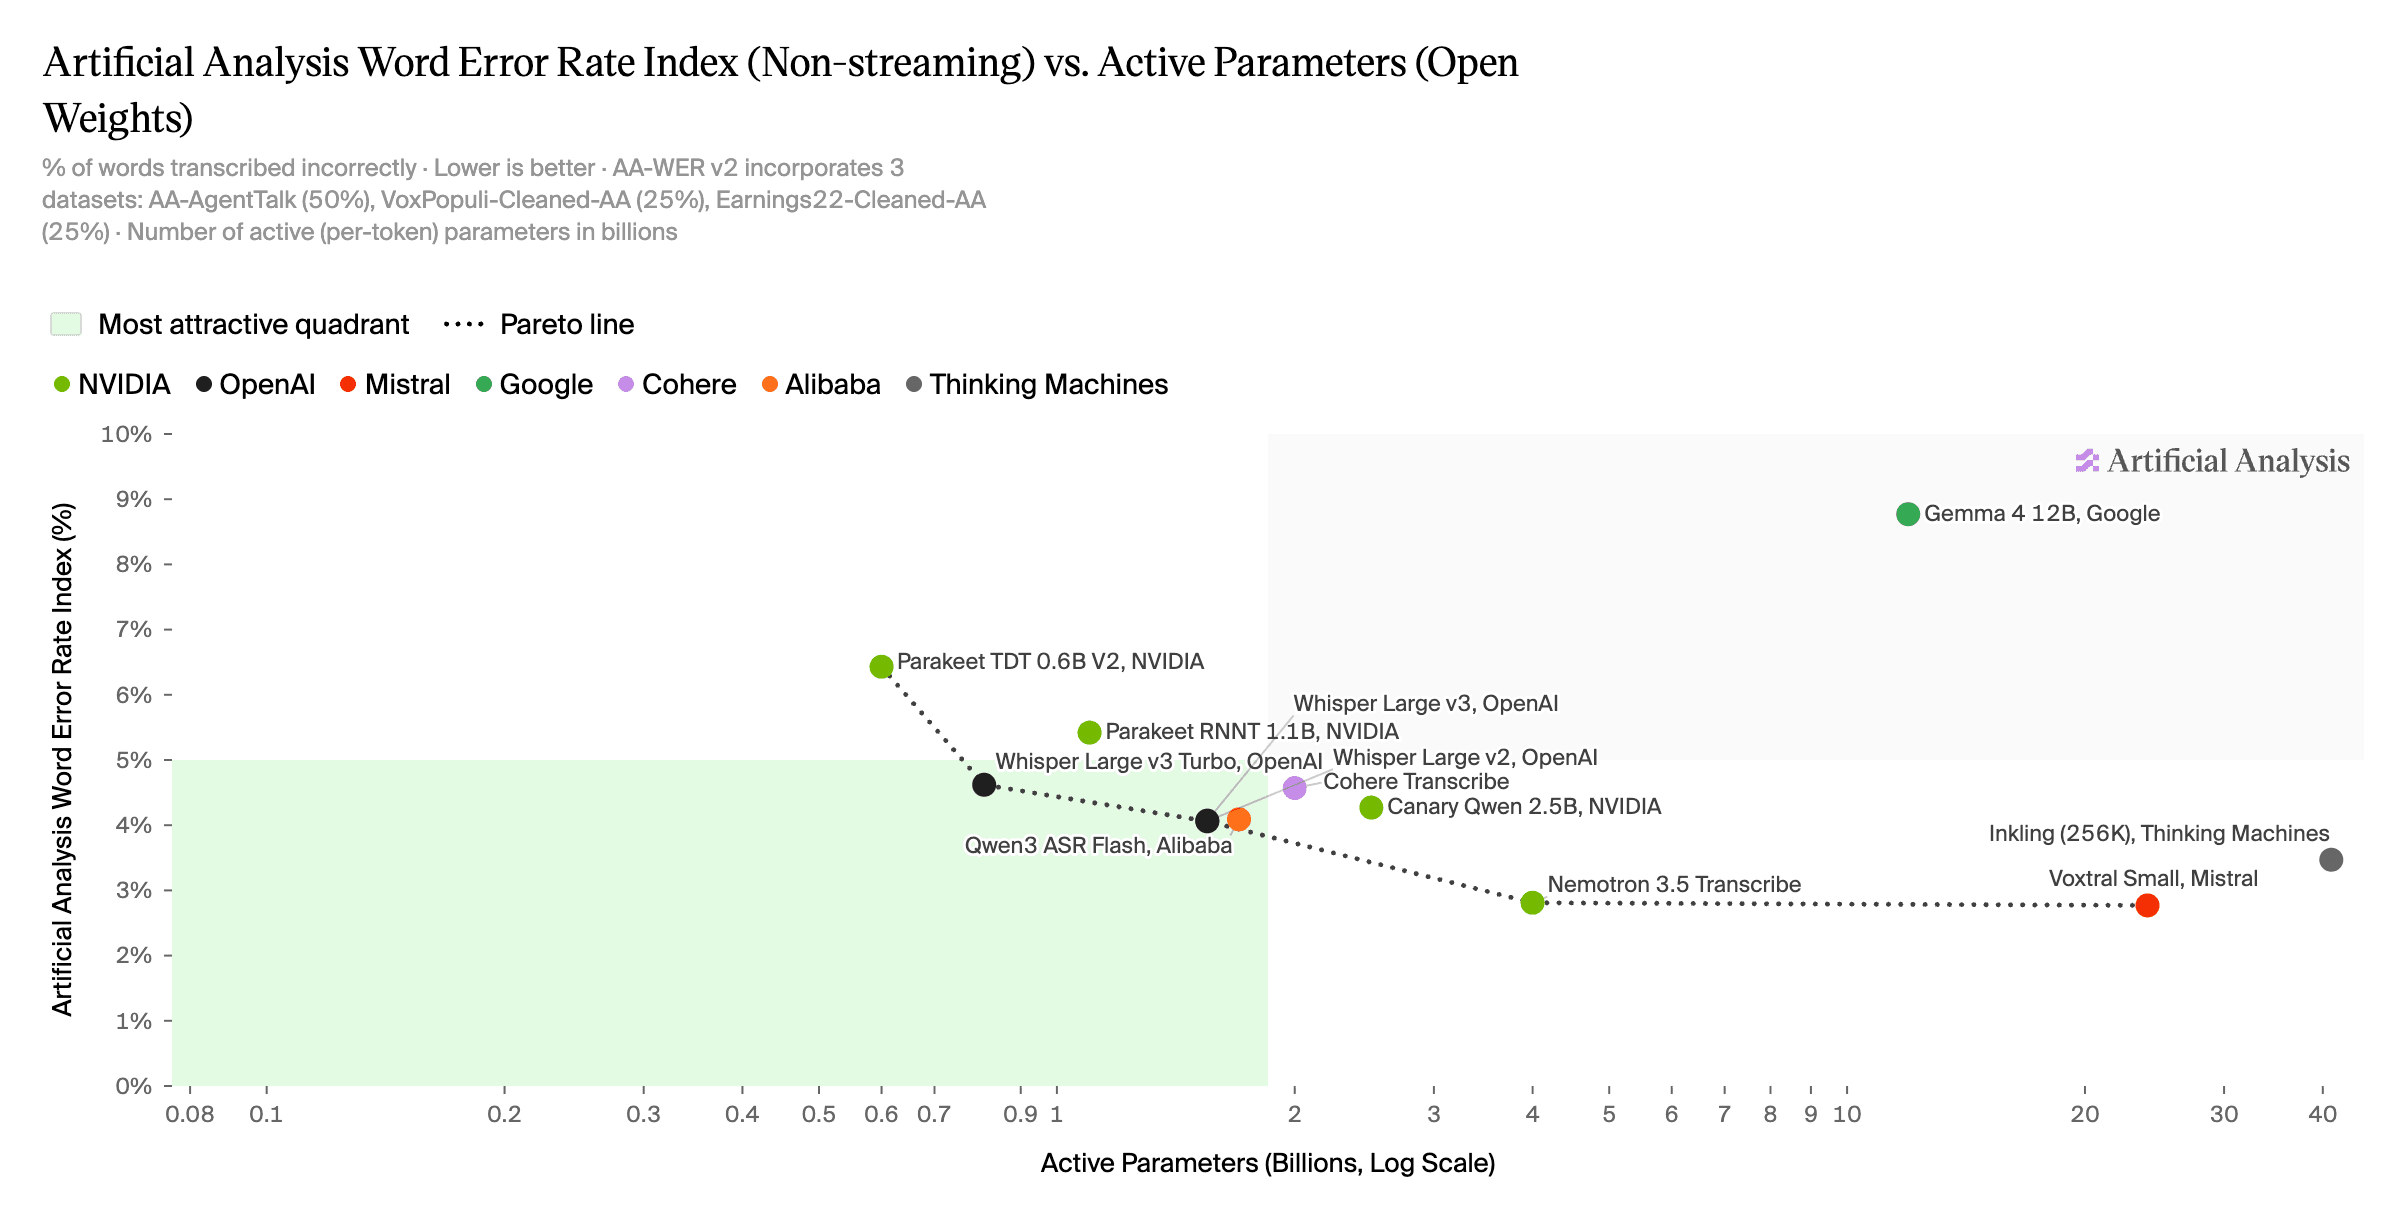
รูปที่ 2. ความเป็นผู้นำด้านความแม่นยำของ AA ด้วยพารามิเตอร์ที่ใช้งานเพียงบางส่วน
การระบุตัวตนผู้พูดในหลายภาษาและการพูดทับซ้อน ด้วยสัญญาณ Sortformer ทำให้ Transcribe ติดป้ายกำกับผู้พูดได้ในระหว่างสร้างข้อความ ส่งผลให้ครองอันดับหนึ่งบนลีดเดอร์บอร์ด David AI ในด้านการทำ diarization 21 ภาษา นำหน้าโมเดลเฉพาะทางอย่าง Nemotron 3 Diarization
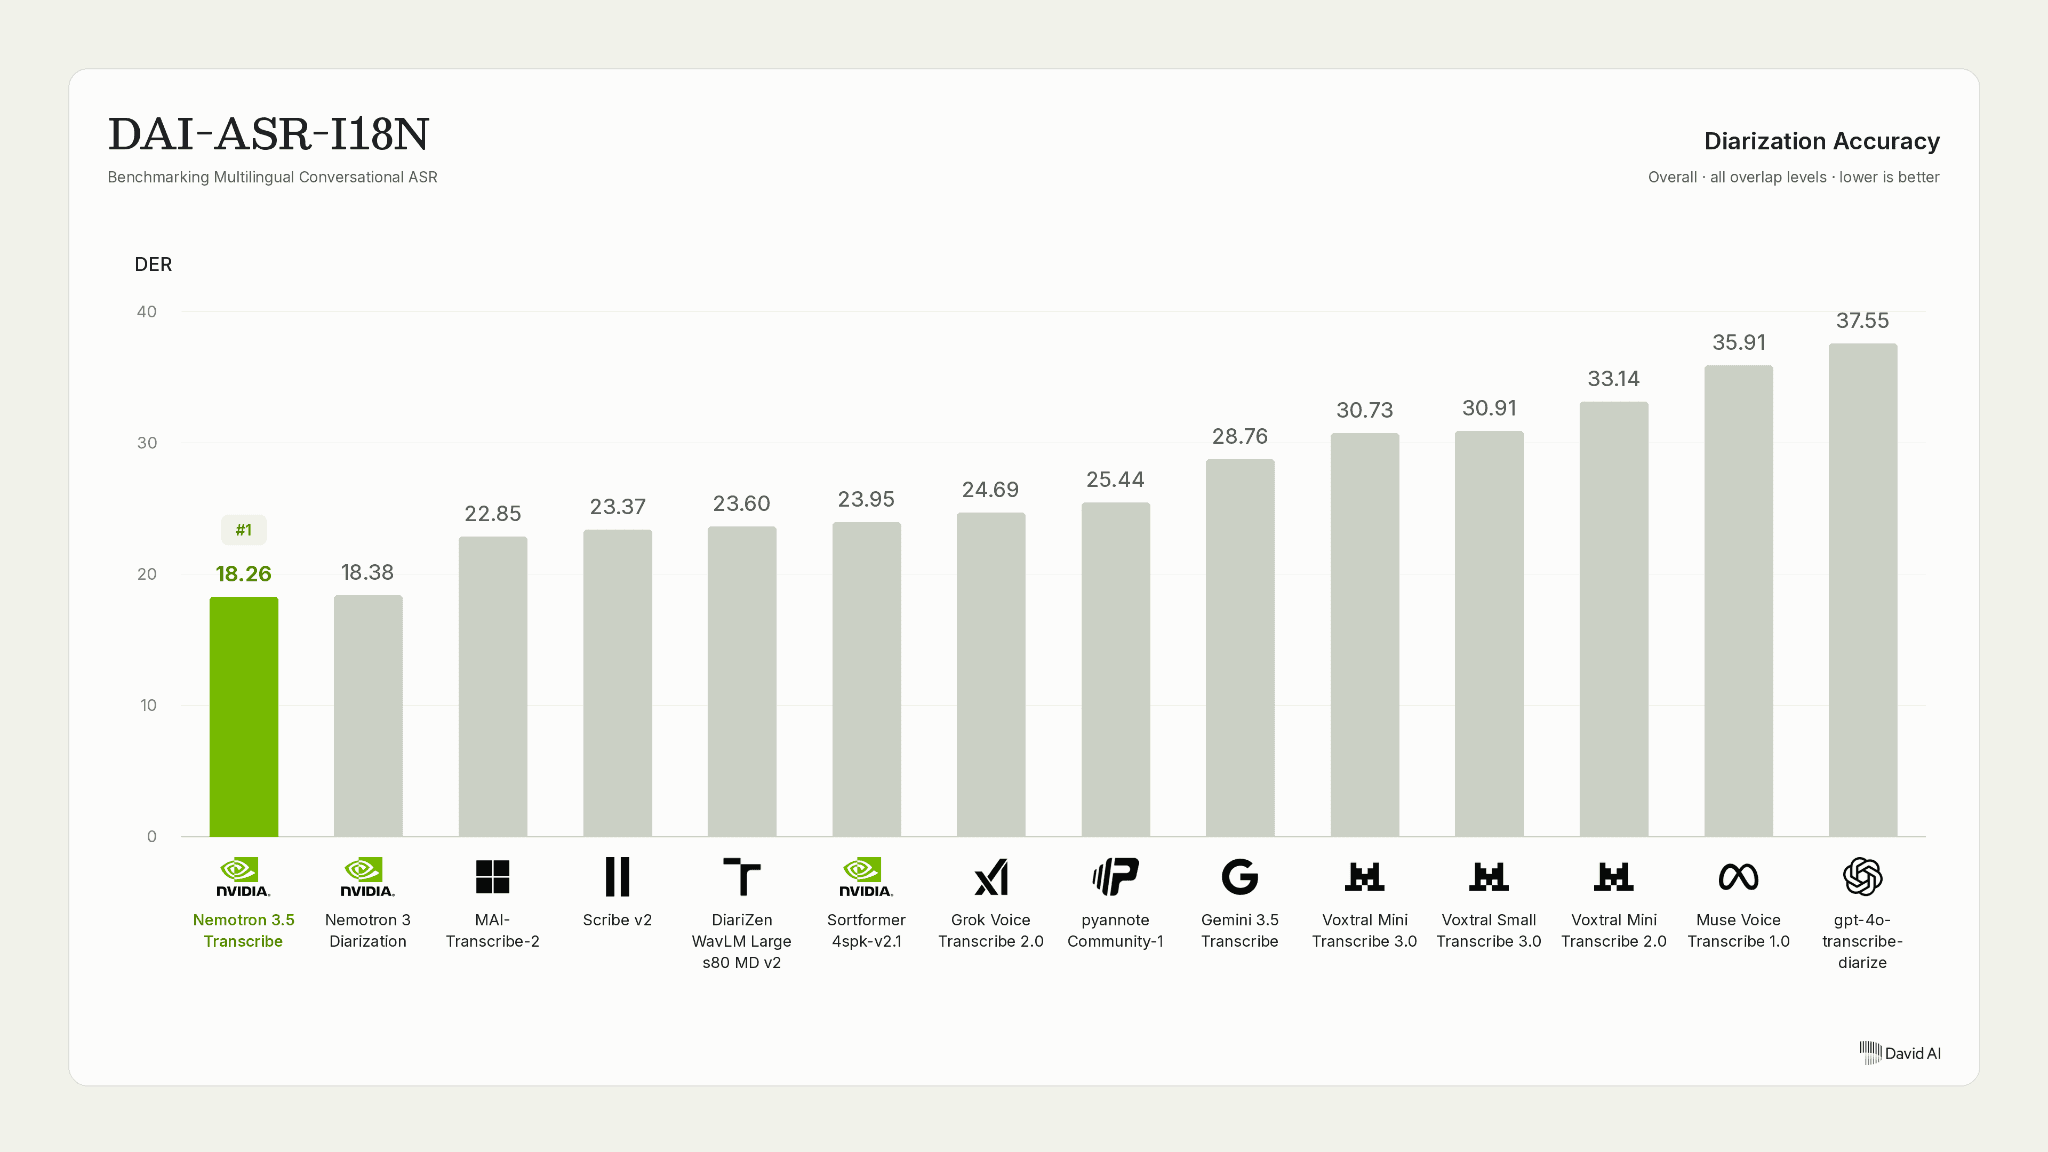
รูปที่ 3. โมเดลของ NVIDIA ครองสองอันดับแรกบน ลีดเดอร์บอร์ดการทำ diarization หลายภาษาของ David AI
นอกจากนี้ ในเบนช์มาร์ก VoiceArena สำหรับภาษาอังกฤษ Transcribe ยังทำคะแนน cpWER ได้ต่ำที่สุดและมีอัตราคำหล่นหายน้อยที่สุดเพียง 8.32% เมื่อเทียบกับค่ามัธยฐานในอุตสาหกรรมที่ 31%
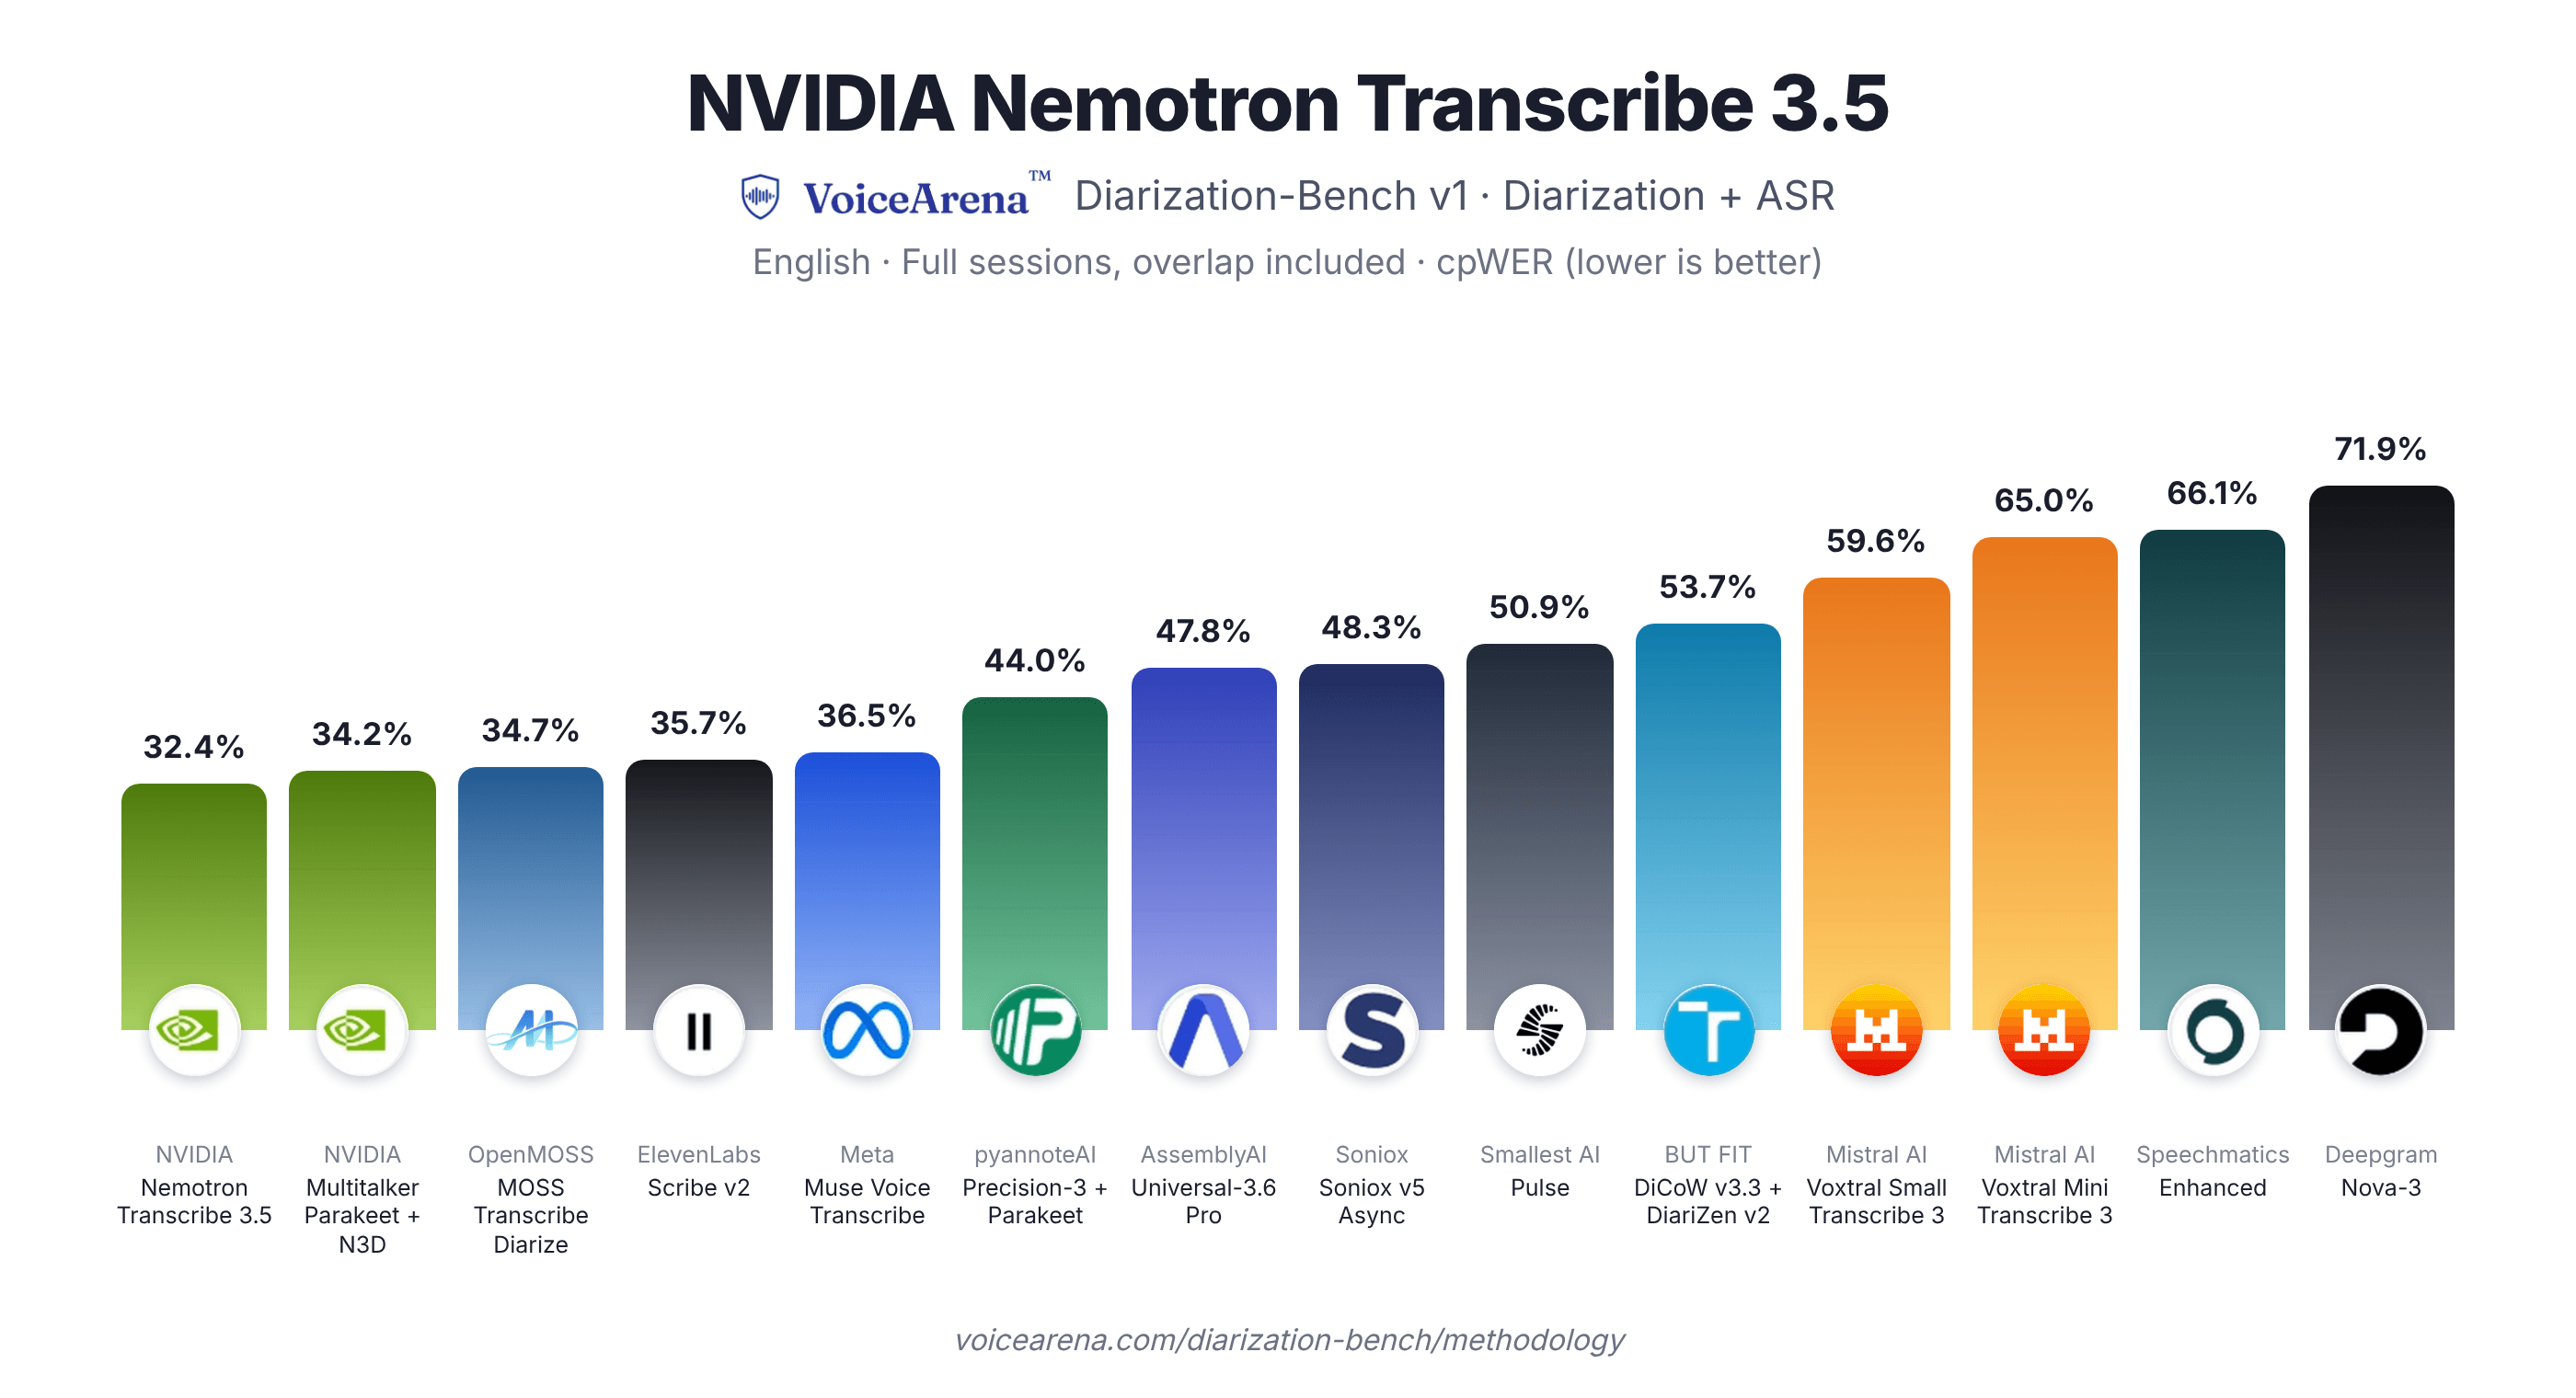
รูปที่ 4. ผลการทดสอบจาก VoiceArena แสดงให้เห็นว่า Nemotron 3.5 Transcribe เป็นผู้นำในระบบการถอดความพร้อมระบุตัวผู้พูด
โมเดลนี้ทำงานได้ตั้งแต่ระดับ Edge บน Jetson AGX Thor ไปจนถึงศูนย์ข้อมูล Blackwell โดยบน RTX PRO 6000 Blackwell Server Edition สามารถประมวลผลเสียง 100 ชั่วโมงได้ในเวลาไม่ถึง 3 นาที สามารถให้บริการผ่าน vLLM หรือรันในเครื่องผ่าน NeMo-Speech.cpp
Granary v2: ไปป์ไลน์การคัดกรองข้อมูลแบบเปิดเบื้องหลัง Transcribe
Granary v2 ถูกสร้างขึ้นด้วย NVIDIA NeMo Curator เพื่อเตรียมข้อมูลเสียงหลายภาษา โดยครอบคลุมกว่า 463,062 ชั่วโมงใน 48 ภาษา ไปป์ไลน์นี้สร้างรูปแบบบทถอดความสามรูปแบบ ทั้งแบบ verbatim และแบบสะอาด (clean) รวมถึงสร้างคำบรรยายเสียงและคู่คำถาม-คำตอบจากเสียง
| เป้าหมายการฝึกฝน | บทถอดความตัวอย่าง |
|---|---|
| Text-normalized, verbatim | I paid, uh, twenty-five euros. |
| Inverse text normalization, with disfluencies | I paid, uh, €25. |
| Inverse text normalization, without disfluencies | I paid €25. |
ตารางที่ 1. รูปแบบบทถอดความของ Granary v2 สำหรับเสียงชุดเดียวกัน
ไปป์ไลน์แบ่งเป็น 4 ขั้นตอนหลัก ได้แก่ การเตรียมข้อมูลเมตา, การถอดความ (ASR) ที่มีระบบตรวจสอบการหลอน, การสร้างป้ายกำกับงาน และการกรองคุณภาพสูง (HiFi) เพื่อให้ได้ชุดข้อมูลที่สะอาดที่สุดสำหรับการฝึกฝน
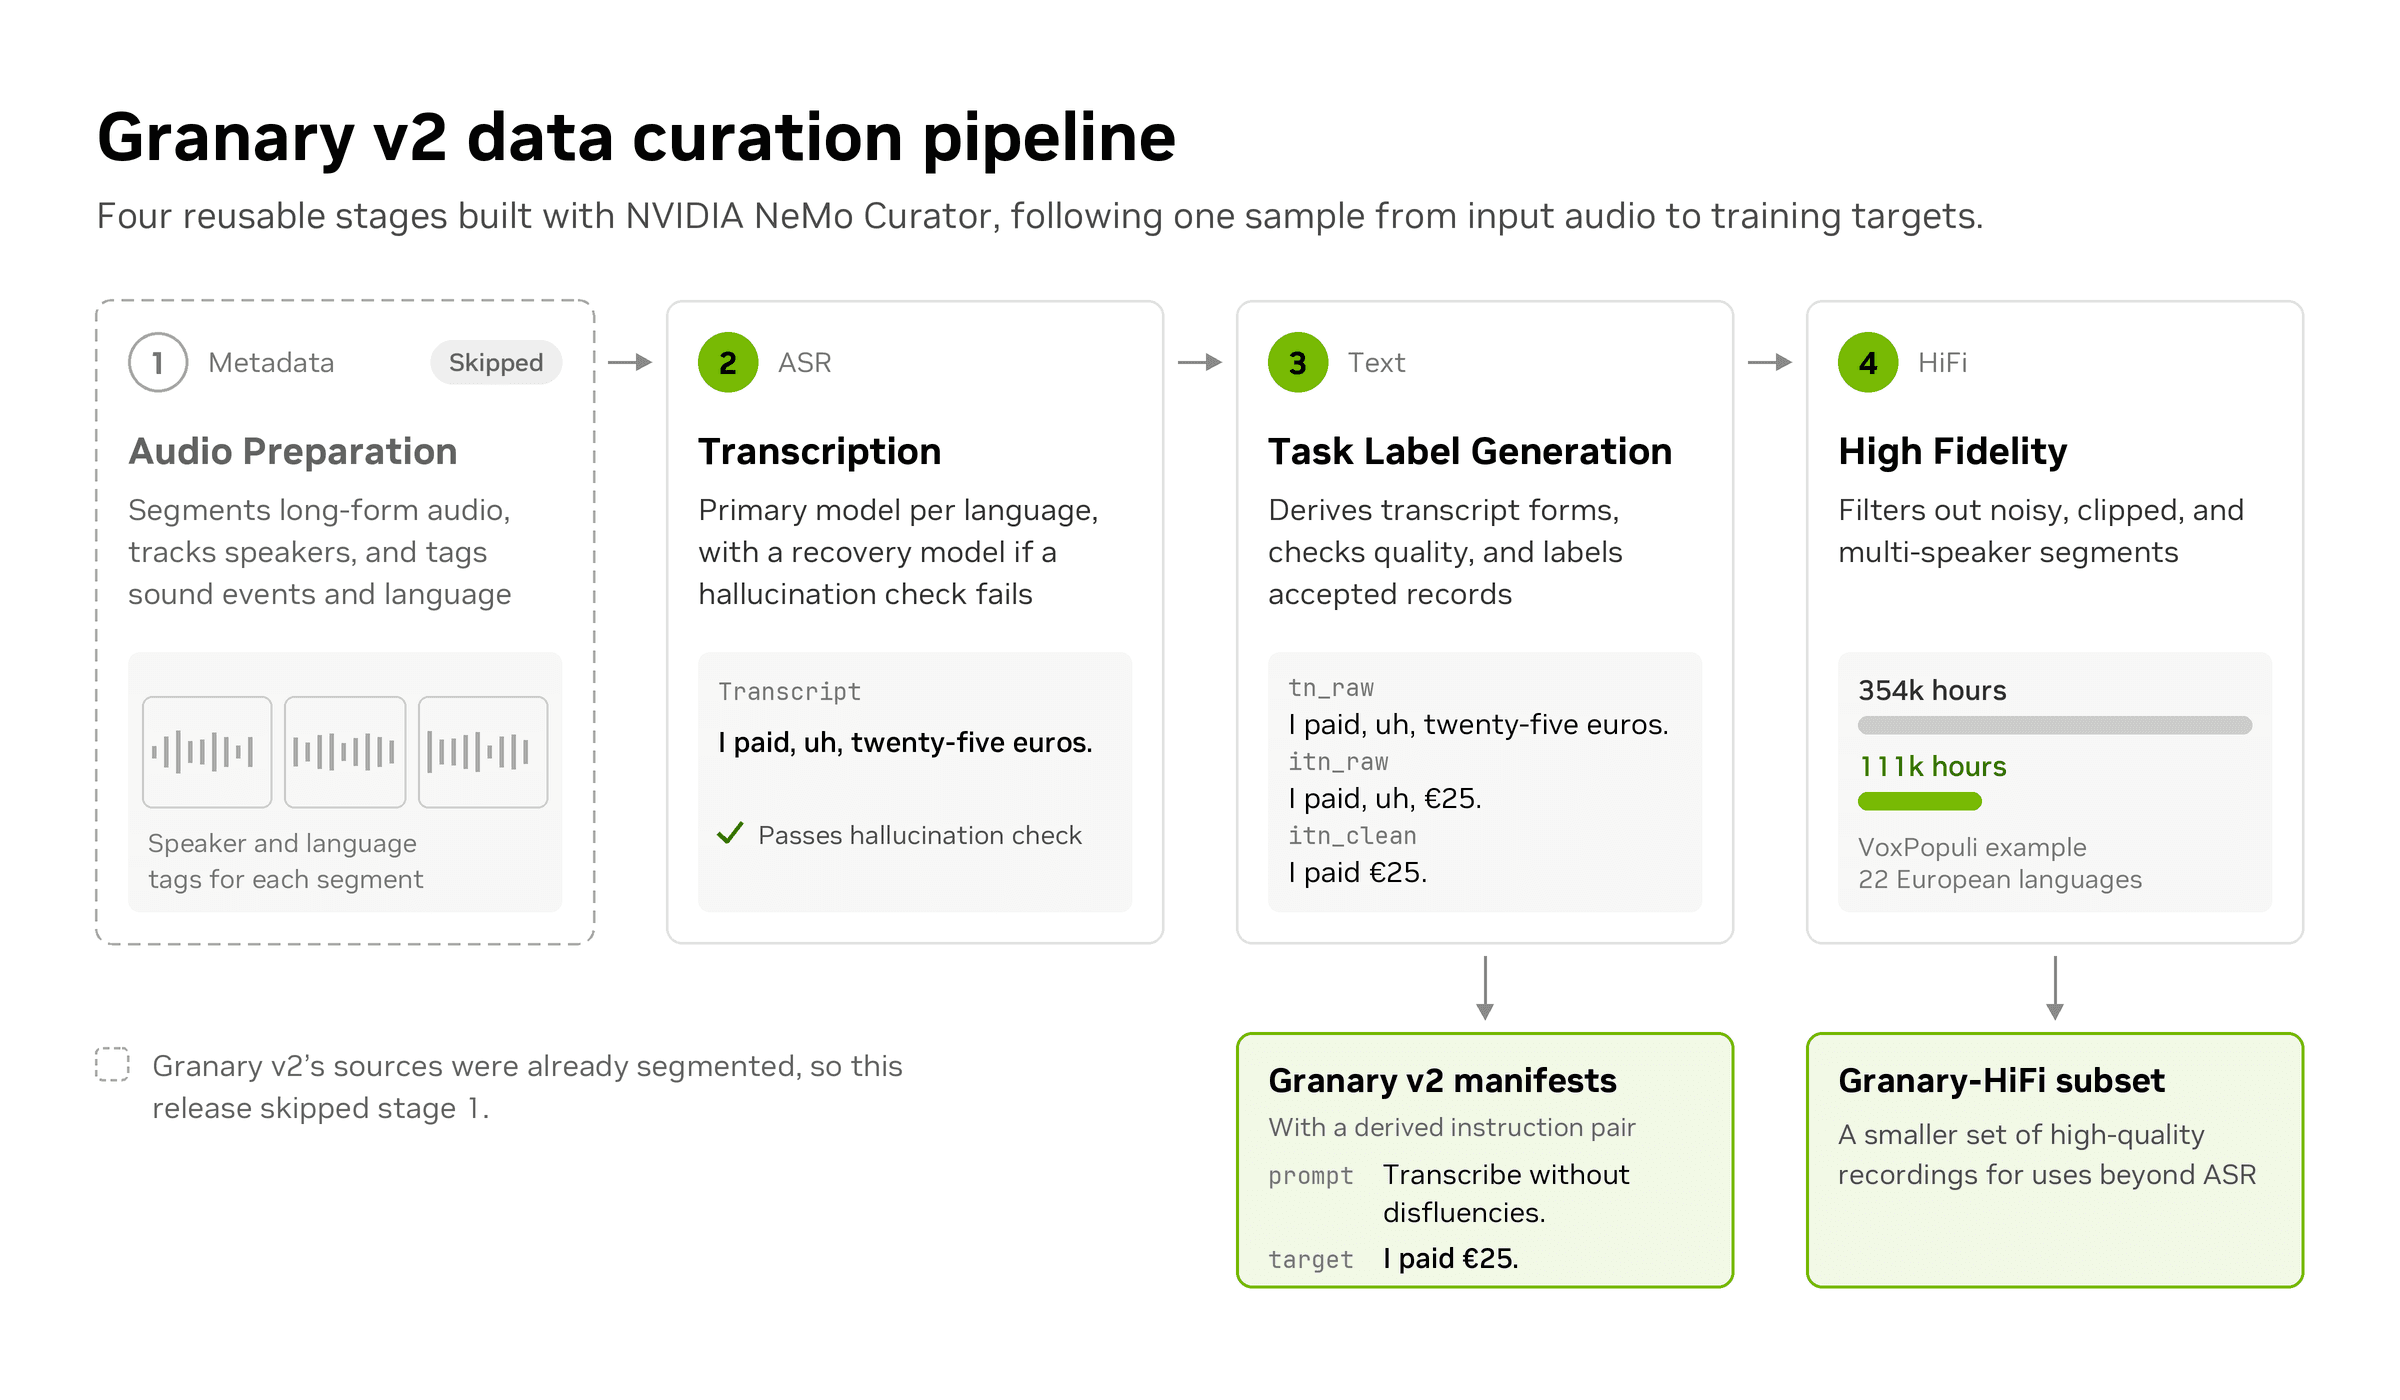
รูปที่ 6. แผนผังการทำงานของไปป์ไลน์ Granary v2 ตั้งแต่เสียงดิบจนถึงข้อมูลสำหรับการฝึกฝน
ปรับแต่งการจดจำให้เข้ากับคำศัพท์ที่สำคัญ
ในการทดสอบ ASR ทางการแพทย์ของ Eka Care การใช้พรอมต์ที่เหมาะสมช่วยลด WER จาก 30.8% เหลือ 23.8% และเมื่อผ่านการ fine-tuning ด้วย NeMo Speech โดยใช้ข้อมูลสังเคราะห์และข้อมูลสาธารณะ ค่า WER ลดลงเหลือเพียง 11.8%
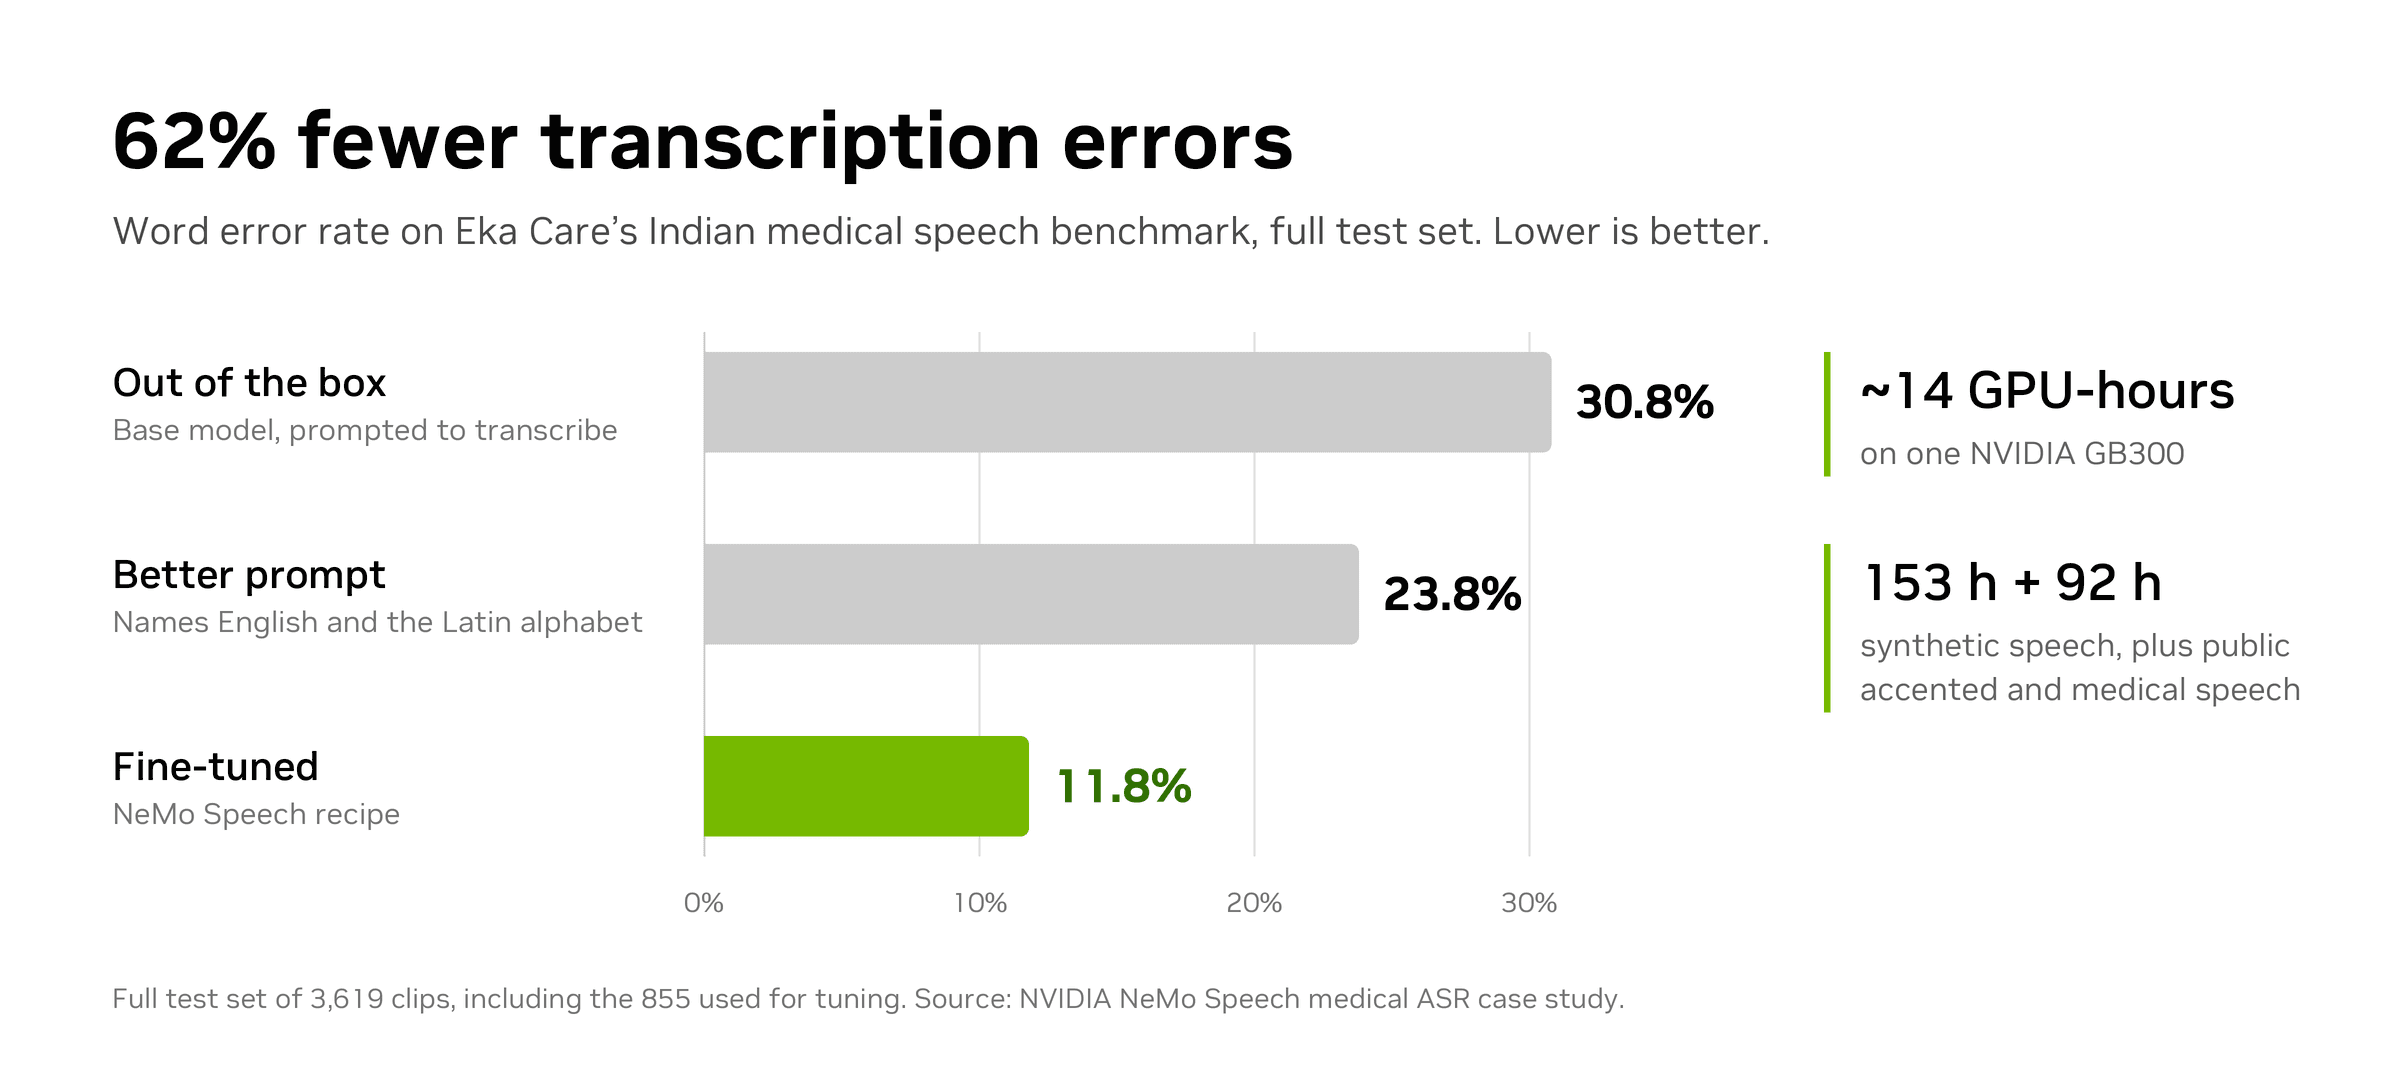
รูปที่ 7. กราฟแสดงประสิทธิภาพที่เพิ่มขึ้นจากการใช้พรอมต์และการ fine-tuning ในงานเฉพาะทางด้านการแพทย์
การปรับแต่งนี้ใช้เทคนิค LoRA บนโมเดลภาษาและใช้เวลาเพียง 14 GPU-hours บน NVIDIA GB300 หนึ่งตัว ผลลัพธ์ที่ได้คือประสิทธิภาพที่เหนือกว่าโมเดลเฉพาะทางทางการแพทย์แบบเปิดอื่นๆ และโมเดล ASR อเนกประสงค์ทั่วไป
สำหรับนักพัฒนาที่สนใจ สามารถเริ่มต้นได้จาก บทช่วยสอนการ fine-tuning หรือใช้ agent skill เพื่อให้เอเจนต์ AI ช่วยรันเวิร์กโฟลว์การปรับแต่งทั้งหมดให้โดยอัตโนมัติ
เริ่มต้นใช้งาน Nemotron 3.5 Transcribe และ Granary v2
ผู้ใช้สามารถทดลองใช้เดโมได้บน Hugging Face หรือดาวน์โหลด checkpoint ไปใช้งานเอง รวมถึงสามารถใช้บริการผ่านเอ็นพอยต์ของผู้ให้บริการอย่าง Baseten, DeepInfra หรือ Simplismart ได้ทันที
โมเดลและชุดข้อมูล
- Model Checkpoints: NVIDIA Nemotron 3.5 Transcribe บน Hugging Face, ModelScope
- Dataset Manifests: Granary v2 บน Hugging Face, ModelScope
ติดตามรายละเอียดเพิ่มเติมและบทช่วยสอนได้ที่ NVIDIA NeMo Speech GitHub
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร