
Gradium เปิดตัว Voice Design สร้างเสียงสังเคราะห์คุณภาพสูงจาก Prompt ในไม่กี่วินาที
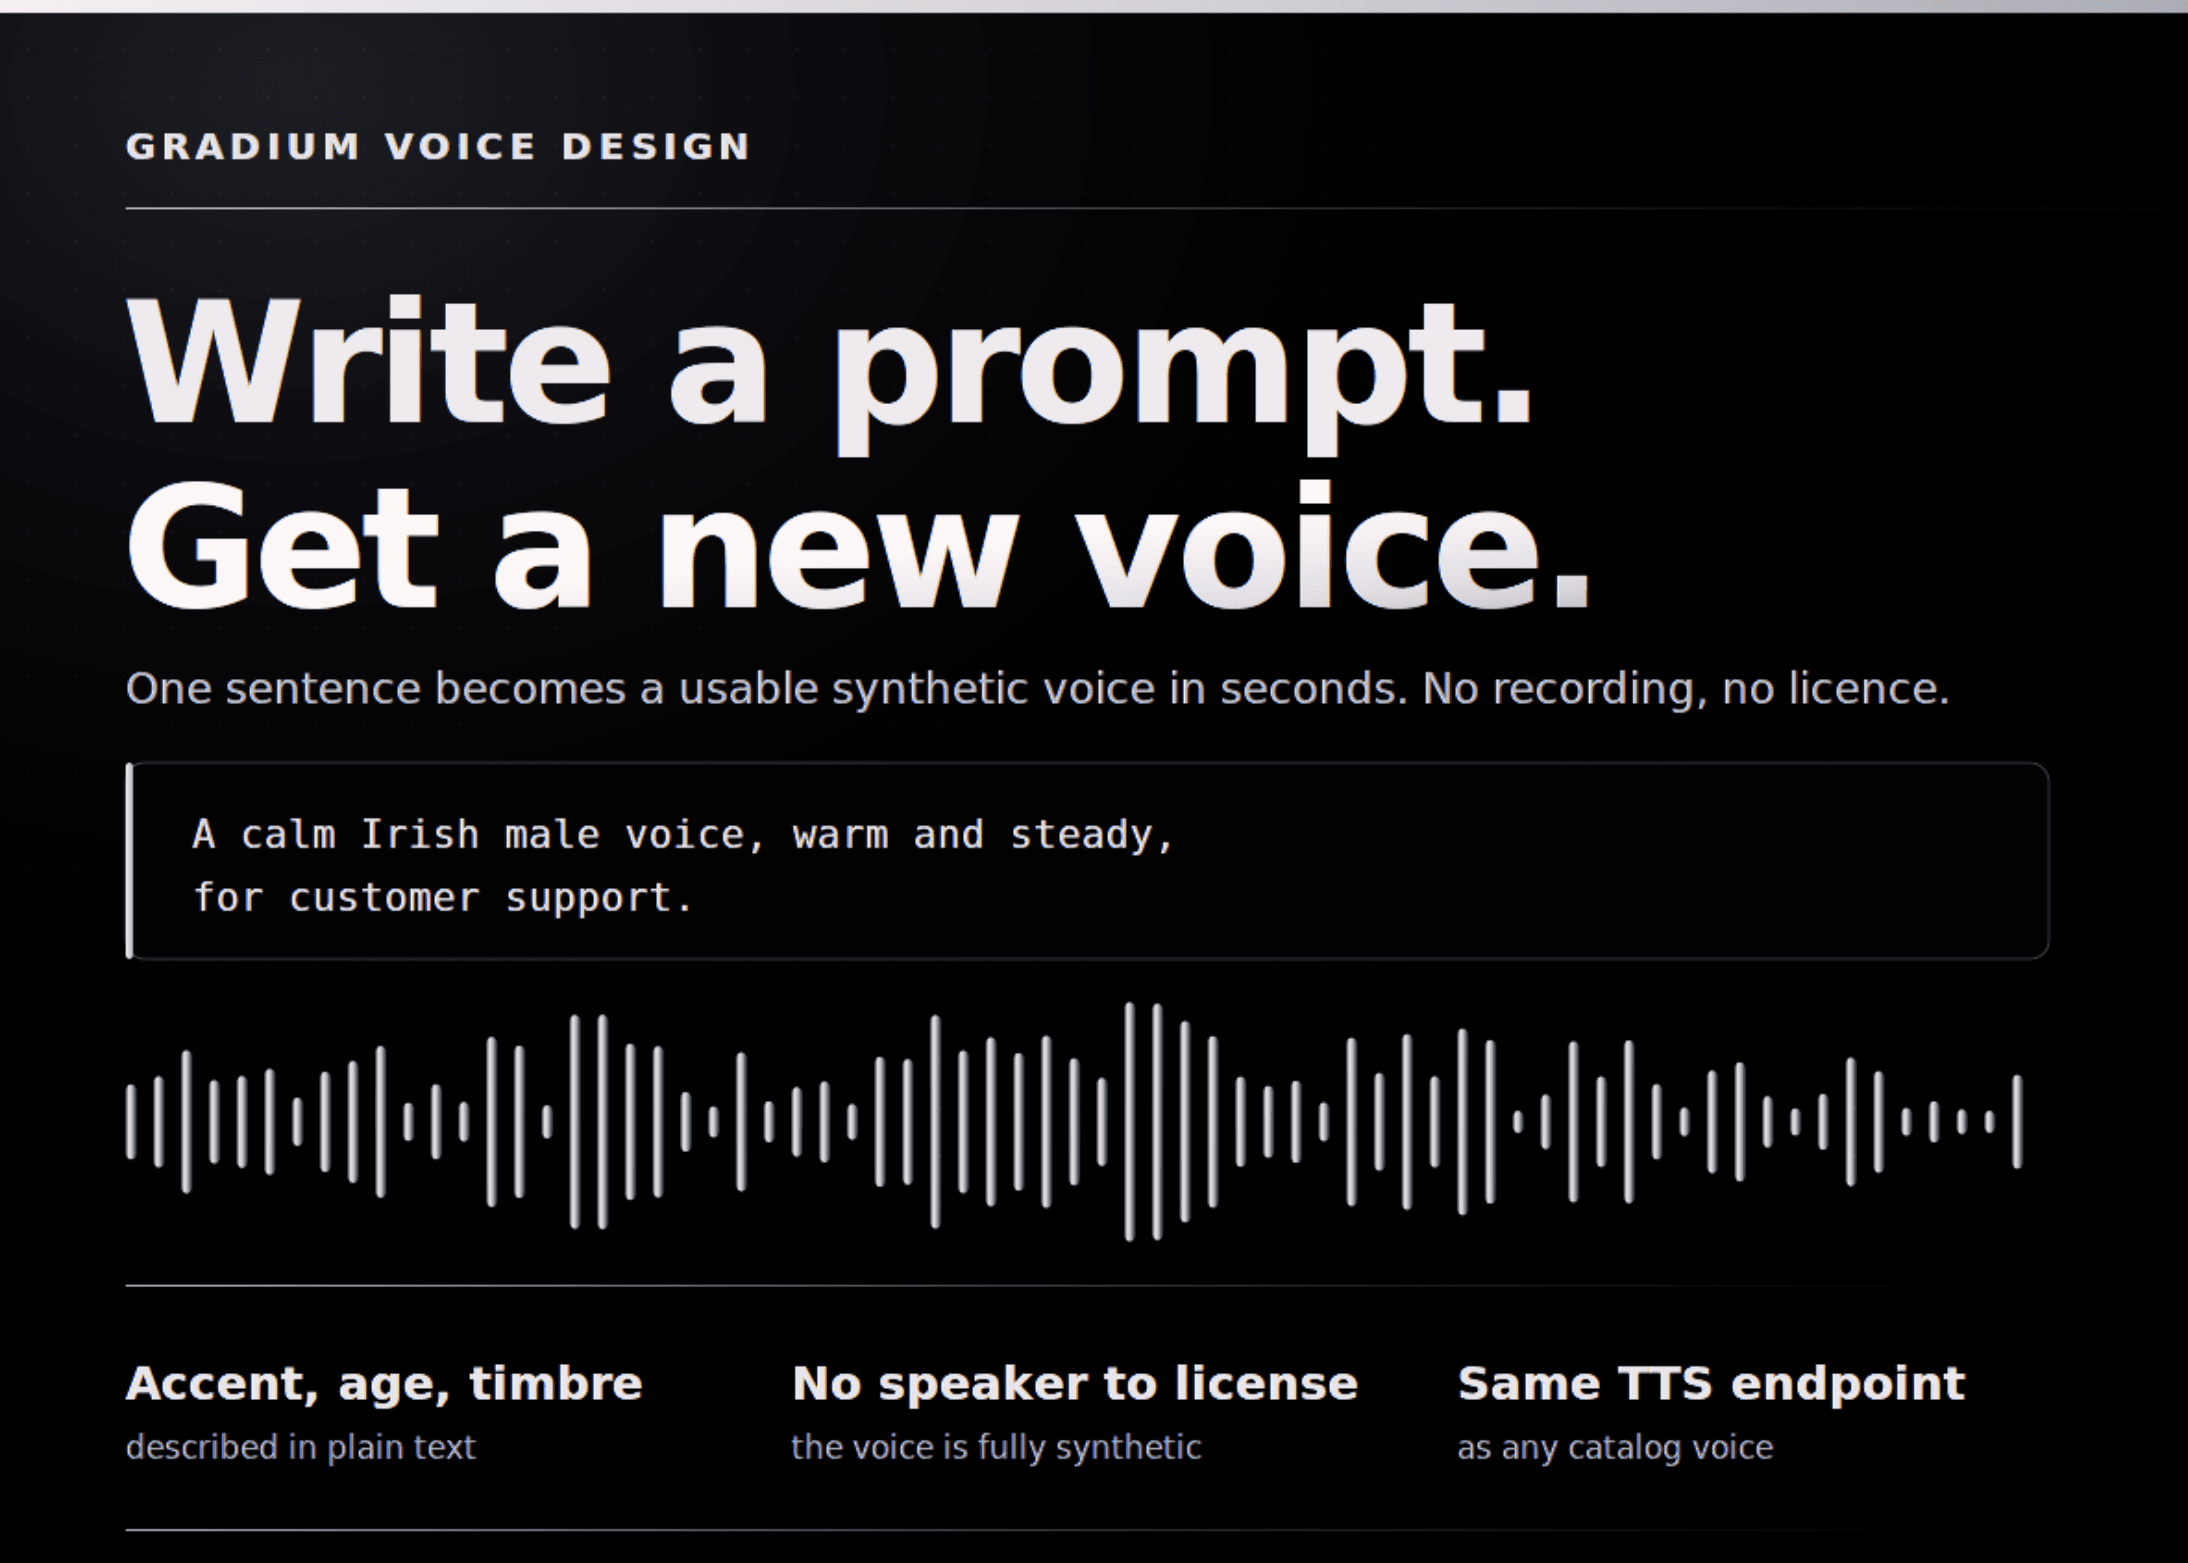
ทีมงานผู้สร้าง Voice agent มักจะประสบปัญหาข้อจำกัดของแคตตาล็อกเสียงที่มีอยู่ แม้จะมีให้เลือกกว่า 400 เสียง แต่บ่อยครั้งบรีฟงานกลับต้องการเสียงเฉพาะทางที่หาไม่ได้ เช่น พนักงานต้อนรับหญิงสำเนียงควิเบก หรือนักบรรยายวัย 60 ปีที่มีน้ำเสียงน่าเกรงขามแบบวิชาการ ซึ่งการทำ Voice Cloning ในปัจจุบันมีภาระทั้งเรื่องการจัดหาเจ้าของเสียง การขอความยินยอม และปัญหาด้านลิขสิทธิ์ที่ยุ่งยาก
Gradium บริษัท Voice AI จากปารีสที่แยกตัวมาจากห้องปฏิบัติการวิจัย Kyutai ได้นำเสนอทางออกใหม่ผ่าน Voice Design เครื่องมือที่สามารถเปลี่ยนคำอธิบายตัวอักษรให้เป็นเสียงสังเคราะห์ที่สมบูรณ์ได้ภายในไม่กี่วินาที โดยไม่จำเป็นต้องใช้ไฟล์เสียงอ้างอิง ไม่ต้องมีเจ้าของเสียง และไม่มีภาระเรื่องการเคลียร์สิทธิใดๆ
ปัจจุบัน Voice Design เปิดให้ใช้งานจริงแล้วผ่าน Gradium API และบน Studio โดยเปิดให้ใช้ฟรีในทุกแผนการใช้งาน รวมถึงแผนเริ่มต้น ซึ่งเสียงที่สร้างขึ้นจะทำงานบนระบบ Text-to-Speech (TTS) เดียวกับเสียงมาตรฐานในแคตตาล็อก ให้ค่าความหน่วง (Latency) และคุณภาพในระดับเดียวกัน
บรีฟคัดเลือกเสียงผ่าน API
ระบบนี้ใช้คำอธิบายเป็นข้อมูลนำเข้าเพียงอย่างเดียว โดย เอกสารประกอบ ของ Gradium ระบุว่าโมเดลจะตอบสนองต่อคุณลักษณะที่ละเอียดเหมือนการคัดเลือกนักแสดง ตั้งแต่เพศ ช่วงอายุ สำเนียง ระดับเสียง (pitch) จังหวะ (pace) พลังงาน เนื้อเสียง (timbre) ไปจนถึงท่าทางและหน้าที่ของเสียงนั้นๆ
ผู้ใช้สามารถป้อนคำอธิบายความยาว 1 ถึง 500 ตัวอักษร ได้ทั้งภาษาอังกฤษ ฝรั่งเศส สเปน โปรตุเกส และเยอรมัน โดย Gradium แนะนำให้ระบุวัตถุประสงค์การใช้งานในตอนท้ายเพื่อควบคุมระดับภาษาให้แม่นยำยิ่งขึ้น ซึ่งการขอหนึ่งครั้งจะส่งคืนผู้สมัคร 1 ถึง 5 รายภายในเวลา 3 ถึง 5 วินาที โดยแต่ละรายจะเป็นตัวแปรที่แตกต่างกันภายใต้โจทย์เดียวกัน
จากการทดสอบสู่การใช้งานจริงในโปรดักชัน
ขั้นตอนการทำงานแบ่งออกเป็น 4 ขั้นตอนหลัก เริ่มจากการเรียกใช้ POST /voice-generator/generate เพื่อสร้างรายชื่อผู้สมัคร จากนั้นใช้ GET /voice-generator/embeddings เพื่อตรวจสอบสถานะ เมื่อเสียงพร้อมแล้วจะสามารถทดสอบผ่าน TTS endpoint ปกติโดยใช้ voice_id ของผู้สมัคร และสุดท้ายคือการบันทึกเสียงที่เลือกด้วย POST /voices/from-embedding เพื่อนำไปใช้งานถาวร
สำหรับข้อจำกัดในช่วงทดสอบ ผู้สมัครที่ยังไม่ได้ถูกบันทึกจะรองรับข้อความสูงสุด 100 ตัวอักษรและใช้ได้เฉพาะ REST API เท่านั้น โดยจะมีอายุการใช้งาน 30 วันก่อนถูกลบอัตโนมัติ หากทำการบันทึกเพื่อใช้งานจริง (ซึ่งไม่มีค่าใช้จ่ายเพิ่ม) จะสามารถใช้ได้ทั้ง WebSocket และ Speech-to-Speech โดยจะแชร์พื้นที่ในช่อง Custom Voice ร่วมกับเสียงที่ทำ Cloning
การสุ่มตัวอย่างถูกออกแบบให้เป็นแบบ non-deterministic โดยทีม Gradium จะใช้วิธีขยายความคำอธิบาย (prompt expansion) ที่แตกต่างกันในทุกครั้ง ทำให้แม้จะใช้ Prompt เดิมและค่า seed คงที่ ก็จะได้ผลลัพธ์ของเสียงที่เปลี่ยนแปลงไปในแต่ละครั้งที่ส่งคำขอใหม่
เกณฑ์มาตรฐานและประสิทธิภาพการแข่งขัน
Gradium ได้ทดสอบการฟังแบบจับคู่ปกปิด (Blind pairwise listening test) ในสำเนียงต่างๆ ผ่านระบบ Voice Design ของผู้ให้บริการ 6 ราย ใน 5 ภาษา พบว่าจากการเปรียบเทียบกว่า 7,627 ครั้ง Gradium มีอัตราการชนะสูงถึง 72.6% นำหน้า ElevenLabs (รุ่น eleven_ttv_v3) ที่ทำได้ 59.0% ตามมาด้วย Inworld, Fish Audio และ MiniMax
จุดแข็งที่โดดเด่นคือสำเนียงท้องถิ่นเฉพาะทางที่แคตตาล็อกส่วนใหญ่มักทำได้ไม่ชัดเจน เช่น ภาษาฝรั่งเศสแบบควิเบกที่มีอัตราการชนะสูงถึง 97% และภาษาสเปนแบบริโอพลาเทนเซ่ที่ 86% สอดคล้องกับผลการให้คะแนนจากโมเดล AI อย่าง Gemini 3.1 Pro ที่ให้คะแนน Gradium สูงสุดที่ 4.06 เต็ม 5 นอกจากนี้ยังมีค่าความสามารถในการปฏิบัติตามคำสั่ง (Prompt Adherence) อยู่ที่ 83.4% บนชุดทดสอบ InstructTTSEval ด้วย
สรุปประเด็นสำคัญ
- Voice Design แปลงคำอธิบายให้เป็นเสียงใหม่ได้สูงสุด 5 เสียงในเวลาไม่กี่วินาทีโดยไม่ต้องใช้เสียงต้นแบบ
- เปิดให้ใช้งานฟรีทุกแผน ครอบคลุมการทำงานทั้งบน API และ Studio ใน 5 ภาษาหลัก
- ชนะการทดสอบ Blind Test สูงสุดที่ 72.6% โดยโดดเด่นเป็นพิเศษในด้านสำเนียงท้องถิ่นเฉพาะทาง
- เสียงที่ถูกบันทึกจะสามารถใช้งานได้ครบทุกฟีเจอร์ ทั้ง REST, WebSocket และ Speech-to-Speech
- ระบบเป็นแบบ non-deterministic ทำให้การส่งคำขอแต่ละครั้งได้เสียงที่เป็นเอกลักษณ์ไม่ซ้ำกัน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร