
Open TTS Leaderboard มาตรฐานใหม่ประเมินโมเดลสร้างเสียงหลายภาษา
ความเร็วในการเปิดตัวโมเดล Text-to-Speech (TTS) แบบโอเพนซอร์สนั้นน่าทึ่งมาก โดยข้อมูลบน Hugging Face Hub ณ วันที่ 30 กันยายน 2026 พบว่ามี โมเดล TTS มากกว่า 8,000 โมเดล ให้เลือกใช้งาน 🚀
อย่างไรก็ตาม การประเมินผลยังขาดมาตรฐานและกระจัดกระจาย โดยปัจจุบันมักใช้คะแนนความพึงพอใจจากมนุษย์อย่าง MOS หรือ MUSHRA (ข้อมูลเพิ่มเติมเกี่ยวกับ ตัวชี้วัด) ทำให้เกิดการสร้างลีดเดอร์บอร์ดแบบ Arena หลายแห่งเพื่อเป็นจุดอ้างอิงให้ชุมชน เช่น:
ระบบ Arena เหล่านี้จะใช้วิธีเปรียบเทียบผลลัพธ์จากสองโมเดลและให้ผู้ใช้เลือกตัวที่ชอบที่สุด จากนั้นจึงนำคะแนนมาคำนวณเป็น คะแนน Elo เพื่อจัดอันดับ ซึ่งมักใช้โมเดล Bradley - Terry ในการวิเคราะห์ (ดู วิธีการของ Voice Arena)
แม้ความชอบของมนุษย์จะเป็นตัวตัดสินที่ดีที่สุด แต่ระบบ Arena ไม่สามารถขยายตัวได้ทันกับความเร็วในการเปิดตัวโมเดลใหม่ๆ เห็นได้จาก ณ วันที่ 30 กันยายน 2026 มีเพียง 16 จาก 92 โมเดลใน Artificial Analysis เท่านั้นที่เป็นแบบ open-weights เช่นเดียวกับใน Voice Arena ที่มีสัดส่วนใกล้เคียงกัน ปัจจัยสำคัญมาจากความสะดวกในการเพิ่มโมเดลผ่าน API Key ของผู้ให้บริการเชิงพาณิชย์ ในขณะที่โมเดลเปิดต้องใช้ทรัพยากรในการโฮสต์ นอกจากนี้ความสม่ำเสมอของเกณฑ์การให้คะแนนจากมนุษย์ยังควบคุมได้ยากตามกาลเวลา
ด้วยเหตุนี้ เราจึงได้สร้าง Open TTS Leaderboard ขึ้นมา โดยใช้ตัวชี้วัดเชิงวัตถุเพื่อประเมินประสิทธิภาพใน 3 ด้านหลัก:
- ความชัดเจน (Intelligibility): วัดอัตราความผิดพลาดของคำ (WER) และตัวอักษร (CER) โดยใช้ Qwen3 ASR ซึ่งเป็นโมเดลอันดับต้นๆ บน Open ASR Leaderboard
- ความเร็ว (Speed): วัดผ่านค่าผกผันของ Real-Time Factor (RTFx) สำหรับการประมวลผลแบบกลุ่ม และ Time-to-First-Audio (TTFA) เพื่อดูความหน่วงในการสตรีมบน GPU H200 และ CPU
- ความคล้ายคลึงของผู้พูด (Speaker similarity): คำนวณค่า Cosine Similarity (SIM) ระหว่าง WavLM speaker embeddings ของเสียงที่สร้างขึ้นเทียบกับต้นฉบับ
การใช้ตัวชี้วัดเชิงวัตถุช่วยรัดเวลาการประเมินจากหลายสัปดาห์เหลือเพียงไม่กี่ชั่วโมง ⚡ แม้ว่า WER หรือ SIM จะไม่ได้วัดความเป็นธรรมชาติและความรู้สึกโดยตรง แต่มันเป็นข้อมูลสำคัญในการคัดกรองโมเดลเข้าสู่กระบวนการทดสอบโดยมนุษย์ต่อไป
การประเมินหลายภาษาและการโคลนเสียง
ในเบื้องต้น ลีดเดอร์บอร์ดจะจัดอันดับตามค่าเฉลี่ย macro WER ในภาษาอังกฤษจากชุดข้อมูล Seed TTS Eval (paper) และ CV3 Eval (paper)
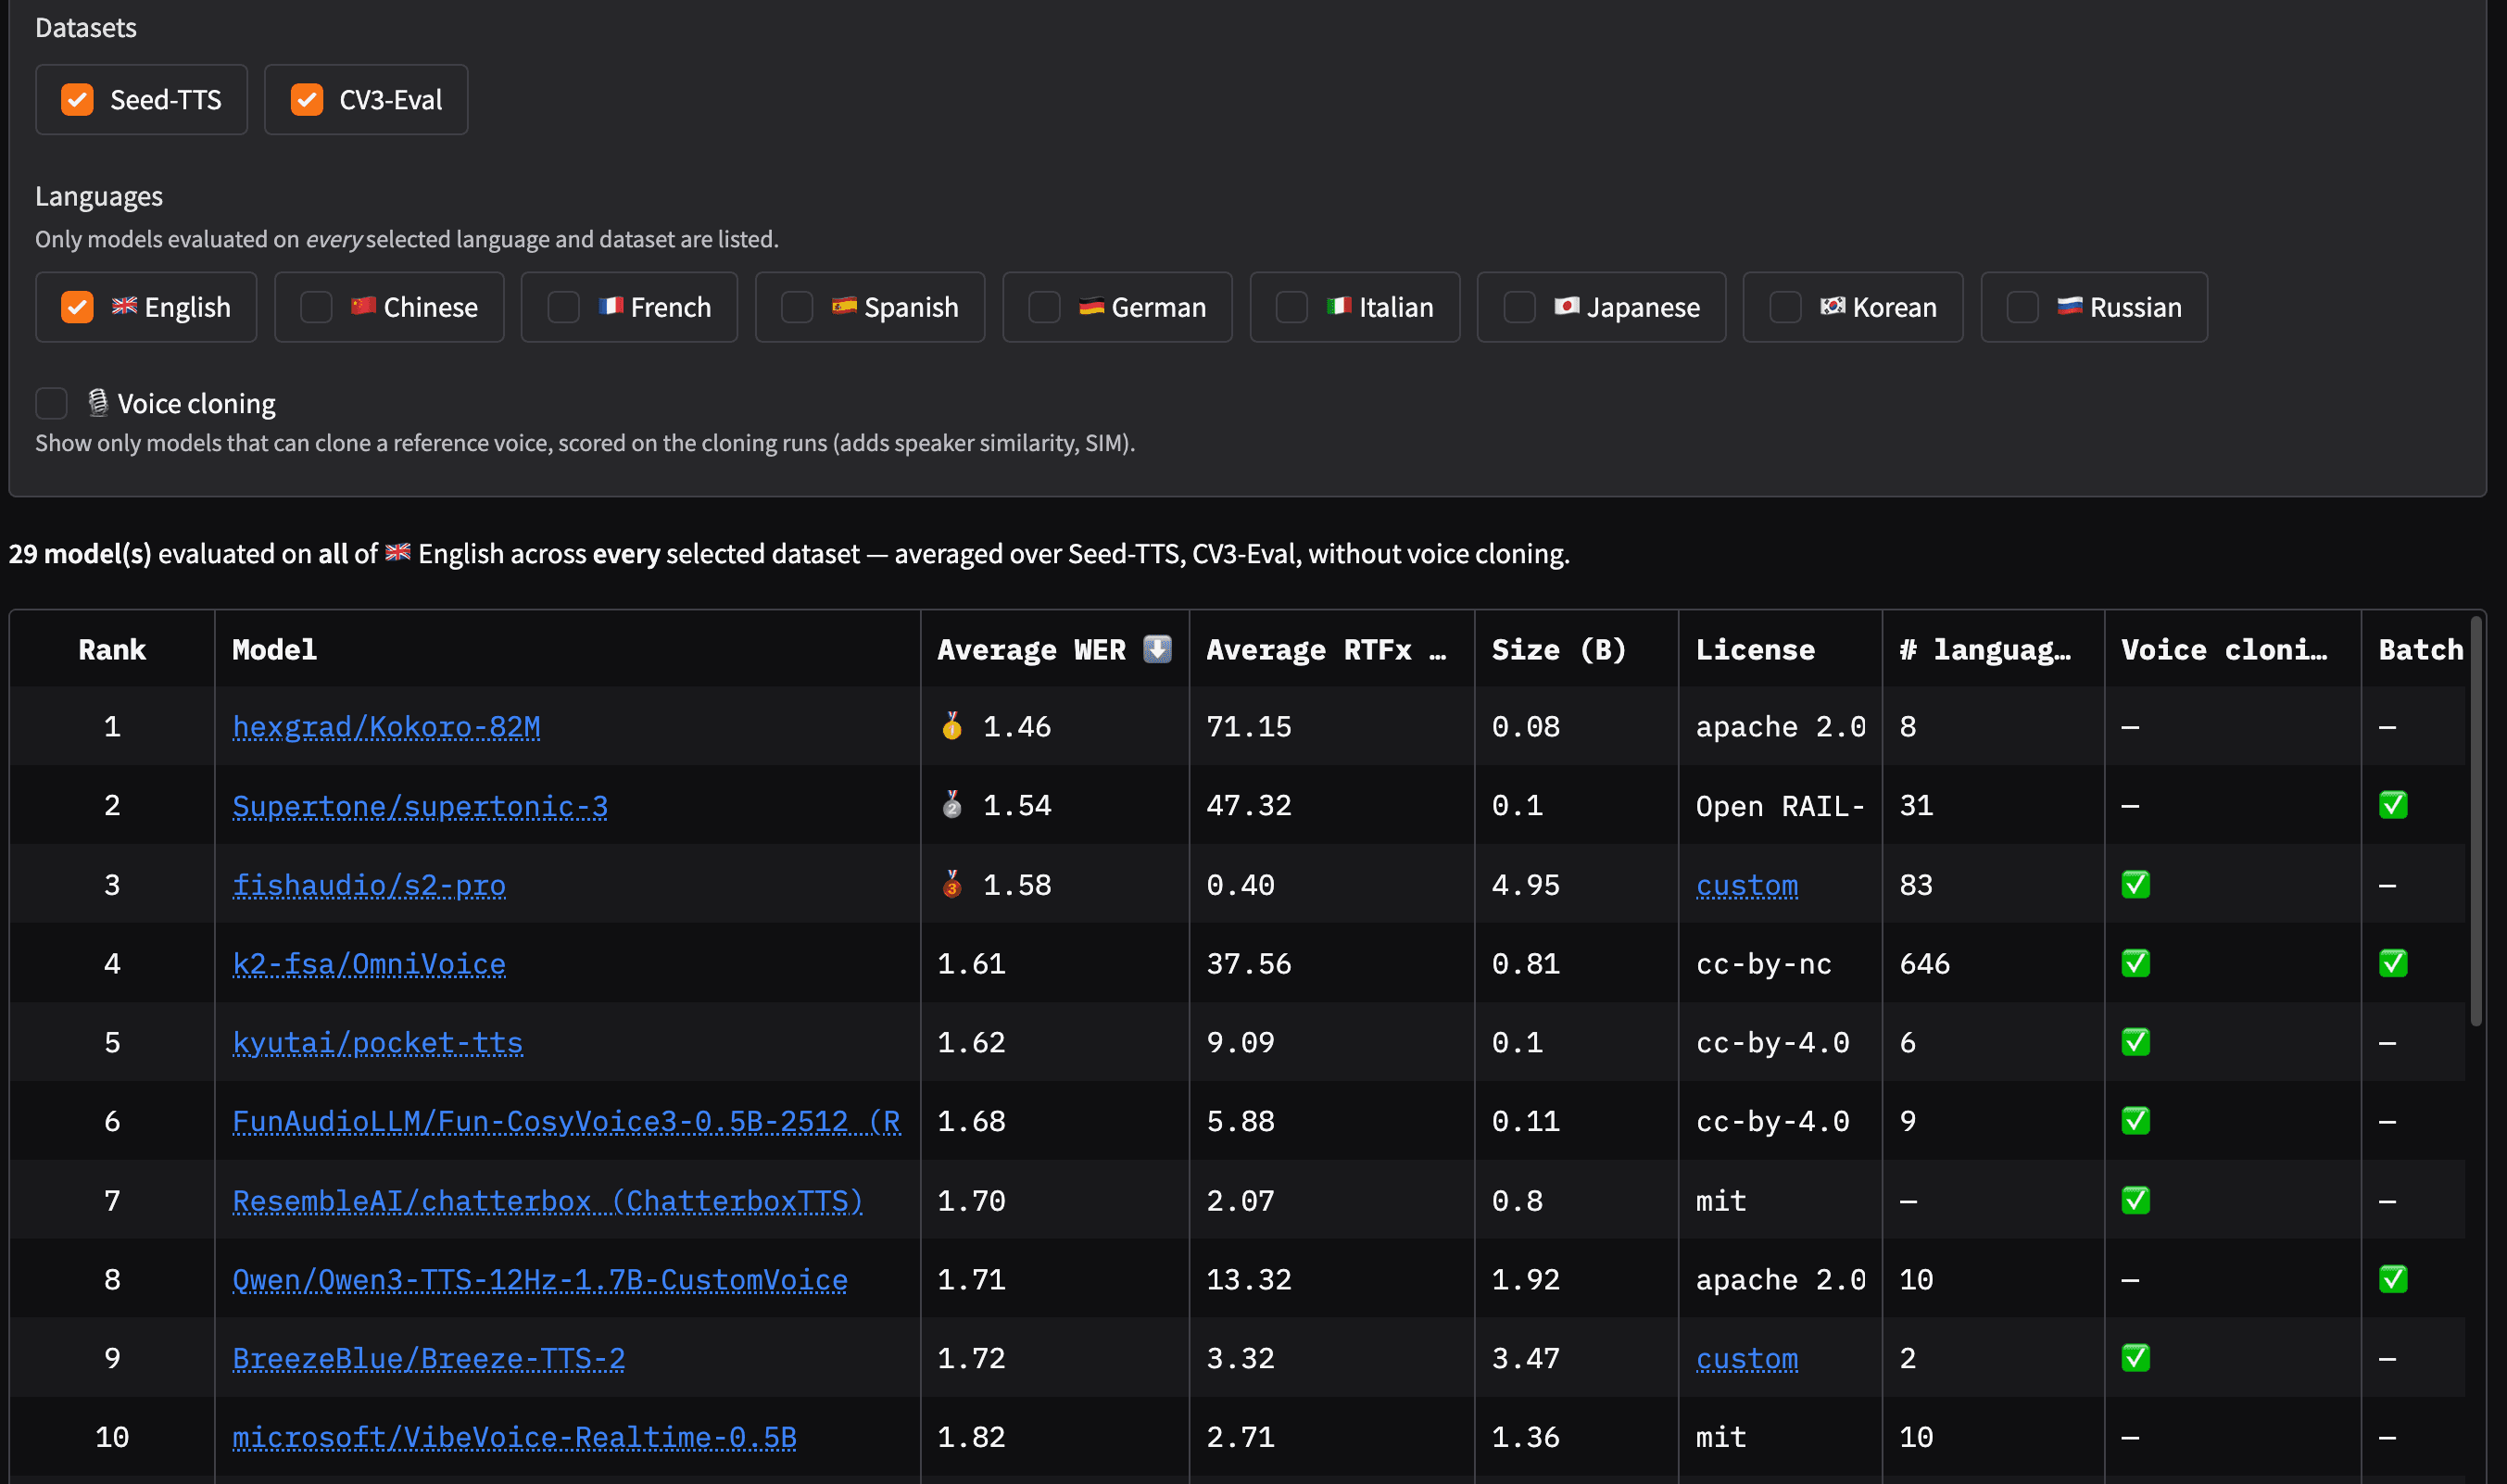
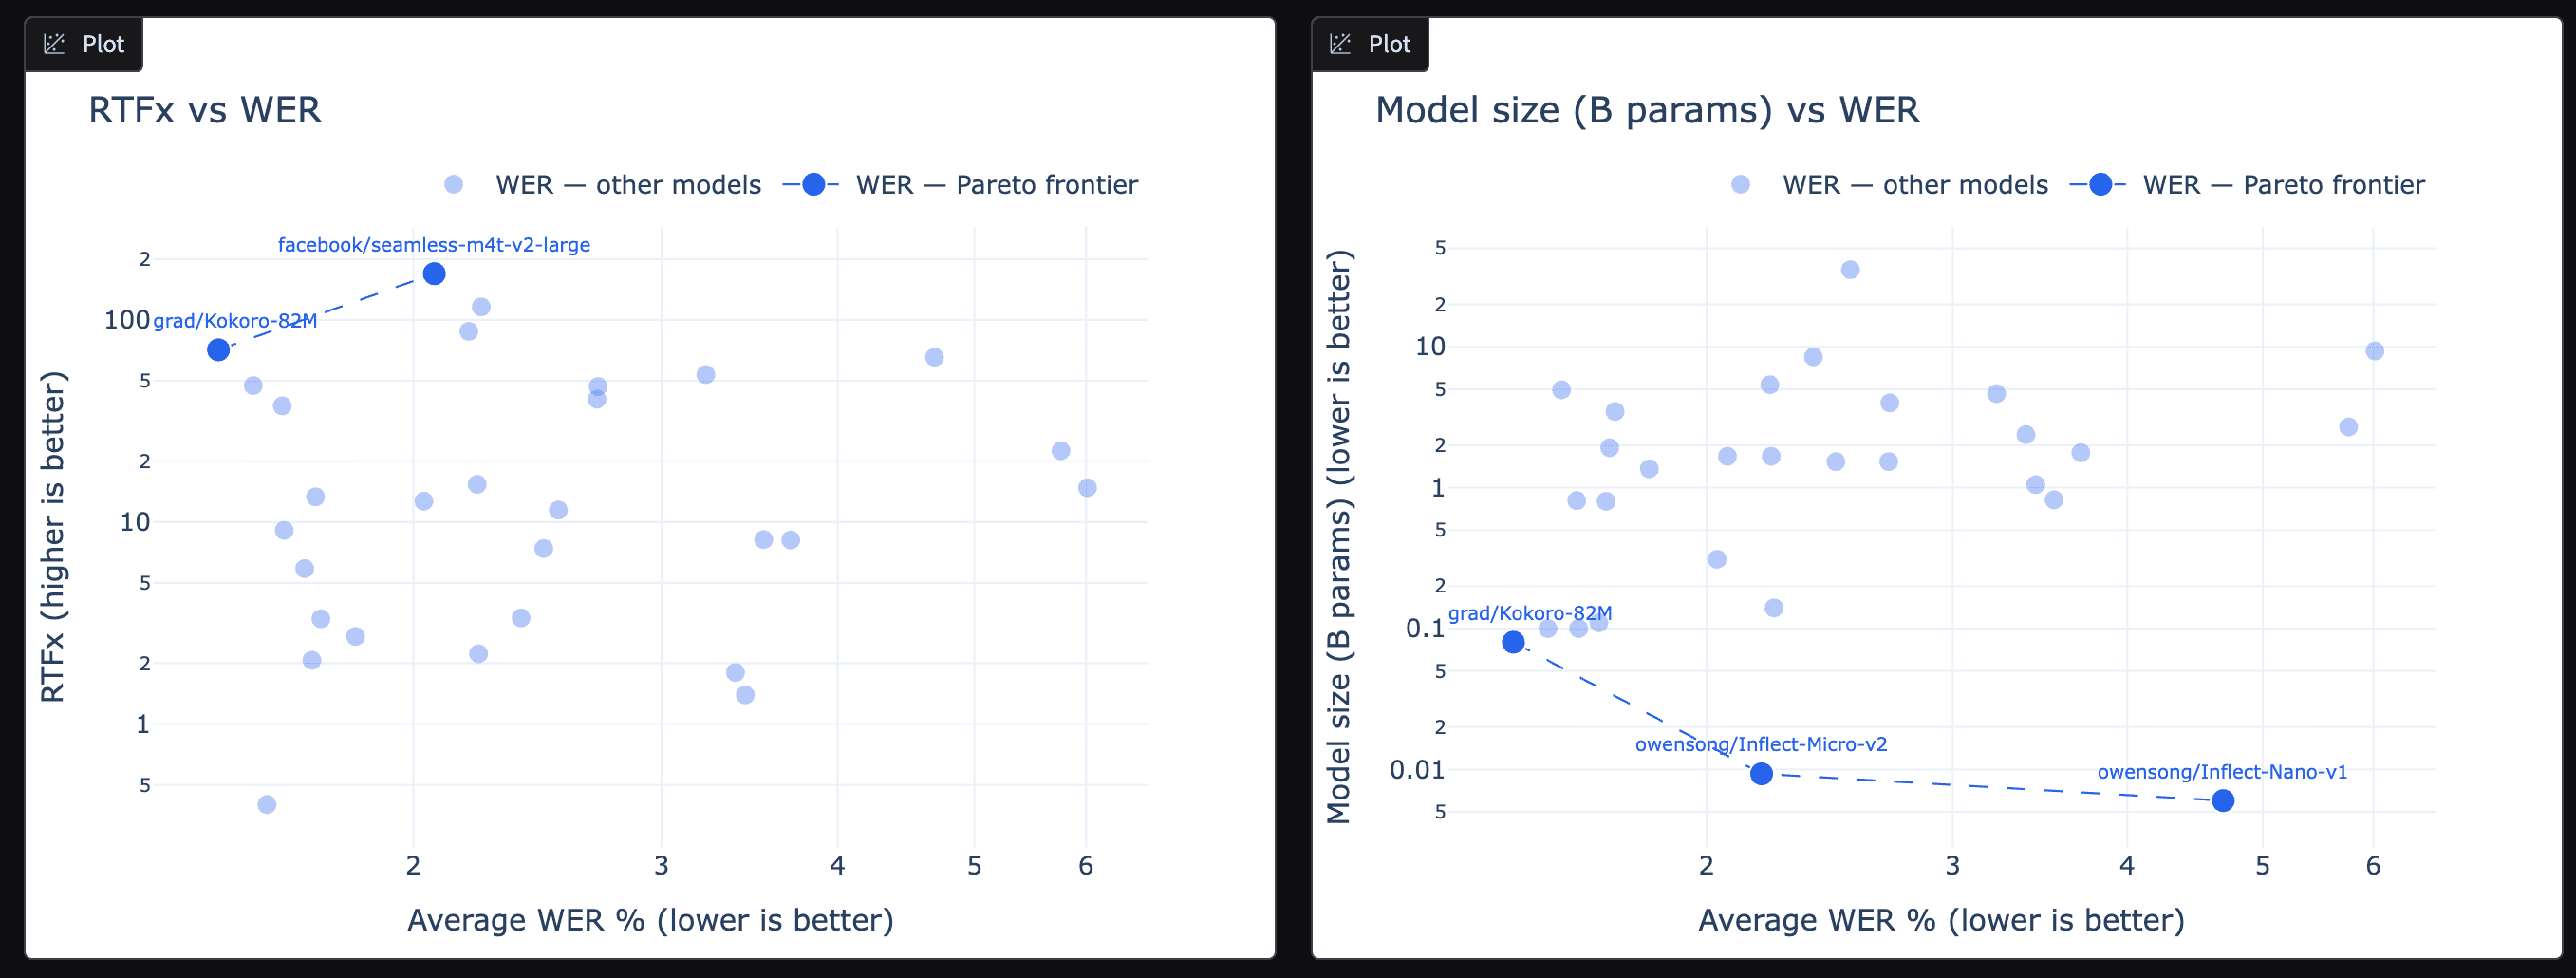
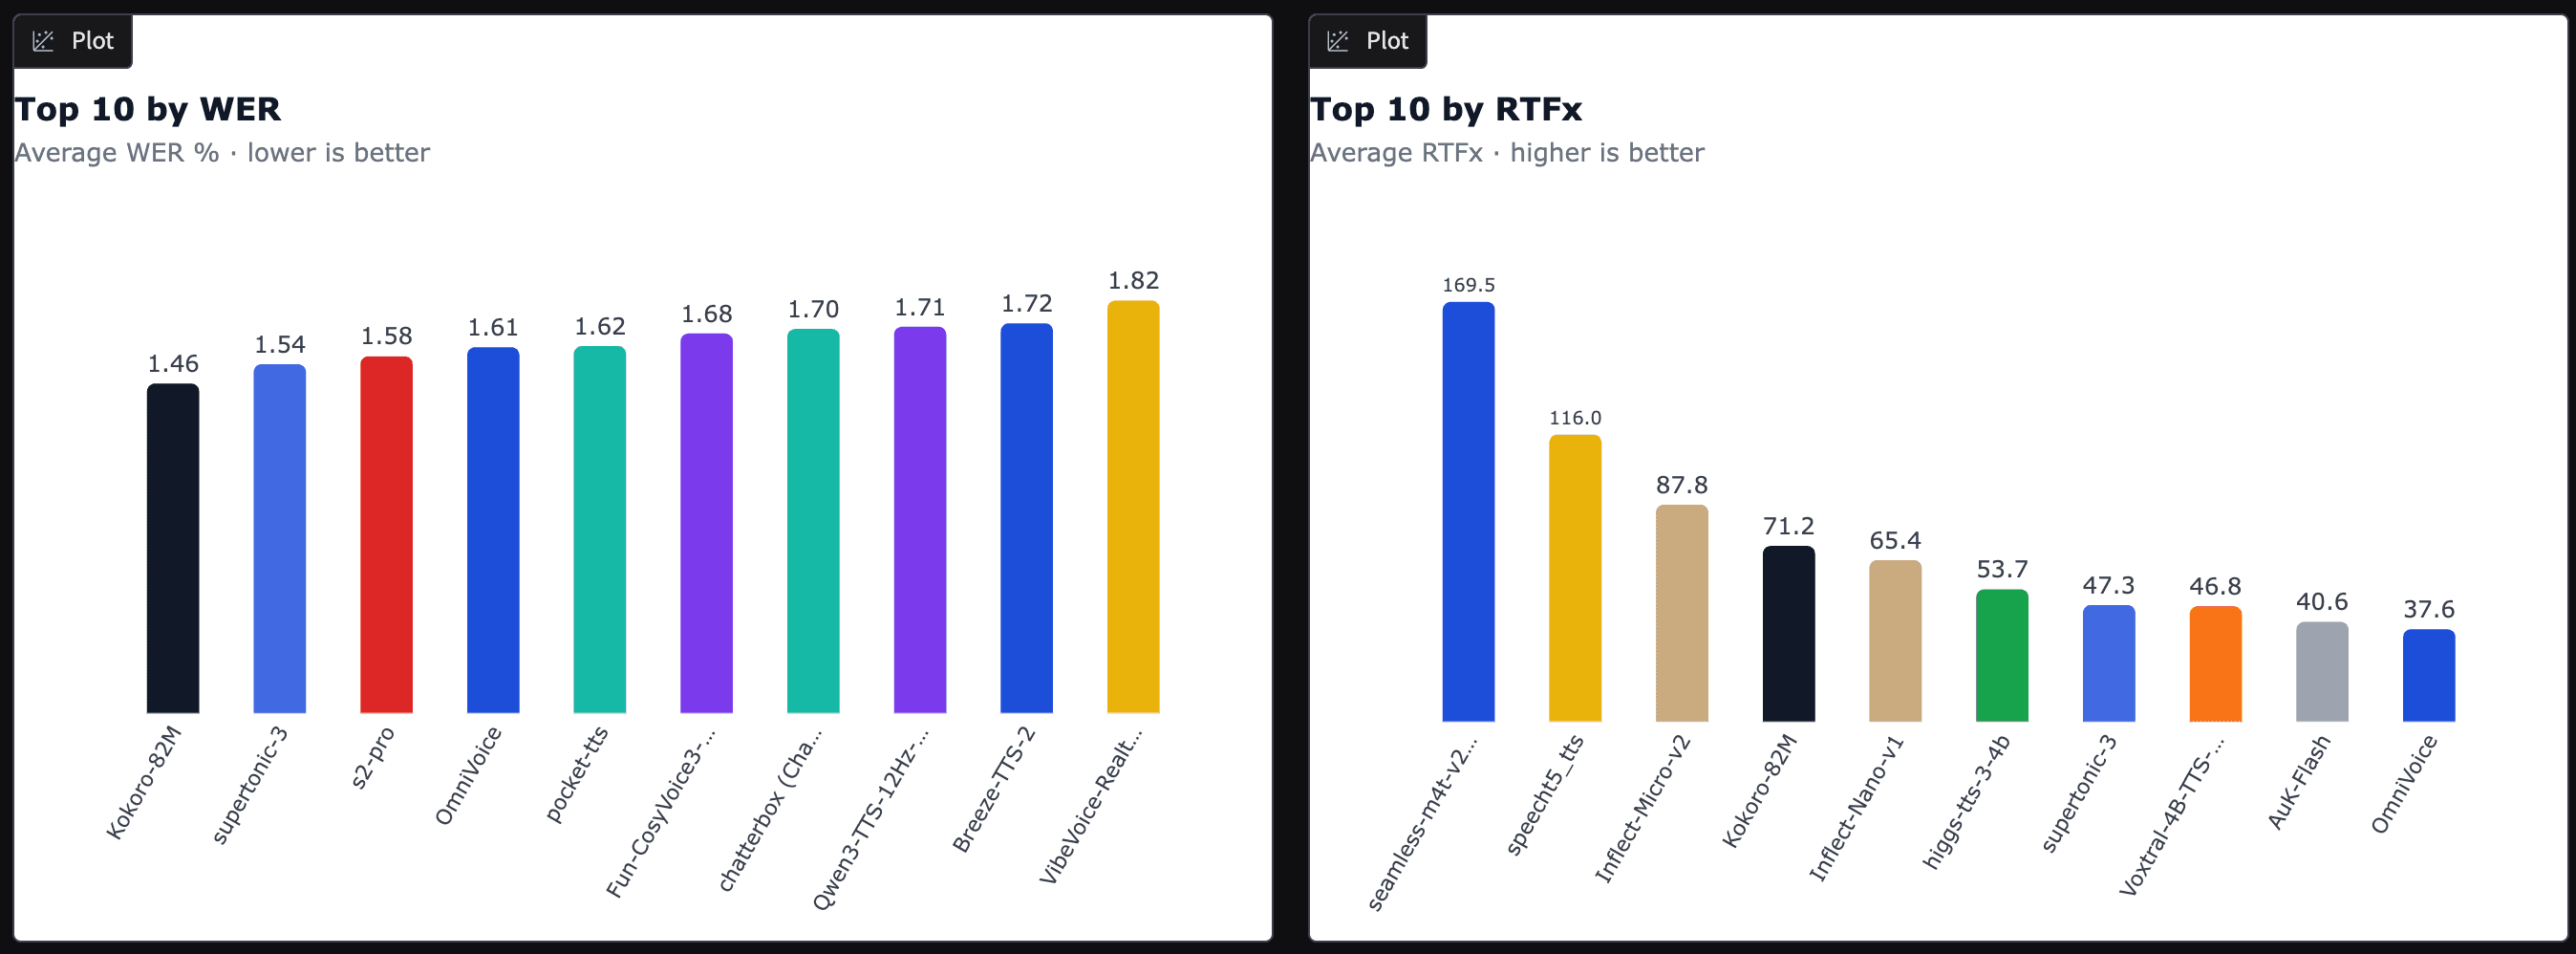
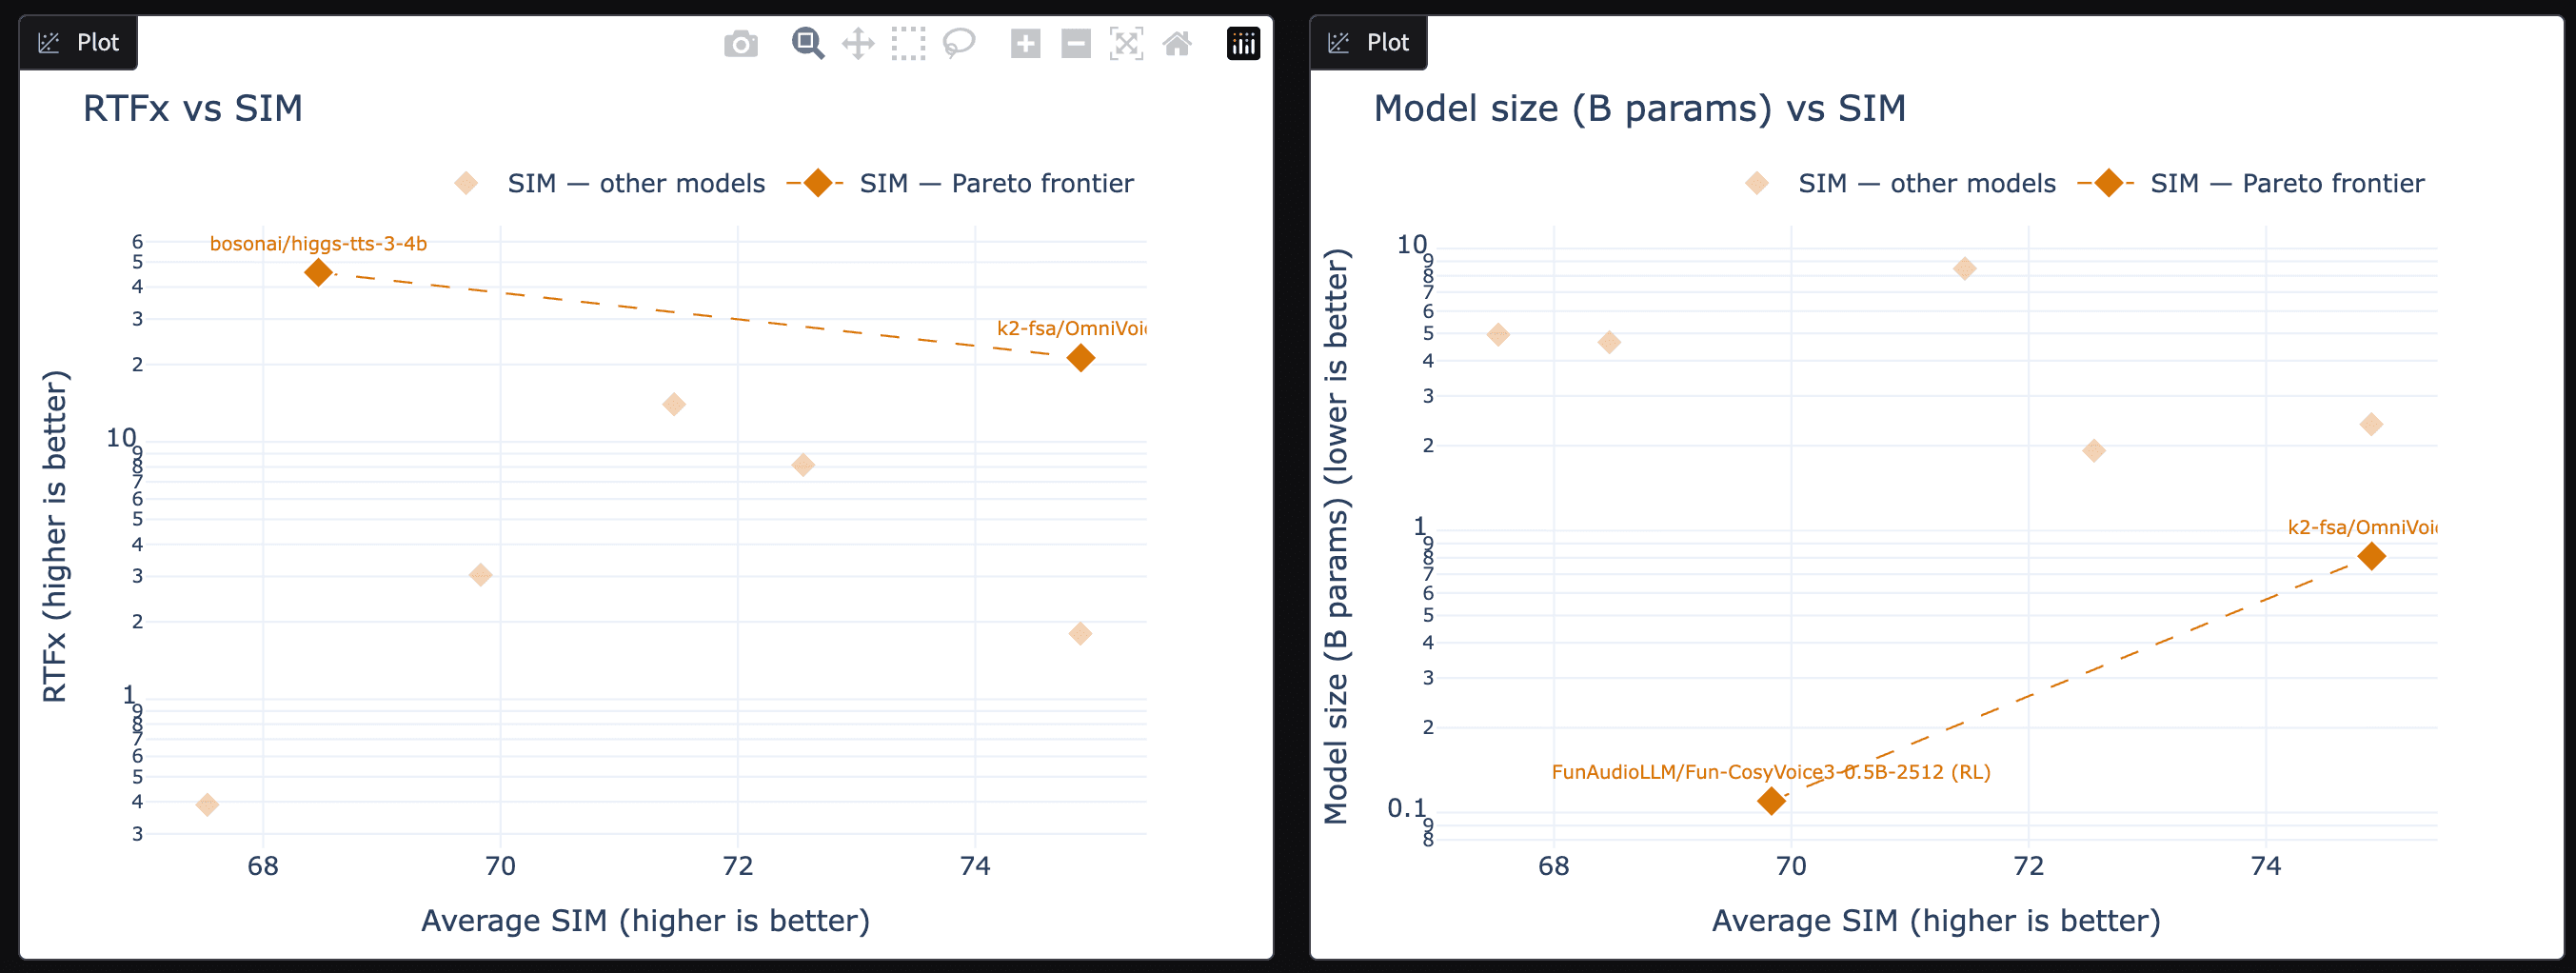
โมเดลอย่าง hexgrad/Kokoro-82M, Supertone/supertonic-3 และ fishaudio/s2-pro คือผู้นำในด้าน WER ภาษาอังกฤษ โดยแผนภูมิ Pareto จะแสดงให้เห็นจุดสมดุลระหว่างความแม่นยำ ความเร็ว และขนาดของโมเดล
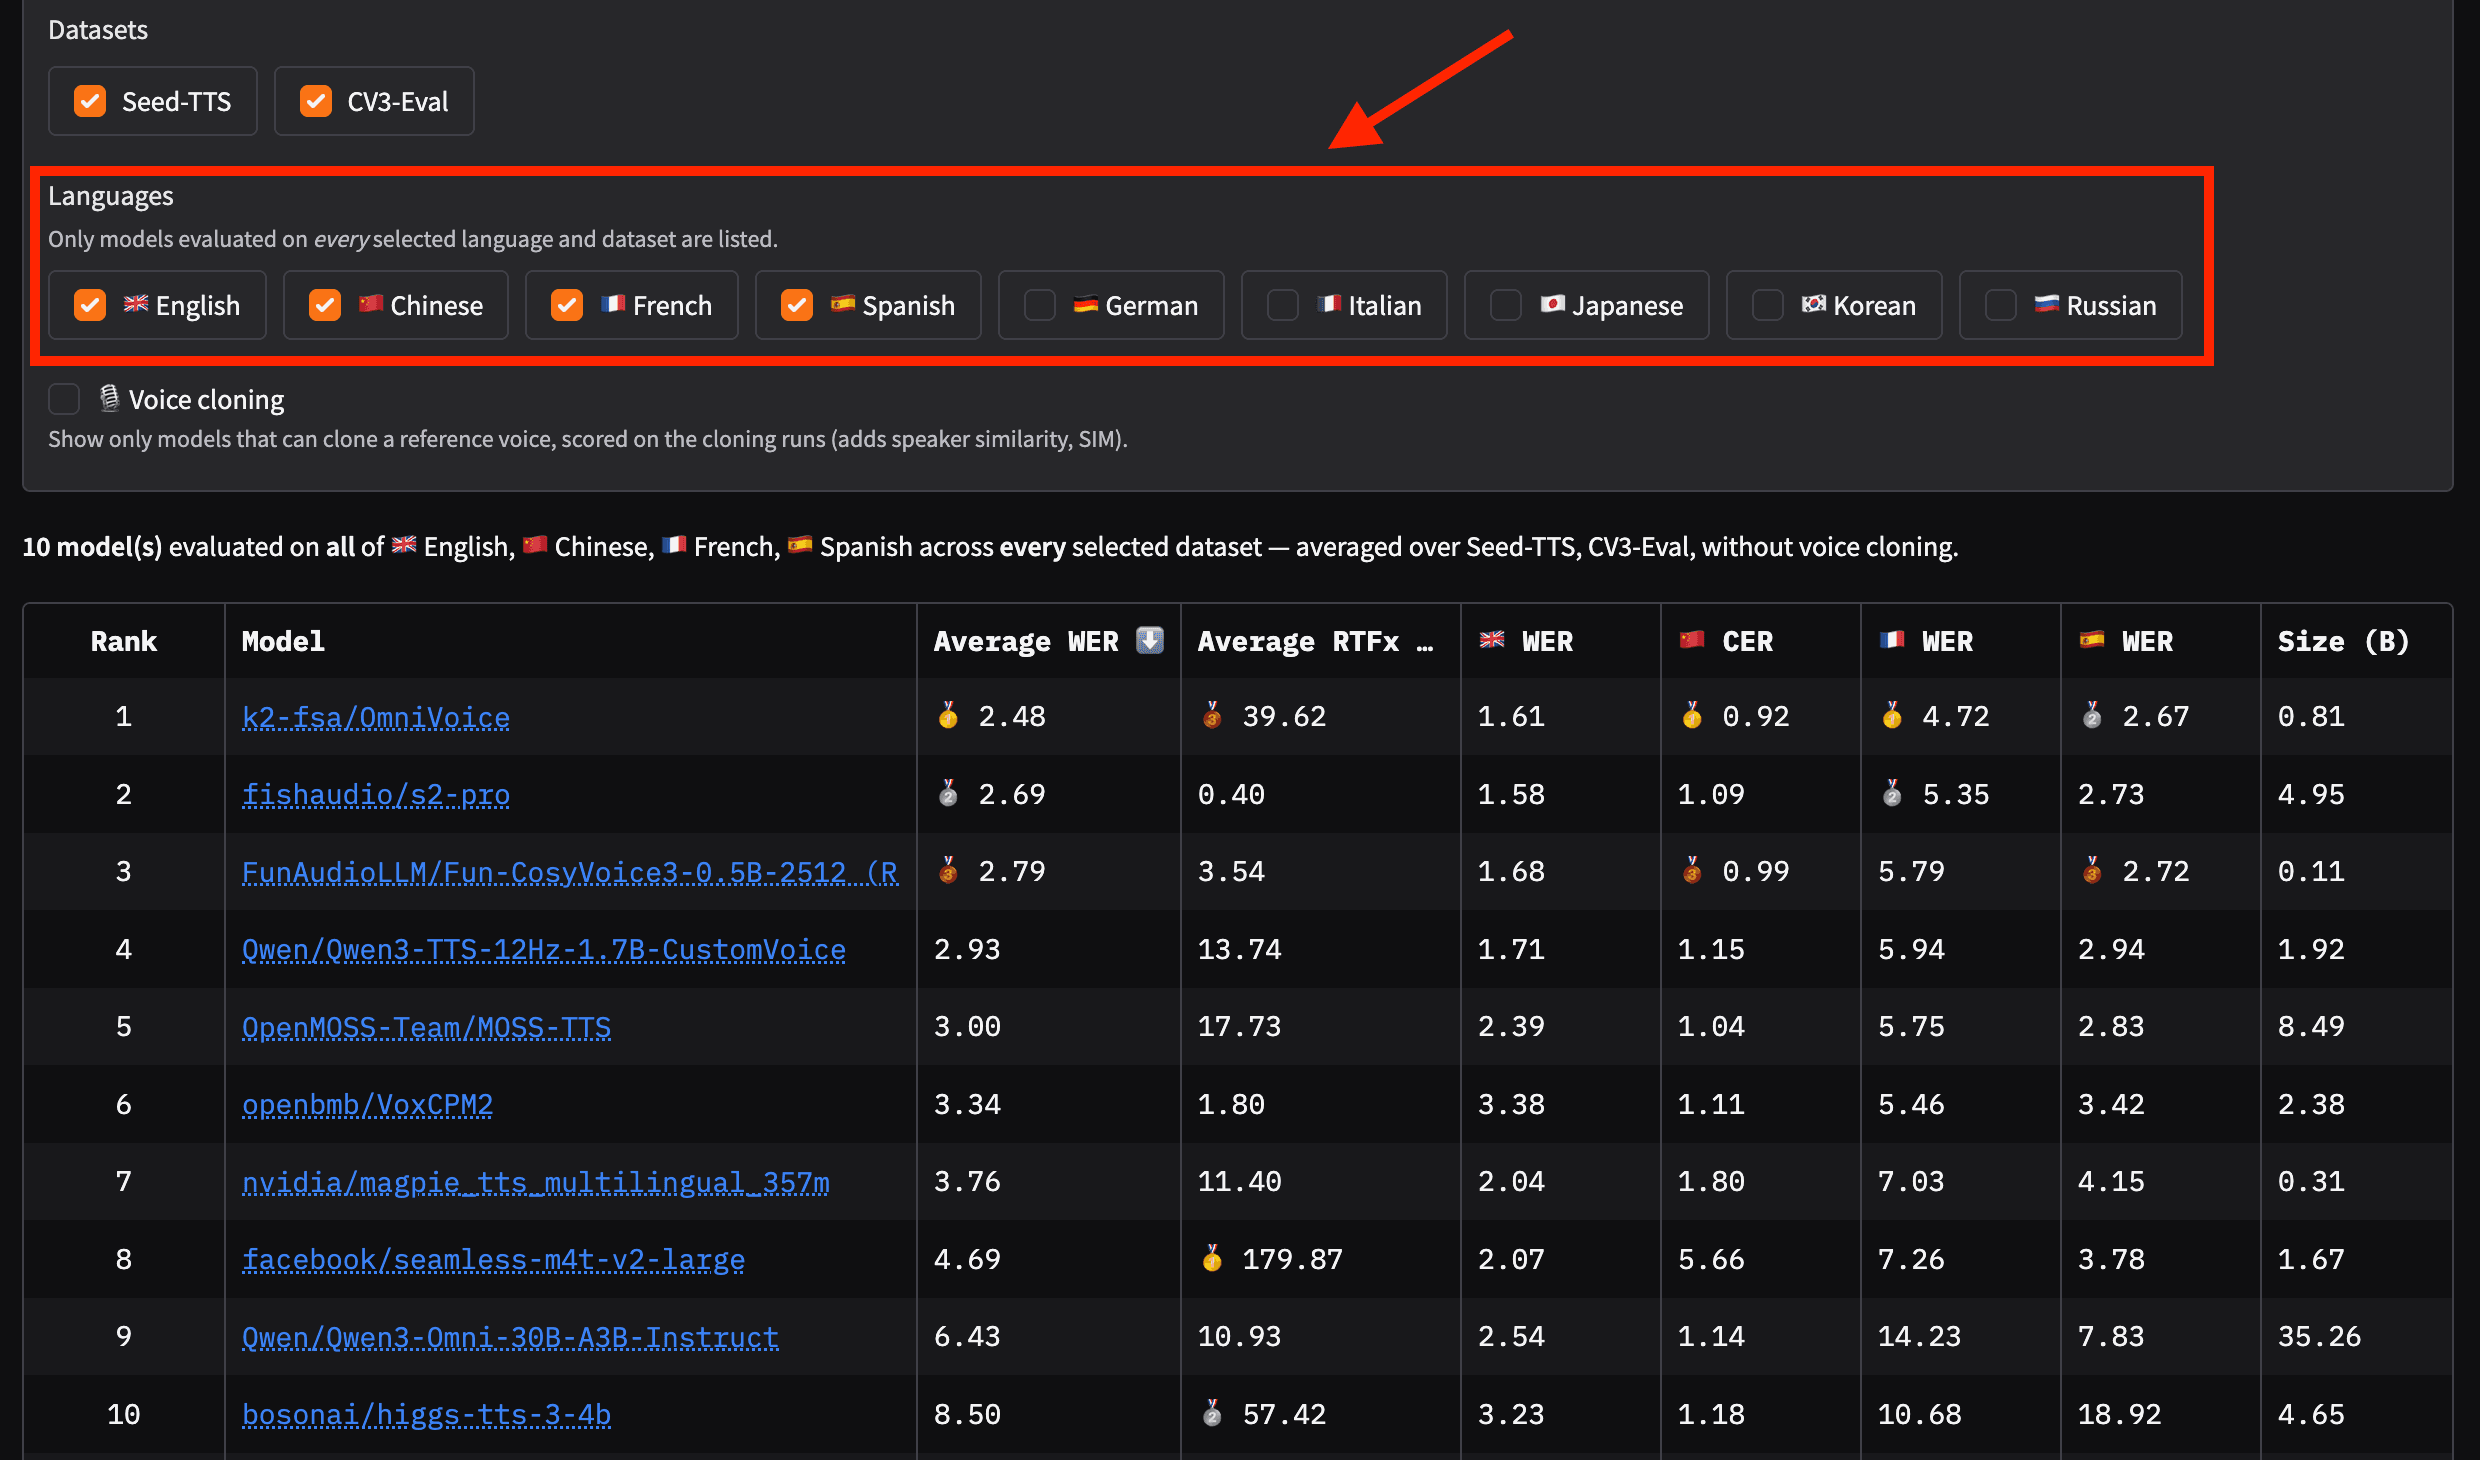
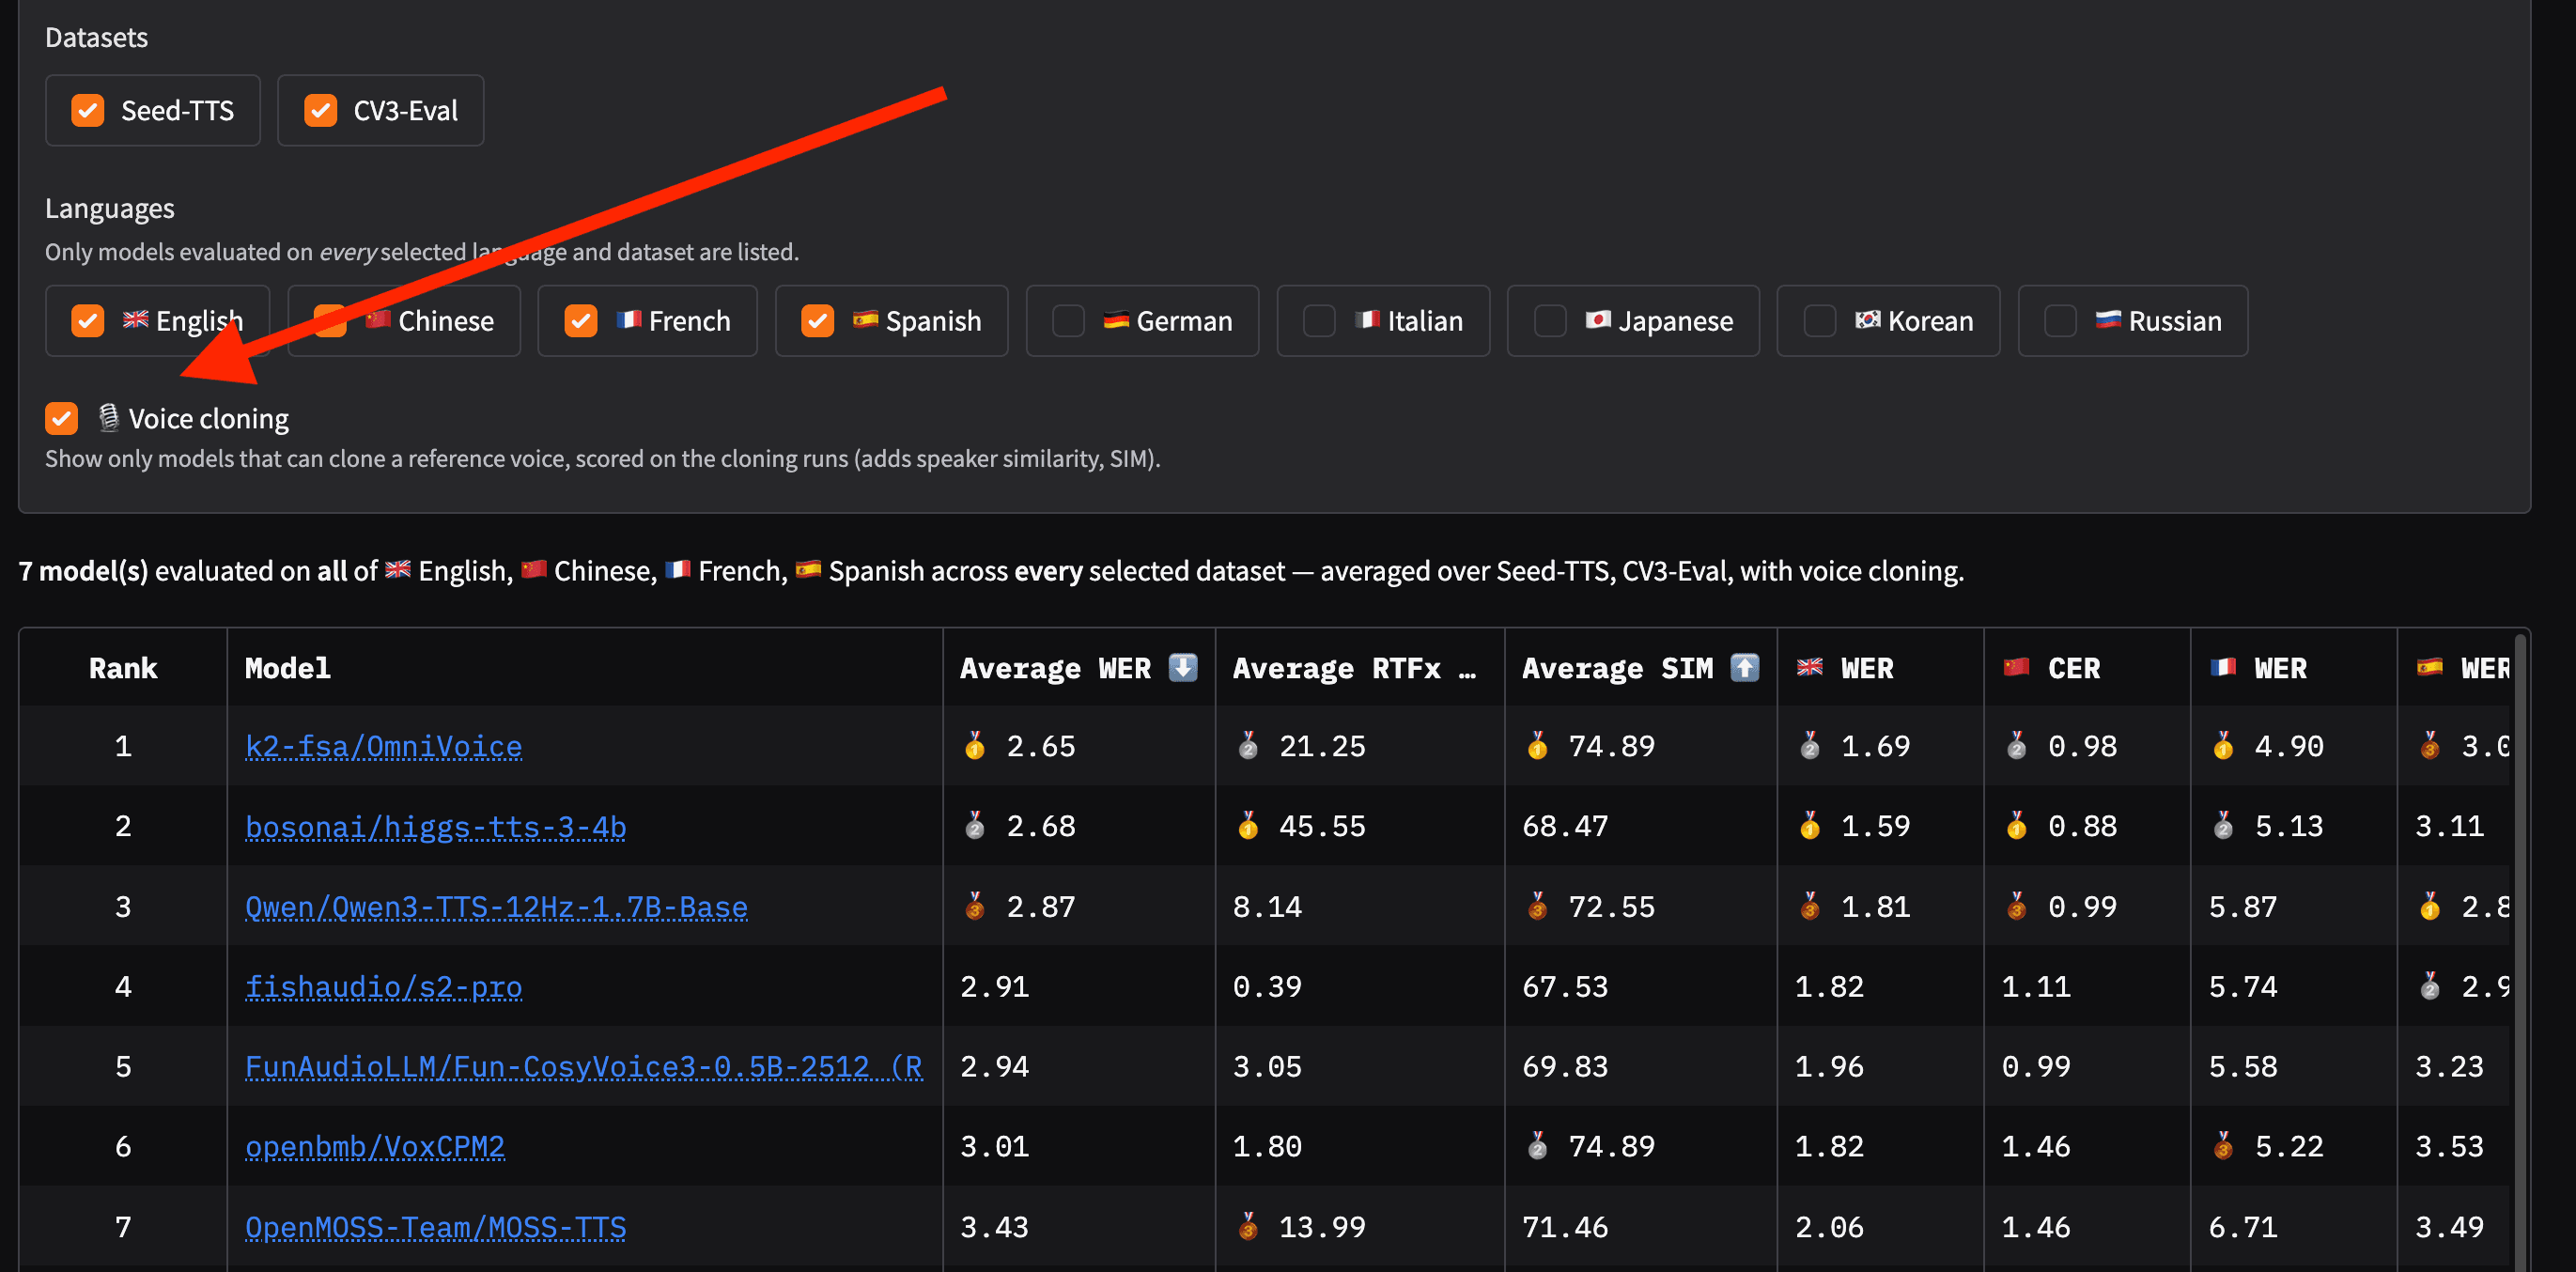
สำหรับการประเมินพหุภาษา ระบบจะแสดงผลเป็นอัตราความผิดพลาดของตัวอักษร (CER) ในภาษาที่ใช้ตัวอักษรพื้นฐานอย่าง จีน ญี่ปุ่น และเกาหลี โดยมีโมเดลอย่าง k2-fsa/OmniVoice และ FunAudioLLM/Fun-CosyVoice3-0.5B-2512 ที่ทำผลงานได้โดดเด่น
เมื่อเปิดโหมด "Voice cloning" จะมีคอลัมน์ SIM เพิ่มเข้ามาเพื่อแสดงระดับความเหมือนของเสียง ซึ่งบางโมเดลเช่น bosonai/higgs-tts-3-4b และ openbmb/VoxCPM2 จะมีประสิทธิภาพดีขึ้นอย่างเห็นได้ชัดเมื่อใช้เสียงอ้างอิง
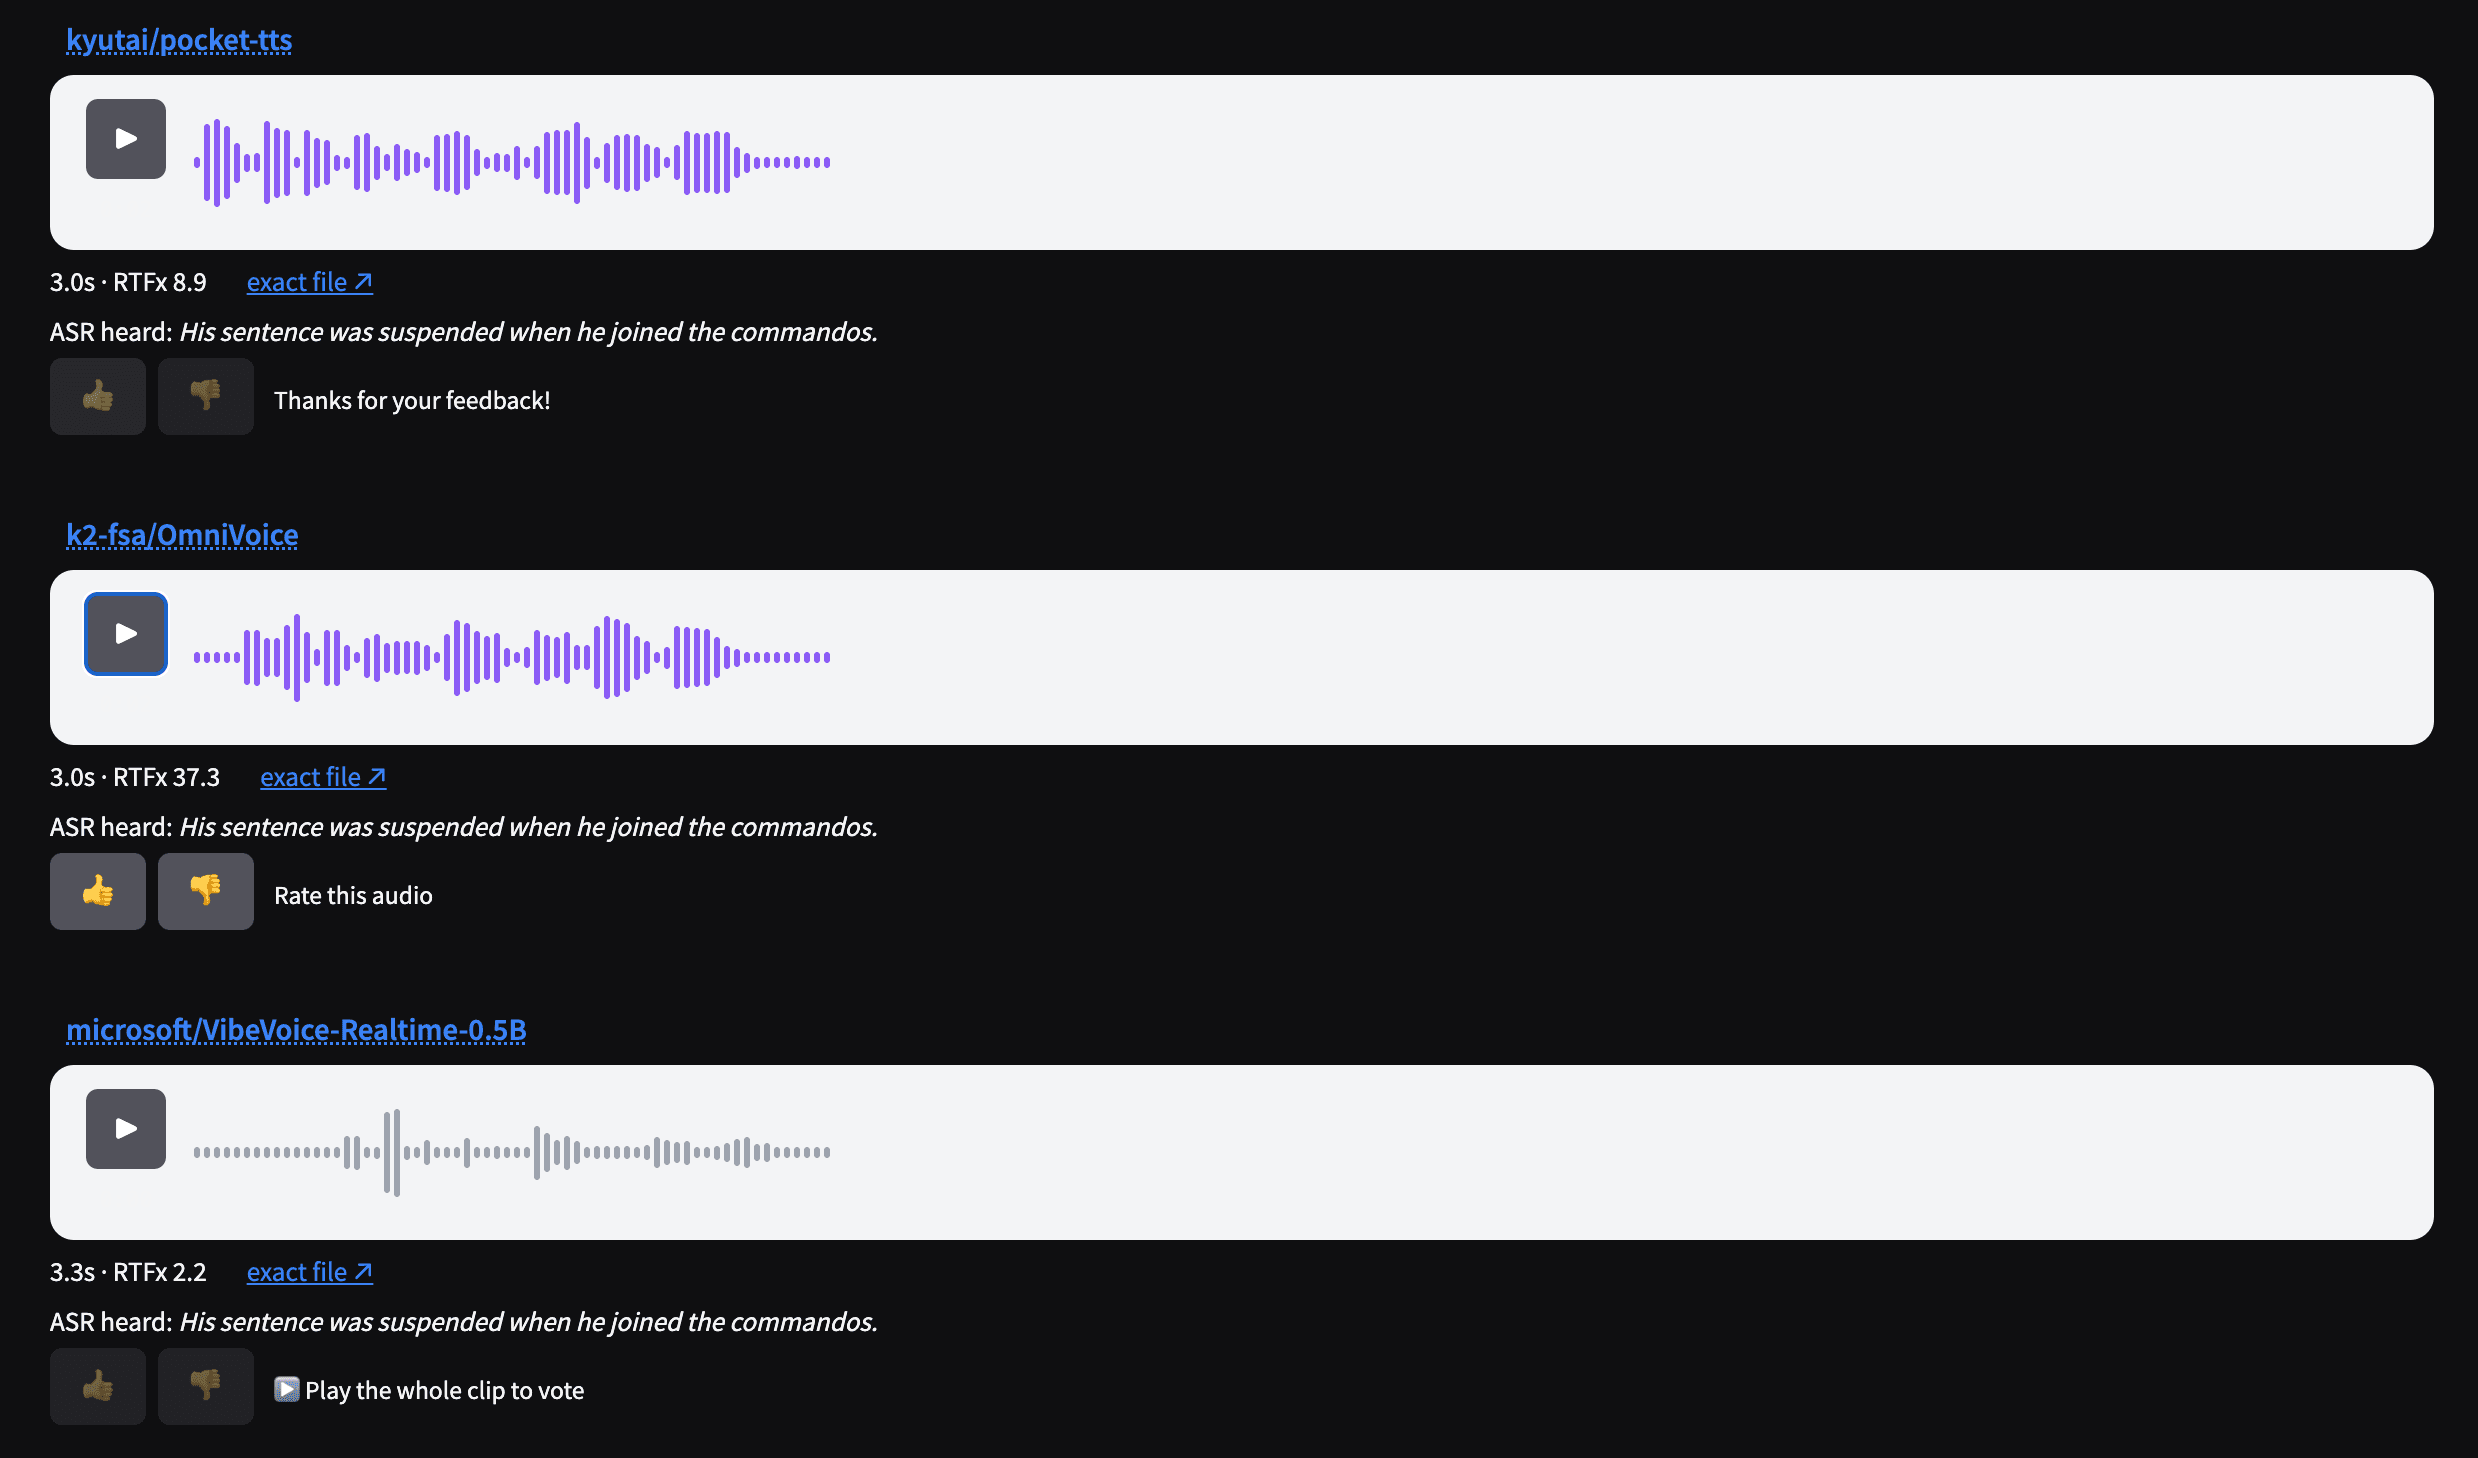
เปรียบเทียบและโหวตผลลัพธ์ TTS เนื่องจากตัวเลขไม่สามารถบอกคุณภาพได้ทั้งหมด แท็บ "Listen" จึงถูกออกแบบมาเพื่อให้ผู้ใช้สามารถฟังและเปรียบเทียบเสียงที่สร้างขึ้นได้จริง ผู้ใช้สามารถเลือกภาษา ชุดข้อมูล หรือโหมดการโคลนเสียงเพื่อฟังผลลัพธ์จากโมเดลต่างๆ
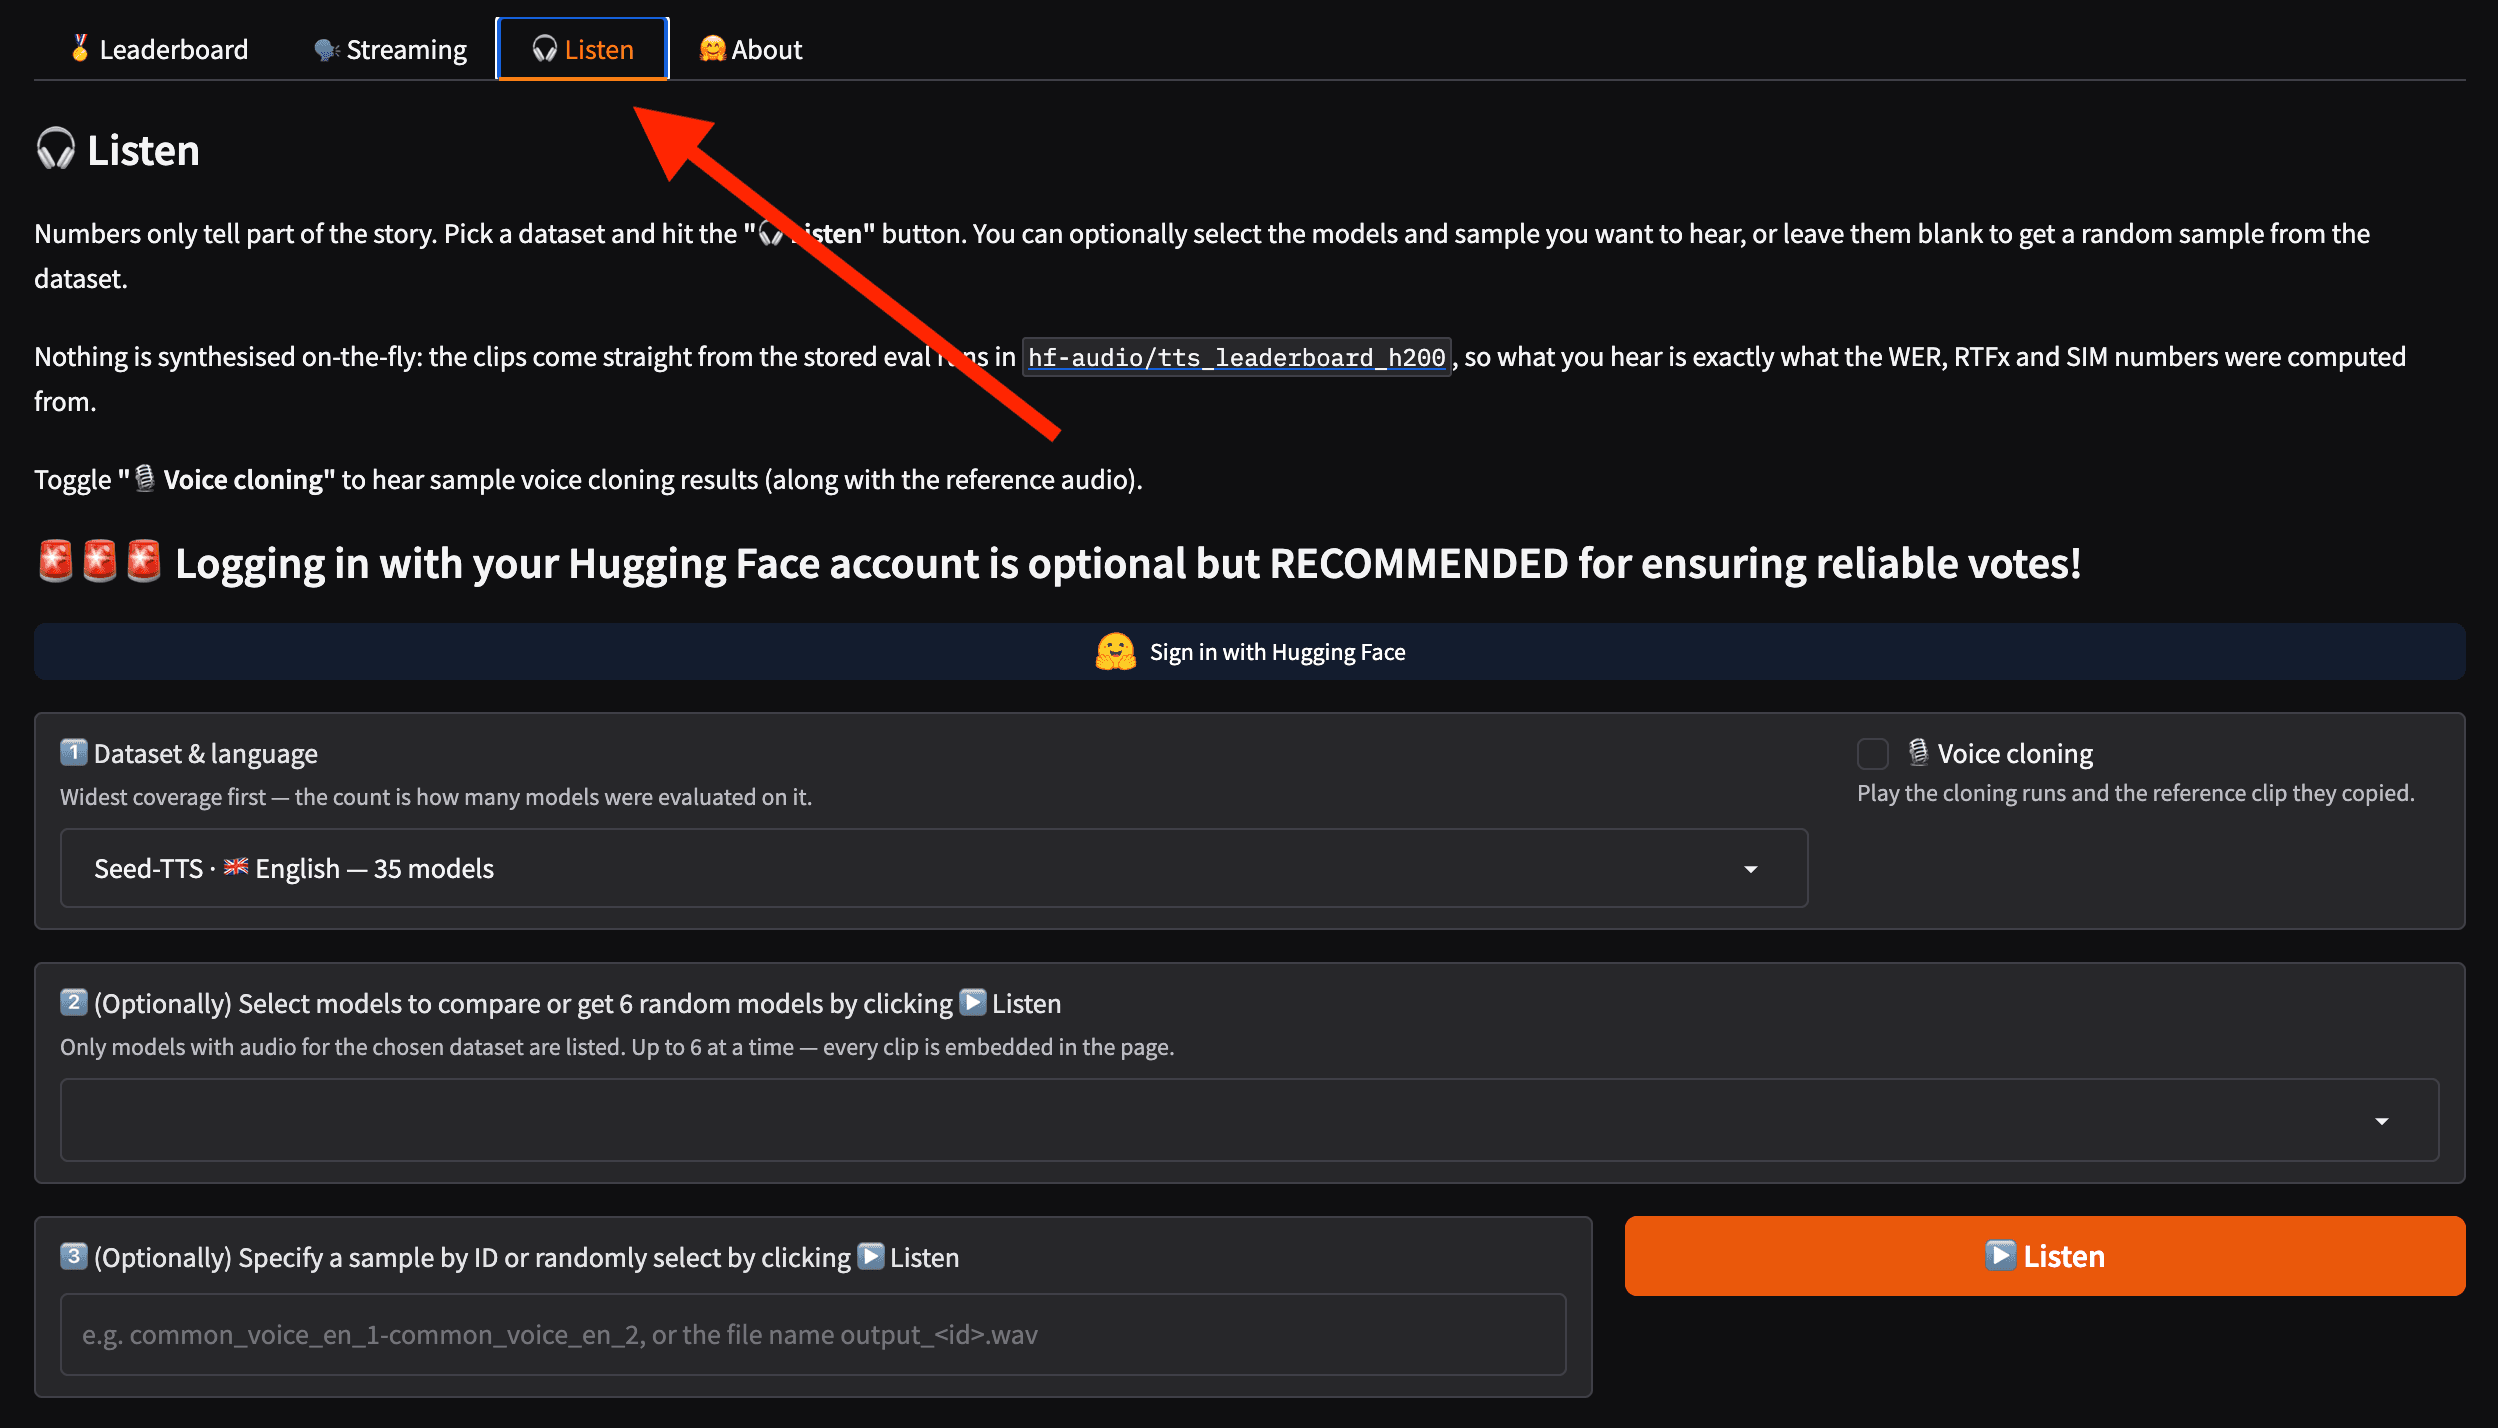
คุณสามารถให้คะแนนความพึงพอใจเพื่อช่วยในการจัดอันดับได้ โดยต้องเข้าสู่ระบบผ่านบัญชี Hugging Face เพื่อป้องกันสแปม ซึ่งข้อมูลส่วนนี้จะถูกนำมาผสานรวมเข้ากับลีดเดอร์บอร์ดในอนาคต
ประสิทธิภาพการสตรีม
แท็บ "Streaming" จะประเมินค่า TTFA เพื่อดูว่าผู้ใช้ต้องรอนานเท่าใดก่อนที่เสียงแรกจะถูกเล่นออกมา ซึ่งสำคัญมากสำหรับ AI Voice Agents โดยโมเดลที่มีเครื่องหมาย ✅ ภายใต้ "Streaming API" จะวัดเวลาจนถึง Chunk แรกที่ถูกส่งออกมา
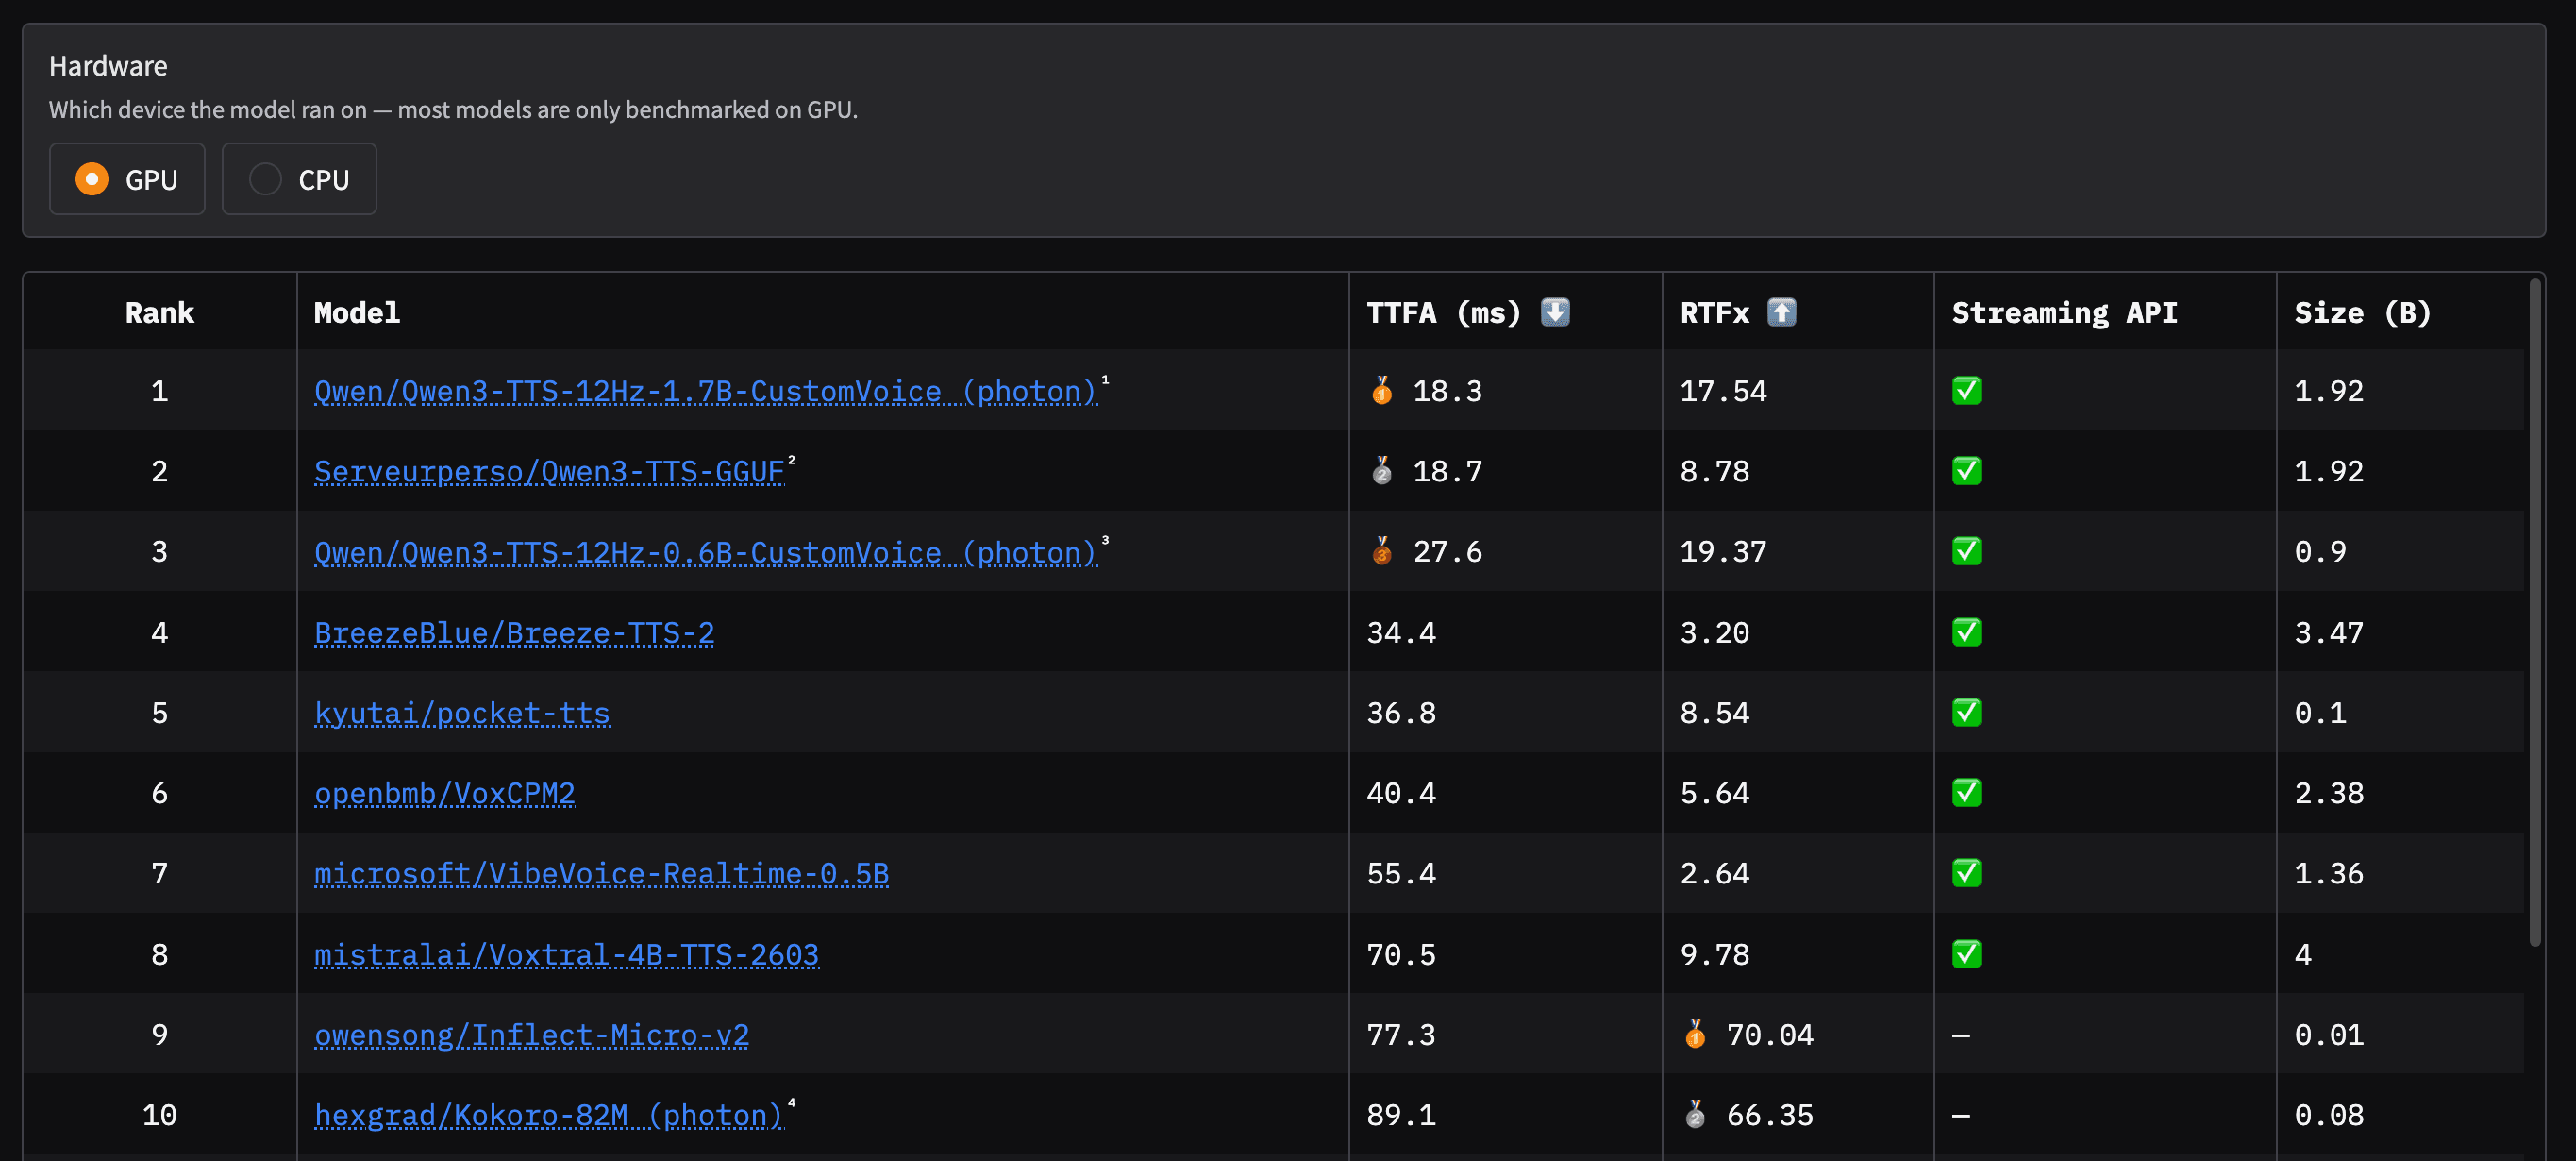
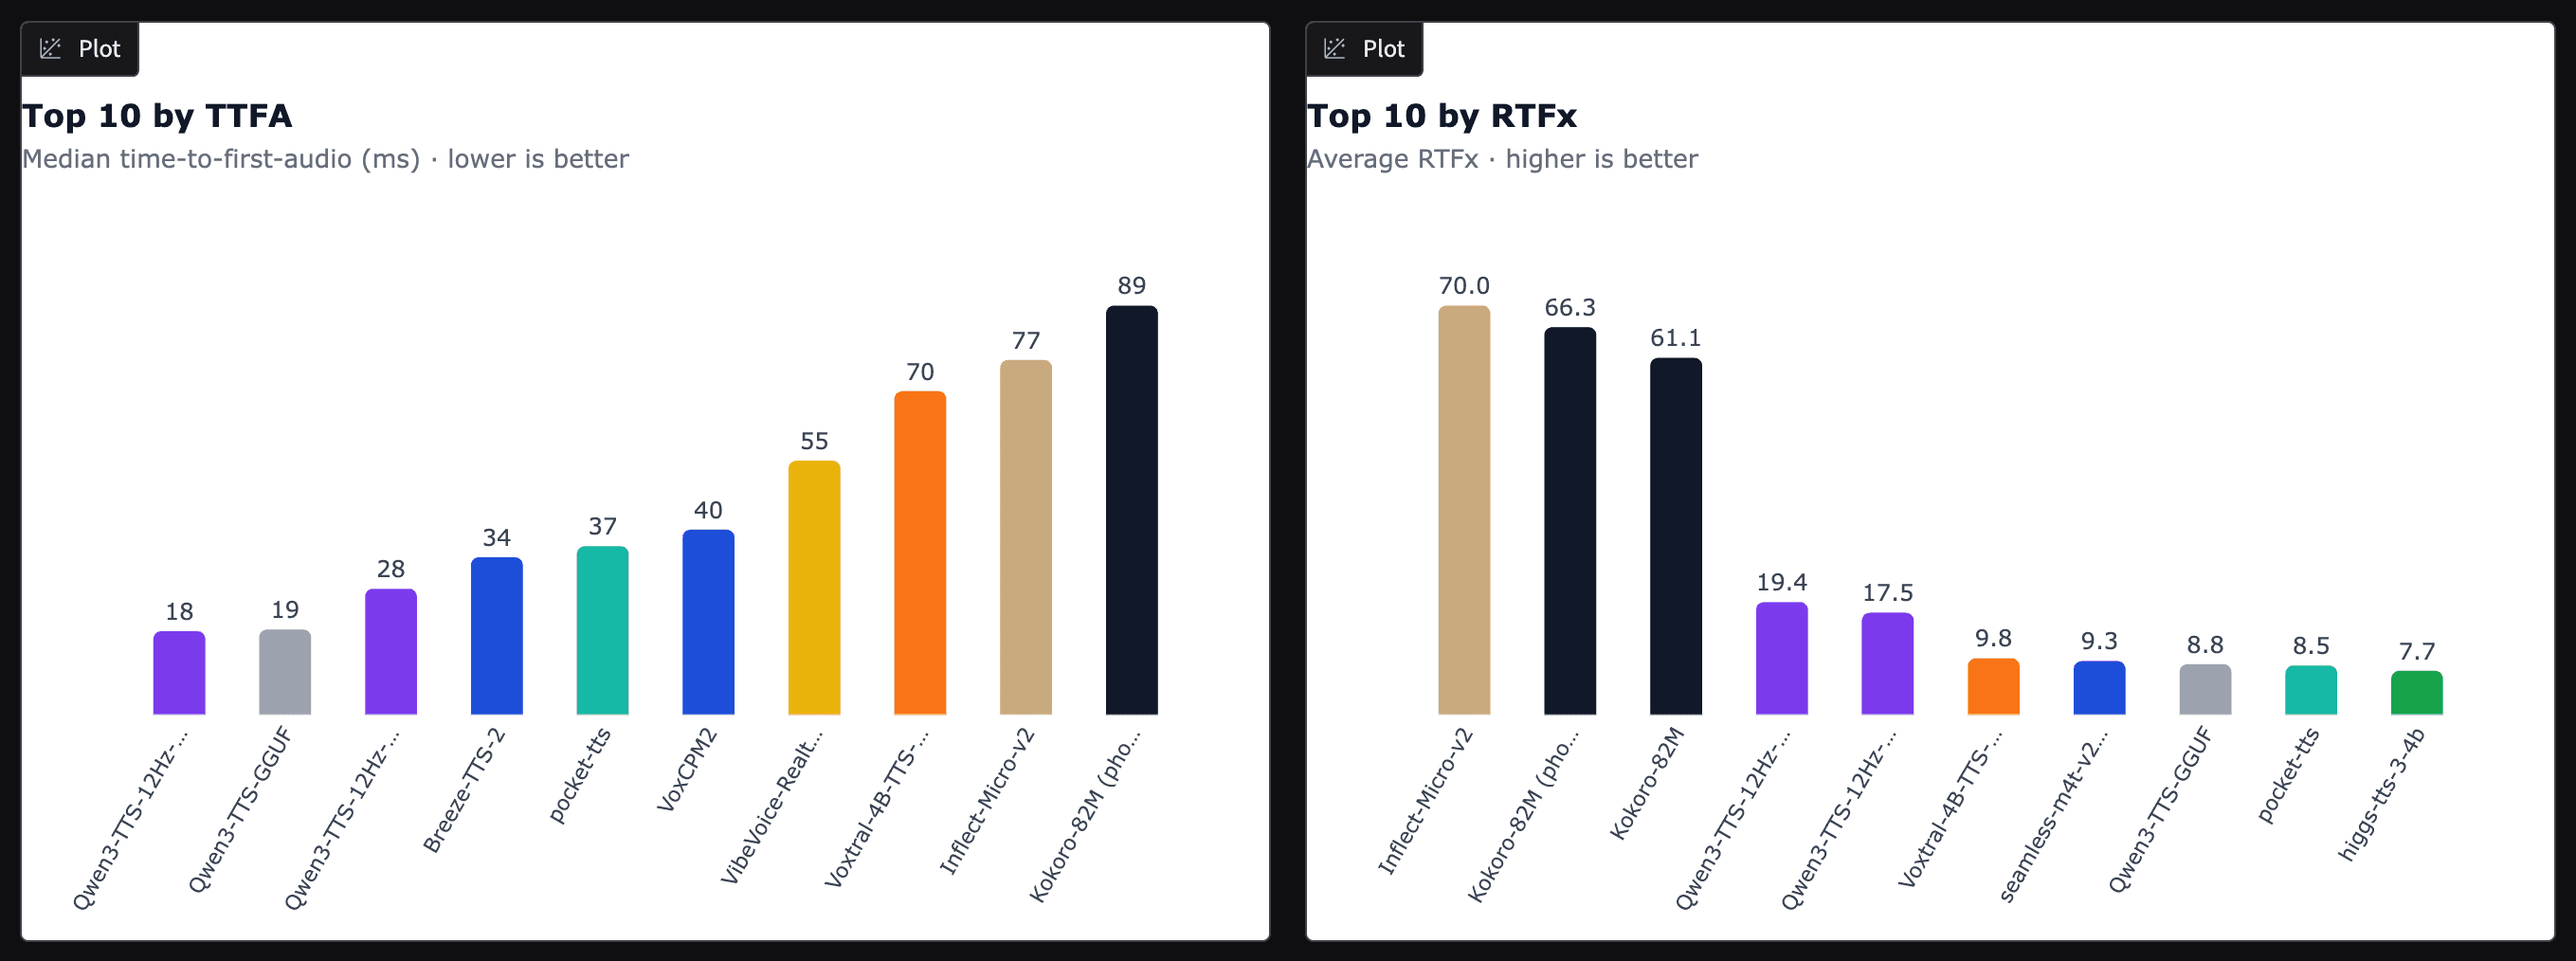
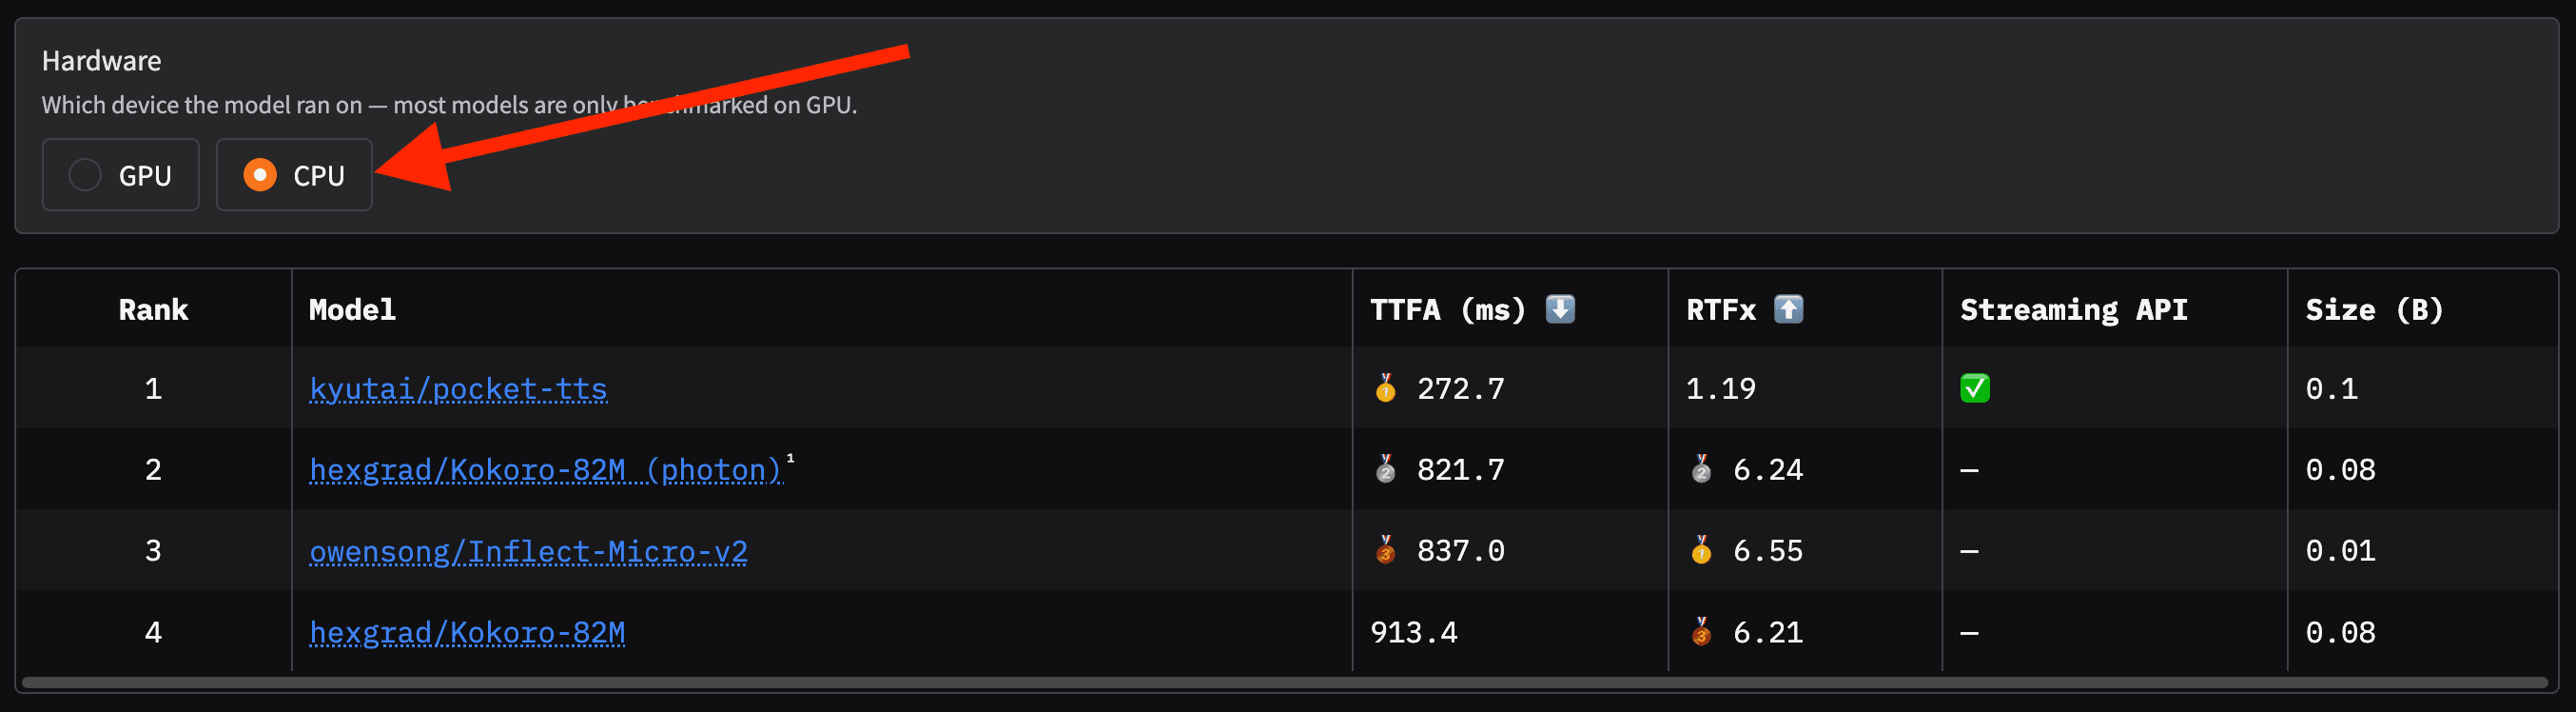
การทดสอบทำบนฮาร์ดแวร์ GPU H200 และ CPU โดยรายงานค่ามัธยฐานจาก 50 ตัวอย่าง ซึ่งโมเดล kyutai/pocket-tts แสดงให้เห็นถึงประสิทธิภาพการสตรีมที่ยอดเยี่ยมในทั้งสองประเภทฮาร์ดแวร์
บทสรุป
Open TTS Leaderboard มุ่งเน้นไปที่โมเดลโอเพนซอร์สและการประเมินแบบพหุภาษาเพื่อให้ครอบคลุมการใช้งานทั่วโลก และในเร็วๆ นี้จะมีการเปิดเผยซอร์สโค้ดสำหรับสคริปต์การประเมิน เช่นเดียวกับ repo ของ Open ASR Leaderboard เพื่อให้ชุมชนสามารถร่วมพัฒนาและเสนอแนะตัวชี้วัดใหม่ๆ ได้ผ่าน GitHub ต่อไป 🤗
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร