
AssemblyAI เปิดตัว TTS-1 ชูความเร็วสูง ราคาประหยัดสำหรับ Voice Agents
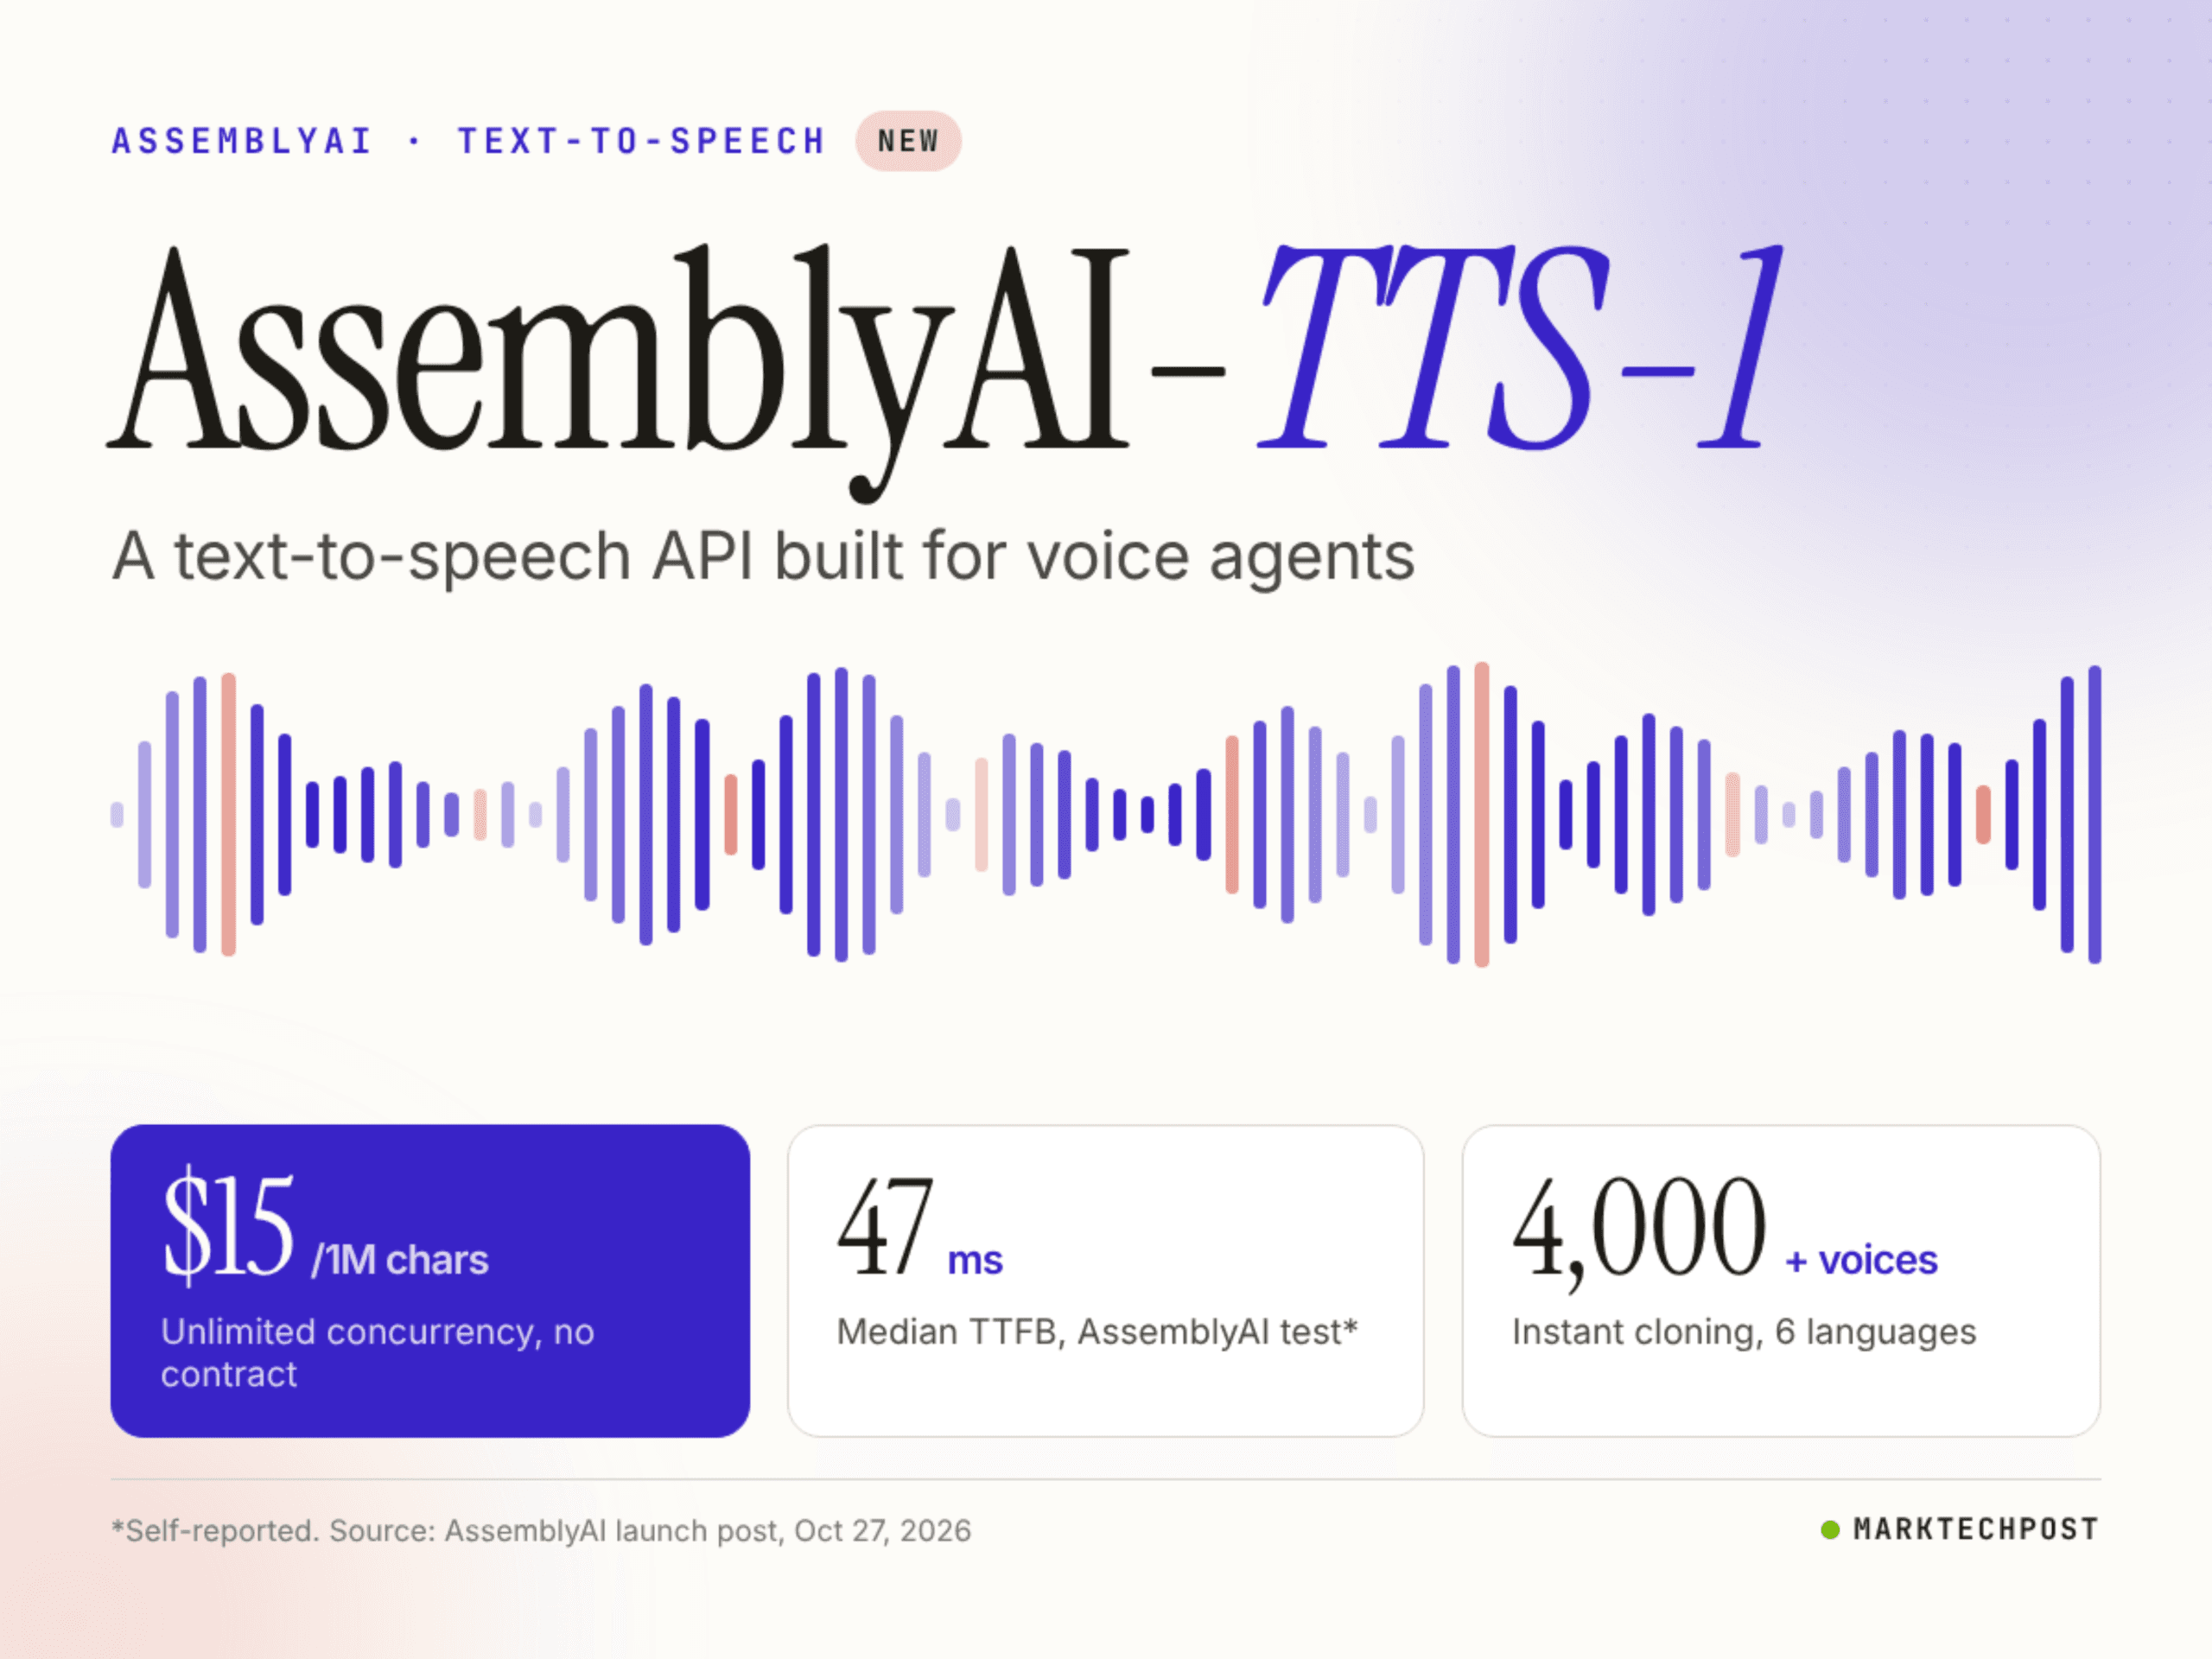
AssemblyAI ประกาศเปิดตัว AssemblyAI-TTS-1 โมเดล text-to-speech (TTS) ตัวแรกของบริษัทที่พร้อมให้ใช้งานทั่วไปแล้ว โดย API ตัวนี้มุ่งเน้นการใช้งานสำหรับ voice agents ที่ต้องโต้ตอบผ่านการโทรศัพท์สด ซึ่งความหน่วง (latency) และความแม่นยำในการออกเสียงเป็นปัจจัยสำคัญในการรักษาบทสนทนา
โมเดลนี้มาพร้อมโครงสร้างราคาที่น่าสนใจเพียง 15 ดอลลาร์ต่อ 1 ล้านตัวอักษร โดยไม่มีข้อผูกมัดสัญญาจ้างรายปีและไม่จำกัดระดับ concurrency สำหรับนักพัฒนาที่ใช้ระบบ speech-to-text ของ AssemblyAI อยู่แล้ว การเปิดตัวนี้จะช่วยให้สามารถสร้างวงจรเสียงที่ครบถ้วนได้จบในผู้ให้บริการรายเดียว
TL;DR
- Size: โมเดลในรูปแบบ Hosted API
- Runs on: ให้บริการผ่านคลาวด์ของ AssemblyAI ในภูมิภาคสหรัฐอเมริกา (us-east-1) หรือสหภาพยุโรป (eu-north-1) เท่านั้น ไม่มี open weights หรือตัวเลือก on-prem โดยรองรับการเชื่อมต่อผ่าน HTTP หรือ WebSocket
- Performance: ในการทดสอบของ AssemblyAI พบว่ามีความแม่นยำของเอนทิตีเทียบเท่า ElevenLabs v4 แต่ราคาถูกกว่าถึง 5 เท่า
- Best: ค่ามัธยฐาน time to first byte อยู่ที่ 47 ms ซึ่งเร็วที่สุดในบรรดา 6 โมเดลที่บริษัทนำมาทดสอบ
- Best: ราคา 15 ดอลลาร์ต่อ 1 ล้านตัวอักษร พร้อม concurrency แบบไม่จำกัด
- Worst: ปัจจุบันยังไม่รองรับ SSML, การควบคุมความเร็ว, พจนานุกรมการออกเสียง หรือแท็กอารมณ์
AssemblyAI-TTS-1 คืออะไร?
AssemblyAI-TTS-1 คือโมเดล streaming text-to-speech ที่เปลี่ยนคำตอบของ AI เอเจนท์ให้เป็นเสียงพูดสำหรับการสนทนาสด ตัวโมเดลถูกฝึกฝนด้วยเสียงออดิโอหลายล้านชั่วโมงรวมถึงข้อมูลการสนทนาจริง ทั้งนี้ AssemblyAI ระบุว่า TTS-1 ทำงานบน continuous audio representations แทนการใช้ discrete tokens แบบโมเดลทั่วไป ซึ่งช่วยเพิ่มความสมจริงและลดเวลาการสร้างเสียงพูดเริ่มต้นได้มหาศาล
ในการเปิดตัวครั้งนี้ยังมีไลบรารีเสียงให้เลือกกว่า 4,000 เสียง พร้อมฟีเจอร์การโคลนเสียงแบบทันที (instant voice cloning) ที่ใช้ไฟล์บันทึกเสียงเพียง 24 วินาทีและการยืนยันตัวตนจากเจ้าของเสียง โดยในช่วงแรกจะรองรับ 6 ภาษา ได้แก่ อังกฤษ, สเปน, ฝรั่งเศส, เยอรมัน, อิตาลี และโปรตุเกส
การรวมระบบสำหรับนักพัฒนา
นักพัฒนาสามารถเลือกใช้งานได้ผ่าน 3 อินเทอร์เฟซ ได้แก่ HTTP API, WebSocket API และรูปแบบที่รองรับการทำงานร่วมกับ OpenAI โดยเซสชัน WebSocket จะคงการเชื่อมต่อหนึ่งรายการต่อการสนทนา และรองรับคำสั่งยกเลิกเพื่อจัดการจังหวะการพูดแทรก (barge-in)
ตัวเลือกเอาต์พุตมีทั้ง mono PCM, mu-law หรือ A-law ที่ความถี่ 8 kHz ถึง 48 kHz (โดยมี 24 kHz PCM เป็นรูปแบบดั้งเดิม) ระบบโทรศัพท์สามารถขอรับไฟล์ 8 kHz mu-law ได้โดยตรง พร้อมระบบระบุเวลาของคำ (word timestamps) นอกจากนี้ยังมีการเผยแพร่ reference agents สำหรับ LiveKit และ Pipecat เพื่อเป็นแนวทางให้นักพัฒนาอีกด้วย
ประสิทธิภาพและผลการทดสอบ
AssemblyAI ได้ทดสอบ TTS-1 เปรียบเทียบกับ 5 โมเดลคู่แข่งในชุดข้อมูลภาษาอังกฤษ โดยตัวเลขผลลัพธ์จากการประเมินเมื่อวันที่ 28 ตุลาคม 2026 (ตามรายงานของบริษัท) มีดังนี้:
- ความแม่นยำของเอนทิตี (หมายเลขโทรศัพท์และรหัส): ทำได้ 93.7% สูงกว่า ElevenLabs v4 (93.6%) และ Cartesia Sonic 3.6 (82.5%)
- ความแม่นยำของคำ: อยู่ที่ 99.0% จากชุดข้อมูล Seed-TTS และ LibriSpeech
- ค่ามัธยฐาน time to first byte: อยู่ที่ 47 ms ขณะที่ ElevenLabs Flash v2.5 ใช้เวลา 119 ms และ Sonic 3.6 ใช้ 143 ms
อย่างไรก็ตาม ผลการทดสอบจากภายนอกโดย Cekura สำหรับ 27 โมเดล พบว่า TTS-1 ได้คะแนนความแม่นยำในการอ่าน 81.5% และความหน่วงในการสตรีม (streaming latency) อยู่ที่ 159 ms ซึ่งตามหลัง Inworld TTS-2 Flash ที่ทำได้ 45 ms ในระดับราคาเดียวกัน
การเปรียบเทียบในตลาด
| คุณสมบัติ | AssemblyAI-TTS-1 | Inworld TTS-2 Flash | ElevenLabs Flash v2.5 | Cartesia Sonic 3.6 |
|---|---|---|---|---|
| Architecture | Continuous audio representations | ไม่เปิดเผย | ไม่เปิดเผย | State space model (SSM) |
| Languages | 6 | 200+ | 32 | 44 |
| Median TTFB (AssemblyAI) | 47 ms | 244 ms | 119 ms | 143 ms |
| Median Latency (Cekura) | 159 ms | 45 ms | 177 ms | 270 ms |
| List price (ต่อ 1M ตัวอักษร) | $15 | $15 | $40 | $37.38 - $50 |
| Self-serve concurrency | ไม่จำกัด | 5 - 500 requests | ไม่เปิดเผย | 2 - 15 requests |
ราคาและการเข้าถึง
ราคาของ AssemblyAI-TTS-1 คิดตามจำนวนตัวอักษรที่ป้อน (รวมเว้นวรรคและเครื่องหมายวรรคตอน) ที่ 15 ดอลลาร์ต่อ 1 ล้านตัวอักษร ซึ่งรวมค่าบริการโคลนเสียงและ word timestamps ไว้แล้วโดยไม่มีค่าธรรมเนียมเพิ่มเติม
จุดเด่นสำคัญที่ทำให้เหนือกว่าคู่แข่งอย่าง Inworld ในระดับราคาเดียวกันคือเรื่อง concurrency ซึ่งทาง AssemblyAI อนุญาตให้ใช้งานได้แบบไม่จำกัดในรูปแบบ pay-as-you-go ในขณะที่แผนเริ่มต้นของคู่แข่งอาจจำกัดอยู่ที่ 5 รายการพร้อมกัน
ประเด็นสำคัญ
- AssemblyAI-TTS-1 เป็นโมเดลเสียงตัวแรกของค่ายที่ออกแบบมาเพื่อ live voice agents โดยเฉพาะ
- ราคาประหยัด 15 ดอลลาร์ต่อ 1 ล้านตัวอักษร พร้อม concurrency แบบไม่จำกัด
- ผลทดสอบภายในระบุความหน่วงต่ำสุดที่ 47 ms แม้ผลการทดสอบภายนอกจะมีความหลากหลาย
- ปัจจุบันยังขาดฟีเจอร์ปรับแต่งขั้นสูงอย่าง SSML และการควบคุมอารมณ์เสียง
รายงานโดย Michal Sutter ผู้เชี่ยวชาญด้านวิทยาศาสตร์ข้อมูลจาก University of Padova ที่มีประสบการณ์ด้าน machine learning และการวิเคราะห์สถิติระดับสูง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร