
เปิดตัว Beam: โมเดล Open-Weight ขนาด 501B ปรับแต่งได้อิสระ
Beam โดย Reflection เปิดตัวอย่างเป็นทางการบน Hugging Face แล้ว! นี่คือโมเดลแรกจาก Reflection ห้องปฏิบัติการน้องใหม่ในสหรัฐอเมริกาที่มาในรูปแบบโมเดลแบบเปิด (Open-Weight) โดยใช้โครงสร้าง Mixture-of-Experts (MoEs) ที่มีพารามิเตอร์รวม 501B (Active 23B ต่อ token) รองรับ Context Window ขนาดใหญ่ถึง 1M tokens และปล่อยภายใต้สัญญาอนุญาต Apache 2.0
Beam ถูกออกแบบมาเพื่อเน้นการใช้งานด้าน Coding และ Agentic โดยเฉพาะ เหมาะสำหรับทีมที่ต้องการโมเดลระดับ Frontier-scale ไว้บนโครงสร้างพื้นฐานหรือคลาวด์ของตนเองเพื่อปรับแต่งให้ตอบโจทย์เฉพาะทาง โดยมาพร้อมกับ Harness โอเพนซอร์สที่เขียนด้วยภาษา Rust เพื่อรีดประสิทธิภาพสูงสุดจากโมเดล
ปัจจุบัน Beam รองรับการทำงานร่วมกับ Transformers แบบ Native รวมถึงไลบรารีอย่าง vLLM และ SGLang นอกจากนี้ทีมงานยังได้ร่วมกับ Reflection นำเสนอสูตรสำหรับการทำ Inference, SFT (Supervised Fine-Tuning) และ RL (Reinforcement Learning) เพื่อให้ผู้ใช้นำไปต่อยอดได้ทันทีตั้งแต่วันแรก
TL;DR
- LLM แบบ MoEs ขนาด 501B พารามิเตอร์ (Active 23B ต่อ token) ประกอบด้วย 52 layers, 256 experts ต่อชั้น MoE และใช้ 8 routed ต่อ token
- รองรับ Input และ Output แบบข้อความ พร้อม Context Window 1M tokens
- รูปแบบ Checkpoint: BF16, FP8, และ NVFP4
- รองรับการคงกระบวนการคิดข้ามการโต้ตอบ (
preserve_thinking) และการเรียกใช้เครื่องมือ (Tool Calling) โดยปรับระดับความพยายามในการใช้เหตุผลได้ 5 ระดับ: "low", "medium" (เริ่มต้น), "high", "xhigh", และ "max"- มี Response template ใน Tokenizer และรองรับโมเดล Drafter สำหรับ Speculative Decoding ด้วย DFlash2
- รองรับ Transformers, SGLang, vLLM และการทำ Full-parameter RL ด้วย Miles ตั้งแต่วันแรก
- มาพร้อมกับ Rust-based custom harness. ภายใต้ Apache 2.0
สร้างสิ่งใหม่ด้วย Beam
Reflection มอบเครดิต Hub มูลค่า $10,000 ให้กับโครงการดีเด่นที่ใช้ Beam โดยผู้สนใจสามารถสร้างสรรค์ผลงานได้หลากหลายรูปแบบ เช่น:
- สร้างเดโมบน Spaces โดยใช้โมเดล Beam
- ทำ Quantization สำหรับฮาร์ดแวร์เฉพาะ
- สร้างชุดข้อมูลสังเคราะห์ (Synthetic Dataset)
- สร้างสภาพแวดล้อม RL สำหรับ Beam หรือทำการ Benchmark ผลลัพธ์
หากคุณพัฒนาโปรเจกต์ด้วย Beam สามารถแบ่งปันได้ที่ หน้า repo ของโมเดล เพื่อลุ้นรับเครดิตรางวัล
Beam คืออะไร?
Beam คือโมเดลข้อความล้วนที่เน้นการใช้เหตุผลในบริบทที่ยาวมาก (1M Context) และงานประเภท Agentic ด้วยโครงสร้าง MoE แบบ Sparse ทำให้แต่ละ token ใช้ทรัพยากรเพียงส่วนเล็กๆ ของเครือข่าย ส่งผลให้ทำงานได้รวดเร็วเท่าโมเดลขนาดเล็กแต่ยังคงความสามารถของโมเดลขนาดใหญ่ไว้ได้
Attention
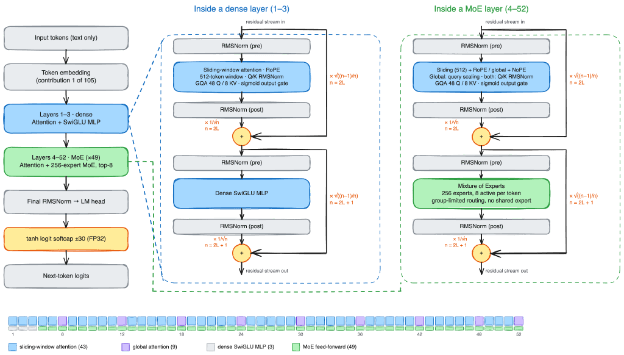
Decoder ของ Beam มี 52 layers พร้อม hidden size 5,120 โดยส่วนใหญ่ (43 ชั้น) จะใช้ Sliding-window attention ขนาด 512 tokens และทุกๆ ชั้นที่หกจะสลับเป็น Global attention เพื่อประมวลผลบริบททั้งหมด
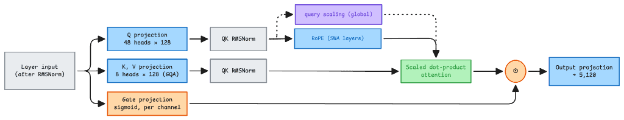
กลไกภายในบล็อก Attention
ชั้น Sliding-window จะใช้ RoPE เพื่อจัดการตำแหน่งที่สัมพันธ์กันในหน้าต่างสั้นๆ ส่วน ชั้น Global จะไม่ใช้ Positional Encoding แต่จะใช้เทคนิค Scalable-softmax query scaling เพื่อรักษาความแม่นยำเมื่อบริบทมีความยาวขึ้น นอกจากนี้ยังใช้ Grouped-query attention (48 query heads / 8 KV heads) พร้อม Sigmoid gate เพื่อปรับสเกล Output ก่อนส่งต่อ
Mixture of Experts
โครงสร้างเริ่มด้วยชั้น Dense SwiGLU MLP ใน 3 ชั้นแรก ส่วนอีก 49 ชั้นที่เหลือเป็นบล็อก MoE ที่มีถึง 256 experts ซึ่งเก็บพารามิเตอร์ไว้ถึง 98.4% ของทั้งโมเดล
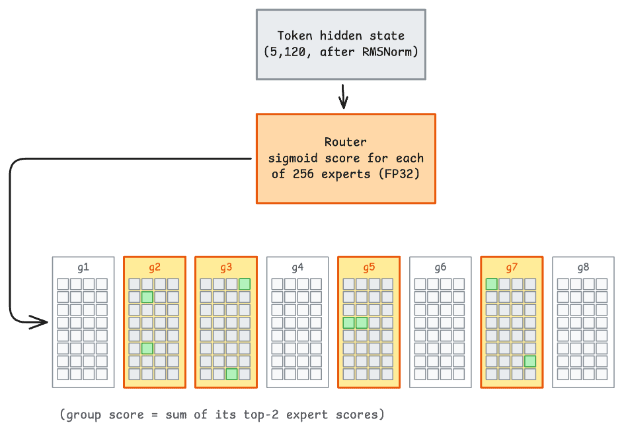
ตัว Router ใช้แผน Group-limited ตามแบบ DeepSeek-V3 โดยจะคัดเลือกกลุ่มและ Expert ที่ดีที่สุด 8 ตัวต่อ token ทำให้การคำนวณจริงใช้เพียง 23B พารามิเตอร์ การ Deploy จึงต้องการหน่วยความจำสำหรับ 501B แต่ให้ความเร็วระดับ 23B โดย Checkpoint แบบ BF16 มีขนาดราว 1 TB ส่วนแบบ NVFP4 จะเหมาะสำหรับ GPU ตระกูล Blackwell และแบบ FP8 สำหรับตระกูล Hopper
Residual Stream
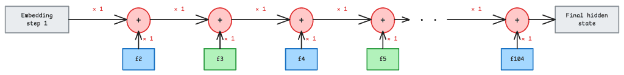
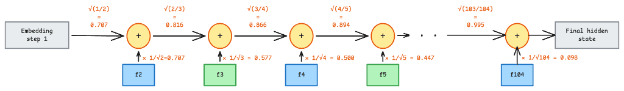
Beam ใช้การเชื่อมต่อแบบ Residual ที่โดดเด่น โดยแทนที่จะบวก Output เข้ากับ Stream ด้วยน้ำหนัก 1 เท่ากันหมด Beam จะใช้น้ำหนักแบบ 1/sqrt(k) เพื่อให้ Hidden state มีสเกลที่คงที่ตลอดความลึกของชั้น ช่วยให้ทุก Output มีความสำคัญเท่ากันในสถานะสุดท้าย
Long Context
ด้วยการผสมผสาน Attention สองรูปแบบ ทำให้การเก็บ Cache ของ Beam มีประสิทธิภาพสูงขึ้นมาก โดยชั้น Sliding-window จะหยุดการเติบโตของแคชหลังจาก 512 tokens ส่งผลให้ความต้องการหน่วยความจำลดลงเหลือเพียงหนึ่งในหกของโมเดลปกติ
| บริบท | หากทั้ง 52 ชั้นเป็น global | Beam |
|---|---|---|
| 32K tokens | 6.5 GiB | 1.2 GiB |
| 128K tokens | 26 GiB | 4.6 GiB |
| บริบทเต็ม (1M) | 208 GiB | 36.08 GiB |
ผลการทดสอบ Benchmark
ข้อมูลผลการทดสอบจากทีม Reflection ในระดับความแม่นยำต่างๆ มีดังนี้:
| Beam (BF16) | Beam (FP8) | Beam (NVFP4) | |
|---|---|---|---|
| Agentic Coding / Terminal | |||
| SWE Bench Pro v2-Hard | 76.5% | 78.4% | 78.6% |
| SWEBench Verified | 81.6% | 80.2% | 80.7% |
| การใช้เหตุผล | |||
| AIME 2026 | 97.7% | 98.0% | 97.5% |
| GPQA Diamond | 90.6% | 90.3% | 89.3% |
| LiveCodeBench | 88.3% | 88.1% | 87.4% |
ข้อกำหนดด้านฮาร์ดแวร์
การให้บริการผ่าน NVFP4 Checkpoint จะช่วยลดความต้องการหน่วยความจำจาก 1 TB เหลือประมาณ 280 GB ซึ่ง GPU Blackwell สามารถรันได้แบบ Native ส่วนผู้ใช้ H200 หรือรุ่นก่อนหน้าควรเลือกใช้ FP8 Checkpoint
สำหรับการรันที่เหมาะสม แนะนำให้ใช้ B200 จำนวน 4 ตัว (720 GB) เพื่อให้มีพื้นที่เพียงพอสำหรับบริบทที่ยาว หรือใช้โหนด 8xB200 แบบเต็ม หากไม่มีฮาร์ดแวร์เหล่านี้ สามารถทดสอบผ่าน Inference Providers แบบ Serverless ได้
การรองรับ Inference
Transformers
ติดตั้งเวอร์ชันล่าสุดและรันผ่าน Text-generation pipeline ได้ง่ายๆ:
pip install -U "transformers>=5.20.1"from transformers import pipeline
pipe = pipeline(
"text-generation", model="reflection/Beam-1.0-501B-A23B", device_map="auto"
)
messages = [
{"role": "user", "content": "Write a limerick about Python exceptions."}
]
output = pipe(messages, max_new_tokens=2000)Tokenizer ของ Beam มาพร้อมกับ Response template ที่แยกส่วนการใช้เหตุผล (Reasoning) และคำตอบออกจากกัน ช่วยให้การจัดการข้อมูลทำได้โดยไม่ต้องใช้ Regex
vLLM
Beam รองรับ vLLM ตั้งแต่วันแรก โดยสามารถเปิดใช้ API ที่เข้ากันได้กับ OpenAI และเสริมความเร็วด้วย DFlash2 Speculative Decoding:
vllm serve reflection/Beam-1.0-501B-A23B --tensor-parallel-size 16 --served-model-name beamSGLang
สำหรับการใช้งานบน Blackwell หรือ Hopper สามารถตั้งค่าผ่าน SGLang เพื่อดึงประสิทธิภาพสูงสุดตามประเภทของ Checkpoint และ Backend ที่เหมาะสม
การทำ Post-training ให้ Beam
SFT ด้วย TRL
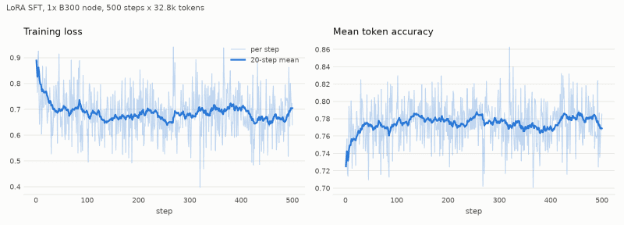
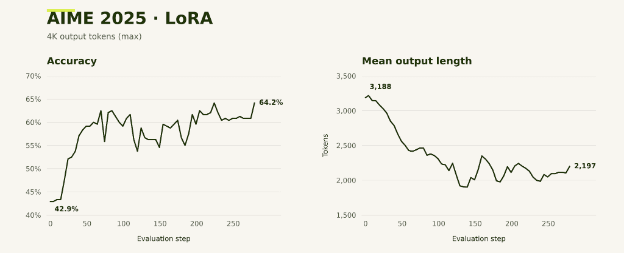
ผู้ใช้สามารถทำ Supervised Fine-tuning (SFT) โดยใช้ LoRA adapters เพื่อลดการใช้หน่วยความจำ จากการทดสอบบนโหนด B300 พบว่าสามารถปรับปรุงความสอดคล้องด้านภาษาในการใช้เหตุผลได้ดีขึ้นอย่างมาก
GRPO ด้วย Miles
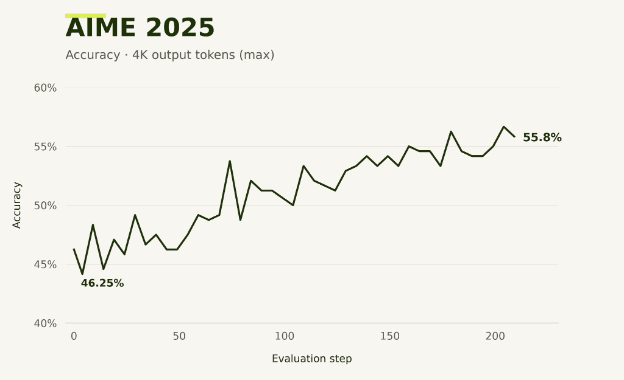
Reflection ได้สร้างสูตรการฝึกด้วย GRPO ผ่าน Miles ในรูปแบบ BF16 ซึ่งรองรับทั้งการอัปเดตโมเดลทั้งหมดหรือใช้ LoRA โดยระบบจะทำงานร่วมกับ Ray Cluster เพื่อจัดการการฝึกแบบขนานขนาดใหญ่
ตัวอย่างการใช้งานจริง
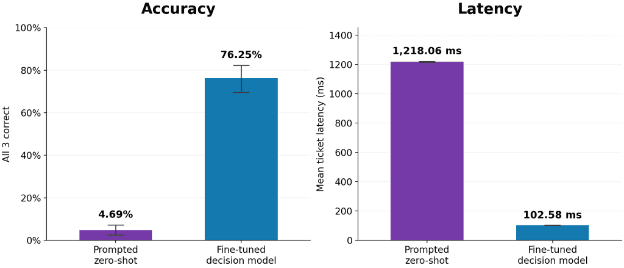
ทีมงานได้ทดลองใช้ Beam ในภารกิจต่างๆ เช่น การสร้างแอปพลิเคชัน MacOS แบบ Native สำหรับถอดความเสียง, การจัดการงานผ่านระบบ Multi-agent เพื่อแก้ปัญหา ProgramBench และการสร้างโมเดลตัดสินใจสำหรับคัดกรองเหตุการณ์ผิดปกติใน Code base ซึ่งพบว่าช่วยลดความหน่วงและเพิ่มความแม่นยำได้มากกว่าการใช้ Prompt แบบปกติ
บทสรุป
Beam คือก้าวสำคัญของโมเดลแบบเปิดขนาด 501B ที่ยืดหยุ่นสูง ผู้ใช้สามารถเลือกเริ่มจาก BF16 หรือรุ่น Quantize อย่าง FP8 และ NVFP4 เพื่อรันบนฮาร์ดแวร์ส่วนตัวได้ทันที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร