
เผยโครงสร้าง Sleep: แนวคิดใหม่ช่วย LLM เรียนรู้ต่อเนื่องไม่หยุดยั้ง
LLM สมัยใหม่ทำผลงานได้อย่างน่าทึ่งผ่านการ pre-training และ in-context learning (ICL) อย่างไรก็ตาม เมื่อนำไปใช้งานจริง โมเดลส่วนใหญ่ยังคงอยู่ในสภาวะคงที่และมีขีดจำกัดด้านวันที่ตัดข้อมูล (cutoff date) ทำให้ไม่สามารถพัฒนาความสามารถในระยะยาวหรือปรับตัวเข้ากับข้อมูลใหม่ได้
แม้การอัปเดตโมเดลด้วยข้อมูลใหม่จะเป็นทางออกที่ชัดเจน แต่การปรับพารามิเตอร์อย่างต่อเนื่องมักก่อให้เกิด catastrophic forgetting ซึ่งเป็นปัญหาใหญ่ที่การเรียนรู้สิ่งใหม่ไปทำลายประสิทธิภาพในงานเดิมที่เคยเรียนรู้มาก่อน ขณะเดียวกันการพึ่งพา ICL เพียงอย่างเดียวก็จำกัดการรักษาข้อมูลไว้แค่ใน context window เมื่อสิ้นสุดเซสชัน ข้อมูลระยะสั้นเหล่านั้นก็จะหายไป
ด้วยแรงบันดาลใจจากการทำงานของสมองมนุษย์ที่ประมวลผลและทำให้หน่วยความจำคงที่ในช่วงพักผ่อน เราขอแนะนำ sleep framework สำหรับการเรียนรู้อย่างต่อเนื่อง ซึ่งเป็นกระบวนทัศน์ที่ช่วยให้ large language models (LLMs) มีวงจรชีวิตแบบเป็นคาบอย่างสม่ำเสมอ เพื่อรวมบริบทระยะสั้นที่เปราะบางให้กลายเป็นพารามิเตอร์ระยะยาวที่มั่นคง การสลับระหว่างการโต้ตอบ (active interaction) และการรวมหน่วยความจำแบบออฟไลน์ (offline memory consolidation) ช่วยให้ LLM รับข้อเท็จจริงใหม่ได้ต่อเนื่อง รักษาบริบทได้ยาวถึง 10 ล้าน tokens และเพิ่มทักษะการให้เหตุผลที่ซับซ้อนได้ดียิ่งขึ้น
การคิดใหม่เกี่ยวกับการเรียนรู้ของเครื่อง: ช่วง Active เทียบกับช่วง Sleep
การเรียนรู้ของเครื่องแบบดั้งเดิมมักแยกส่วนระหว่างการฝึกฝน (training) และการอนุมาน (inference) อย่างเด็ดขาด แต่ในโครงสร้างการเรียนรู้อย่างต่อเนื่องนี้ เอเจนต์ที่ชาญฉลาดต้องเรียนรู้และปรับตัวอยู่ตลอดเวลา
ภายใต้กระบวนทัศน์การนอนหลับ LLM จะทำงานในสองสถานะหลัก:
- Active (wake) phase: โมเดลจะรับ ประมวลผล และโต้ตอบกับข้อมูลขาเข้า โดยจัดเก็บข้อมูลชั่วคราวไว้ในหน่วยความจำระยะสั้นที่รวดเร็ว
- Sleep phase: โมเดลจะหยุดประมวลผลข้อมูลใหม่ และหันไปใช้ทรัพยากรคำนวณภายในเพื่อรวมหน่วยความจำและปรับปรุงตนเอง
แม้คำว่า "การนอนหลับ" หรือ "การฝัน" จะหยิบยืมมาจากประสาทวิทยาศาสตร์ แต่โครงสร้างนี้ทำงานภายใต้สถาปัตยกรรมโมเดลและกฎการฝึกฝนที่กำหนดไว้ ในช่วง sleep phase แบบออฟไลน์ โมเดลจะปลดล็อกบล็อกหน่วยความจำ Mixture-of-Experts (MoE) ที่จัดสรรไว้ล่วงหน้า และอัปเดตค่าน้ำหนักตัวเลข (numerical weights) โดยใช้ตัวอย่างที่สร้างขึ้นเอง ช่วยให้โมเดลดูดซับข้อเท็จจริงใหม่และเพิ่มความแม่นยำได้โดยไม่ต้องเปลี่ยนรหัสต้นฉบับ
ส่วนประกอบสำคัญของกระบวนการนอนหลับ
กระบวนทัศน์นี้จัดการกับปัญหา catastrophic forgetting และการปรับตัวอย่างต่อเนื่องผ่านสองขั้นตอนสำคัญ ได้แก่ การรวบรวมหน่วยความจำและการฝัน
1. การรวบรวมหน่วยความจำ
เช่นเดียวกับช่วง non-rapid eye movement (NREM) ในมนุษย์ โครงสร้างการนอนหลับจะจำลองการโอนย้ายข้อมูลผ่านกลไกทางเทคนิคดังนี้:
- การขยาย parameter และลำดับชั้นหน่วยความจำ: โมเดลจะปรับขนาดความสามารถแบบไดนามิกผ่านสถาปัตยกรรม Mixture of Experts (MoE) และ Hope โดยใช้ผู้เชี่ยวชาญระดับต่ำ (low-rank experts) มาจัดเก็บความรู้ใหม่โดยไม่รบกวนพารามิเตอร์เดิม
- การวางรากฐานความรู้: ข้อมูลระยะสั้นจะถูกโอนไปยังพารามิเตอร์ระยะยาวผ่าน Generalized Knowledge Distillation (GKD) ร่วมกับ imitation learning บนพื้นฐานของ reinforcement learning (RL)
- Synaptic pruning: เมื่อรวมหน่วยความจำเสร็จสิ้น พารามิเตอร์ชั่วคราวจะถูกรีเซ็ตเพื่อเตรียมพื้นที่สำหรับข้อมูลในอนาคต
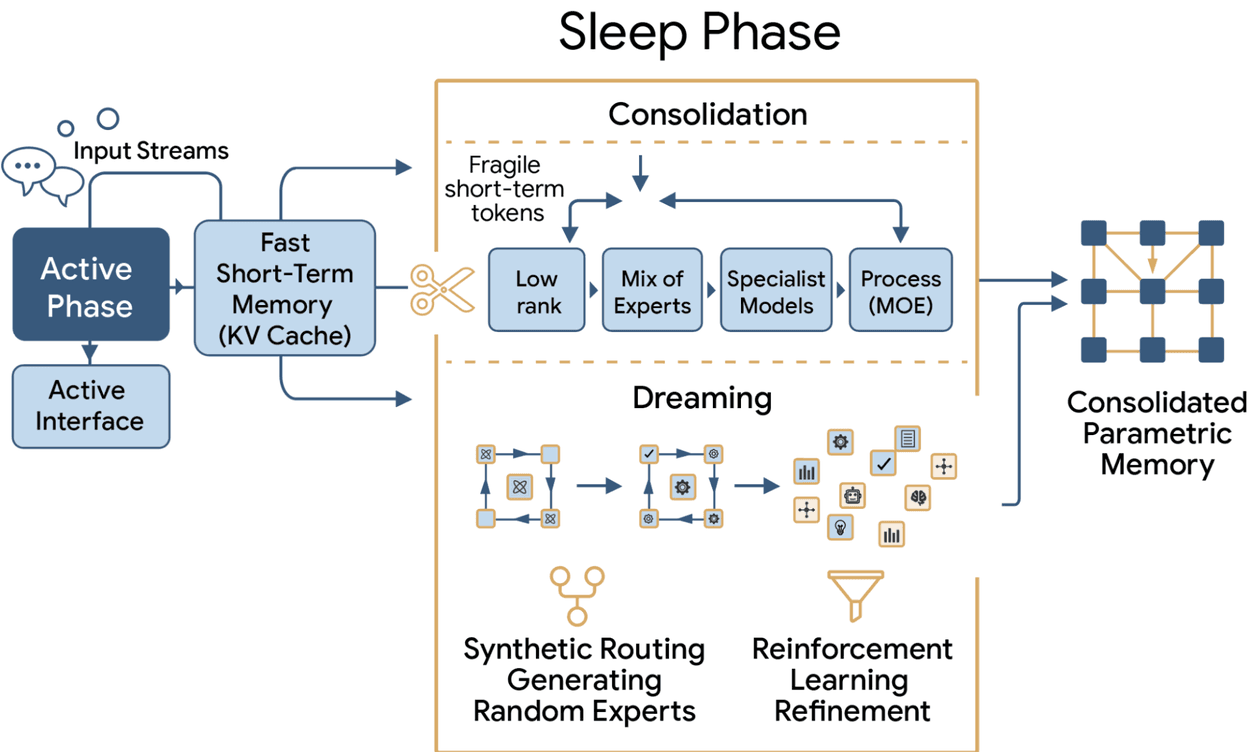
ภาพรวมโครงสร้างการนอนหลับ: ข้อมูลจากช่วง active จะถูกส่งต่อมายังรอบการนอนหลับ ซึ่งแบ่งเป็น Consolidation (การโอนข้อมูลระยะสั้นไปยังหน่วยความจำระยะยาว) และ Dreaming (การปรับปรุงตนเองผ่าน RL)
2. การฝันเพื่อการปรับปรุงตนเอง
ในช่วง REM sleep สมองจะจำลองสถานการณ์และสำรวจเส้นทางประสาทใหม่ๆ ซึ่งโครงสร้างการนอนหลับก็นำแนวคิดนี้มาใช้ผ่านลูปอัตโนมัติ:
- การเลือกผู้เชี่ยวชาญแบบสุ่ม: MoE router จะสุ่มเปิดใช้งานผู้เชี่ยวชาญที่ไม่เป็นมาตรฐาน เพื่อบีบคั้นให้โมเดลผสมผสานความรู้จากโดเมนที่ต่างกัน
- การซักซ้อมที่คัดสรรแล้ว: โมเดลสร้างข้อมูลสังเคราะห์ ("ความฝัน") และคัดกรองตัวอย่างที่มีศักยภาพสูงสุดมาฝึกฝน
- การขัดเกลาด้วย RL: ทำการ fine-tuning บนตัวอย่างที่ดีที่สุดเพื่อประเมินและเพิ่มประสิทธิภาพในงานต่างๆ
รากฐานทางทฤษฎี
กระบวนทัศน์การนอนหลับมีทฤษฎีรองรับว่าทำไมขั้นตอนเหล่านี้จึงสนับสนุนการเรียนรู้อย่างต่อเนื่องโดยไม่เสียความสามารถเดิม
ในการรวบรวมหน่วยความจำ โมเดลจะระบุชุดของทิศทางที่กระชับเพื่อรักษาพฤติกรรมเดิมและคุณสมบัติทางความหมายที่สำคัญ แทนที่จะคัดลอกทุกรายละเอียด โดยมี on-policy distillation ช่วยจัดตำแหน่งให้สอดคล้องกับแนวทางที่โมเดลจะผลิตจริงขณะใช้งาน
สำหรับการฝัน การเปิดใช้งาน MoE แบบสุ่มช่วยขยายชุดทิศทาง gradient ทำให้โมเดลพบการอัปเดตที่สมบูรณ์กว่าข้อมูลในช่วงเวลาตื่นปกติ และการกรองข้อมูลช่วยให้การปรับปรุงมีสมดุลและมั่นคงยิ่งขึ้น
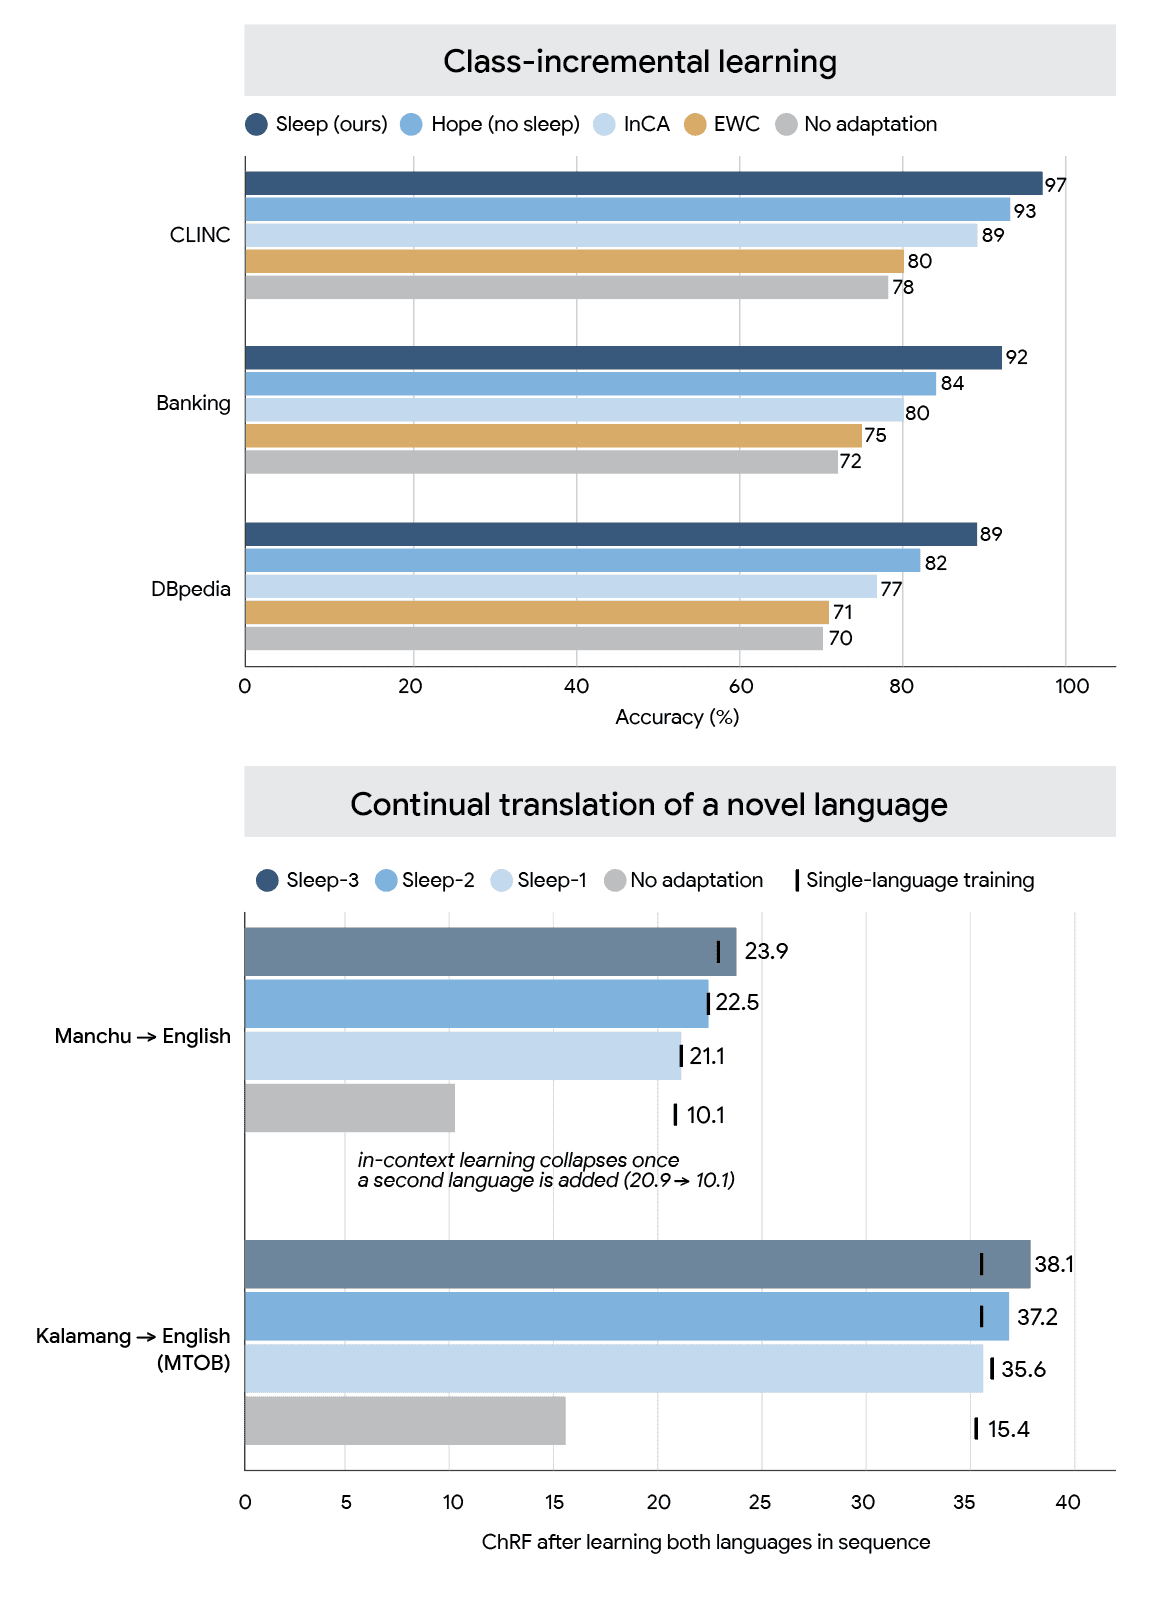
กราฟเปรียบเทียบประสิทธิภาพ: โครงสร้างการนอนหลับทำคะแนนได้เหนือกว่าวิธีมาตรฐาน ทั้งในการแปลภาษาต่อเนื่อง การขยายบริบทถึง 10 ล้าน tokens และการให้เหตุผลทางคณิตศาสตร์
ผลการทดสอบพบว่า ในการแปลภาษาต่อเนื่อง (continual translation) สำหรับภาษาที่พบยาก โมเดลนี้รักษาประสิทธิภาพได้คงที่เกือบ 100% ขณะที่วิธีเดิมอย่าง ICL หรือ supervised fine-tuning (SFT) เกิดปัญหา catastrophic forgetting อย่างรุนแรง
ด้านการทำความเข้าใจบริบทระยะยาวบน BABILong วิธีนี้สามารถขยาย context window ได้ถึง 10 ล้าน tokens เหนือกว่า GPT-4 และ Titans ส่วนการให้เหตุผลทางคณิตศาสตร์บน AIME 24/25 ก็ทำคะแนนได้สูงถึง 79.2% ซึ่งสูงกว่าการใช้ GRPO หรือ OPSD แบบเดิมอย่างชัดเจน
บทสรุป
กระบวนทัศน์การนอนหลับเป็นเส้นทางใหม่สู่ระบบ AI ที่เรียนรู้ได้อย่างอิสระ การสลับระหว่างการทำงานที่ตื่นตัวและการพักผ่อนแบบออฟไลน์ ช่วยให้ LLM สามารถก้าวข้ามขีดจำกัดเดิมๆ สรุปทักษะใหม่เข้าสู่พารามิเตอร์ และพัฒนาตนเองได้อย่างต่อเนื่องโดยไม่มีที่สิ้นสุด
กิตติกรรมประกาศ
งานวิจัยนี้ จัดทำโดย Ali Behrouz (Google และ Cornell University), Farnoosh Hashemi (Cornell University), Adel Javanmard (Google และ University of Southern California) และ Vahab Mirrokni โดยได้รับข้อเสนอแนะจาก Yuan Deng และ Corinna Cortes พร้อมความช่วยเหลือจาก Mark Simborg, Kimberly Schwede และ Tim Herrmann
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร