
สร้าง Conversational Commerce ด้วย Multi-Agent Swarms บน GCP
27 ต.ค. 2026
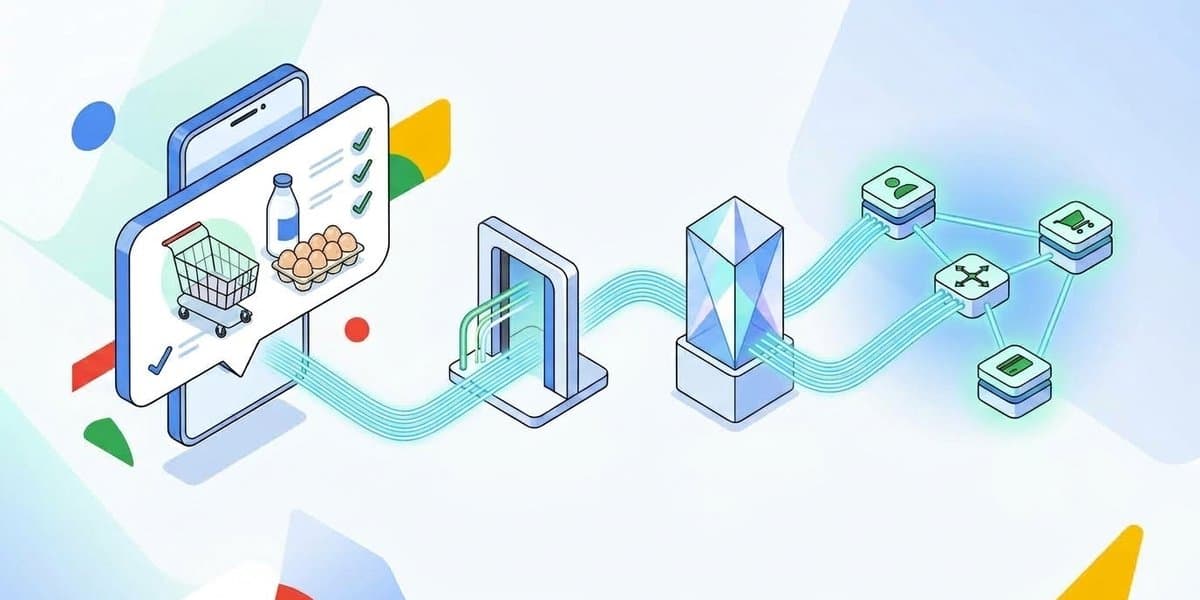
ลองจินตนาการถึงการสั่งซื้อของชำประจำสัปดาห์ที่เป็นธรรมชาติเหมือนการส่งข้อความหาเพื่อน: "เฮ้ นมกับไข่ของเราหมดแล้ว ช่วยเพิ่มขนมสำหรับดูหนังคืนวันศุกร์ให้ด้วยได้ไหม?"
ในโพสต์ก่อนหน้านี้ของเรา Building Conversational Commerce with Multi-Agent Swarms on GCP เราได้แชร์พิมพ์เขียวทางสถาปัตยกรรมสำหรับ commerce แบบสนทนา โดยนำเสนอการออกแบบแบบแยกส่วน 3 เลเยอร์ (Ingress, Memory และ Cognition) เพื่อแก้ปัญหาการหมดเวลาของข้อความ (messaging timeouts), การติดตามสถานะ (state tracking) และความน่าเชื่อถือของการตอบกลับ
แม้ว่าพิมพ์เขียวจะกำหนดสถาปัตยกรรมไว้บนกระดาษ แต่การใช้งานจริง (production readiness) จำเป็นต้องมีซอฟต์แวร์ที่ทำงานได้จริง ในโพสต์นี้ เราจะเปลี่ยนพิมพ์เขียวนั้นให้มีชีวิตด้วยต้นแบบที่ชื่อว่า HappyDelivery
เราจะใช้ LangGraph, Gemini, FastAPI และ Google Cloud เพื่อเจาะลึกทั้งโค้ด, state machine, เครื่องมือทางการเงินแบบ deterministic และชุดการตรวจสอบอัตโนมัติ เพื่อแสดงให้เห็นว่า multi-agent swarm นี้ทำงานอย่างไรในเชิงปฏิบัติ
ในการสร้าง commerce swarm ที่เชื่อถือได้ เราได้แยกการจัดการข้อความจากลูกค้าออกเป็นสามเลเยอร์ดังนี้:
Layer 1: Ingress & Payload Normalization
คำถามสำคัญในการออกแบบระบบนี้คือ: ข้อความจากสมาร์ทโฟนของลูกค้าจะมาถึง Layer 1 ได้อย่างไร และรองรับแพลตฟอร์มอื่นนอกจาก WhatsApp หรือไม่?
ความจริงคือผู้ใช้ไม่ได้สื่อสารกับเซิร์ฟเวอร์ Google Cloud ของคุณโดยตรง แต่ข้อความจะเดินทางผ่านระบบนิเวศของผู้ให้บริการก่อนจะส่งมายัง webhook ของคุณ โดยทุกแพลตฟอร์มทำงานบนหลักการเดียวกันคือการส่งมอบ webhook แบบ asynchronous HTTPS POST พร้อมกำหนดเวลาหมดเวลาที่เข้มงวด:
- WhatsApp (Meta Cloud API): ต้องการการตอบรับ HTTP 200 OK ทันทีและการตรวจสอบลายเซ็น HMAC-SHA256 หากหมดเวลา Meta จะลองส่งใหม่แบบ exponential backoff ซึ่งอาจทำให้เกิดคำสั่งซื้อซ้ำซ้อน
- Google RCS Business Messaging (RBM): ส่งผ่าน Cloud Pub/Sub หรือ HTTPS webhooks ที่ตรวจสอบสิทธิ์ผ่าน OAuth2 หรือ HMAC ต้องการ
HTTP 200ทันทีเช่นกัน - Apple Messages for Business (AMB): ส่งผ่านผู้ให้บริการที่ได้รับการรับรอง (MSP) ตรวจสอบผ่าน JWS หรือ mTLS และคาดหวังการตอบรับทันที
- SMS / MMS (Twilio, Sinch, Infobip): ใช้มาตรฐาน webhooks แบบ JSON POST ที่ลงนามด้วย HMAC tokens
Layer 1 จะทำหน้าที่แยกความแตกต่างของไคลเอนต์แต่ละรายผ่าน Security & Signature Verifier และ Payload Normalization Adapter เพื่อแปลงข้อมูลเป็น canonical schema (CommonMessageEvent) ดังนี้:
{
"channel": "whatsapp", # หรือ "rcs", "apple_messages", "sms"
"sender_id": "+1xxxxxxxxxx", # หมายเลขโทรศัพท์ E.164 ที่ตรวจสอบแล้ว
"text": "Out of milk & eggs",
"timestamp": 1773428900,
"raw_metadata": {...}
}
กระบวนการนี้จะเข้าคิวข้อความลงใน Google Cloud Pub/Sub และส่งคืน HTTP 200 OK ภายในเวลาที่น้อยกว่า 150ms เพื่อให้ส่วนที่เหลือของระบบทำงานบนข้อมูลที่สะอาดโดยไม่ต้องกังวลเรื่องที่มาของข้อความ
Layer 2: Session & Persistent Cart Memory เนื่องจากแพลตฟอร์มข้อความมีความเป็น stateless ระบบจึงต้องสร้างบริบทลูกค้าขึ้นใหม่ทันที เราใช้ Cloud Memorystore (Redis) โดยใช้หมายเลขโทรศัพท์เป็นคีย์เพื่อเก็บสถานะที่ใช้งานอยู่
การออกแบบนี้ช่วยรองรับพฤติกรรมผู้ใช้ในชีวิตจริง เช่น การสั่งของทิ้งช่วงเวลา (เพิ่มนมตอนเช้า แล้วค่อยมาถามยอดรวมตอนบ่าย) รวมถึงการใช้ Contextual Guardrails เพื่อจดจำความชอบส่วนตัวหรืออาการแพ้อาหาร และการทำ Safe, Tokenized Checkout ที่ช่วยให้ LLM เข้าถึงเฉพาะข้อมูลที่จำเป็นโดยไม่สัมผัสเลขบัตรเครดิตโดยตรง
ในแง่ของประสิทธิภาพ Google Cloud Memorystore for Redis สามารถจัดการได้ 10,000 ถึง 50,000+ QPS ด้วยความหน่วงระดับต่ำกว่ามิลลิวินาที จึงมั่นใจได้ว่าเลเยอร์นี้จะไม่เป็นคอขวดของระบบแน่นอน
Layer 3: The Multi-Agent Cognition Swarm
แทนที่จะใช้ prompt ขนาดใหญ่เพียงอันเดียว เราแยกหน้าที่การทำงานออกเป็นเอเจนต์เฉพาะทาง:
- Supervisor (Gemini Flash): ทำหน้าที่เป็นเราเตอร์ความหน่วงต่ำ คัดแยกและส่งต่องานให้ผู้เชี่ยวชาญ
- Profile Specialist: จัดการข้อมูลความชอบและลิงก์ตรวจสอบสิทธิ์
- Inventory Specialist (Gemini Pro): เชื่อมต่อกับระบบคลังสินค้า ตรวจสอบสต็อก และจัดการรถเข็น
- Transaction Specialist (Gemini Pro): คำนวณยอดเงินและเริ่มกระบวนการเรียกเก็บเงิน
เราใช้ LangGraph ในการกำหนดโครงสร้าง state machine เพื่อควบคุมการไหลของข้อมูลระหว่างเอเจนต์ โดยเน้นการใช้เครื่องมือแบบ deterministic สำหรับงานคำนวณที่ต้องการความแม่นยำสูง เช่น ภาษีและค่าธรรมเนียม เพื่อป้องกันข้อผิดพลาดจากการที่ LLM คำนวณเลขเอง
@tool
def calculate_cart_totals(cart_items: list[dict]) -> dict:
    """Calculates deterministic subtotal, tax, delivery fees, and grand total."""
    subtotal = sum(item.get("price", 0.0) * item.get("qty", 1) for item in cart_items)
    tax = round(subtotal * 0.0825, 2)
    delivery_fee = 0.00 if subtotal > 15.00 else 3.99
    total = round(subtotal + tax + delivery_fee, 2)
    return {"subtotal": round(subtotal, 2), "tax": tax, "delivery_fee": delivery_fee, "total": total}
การประเมินผลและต้นทุนการดำเนินงาน
จากการทดสอบระบบจริงบน Cloud Run พบว่าบริการ Ingress สามารถตอบสนองได้รวดเร็ว (Handshake < 300ms) และแยกส่วนการประมวลผล AI ออกไปทำงานเบื้องหลังได้อย่างสมบูรณ์
ในด้านต้นทุน การใช้สถาปัตยกรรมแบบแยกส่วนช่วยประหยัดค่าใช้จ่าย LLM ได้อย่างมาก จากการทดสอบ 3 รอบการสนทนาเพื่อปิดการขาย ระบบใช้ token รวมประมาณ 4,240 tokens คิดเป็นค่าใช้จ่ายเพียง $0.0061 (ประมาณ 0.03% ของมูลค่าสินค้า $20.32) ซึ่งถูกกว่าค่าธรรมเนียมบัตรเครดิตทั่วไปอย่างมาก
บทสรุป
การนำพิมพ์เขียวนี้ไปใช้งานจริงพิสูจน์ให้เห็นว่า สถาปัตยกรรมแบบแยกส่วนช่วยแก้ปัญหาหลักของ Conversational Commerce ได้ ทั้งเรื่องความแม่นยำทางการเงิน ความต่อเนื่องของบทสนทนา และการควบคุมต้นทุน
ด้วยการผสานพลังของ LangGraph, Gemini และโครงสร้างพื้นฐานของ GCP เราสามารถสร้างระบบการค้าที่ใช้งานง่ายเหมือนการส่งข้อความ แต่มีความเข้มงวดและเชื่อถือได้ในระดับองค์กร
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร