
เปิดตัว Inkling: โมเดล Open Multimodal ระดับ 1 ล้านล้านพารามิเตอร์จาก Thinking Machines
Inkling คือ open model ขนาดใหญ่ (พารามิเตอร์ 1T!) ที่รองรับอินพุตภาพ ข้อความ และเสียงแบบเนทีฟ
TLDR; Inkling โดย Thinking Machines เปิดตัวแล้วบน Hugging Face โดยเป็น multimodal LLM ขนาดมหึมาที่เข้าใจข้อมูลครบทุกรูปแบบ (ภาพ, เสียง, ข้อความ) มีความสามารถโดดเด่นด้าน agentic และรองรับบริบท (context) ได้ถึง 1M มาในรูปแบบ BF16 และเวอร์ชัน NVFP4 ที่ปรับแต่งมาอย่างดี พร้อมเลเยอร์ speculative MTP เพื่อช่วยให้ทำ inference ได้รวดเร็วขึ้น โดยรองรับการใช้งานตั้งแต่วันแรกทั้งใน transformers, SGLang และ llama.cpp
อะไรที่ทำให้ Inkling พิเศษ?
Inkling เป็น open model ขนาดใหญ่ตัวแรกที่มีพารามิเตอร์ระดับ ~1T parameters และมี 1M context window ที่สามารถประมวลผลอินพุตประเภท ภาพ ข้อความ และเสียง ได้แบบเนทีฟ โดยผ่านการฝึกฝนด้วยข้อมูลรวมกว่า 45 trillion tokens ทั้งจากข้อความ ภาพ เสียง และวิดีโอ โมเดลรุ่นนี้เน้นการใช้เหตุผลข้ามรูปแบบสื่อ (multimodal reasoning) และออกแบบมาเพื่อการปรับตัวเข้ากับเฉพาะโดเมน (domain adaptation) ผ่านการ fine-tuning ซึ่งเราพบว่าโมเดลนี้ยอดเยี่ยมมากสำหรับการสร้างแอปพลิเคชันยุคใหม่
ภาพรวมความสามารถและสถาปัตยกรรม
Inkling เป็นโมเดล multimodal Mixture-of-Experts แบบ decoder-only ที่มีพารามิเตอร์ทั้งหมด 975B และมีพารามิเตอร์ที่ทำงานจริง (active parameters) 41B โดยมีส่วนประกอบสำคัญดังนี้:
- Decoder-only: ใช้สถาปัตยกรรมที่รองรับการสร้างข้อมูลแบบ causal autoregressive เช่นเดียวกับ LLM ชั้นนำส่วนใหญ่
- Multimodal: รองรับอินพุตข้อความ เสียง และภาพได้โดยตรง
- Mixture of Experts (MoE): เครือข่าย feed forward ภายในเลเยอร์มีความเบาบาง (sparse) ช่วยให้ประมวลผล inference ได้เร็ว เนื่องจากมีพารามิเตอร์ทำงานเพียง 41B ในแต่ละช่วงเวลา โดยมีผู้เชี่ยวชาญ (experts) ทั้งหมด 256 ตัว
นี่คือภาพรวมของสถาปัตยกรรม:
Relative attention: แทนที่จะใช้ RoPE แบบเดิม Inkling ใช้ relative attention ในการเข้ารหัสข้อมูลตำแหน่ง โดยเลเยอร์ attention จะเรียนรู้ตำแหน่งโดยตรงใน attention logits นอกเหนือจาก key-query-values แล้ว ยังมีการโปรเจกชันที่สี่เพื่อสร้างฟีเจอร์สัมพัทธ์ R ต่อโทเค็นต่อหัว ซึ่งจะถูกปรับแต่งด้วยข้อมูลระยะห่างและส่งต่อไปยังโมดูล attention
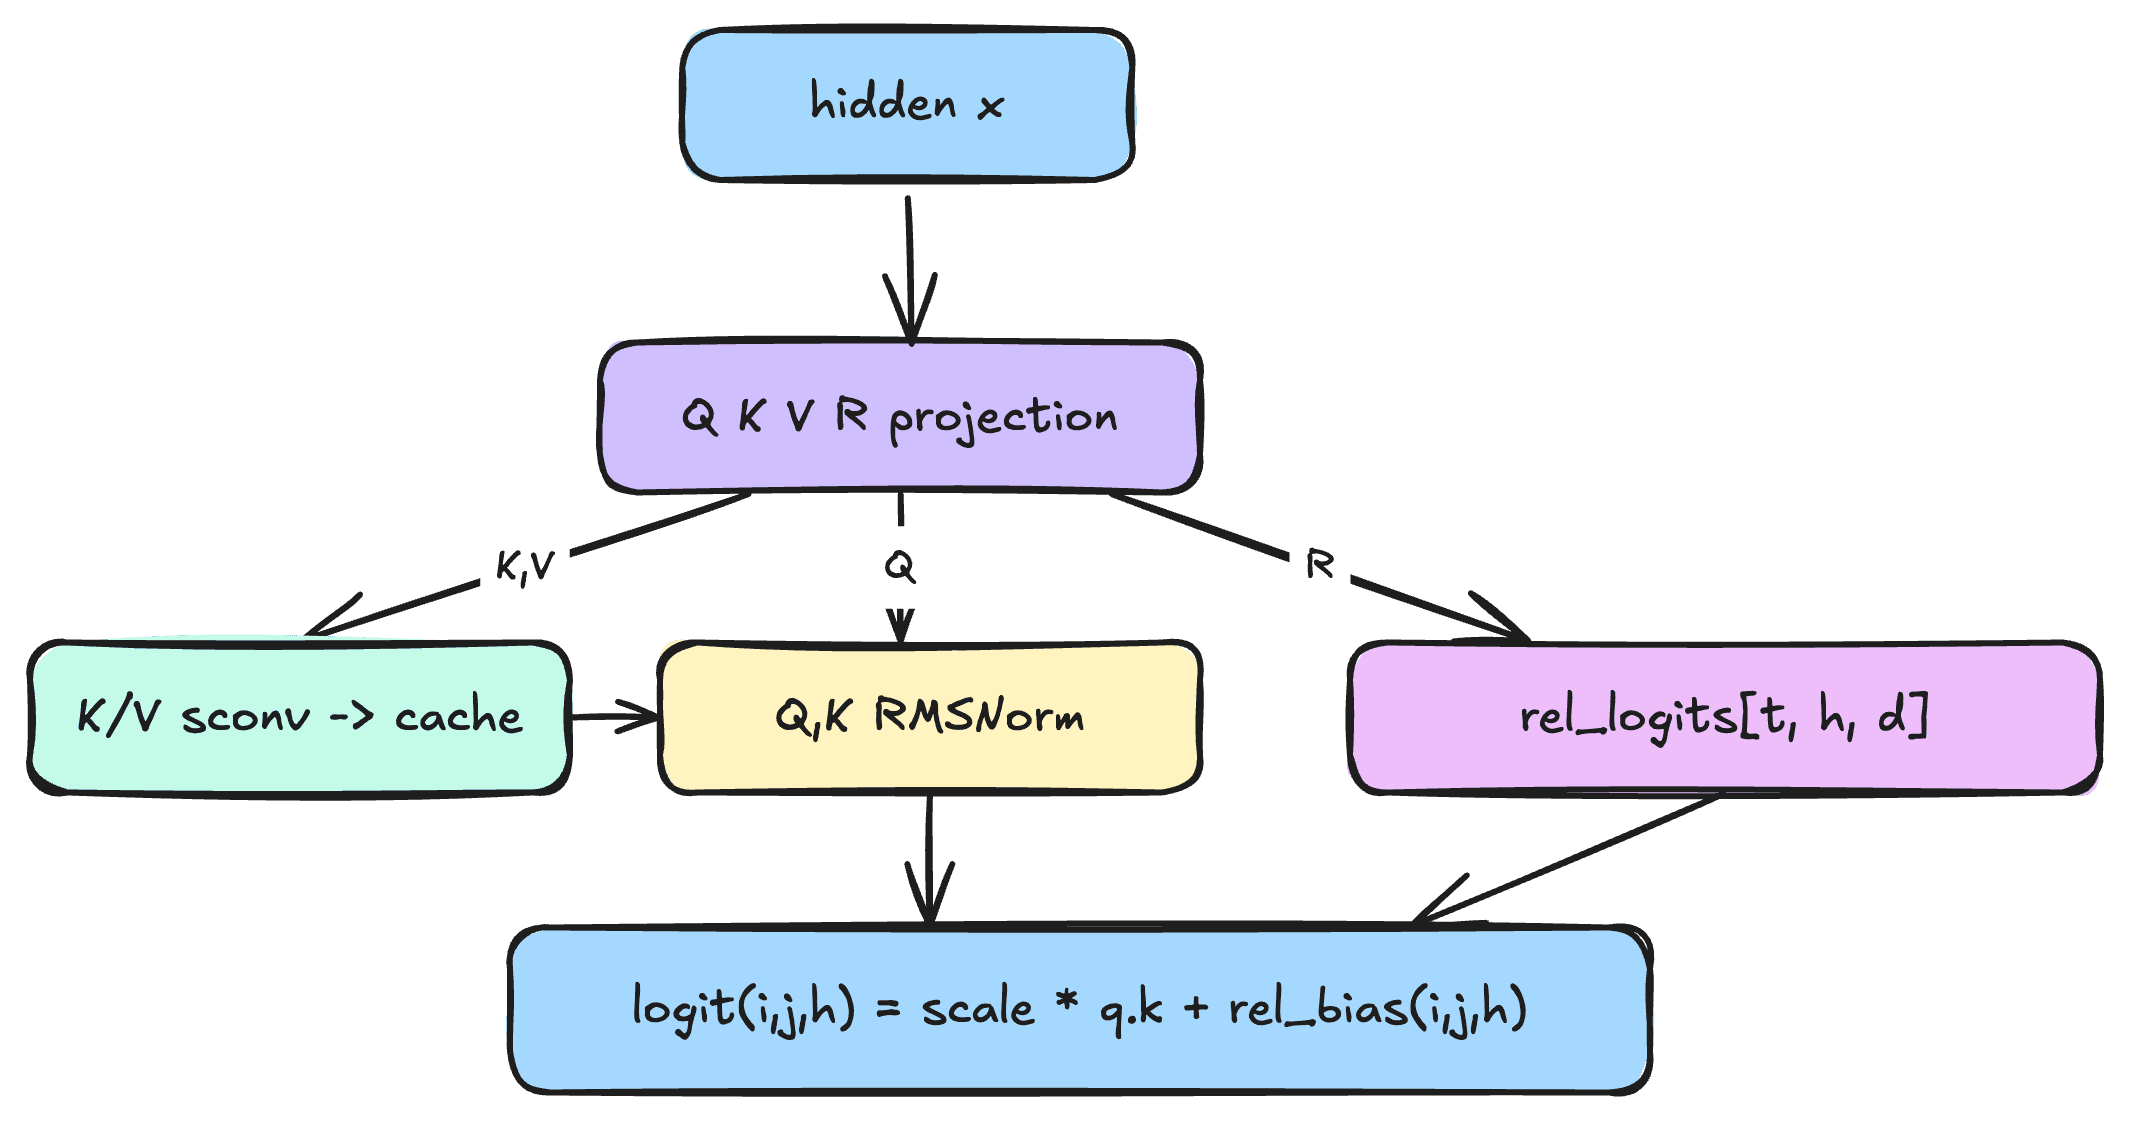
Hybrid attention: เลเยอร์ของ decoder จะสลับกันระหว่าง global attention (พิจารณาความยาวบริบททั้งหมด) และ sliding window attention (พิจารณาบริบทเฉพาะส่วน) โดยมีอัตราส่วน 5:1 เพื่อให้คำนวณได้อย่างมีประสิทธิภาพ ส่วนเลเยอร์สุดท้ายจะใช้ global attention เพื่อสร้างการนำเสนอข้อมูล (representations) ที่สมบูรณ์
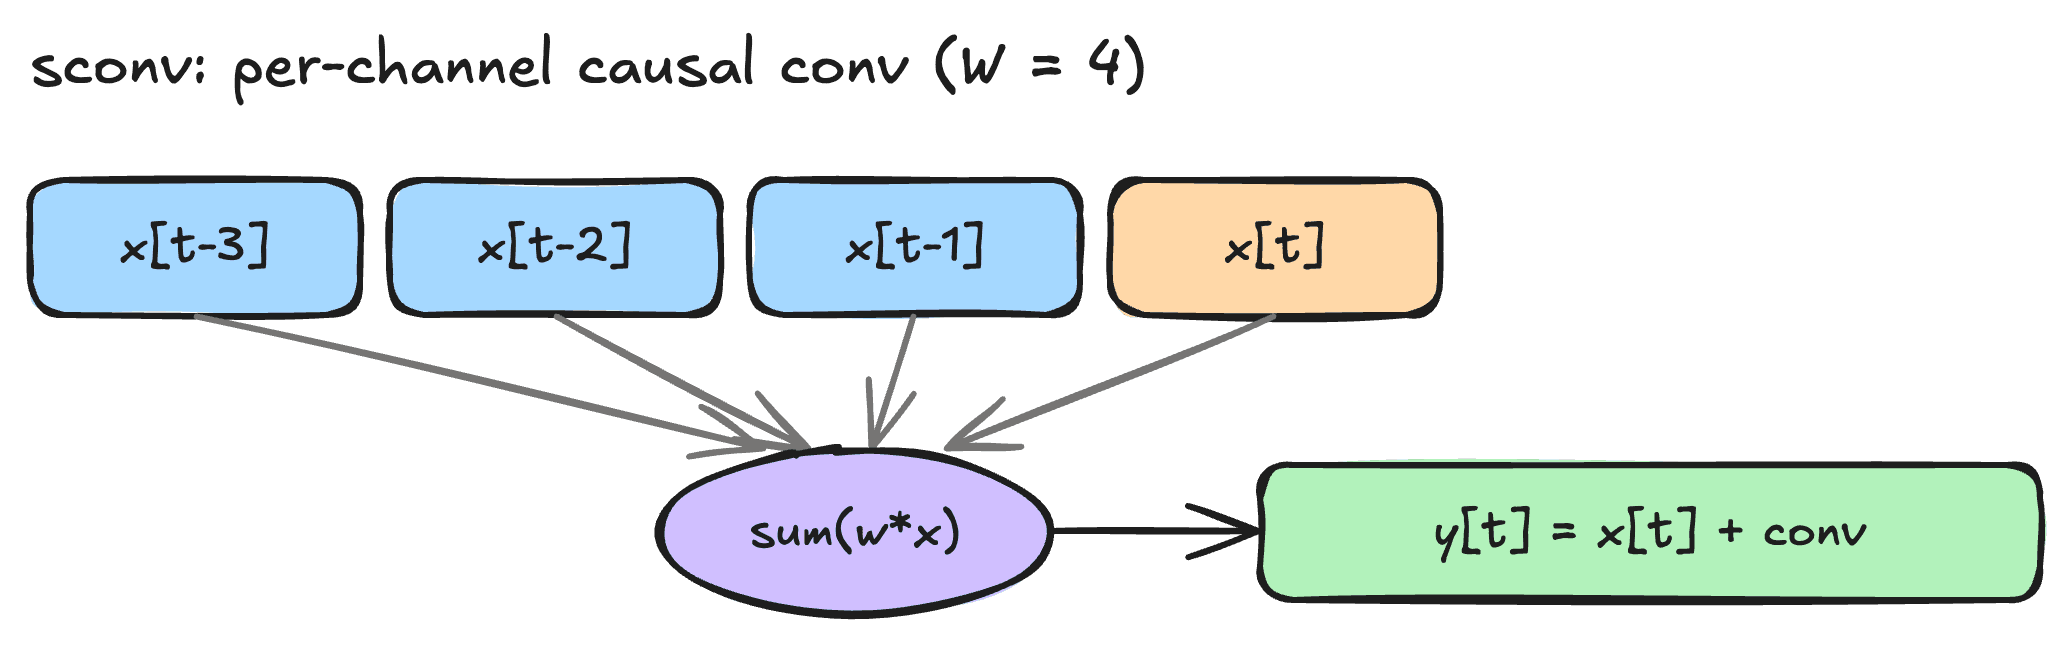
Short convolution: โมเดลใช้ 1D convolution ระยะสั้นหรือ SConv เหนือสถานะที่ซ่อนอยู่ (hidden states) เพื่อช่วยในเรื่อง local attention และทำให้โมดูล attention กับ MoE ทำงานได้อย่างอิสระ
MoE with shared experts sink: ใน Inkling ตัวเลือกเส้นทาง (router) จะให้คะแนนทั้ง routed experts และ shared experts โดยการเลือก Top-k จะใช้ผู้เชี่ยวชาญ 6 ตัว บวกกับ shared experts อีก 2 ตัวที่จะทำงานตลอดเวลา
Vision understanding: ใช้ hierarchical MLP patchifier แบบง่ายเพื่อรวมพิกเซลเข้าด้วยกันอย่างต่อเนื่องจนได้หนึ่ง embedding ต่อหนึ่ง patch
Audio understanding: ใช้ discretized mel spectrogram โดยแปลงเสียงทุก 100 ms เป็นมาตราส่วน mel และจัดประเภทลงในช่อง (bin) ที่แม่นยำ
สถาปัตยกรรม multimodal towers นั้นเรียบง่ายแต่ทรงพลัง โดยแต่ละ image patch จะผ่าน image embedding tower และ audio chunk จะผ่าน audio embedding tower อินพุตภาพยังรองรับมิติด้านเวลาสำหรับการประมวลผลวิดีโอ ซึ่งเป็นประโยชน์มากสำหรับการ fine-tuning ในอนาคต
การรองรับการ Inference
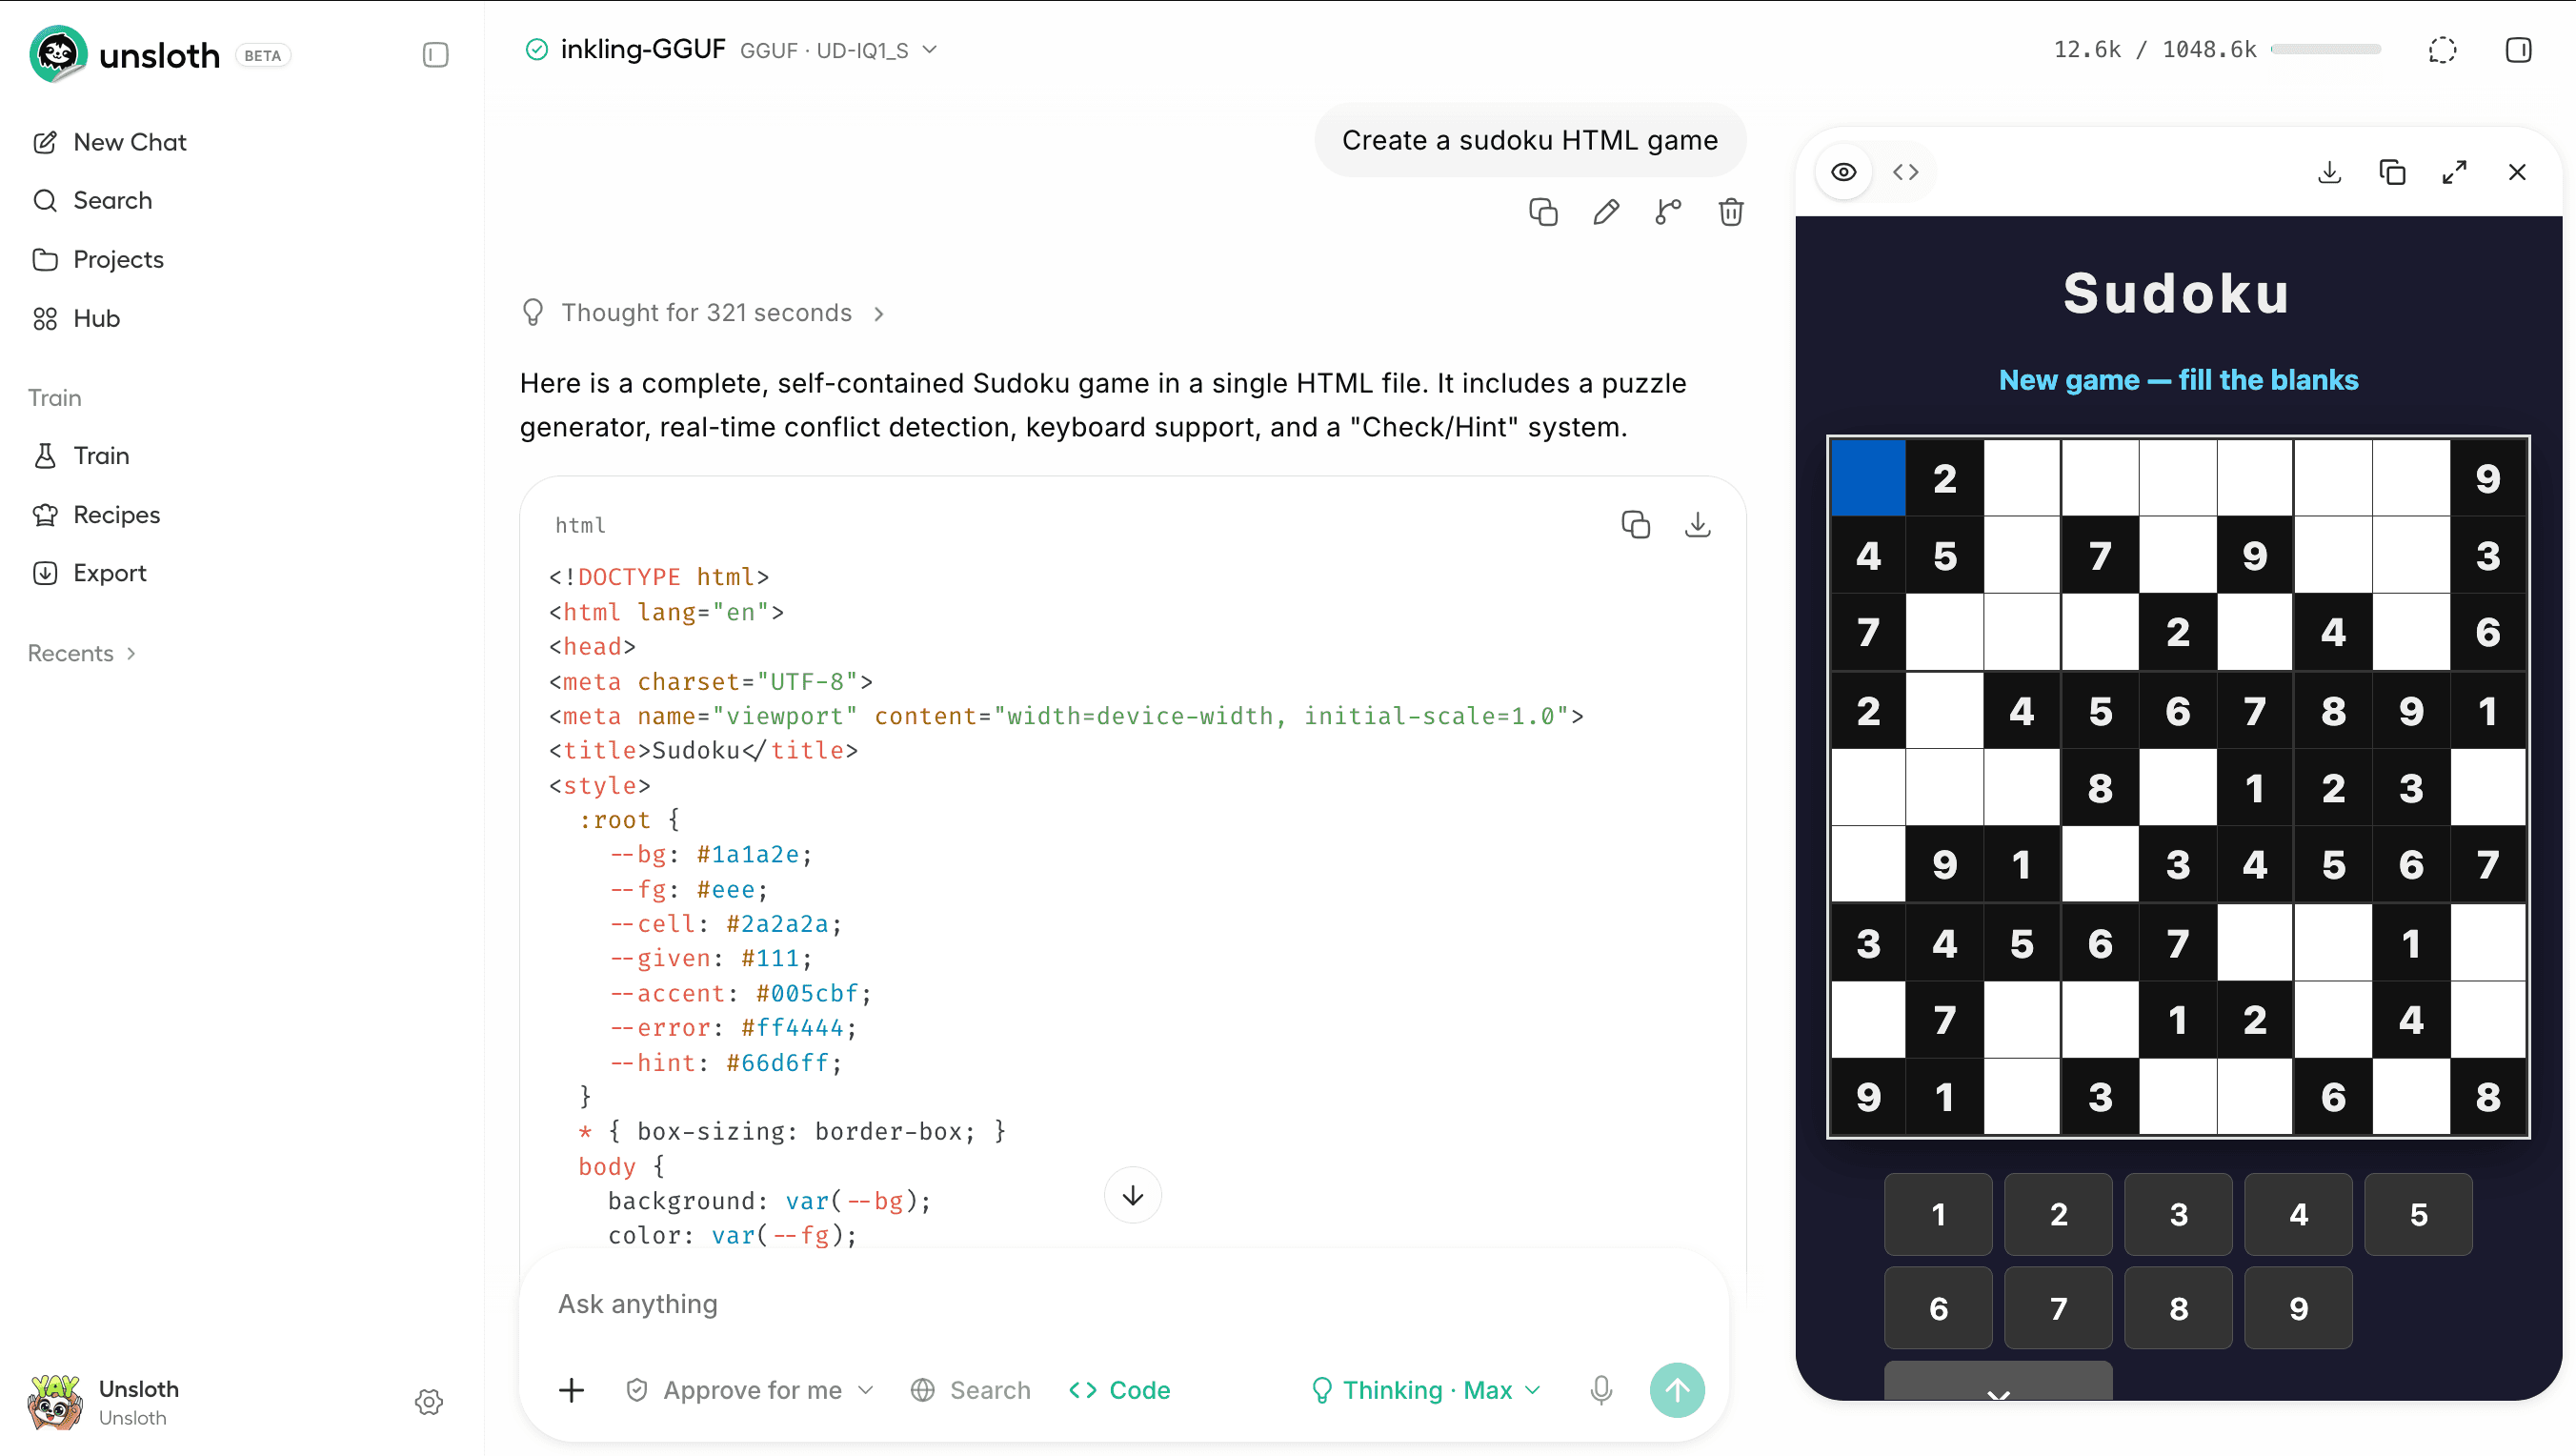
Inkling รองรับการใช้งานผ่าน transformers ตั้งแต่วันแรก และรองรับเอนจินหลักอย่าง SGLang และ vLLM เนื่องจากโมเดลมีขนาดใหญ่มาก checkpoint แบบ bf16 ต้องใช้ VRAM ถึง 2 TB ส่วนเวอร์ชัน nvfp4 ใช้ 600 GB ผู้ใช้สามารถทดลองผ่าน serverless inference หรือใช้ ggml quants ในเครื่องผ่าน llama.cpp
Transformers
วิธีที่ง่ายที่สุดคือใช้ pipeline แบบ any-to-any คุณสามารถใช้รุ่น 16 bit `
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร