
Cohere เปิดตัว North Small Translate โมเดลแปลภาษา MoE
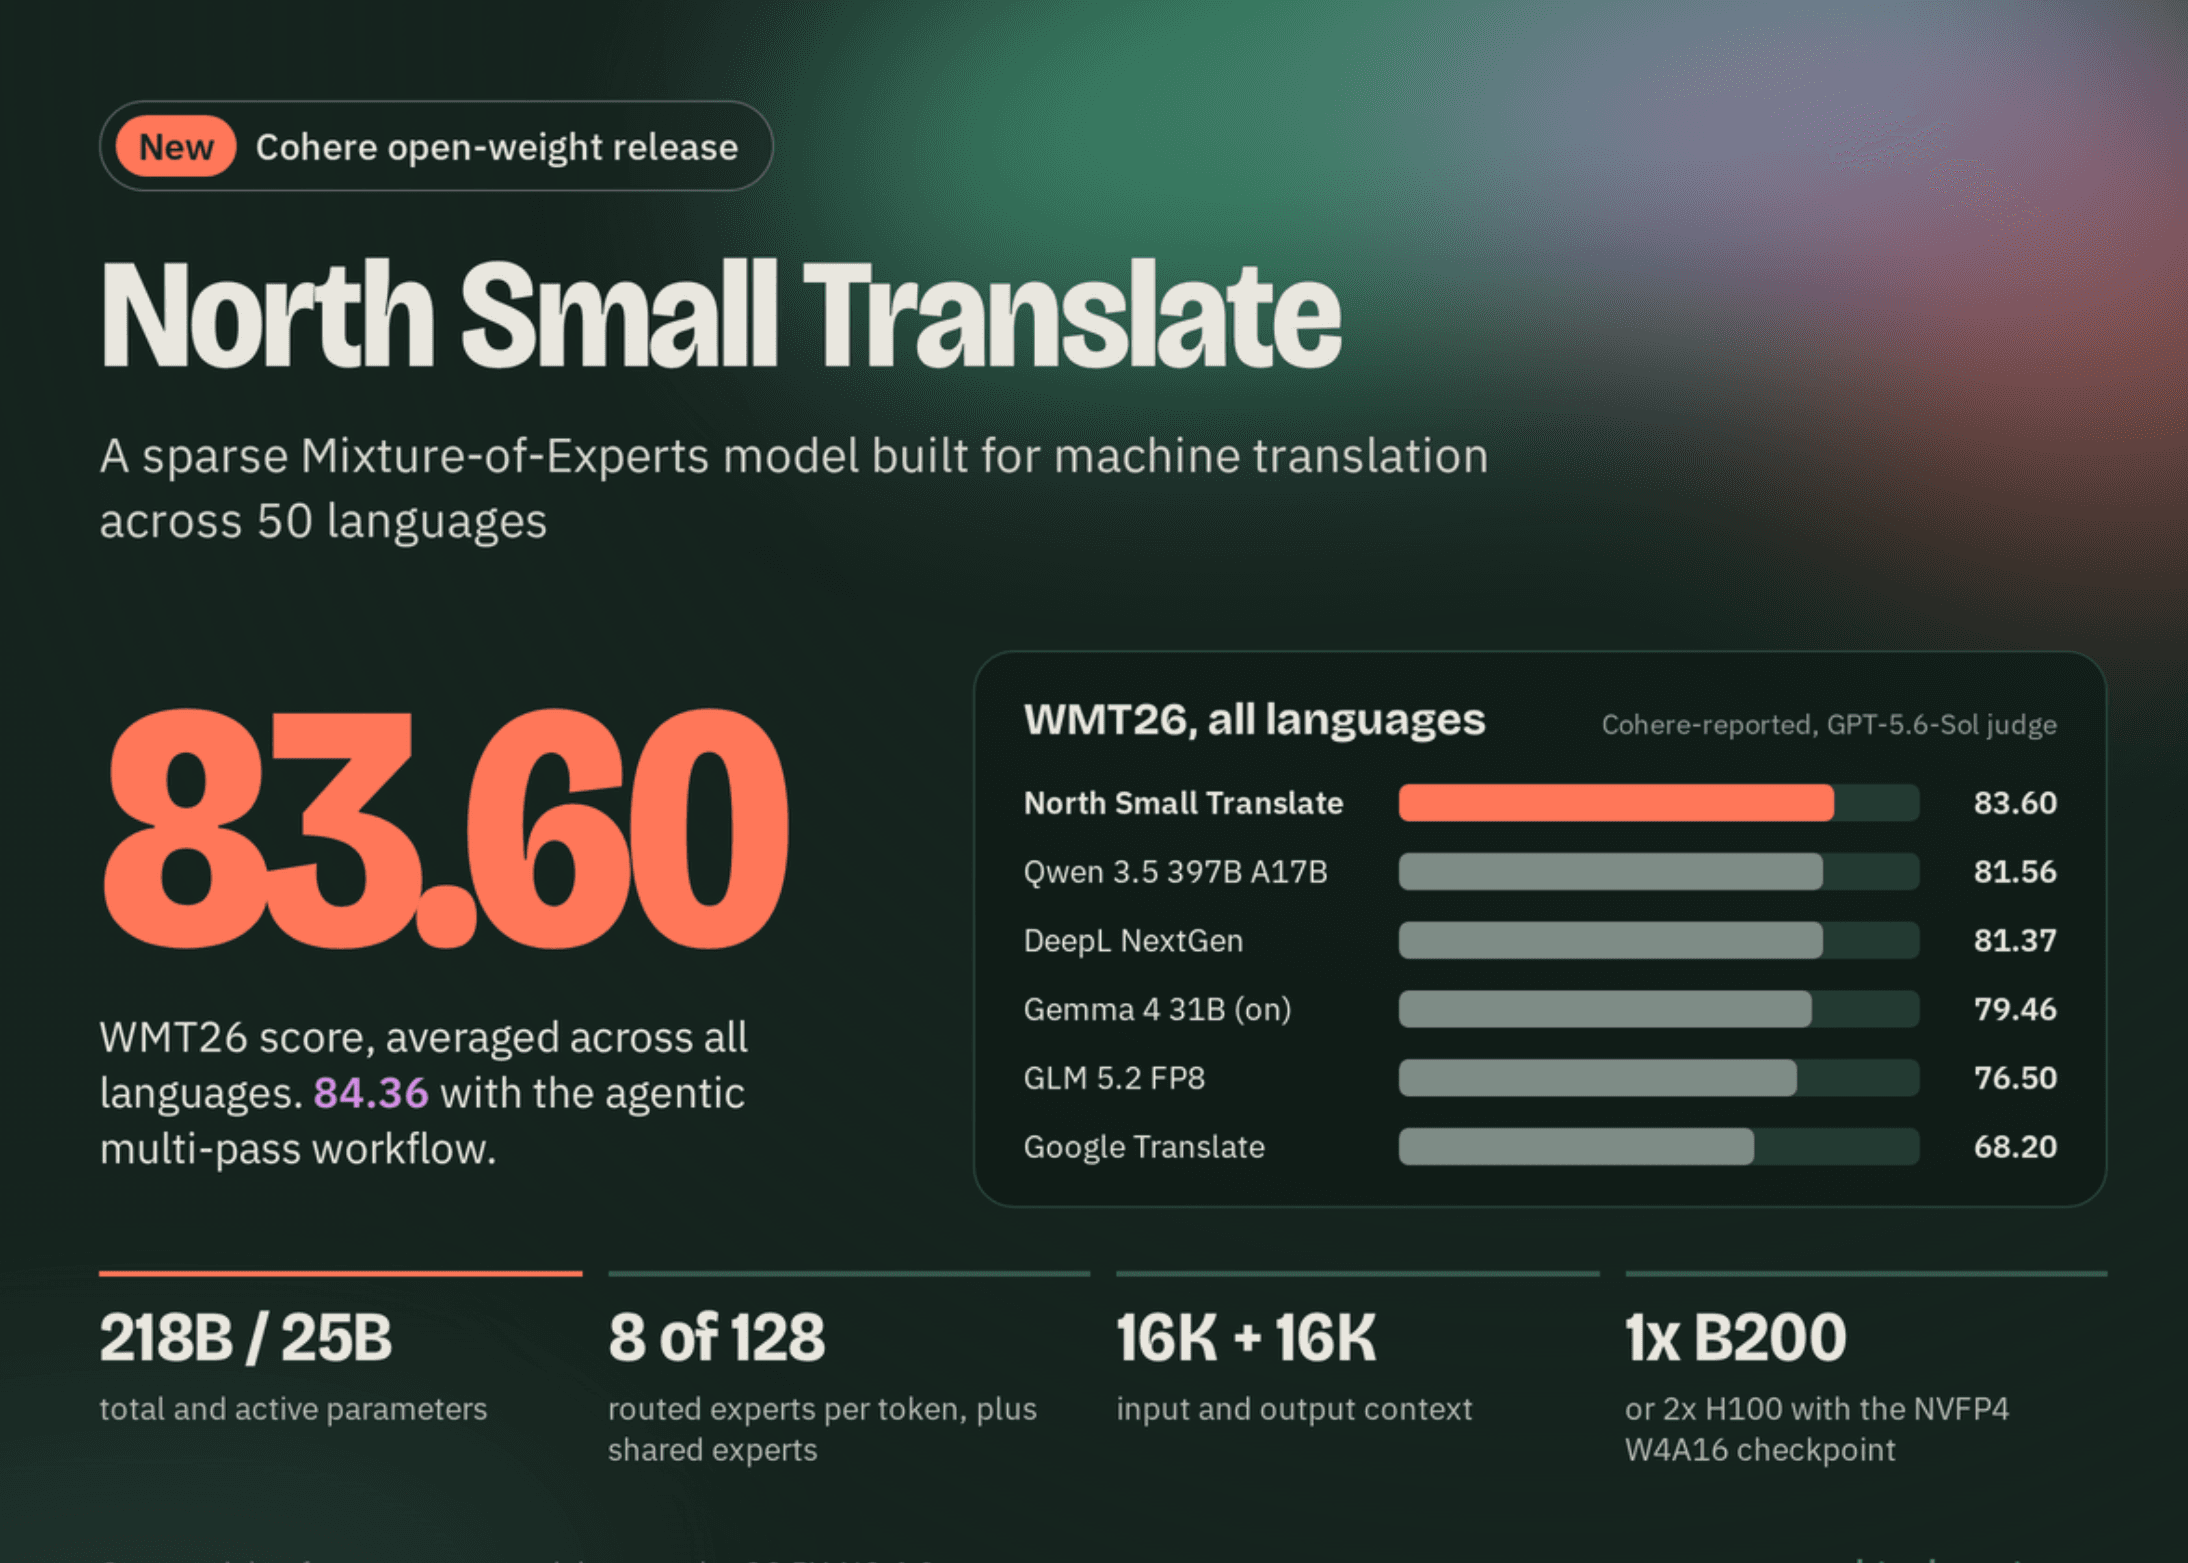
Cohere และ Cohere Labs ประกาศเปิดตัว North Small Translate โมเดลการแปลภาษาด้วยเครื่องแบบ open-weight โดยเป็นโมเดลประเภท sparse Mixture-of-Experts (MoE) ที่มีพารามิเตอร์รวม 218B และมีพารามิเตอร์เปิดทำงาน (active parameters) อยู่ที่ 25B รองรับการแปลภาษาครอบคลุมถึง 50 ภาษา ตั้งแต่ภาษาแอลเบเนียไปจนถึงภาษาเวียดนาม จากการประเมินเบนช์มาร์ก WMT26 ของ Cohere เอง โมเดลนี้ทำคะแนนเฉลี่ยได้ 83.6 คะแนนในทุกภาษา ซึ่งทาง Cohere ระบุว่าสามารถเอาชนะผู้เล่นหลักอย่าง DeepL และ Google Translate รวมถึงโมเดลแบบ open อย่าง GLM 5.2 และ Mistral Large 3 ได้สำเร็จ
สำหรับคำถามที่ว่า สามารถนำไปใช้งานจริงได้หรือไม่? คำตอบคือได้ทันที โดยผู้ใช้งานสามารถเรียกใช้ผ่าน API ของ Cohere ได้ฟรีจนกว่าจะถึงขีดจำกัดการใช้งาน (rate limits) หรือสามารถเลือกโฮสต์ด้วยตนเองเพื่อการใช้งานที่ไม่ใช่เชิงพาณิชย์ ส่วนการเข้าถึงเพื่อใช้งานเชิงพาณิชย์สามารถทำได้ผ่านการซื้อไลเซนส์จาก Cohere Model Vault หรือ RWS Language Weaver
กลับสู่จุดเริ่มต้นของ Transformer
ย้อนกลับไปในปี 2017 นักวิจัยของ Google ได้แนะนำสถาปัตยกรรม Transformer เป็นครั้งแรกผ่านบทความวิจัยชื่อดัง Attention Is All You Need ซึ่งในเวลานั้นผลลัพธ์หลักเน้นไปที่การแปลภาษาอังกฤษเป็นเยอรมันและอังกฤษเป็นฝรั่งเศสบนชุดข้อมูล WMT 2014 ผ่านไป 9 ปี Cohere กำลังพาทุกคนกลับมาสู่โจทย์ดั้งเดิมนั้นอีกครั้งด้วยโมเดลที่ออกแบบมาเพื่อการแปลภาษาโดยเฉพาะ โดยใน โพสต์เปิดตัวของ Cohere บน X ได้วางกรอบการแปลภาษาว่าเป็นเรื่องของอำนาจอธิปไตย (sovereignty) ขององค์กร เพราะหากองค์กรไม่สามารถสื่อสารในระดับโลกได้ ก็จะไม่สามารถรักษาอำนาจอธิปไตยไว้ได้เช่นกัน
North Small Translate ถือเป็นโมเดลการแปลภาษาตัวแรกในตระกูล North ของ Cohere ซึ่งเดินตามรอยโมเดลรุ่นพี่ในสายผลิตภัณฑ์พหุภาษาอย่าง Tiny Aya และ Command A Translate โดยทาง Cohere ได้ร่วมมือกับ RWS ในการพัฒนาโมเดลนี้ ซึ่งได้รับความช่วยเหลือจากนักวิทยาศาสตร์และผู้เชี่ยวชาญด้านภาษาจาก Language Weaver มาช่วยปรับแต่งคุณภาพเพื่อให้พร้อมสำหรับการใช้งานจริงในภาคธุรกิจ
สถาปัตยกรรม
ข้อมูลด้าน โครงสร้างโมเดล ระบุว่านี่คือโมเดล Transformer แบบ sparse MoE ที่มีเฉพาะ decoder-only โดยมีรายละเอียดทางเทคนิคที่สำคัญดังนี้:
- Experts: มีผู้เชี่ยวชาญทั้งหมด 128 experts โดยจะมี 8 experts ถูกเปิดใช้งานต่อหนึ่ง token ร่วมกับ shared experts ที่จะถูกใช้งานในทุก token
- Router: ใช้ฟังก์ชัน sigmoid เหนือค่า expert logits และทำ normalization บน top-k ที่ถูกเลือก
- Attention: ผสมผสานระหว่างเลเยอร์แบบ sliding-window (window 4096, RoPE) และเลเยอร์แบบ global ที่ไม่มี positional embeddings สลับกันในสัดส่วน 3:1
- สายตระกูล: รูปแบบการจัดการ attention นี้ ถูกนำมาใช้งานครั้งแรกในโมเดล Command A
- Context: รองรับอินพุตสูงสุด 16K tokens และเอาต์พุตสูงสุด 16K tokens รองรับเฉพาะข้อมูลรูปแบบข้อความเท่านั้น
- การฝึกฝน: ผ่านกระบวนการ post-trained ที่ปรับแต่งมาเพื่อยกระดับคุณภาพด้านการแปลภาษาโดยเฉพาะ
แม้ว่าโมเดลจะมีพารามิเตอร์รวมทั้งหมดถึง 218B แต่ในการประมวลผลจริงจะมีน้ำหนักโมเดลเพียง 11.5% เท่านั้นที่เปิดทำงานต่อหนึ่ง token ส่งผลให้พลังประมวลผลต่อ token เทียบเท่ากับพารามิเตอร์เปิดทำงานขนาด 25B อย่างไรก็ตาม หน่วยความจำของระบบ (VRAM) ยังคงต้องรองรับขนาดพารามิเตอร์ทั้งหมด 218B ในการโหลดโมเดล
เบนช์มาร์ก
ทีมงาน Cohere ได้เผยแพร่คะแนนทดสอบ WMT26 รวมทุกภาษาไว้ใน บล็อกเปิดตัว โดยมีรายละเอียดเปรียบเทียบดังนี้:
| โมเดล | คะแนน WMT26 |
|---|---|
| North Small Translate (Agentic) | 84.36 |
| North Small Translate | 83.60 |
| Qwen 3.5 397B A17B | 81.56 |
| DeepL NextGen | 81.37 |
| Gemma 4 31B (on) | 79.46 |
| GLM 5.2 FP8 | 76.50 |
| Google Translate | 68.20 |
สำหรับเวอร์ชัน Agentic จะทำงานในลักษณะเวิร์กโฟลว์แบบหลายรอบ (multi-pass) เพื่อตรวจสอบและแก้ไขข้อผิดพลาดในการแปลด้วยตัวเอง ทั้งนี้ เกณฑ์การให้คะแนนของ Cohere ระบุว่าระดับคะแนน 80 ถึง 100 หมายถึงผลงานแปลที่สมบูรณ์แบบหรือมีข้อผิดพลาดน้อยมาก ทว่ามีข้อควรระวังคือ เบนช์มาร์กนี้เป็นการทดสอบภายในของ Cohere เอง โดยใช้โมเดล GPT-5.6-Sol เป็นผู้ตัดสิน ดังนั้นจึงควรพิจารณาในฐานะผลลัพธ์ที่รายงานโดยผู้ผลิต จนกว่าจะมีผลการทดสอบที่เป็นอิสระจากภายนอกอย่าง WMT26 ออกมาสมบูรณ์
เมื่อแยกพิจารณาในระดับภูมิภาค โมเดลของ Cohere ทั้งสองเวอร์ชันสามารถเอาชนะ Gemma 4 31B (on) ได้ในแถบยุโรป โดยในกลุ่มภาษาสหภาพยุโรป โมเดลเวอร์ชันมาตรฐานทำได้ 82.17 คะแนน เทียบกับ Gemma ที่ทำได้ 72.73 คะแนน ส่วนในภูมิภาคเอเชียใต้พบว่าคะแนนมีความใกล้เคียงกันมาก โดย North ได้ไป 86.16 คะแนน ขณะที่ Gemma นำไปเล็กน้อยที่ 88.04 คะแนน
ความเร็ว, เอกสารยาว และต้นทุน
จากการทดสอบด้านความเร็วโดย Cohere พบว่าตัวโมเดลสามารถสร้างเอาต์พุตได้ 112 tokens ต่อวินาที เทียบกับ Gemma 4 31B ที่ทำได้ 81 tokens บนสภาพแวดล้อมฮาร์ดแวร์เดียวกันที่มีการทำงานพร้อมกันต่ำ (low concurrency) ส่วนในสถานการณ์ที่มีการทำงานพร้อมกันสูง (high concurrency) ตัวเลข throughput จะอยู่ที่ 39 ต่อ 30 tokens ซึ่ง Cohere ระบุว่าโมเดลของตนให้ throughput ที่สูงกว่าถึง 1.4 เท่า
จุดแข็งที่โดดเด่นอย่างชัดเจนคือการแปลเอกสารขนาดยาว ซึ่งโมเดลทำคะแนนได้ถึง 48.9 คะแนนจากการประเมินคุณภาพต่อย่อหน้าด้วย xCOMET-XL ในงานแปลเนื้อหาหนังสือจำนวน 2 บทภายในการเรียกใช้งานครั้งเดียว ในขณะที่ Google Translate ทำได้เพียง 21.3 คะแนน และ Gemma 4 31B ทำได้ 19.4 คะแนน
ด้านการเปรียบเทียบต้นทุนที่ Cohere แสดงผลไว้ โมเดลนี้ทำคะแนนได้ 80.1 คะแนน โดยมีค่าใช้จ่ายเฉลี่ยเพียง $0.000676 ต่อหนึ่งงาน (คิดจากค่าเฉลี่ย 661 tokens) เมื่อเทียบกับ Gemini 3.1 Pro Preview (high) ที่มีต้นทุนสูงถึง $0.038928 ต่อหนึ่งงาน หรือแพงกว่าประมาณ 58 เท่า ในขณะที่ Qwen 3.5 397B A17B มีต้นทุนอยู่ที่ $0.004525 และ Command A+ มีต้นทุนอยู่ที่ $0.005158
วิธีการใช้งาน
ช่องทางที่ง่ายและรวดเร็วที่สุดคือการใช้งานผ่าน Chat V2 API ของ Cohere ซึ่งขณะนี้เปิดให้ใช้งานได้ฟรีจนกว่าจะติดขีดจำกัดการใช้งาน:
from cohere import ClientV2
co = ClientV2(api_key="<YOUR_API_KEY>")
response = co.chat(
    model="north-small-translate-1-0",
    messages=[{"role": "user",
               "content": "Translate everything that follows into French:\n\nEnterprises need accurate translations of business-critical documents."}]
)
print(response.message.content[0].text)
สำหรับการเลือกโฮสต์โมเดลด้วยตัวเอง Cohere ได้ปล่อย checkpoint ออกมาทั้งหมด 3 รูปแบบ ซึ่งเป็นสเปกเดียวกับที่ใช้บนระบบโปรดักชันจริง ดังนี้:
| Checkpoint | Blackwell | Hopper |
|---|---|---|
| BF16 | 4x B200 | 8x H100 |
| FP8 | 2x B200 | 4x H100 |
| NVFP4 W4A16 | 1x B200 | 2x H100 |
สรุปประเด็นสำคัญ
- North Small Translate ของ Cohere เป็นโมเดลสถาปัตยกรรม MoE ขนาดรวม 218B พร้อมพารามิเตอร์เปิดทำงานจริง 25B ต่อรอบ
- ทำคะแนนเฉลี่ยรวมทุกภาษาบน WMT26 ได้ 83.6 คะแนน และขยับเพิ่มเป็น 84.36 คะแนนเมื่อเปิดใช้งานโหมด agentic
- ชุดคะแนนเบนช์มาร์กทั้งหมดเป็นผลทดสอบภายในของผู้ผลิต โดยใช้ GPT-5.6-Sol เป็นผู้ประเมินผล
- ตัวเลือก checkpoint แบบบีบอัด 4-bit ช่วยให้สามารถรันโมเดลนี้ได้บนการ์ดจอ 1x B200 หรือ 2x H100
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร