
เปิดตัว Olmo-core 3 โครงสร้างพื้นฐานฝึกฝน MoE ระดับล้านล้านพารามิเตอร์
📄 Tech Report | 💻 Code | 🧩 Interactive demo
วันนี้เรากำลังเปิดตัว Olmo-core 3 ซึ่งเป็นการอัปเกรดครั้งสำคัญสำหรับเฟรมเวิร์กการพัฒนา Large Language Models (LLMs) ของเรา โดยมาพร้อมกับระบบการฝึกฝนแบบ Open Mixture-of-Experts (MoE) ที่ได้รับการออกแบบใหม่ทั้งหมด
Olmo-core 3 ถูกออกแบบมาเพื่อขยายขีดความสามารถในการฝึกฝน MoE ไปจนถึงระดับล้านล้านพารามิเตอร์ (Trillion-parameter) ในขณะที่ยังคงประสิทธิภาพการคำนวณไว้ได้อย่างยอดเยี่ยม นี่คือหนึ่งในระบบหลักที่อยู่เบื้องหลัง Olmo เจนเนอเรชันถัดไป และเป็นส่วนหนึ่งของความมุ่งมั่นในการเปิดกว้างเครื่องมือและโครงสร้างพื้นฐานที่อยู่เบื้องหลังโมเดลใหม่แต่ละตัว
การฝึกโมเดล AI ขนาดใหญ่ต้องใช้ทรัพยากรมหาศาล ส่งผลให้ต้นทุนและพลังงานสูงขึ้นจนเกินเอื้อมสำหรับนักวิจัยทั่วไป แม้โมเดล MoE จะช่วยลดภาระได้โดยใช้วิธีเลือกพารามิเตอร์เฉพาะส่วนมาประมวลผลแทนการใช้ทั้งหมด แต่การจัดการหน่วยความจำ GPU และการสื่อสารข้ามคลัสเตอร์ยังคงเป็นอุปสรรคสำคัญ เมื่อ MoE มีขนาดใหญ่ขึ้น ต้นทุนในการประสานงานเหล่านี้มักจะกัดกร่อนความได้เปรียบด้านความเร็วไป
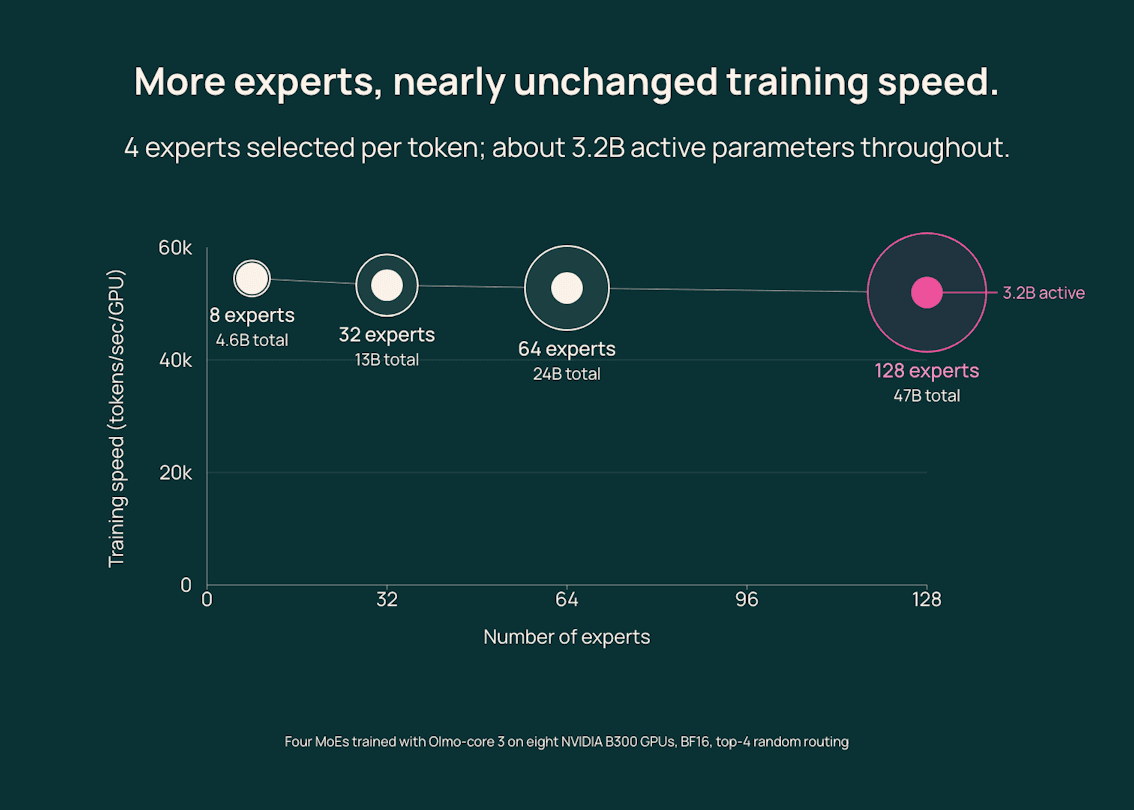
Olmo-core 3 ถูกสร้างขึ้นเพื่อปิดช่องว่างดังกล่าว จากการทดสอบพบว่าแม้จะเพิ่มจำนวนผู้เชี่ยวชาญ (Experts) จาก 8 เป็น 128 ราย แต่ยังคงรักษาความเร็วในการประมวลผล (Throughput) ให้ลดลงน้อยกว่า 5% ขณะที่ความจุพารามิเตอร์รวมเติบโตจาก 4.6 พันล้าน เป็น 4.7 หมื่นล้านพารามิเตอร์ โดยที่จำนวนพารามิเตอร์ใช้งาน (Active parameters) ต่อ token คงที่อยู่ที่ประมาณ 3.2 พันล้านพารามิเตอร์ นอกจากนี้ โครงสร้างพื้นฐานดังกล่าวยังผ่านการทดสอบประสิทธิภาพที่พารามิเตอร์รวมมากกว่าหนึ่งล้านล้านพารามิเตอร์มาแล้ว
การสร้าง Training Stack รอบรูปแบบการทำงานจริงของ MoE
Olmo-core มีวิวัฒนาการไปพร้อมกับ Olmo ในแต่ละรุ่น โดยในรุ่นก่อนหน้าอย่าง OlmoE ใช้ผู้เชี่ยวชาญ 64 ตัว ส่วน Olmo 3 ใช้สถาปัตยกรรมแบบ Dense ที่ทุกส่วนของโมเดลทำงานพร้อมกัน สำหรับ Olmo-core 3 ได้ขยายเฟรมเวิร์กด้วยระบบฝึกฝนที่ออกแบบมาเพื่อโมเดล MoE ที่มีขนาดใหญ่กว่าเดิมมาก
การเปลี่ยนแปลงที่สำคัญคือการเปลี่ยนจากระบบ Fully Sharded Data Parallelism (FSDP) เดิม มาเป็นระบบที่อิงตาม Distributed Data Parallelism (DDP) ซึ่งช่วยเก็บพารามิเตอร์ผู้เชี่ยวชาญไว้บน GPU และกำหนดเส้นทางข้อมูลไปยังจุดนั้นโดยตรง ช่วยเลี่ยงการรวบรวมน้ำหนักซ้ำๆ ที่สิ้นเปลืองเวลา
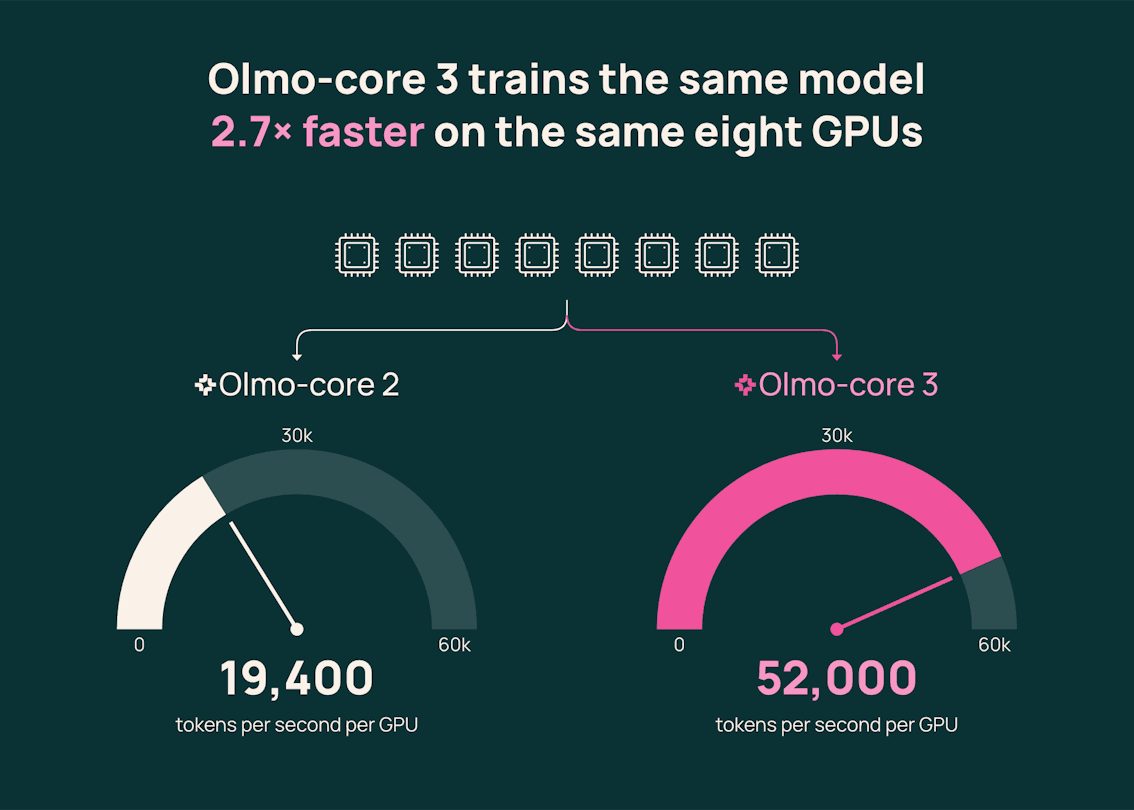
จากการทดสอบบน GPU NVIDIA B300 จำนวน 8 ตัว พบว่า Olmo-core 3 สามารถทำ Throughput ได้สูงถึง 52,000 token ต่อวินาทีต่อ GPU สำหรับโมเดล MoE ขนาด 4.7 หมื่นล้านพารามิเตอร์ ซึ่งคิดเป็นประสิทธิภาพที่สูงขึ้นกว่าระบบ FSDP เดิมถึง 2.7 เท่า ทำให้มันก้าวขึ้นมาเป็นคู่แข่งที่น่าสนใจเทียบกับ Megatron-Core ของ NVIDIA
การขยายขนาดและเพิ่มประสิทธิภาพการฝึกฝน MoE
Olmo-core 3 รวมเทคนิคการกระจาย MoE ข้ามคลัสเตอร์ GPU โดยใช้ 3 กลไกหลัก ได้แก่ Expert Parallelism (กระจายผู้เชี่ยวชาญข้าม GPU), Pipeline Parallelism (แยกเลเยอร์ของโมเดลตามกลุ่ม GPU) และ Distributed Optimizer (กระจายสถานะการคำนวณอัปเดตโมเดล) เพื่อลดภาระหน่วยความจำในแต่ละ GPU
นอกจากนี้ยังมีการเพิ่มประสิทธิภาพในระดับต่ำ เช่น Rowwise expert parallelism เพื่อลดการจัดเรียงข้อมูลใหม่, GPU-resident routing ที่ช่วยให้ CPU จัดคิวงานได้โดยไม่ต้องรอคัดลอกข้อมูล และ Grouped GEMM ที่รวมการคำนวณขนาดเล็กเข้าด้วยกันเพื่อให้ GPU ทำงานได้เต็มประสิทธิภาพมากขึ้น
เทคโนโลยีเด่นอีกอย่างคือการรองรับ MXFP8 ซึ่งเป็นรูปแบบตัวเลขความแม่นยำต่ำที่ช่วยลดปริมาณข้อมูลและการคำนวณ จากการทดสอบบน GPU NVIDIA B300 พบว่า MXFP8 ช่วยเพิ่ม Throughput ได้อีก 21% เมื่อเทียบกับรูปแบบ BF16 และช่วยลดหน่วยความจำที่ใช้งานสูงสุดลงจาก 103 GiB เหลือเพียง 95 GiB
สำรวจ interactive walkthrough ของเรา เพื่อดูว่า data, expert และ pipeline parallelism ทำงานร่วมกันอย่างไรเพื่อขยายขนาดการฝึกฝน MoE จาก GPU ตัวเดียวไปสู่หลายตัว
การขยายขนาดสู่ระดับล้านล้านพารามิเตอร์
ทีมงานได้ทดสอบประสิทธิภาพ Olmo-core 3 บน GPU NVIDIA B300 จำนวน 512 ตัว กับโมเดลขนาด 1.2 ล้านล้านพารามิเตอร์ (พารามิเตอร์ใช้งาน 5.8 หมื่นล้านตัวต่อ token) พบว่าทำ Throughput สูงสุดได้ถึง 858 TFLOP/s/GPU นอกจากนี้ยังทดลองใช้ DeepEP v2 จนสามารถรองรับความจุโมเดลได้ถึง 2.38 ล้านล้านพารามิเตอร์
อย่างไรก็ตาม รายงานฉบับนี้ยังชี้ให้เห็นถึงความท้าทายในการฝึกโมเดลขนาดใหญ่ เช่น ปัญหา Token gerrymandering ที่การรักษาสมดุลการเลือกเส้นทางข้อมูลอาจส่งผลเสียต่อภาระงานจริง หรือข้อค้นพบว่าการใช้ GPU stream แยกกันเพื่อทับซ้อนการสื่อสารกับการคำนวณ (Overlapping) ไม่ได้ช่วยให้การฝึกฝนเร็วขึ้นเสมอไป ซึ่งเป็นบทเรียนสำคัญสำหรับนักวิจัย
สร้างขึ้นเพื่อ Olmo เจนเนอเรชันถัดไป เปิดกว้างสำหรับทุกคน
Olmo-core 3 คือรากฐานสำคัญของ Olmo เจนเนอเรชันถัดไปที่จะใช้สถาปัตยกรรม MoE ซึ่งตั้งเป้าให้เป็นโมเดลที่มีความสามารถสูงสุด ฝึกด้วยชุดข้อมูลที่ใหญ่ที่สุด และรองรับ Context Window ที่ยาวที่สุดเท่าที่เคยมีมา
หัวใจสำคัญคือการเป็นโครงการเปิด (Open Source) ที่นักพัฒนาทั่วโลกสามารถนำ Olmo-core 3 ไปใช้ฝึกโมเดลของตนเอง ปรับให้เข้ากับฮาร์ดแวร์ที่หลากหลาย และทดลองเทคนิคใหม่ๆ ได้อย่างอิสระ เพราะน้ำหนักของโมเดลจะมีประโยชน์ที่สุด เมื่อโครงสร้างพื้นฐานและกระบวนการตัดสินใจเบื้องหลังถูกเปิดเผยอย่างโปร่งใส
สำหรับผู้ที่สนใจรายละเอียดเชิงลึก สามารถศึกษาได้จากรายงานทางเทคนิคหรือ สำรวจ Olmo-core 3 บน GitHub
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร