
MiniMax เปิดตัว M3.1 Flash โมเดล Agentic MoE ราคาประหยัด
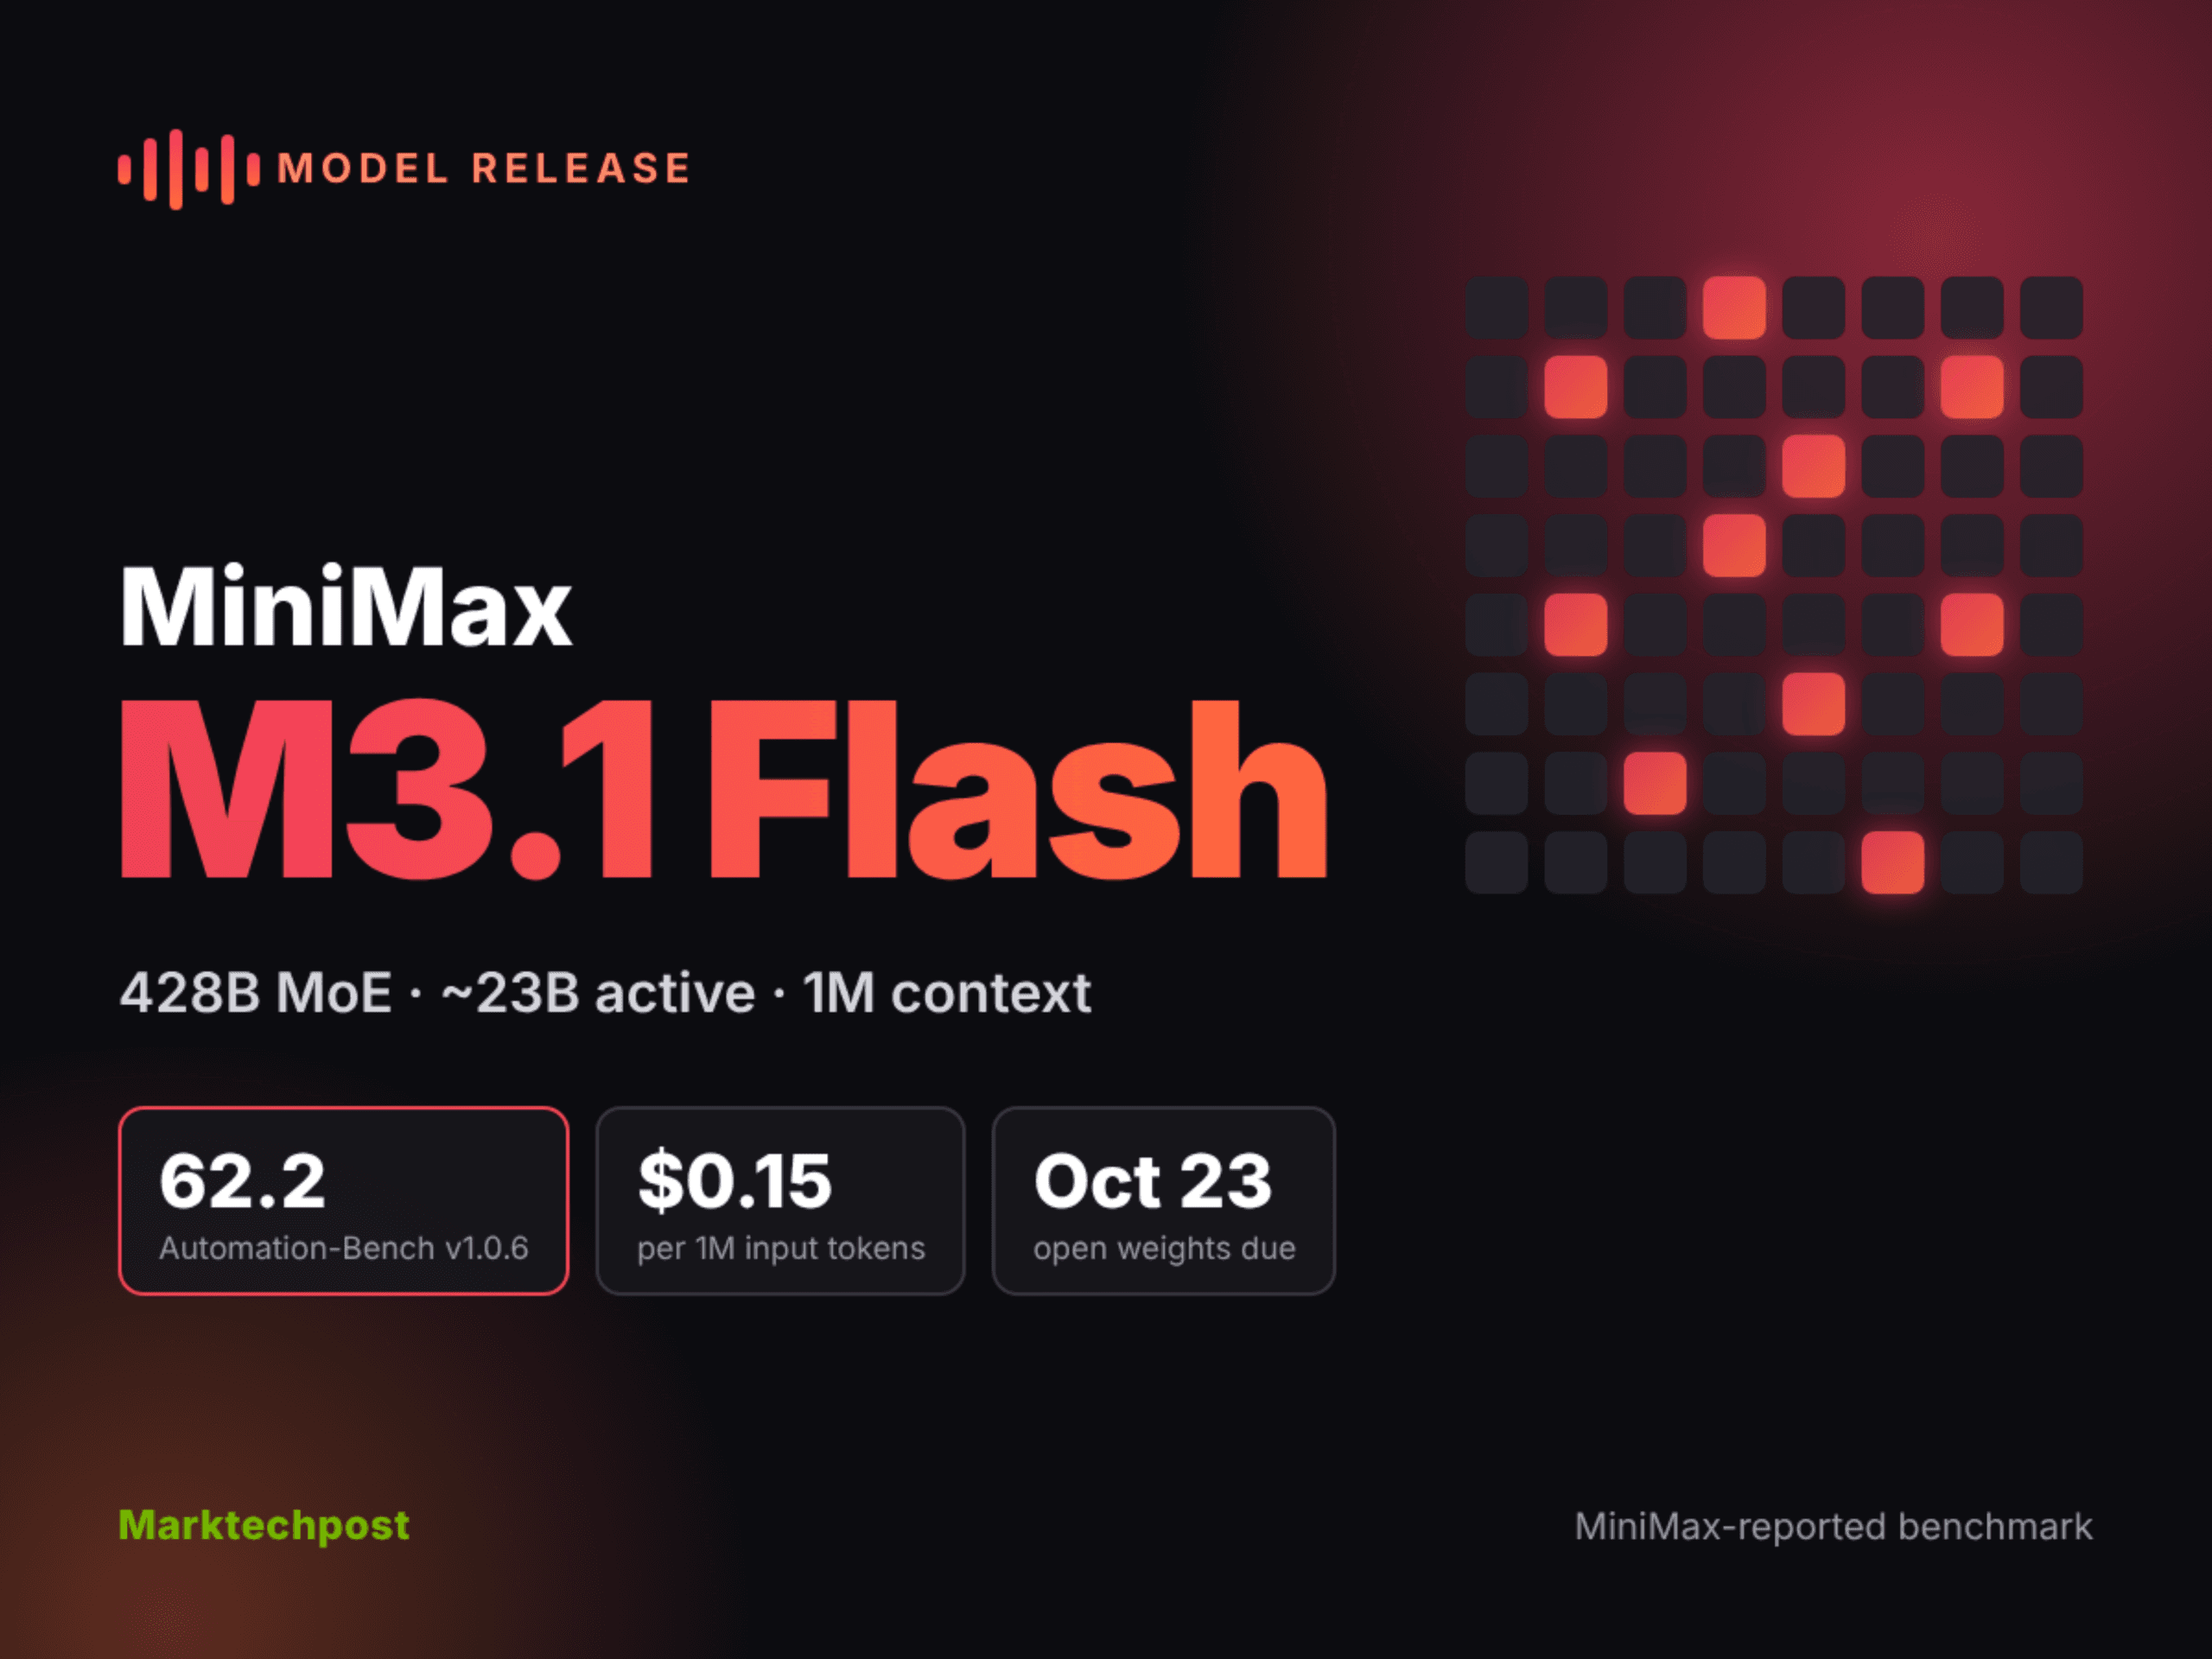
MiniMax เปิดตัว MiniMax M3.1 Flash อย่างเป็นทางการบนบริการ API ของบริษัท โดยกำหนดราคาไว้ที่ $0.15 ต่อ 1M input tokens ซึ่ง MiniMax ยืนยันว่าโมเดลลับอย่าง Space Bunny คือเวอร์ชันการพัฒนาช่วงแรกของรุ่นนี้ โดยผ่านการประมวลผลข้อมูลมามากกว่า 200T tokens เพื่อมอบประสิทธิภาพระดับ Frontier ในราคาแบบ Flash-tier สำหรับนักพัฒนา ทั้งนี้น้ำหนักโมเดล (weights) มีกำหนดจะปล่อยในช่วงปลายเดือนตุลาคม 2026
TL;DR
- ขนาด: พารามิเตอร์รวม 428B โดยมีส่วนที่ทำงานจริง (active) ประมาณ 23B (MoE) พร้อม context window ขนาด 1,000,000-token
- ช่องทางใช้งาน: ปัจจุบันรองรับบน MiniMax API, M Plan และ MiniMax Code โดย weights จะปล่อยในวันที่ 23 ต.ค. (ยังไม่เปิดเผยสเปกฮาร์ดแวร์สำหรับ self-hosting)
- ประสิทธิภาพ: MiniMax ระบุว่าให้ผลลัพธ์ใกล้เคียงระดับ frontier ในงานออฟฟิศแบบ agentic แต่อยู่ในระดับกลางสำหรับงานเขียนโค้ดที่ซับซ้อน
- จุดแข็ง: ทำคะแนนสูงสุดใน Automation-Bench v1.0.6 ที่ 62.2 จากตารางทดสอบของ MiniMax
- จุดอ่อน: ทำคะแนน Terminal Bench 4.0 ได้เพียง 38.1 เทียบกับ Opus 5 ที่ทำได้ 51.8
MiniMax M3.1 Flash คืออะไร?
MiniMax M3.1 Flash คือโมเดล multimodal mixture-of-experts ที่ออกแบบมาเพื่อเน้นการเขียนโค้ด งานออฟฟิศเชิง agentic และการให้เหตุผลทางภาพ (visual reasoning) ข้อมูลจาก หน้าผลิตภัณฑ์ ระบุว่าโมเดลมีพารามิเตอร์รวม 428B และทำงานจริง 23B โดยใช้เทคโนโลยี sparse attention และมี native visual encoder ในตัว
โมเดลรองรับข้อมูลเข้า (input) ทั้งข้อความ รูปภาพ และวิดีโอ โดยส่งผลลัพธ์กลับเป็นข้อความผ่าน context window ขนาด 1,000,000 tokens ซึ่งจำนวนพารามิเตอร์นี้ใกล้เคียงกับ MiniMax M3 รุ่นมาตรฐาน แต่ทางบริษัทยังไม่มีรายงานทางเทคนิคสรุปการเปลี่ยนแปลงในเวอร์ชัน Flash นี้
ระบบการให้เหตุผลใน M3.1 Flash
ระบบการให้เหตุผล (Reasoning) ของโมเดลรุ่นนี้จะเปิดใช้งานตลอดเวลาและไม่สามารถปิดได้ โดยนักพัฒนาสามารถเลือกความพยายามในการประมวลผล (effort levels) ได้ 5 ระดับ ได้แก่ Low, Medium, High, Xhigh และ Max ซึ่งทาง MiniMax แนะนำให้ใช้ระดับ Max เป็นค่าเริ่มต้น
สำหรับการย้ายระบบ (Migration) นักพัฒนาต้องระวังว่าการส่งคำขอผ่าน thinking.type=disabled หรือ effort=none จะทำให้เกิดข้อผิดพลาด นอกจากนี้การให้เหตุผลจะถูกแยกไว้ในฟิลด์ reasoning_content ดังนั้นระบบเดิมที่เคยใช้วิธี parse แท็ก <think> แบบ inline จากรุ่น M3 จำเป็นต้องได้รับการอัปเดตใหม่
ผลการทดสอบประสิทธิภาพ (Benchmarks)
หมายเหตุ: ตัวเลขทั้งหมดเป็นการรายงานโดย MiniMax และยังไม่ได้รับการตรวจสอบจากหน่วยงานอิสระ
ในชุดทดสอบ CoWork โมเดล M3.1 Flash ทำคะแนนนำใน Automation-Bench v1.0.6 ที่ 62.2 แซงหน้า Opus 5 (50.3) และ GPT-5.6 Sol (45.8) ขณะที่ BankerToolBench ทำได้ 76.2 เท่ากับ Opus 5 และยังทำคะแนนสูงสุดใน LOCA-Bench 256K ที่ 60.3
ส่วนงานด้านการเขียนโค้ดพบผลลัพธ์ที่ก้ำกึ่ง โดย DeepSWE v1.1 ทำได้ 73.7 สูงกว่า GPT-5.6 Sol เล็กน้อย แต่ยังแพ้ DeepSeek-V4.1-Flash-1017 ที่ได้ 77.0 ในขณะที่ Terminal Bench 4.0 เป็นจุดที่อ่อนที่สุดเพียง 38.1 และ SWE Refactor Bench อยู่ที่ 23.0 ซึ่งต่ำกว่า Opus 5 ที่ทำไว้ 31.0
ด้านการมองเห็น (vision) โมเดลทำคะแนน BabyVision พร้อมเครื่องมือได้สูงถึง 91.0 และ CharXiv RQ ที่ 82.5 อย่างไรก็ตาม มีข้อสังเกตเรื่องความสอดคล้องของข้อมูลเล็กน้อย เนื่องจากแผนภูมิราคาของ MiniMax ระบุคะแนน Automation-Bench ไว้ที่ 62.8 แต่ในตารางข้อมูลกลับระบุเป็น 62.2
ค่าใช้จ่ายและราคา
MiniMax นำเสนอความคุ้มค่าโดยเน้นที่ต้นทุนต่องานมากกว่าต่อ token โดยในแผนภูมิ Automation-Bench ทุกระดับความพยายามมีค่าใช้จ่ายต่ำกว่า $0.05 ต่องาน ส่วนการรัน Agents’ Last Exam ครบ 152 งาน จะมีค่าใช้จ่ายประมาณ $111
สำหรับการใช้งานผ่าน API ราคาถูกกำหนดไว้คงที่คือ input $0.15 และ output $0.60 ต่อ 1M tokens ส่วนการอ่านแคช (Cache reads) อยู่ที่ $0.015 โดยเวอร์ชัน Flash นี้มีราคาเพียงครึ่งหนึ่งของรุ่น M3 มาตรฐาน และไม่มีค่าธรรมเนียมเพิ่มเติมสำหรับ context ที่มีความยาวมาก
วิธีการเข้าถึงและประสิทธิภาพความเร็ว
ผู้ใช้สามารถเข้าถึงโมเดล MiniMax-M3.1-Flash ได้แล้วผ่าน platform.minimax.io โดยรองรับการเชื่อมต่อที่เข้ากันได้กับ Anthropic และ OpenAI รวมถึงใช้งานผ่าน M Plan และแอปเดสก์ท็อป MiniMax Code
ในด้านความเร็ว หน้าผลิตภัณฑ์ระบุว่าทำได้ประมาณ 150 tokens ต่อวินาที ซึ่งเร็วกว่า M3 เดิมถึง 3 เท่า สำหรับไฟล์ weights ที่จะปล่อยวันที่ 23 ตุลาคมนี้ คาดว่าจะมีขนาดใกล้เคียงกับ M3 เวอร์ชัน MXFP8 ที่ประมาณ 440 GB
การเปรียบเทียบกับคู่แข่งรายสำคัญ
| คุณสมบัติ | MiniMax M3.1 Flash | DeepSeek V4.1 Flash | Kimi K3 | GLM-5.3 |
|---|---|---|---|---|
| พารามิเตอร์รวม / ทำงานจริง | 428B / ~23B | 552B / 8-16B | 2.8T / 104B | ~744B / ~40B |
| Context | 1M | 1M | 1,048,576 | 1,048,576 |
| Inputs | ข้อความ, รูปภาพ, วิดีโอ | ข้อความ, รูปภาพ | ข้อความ, รูปภาพ | ข้อความ |
| Weights / ใบอนุญาต | 23 ต.ค. (ยังไม่ระบุ) | Open, MIT | Open, Kimi License | Open weights |
| ราคา API in / out (1M) | $0.15 / $0.60 | $0.30 / $1.20 | $3.00 / $15.00 | $1.40 / $4.40 |
| Automation-Bench* | 62.2 | 54.8 | 46.7 | 48.8 |
| Terminal Bench 4.0* | 38.1 | 31.2 | 12.6 | 37.9 |
ข้อจำกัดที่ควรทราบ เนื่องจากผลการทดสอบเป็นการรายงานจากผู้พัฒนาเอง การเลือกใช้ชุดทดสอบที่ต่างกันอาจให้ผลลัพธ์ที่คลาดเคลื่อน ตัวอย่างเช่น Automation-Bench ของ Kimi K3 รายงานที่ 30.8 ในชุดทดสอบสาธารณะ แต่ MiniMax ระบุไว้ที่ 46.7
นอกจากนี้ Opus 5 ยังมีคะแนนนำโด่งในด้าน Terminal Bench 4.0 และ NL2Repo-Bench อีกทั้งการที่โมเดลบังคับเปิดระบบการให้เหตุผลตลอดเวลา อาจส่งผลต่อความหน่วง (latency) ในการใช้งานคำสั่งง่ายๆ ซึ่งรายละเอียดการนำไปรันบนเครื่องตัวเอง (self-hosting) จะชัดเจนขึ้นเมื่อมีการปล่อย weights ในช่วงปลายเดือนตุลาคมนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร