
Reflection AI เปิดตัว Beam โมเดล MoE 501B ประสิทธิภาพสูงเพื่อสาย Coding
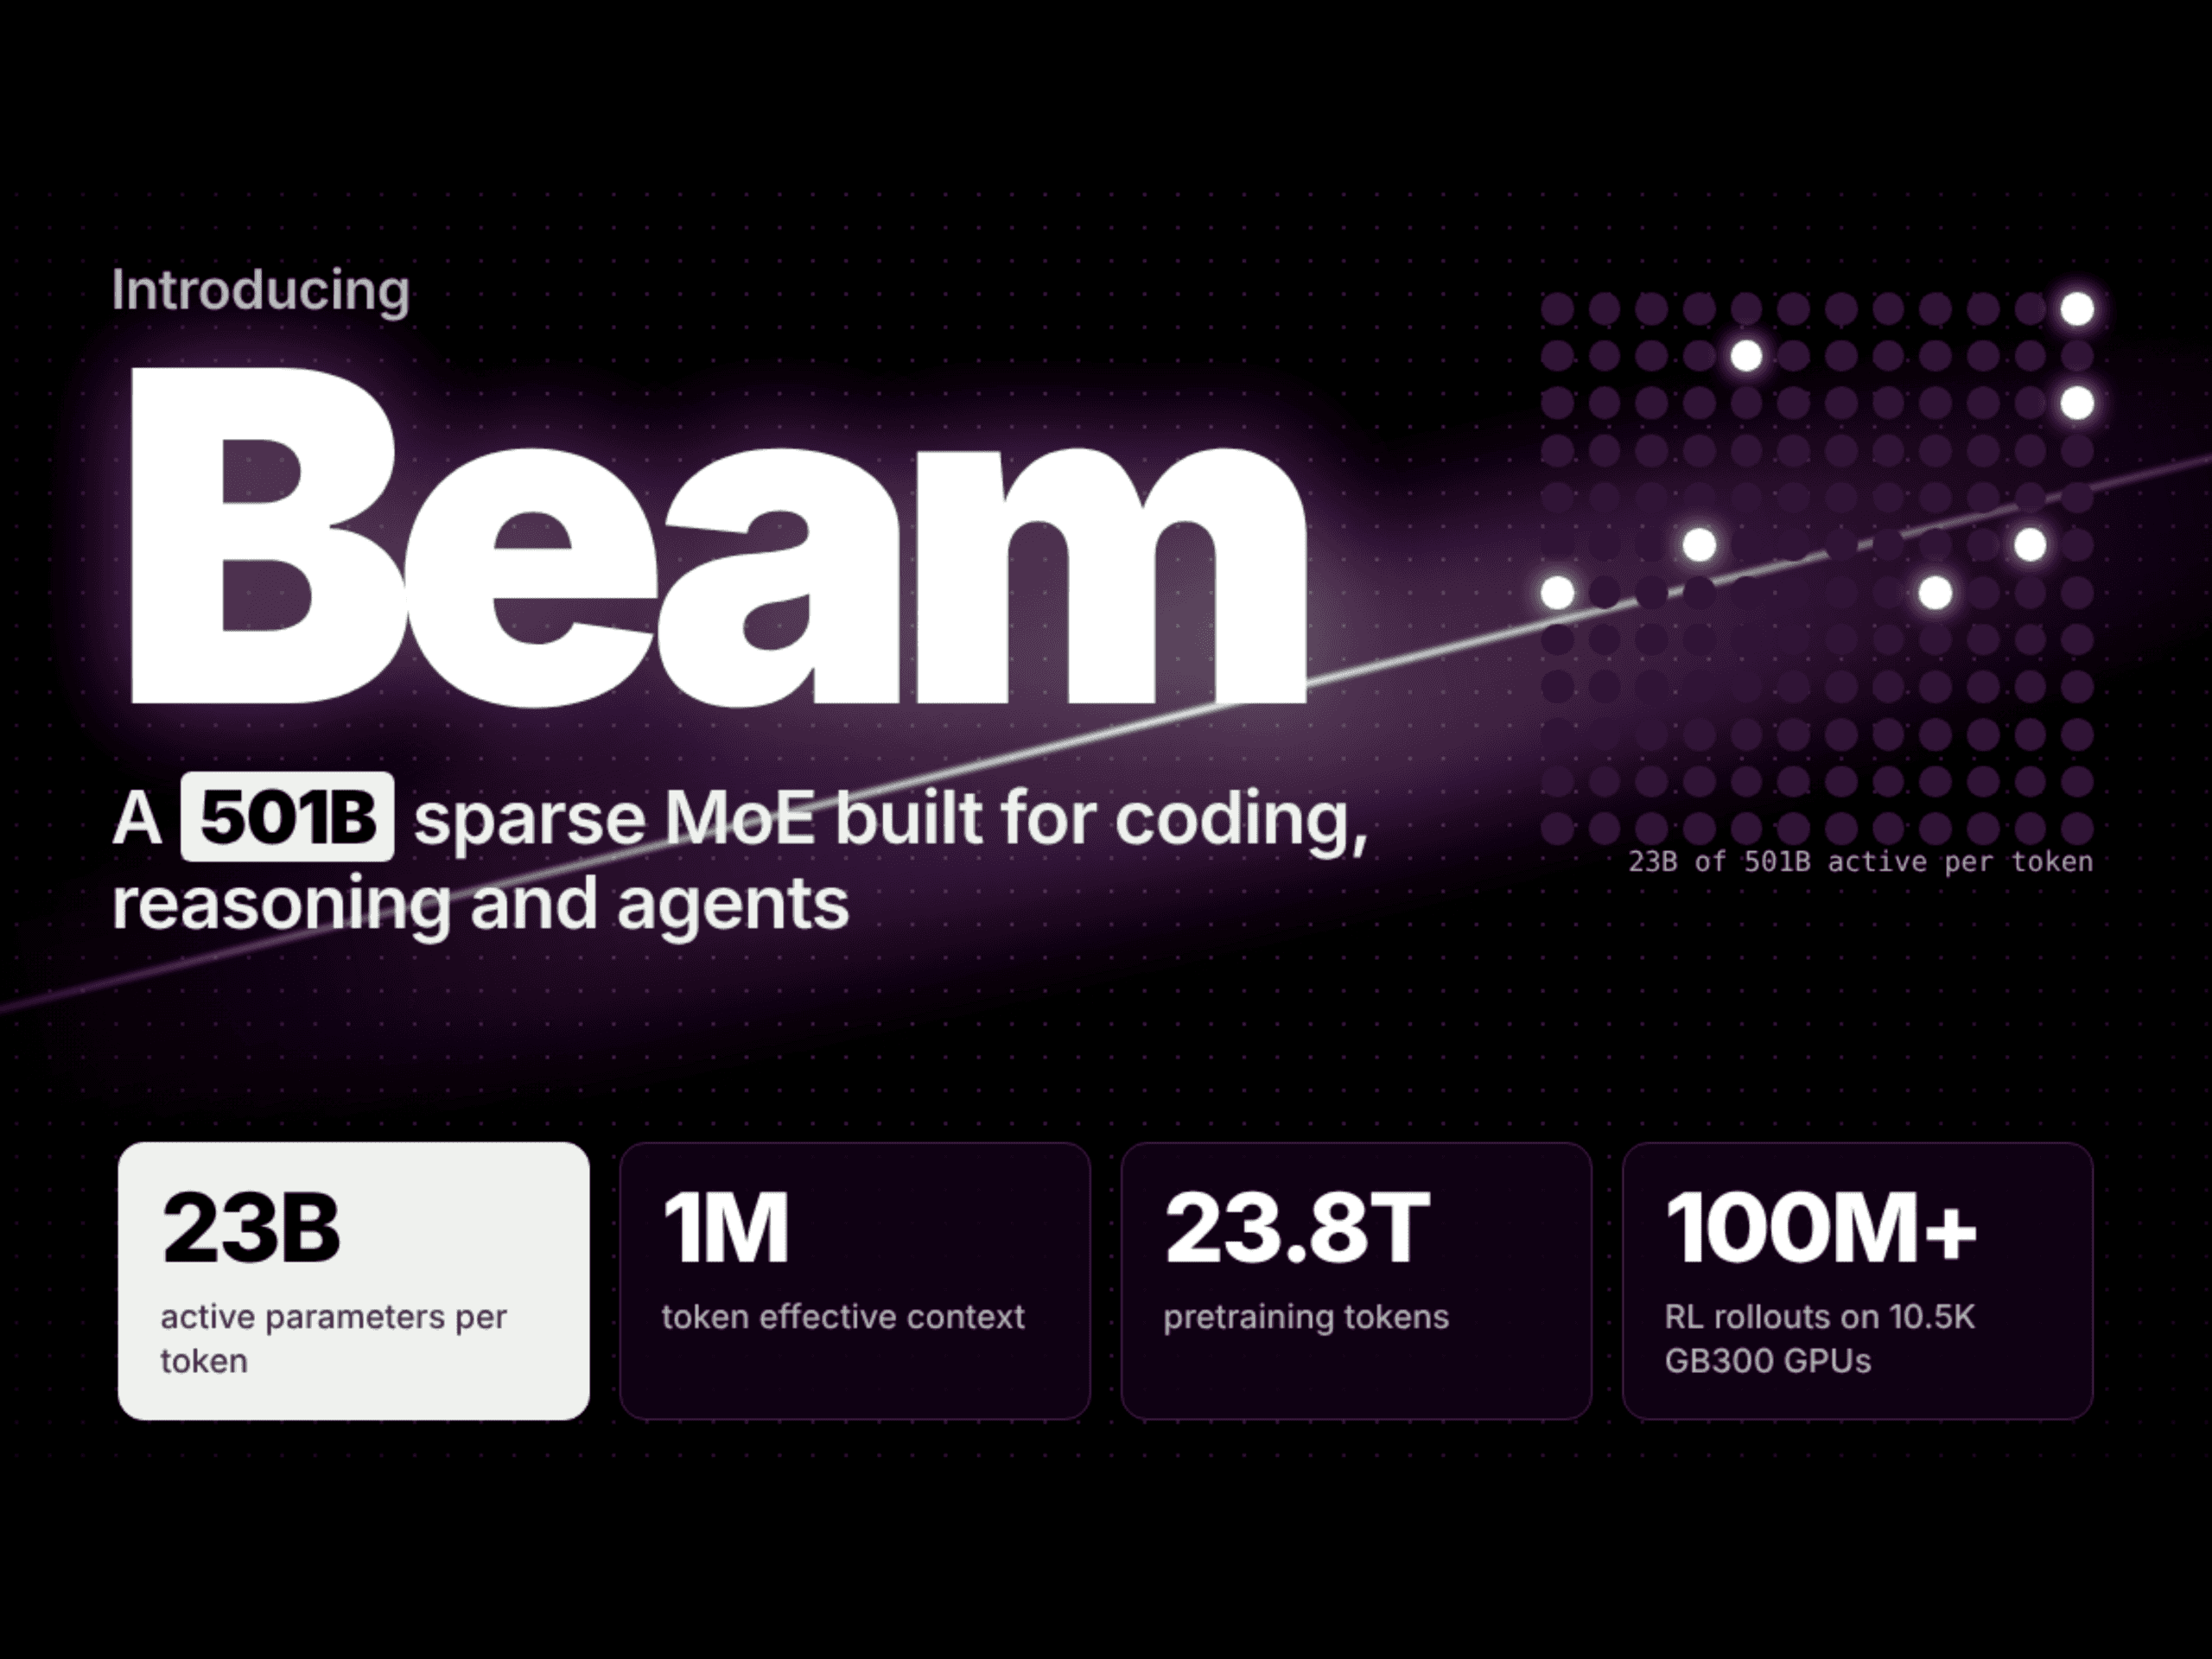
Reflection AI เปิดตัว Beam โมเดล Open-Weight ตัวแรกของบริษัทในรูปแบบ sparse Mixture-of-Experts (MoE) ซึ่งมาพร้อมพารามิเตอร์รวม 501B และพารามิเตอร์ Active 23B ต่อ Token โดยเน้นการใช้งานด้าน Coding, Reasoning และภารกิจแบบ Agentic เป็นหลัก ข้อมูลจากทีมพัฒนาระบุว่า Beam มีประสิทธิภาพเทียบชั้นกับโมเดลขนาดใหญ่กว่าอย่าง GLM 5.2 แต่ใช้ทรัพยากรคำนวณในขั้นตอน Inference น้อยกว่าถึง 3-4 เท่า
ปัจจุบัน Beam อยู่ในขั้นตอนสุดท้ายของการทำ Red-teaming เพื่อความปลอดภัย แม้จะยังไม่เปิดให้ทำ Self-hosting ในทันที แต่ผู้ที่สนใจสามารถลงทะเบียนเพื่อเข้าใช้งานล่วงหน้าได้ผ่านทาง waitlist บนแพลตฟอร์ม Reflection
Reflection Beam คืออะไร?
Beam เป็นโมเดล Agent ทั่วไปที่ถูกฝึกฝนขึ้นใหม่ตั้งแต่ต้น (Trained from scratch) โดยมุ่งเป้าไปที่งาน Coding ระดับองค์กรและกระบวนการทำงานแบบ Agentic ซึ่ง Reflection AI ตั้งเป้าให้เป็นโมเดลที่ผลักดันขีดจำกัดของฝั่งตะวันตก แม้ทีมวิจัยจะยอมรับว่า Kimi K3 ยังคงนำหน้าในด้านความสามารถดิบ แต่จุดขายสำคัญของ Beam คือประสิทธิภาพและความรวดเร็วในช่วงการประมวลผล
ผู้ใช้งานสามารถปรับค่า พารามิเตอร์ระดับความพยายามในการให้เหตุผล (Reasoning effort parameter) ได้ตามต้องการ โดยการตั้งค่าระดับต่ำจะให้คำตอบที่กระชับ ส่วนระดับสูงจะช่วยให้โมเดลใช้เวลาวิเคราะห์ปัญหาที่ยากได้ลึกซึ้งยิ่งขึ้น ช่วยให้ผู้ใช้จัดการงบประมาณการคำนวณให้สอดคล้องกับความซับซ้อนของงานได้
กระบวนการ Pretrained ของ Beam
Beam ผ่านการฝึกฝนด้วยชุดข้อมูลขนาด 23.8 ล้านล้าน Token จากแหล่งข้อมูลสาธารณะและชุดข้อมูลที่ได้รับอนุญาต ซึ่งมีการคัดกรองอย่างเข้มข้นจนตัด Token คุณภาพต่ำออกไปถึง 95% พร้อมทั้งรักษา Token คุณภาพสูงจำนวน 1.8 ล้านล้านชุดที่ตัวกรองทั่วไปมักจะมองข้ามไว้ได้
สถาปัตยกรรมของโมเดลใช้การสลับการทำงานระหว่าง Local และ Global attention ร่วมกับเทคนิค Fine-grained routed experts และระบบ Load balancing ที่ต่อยอดมาจาก auxiliary-loss-free balancing จาก DeepSeek-V3 เพื่อให้การกระจายงานไปยัง Expert ต่างๆ เป็นไปอย่างสมดุลที่สุดตลอด 52 เลเยอร์
การฝึกฝนขั้นต้นเสร็จสิ้นภายในเวลาไม่ถึง 4 สัปดาห์ โดยใช้ GPU NVIDIA GB300 NVL72 จำนวน 6,144 ตัว ซึ่งมีค่า Goodput สูงถึง 92.3% ในช่วงท้ายของการทำงาน นอกจากนี้ยังมีการทำ Midtraining เพื่อขยายขีดความสามารถของ Context Window ให้ใช้งานได้อย่างมีประสิทธิภาพสูงสุดถึง 1M Token
การเรียนรู้แบบเสริมกำลังด้วยการคำนวณสูง (High-Compute Reinforcement Learning)
การเรียนรู้แบบเสริมกำลัง (RL) คือหัวใจหลักในการขยายขีดความสามารถของ Beam โดยใช้ GPU NVIDIA GB300 จำนวน 10.5K ตัว นาน 4 สัปดาห์ เพื่อสร้าง Rollouts มากกว่า 100 ล้านครั้ง และทดสอบในสภาพแวดล้อมจำลอง (Sandboxes) กว่า 1.3 พันล้านครั้ง ครอบคลุมทั้งงานด้าน Coding, Agentic และความรู้สาย STEM
Reflection ใช้เทคนิค Fully asynchronous policy gradients ในการฝึกฝน ซึ่งช่วยให้การเรียนรู้มีความเสถียรแม้จะมีความล้าหลังของข้อมูลน้ำหนักโมเดล (Policy) ที่แตกต่างกันถึง 107 เวอร์ชัน โดยทีมงานพบว่าประสิทธิภาพยังคงเพิ่มขึ้นเรื่อยๆ ตามปริมาณการคำนวณที่ใส่เข้าไปโดยไม่มีจุดอิ่มตัว
ระบบโครงสร้างพื้นฐานยังรองรับการส่งน้ำหนักโมเดลใหม่ไปยังฝั่ง Inference ด้วยเวลาเฉลี่ยเพียง 12 วินาที และสามารถจัดการเหตุการณ์ขัดข้องระหว่างการทำงานได้โดยไม่จำเป็นต้องหยุดกระบวนการฝึกฝน นอกจากนี้ยังพบว่า Beam พัฒนาทักษะด้านการท่องเว็บ (Browsing skills) ขึ้นมาได้เองแม้จะไม่ได้ระบุไว้ในบทเรียน RL โดยตรง
ความปลอดภัยและการปรับจูน (Safety and Alignment)
ในด้านความปลอดภัย Reflection ได้ฝึกฝนโมเดลตัวสอน (Teacher) แยกต่างหากเพื่อนำมาประยุกต์ใช้กับกระบวนการ RL ผ่านเทคนิค Multi-teacher on-policy distillation และใช้แนวทาง deliberative alignment เพื่อให้มั่นใจว่าโมเดลจะทำงานภายใต้กรอบความปลอดภัยที่เหมาะสม
เกณฑ์มาตรฐาน (รายงานโดย Reflection)
จากการทดสอบ SWE-bench Verified พบว่า Beam ทำคะแนนได้ 80.9 สูงกว่า Nemotron 3 Ultra ที่ได้ 70.7 ส่วนใน Terminal Bench v2.1 ทำได้ 80.1 ซึ่งใกล้เคียงกับ GLM 5.2 ที่ได้ 81.0 โดยมีผู้นำในกลุ่มคือ DeepSeek V4.1 Flash และ Kimi K3
Beam เปรียบเทียบกับคู่แข่ง Open-Weight ที่ใกล้เคียงที่สุด
| คุณสมบัติ | Reflection Beam | GLM-5.2 | Nemotron 3 Ultra | DeepSeek V4.1 Flash | Kimi K3 |
|---|---|---|---|---|---|
| ผู้พัฒนา | Reflection AI (US) | Z.ai (China) | NVIDIA (US) | DeepSeek (China) | Moonshot AI (China) |
| พารามิเตอร์ทั้งหมด | 501B | ~753B | 550B | 552B backbone + 196B Engram | 2.8T |
| พารามิเตอร์ Active | 23B | ~40B | 55B | 8B prefill / 16B decode | 104B |
| Context | 1M (มีประสิทธิภาพ) | 1M | สูงสุด 1M | 1M | 1M |
| อินพุต | ข้อความ | ข้อความ | ข้อความ | ข้อความ + รูปภาพ | ข้อความ + รูปภาพ |
| สัญญาอนุญาต | Apache 2.0 (แผนงาน) | MIT | OpenMDW-1.1 | MIT | Kimi K3 License |
| Weights | ปลายเดือน ต.ค. 2026 | พร้อมใช้งาน | พร้อมใช้งาน | พร้อมใช้งาน | พร้อมใช้งาน |
| Terminal Bench v2.1* | 80.1 | 81.0 | 56.4 | 90.6 | 88.3 |
| แหล่งที่มา | Reflection | Hugging Face | NVIDIA | Hugging Face | Hugging Face |
*คะแนนตามที่ประกาศในการเปิดตัว Beam ของ Reflection ข้อมูลจำเพาะตรวจสอบเมื่อวันที่ 5 ตุลาคม 2026
Beam ถือเป็นโมเดลที่มีขนาดพารามิเตอร์ Active เพียง 23B ซึ่งน้อยกว่าคู่แข่งส่วนใหญ่ในกลุ่มเดียวกัน แต่ยังคงให้ประสิทธิภาพที่น่าประทับใจ โดยมีแผนจะปล่อย Weight ภายใต้สัญญาอนุญาต Apache 2.0 ซึ่งเป็นมาตรฐานเปิดที่ให้อิสระแก่ผู้ใช้งานสูง
สรุปประเด็นสำคัญ
- Beam เป็นโมเดล MoE 501B (Active 23B) รองรับข้อความและ Context 1M
- ใช้ GPU NVIDIA GB300 จำนวนมากในการฝึกฝนทั้งช่วง Pretraining และ RL
- ทำคะแนนได้ดีเยี่ยมในเกณฑ์วัดด้านงานวิศวกรรมซอฟต์แวร์ (SWE-bench)
- เตรียมเปิดให้ดาวน์โหลด Weight แบบ Apache 2.0 ภายในสิ้นเดือนตุลาคมนี้
ผู้สนใจสามารถศึกษา รายละเอียดทางเทคนิค หรือสมัคร เข้าใช้งานล่วงหน้า ได้ทันที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร