
AMD เปิดตัว Instella-MoE-16B-A3B โมเดล LLM แบบเปิดกว้างเต็มรูปแบบ ฝึกฝนบนชิป Instinct GPU
AMD เปิดตัว Instella-MoE-16B-A3B โมเดลภาษาขนาดใหญ่ (LLM) แบบ Mixture-of-Experts ที่มีความโปร่งใสสูง โดยเป็นการฝึกฝนใหม่ตั้งแต่ต้นบน GPU รุ่นเรือธงอย่าง Instinct MI300X และ MI325X โมเดลนี้ถูกออกแบบมาให้มีพารามิเตอร์รวม 16B แต่เรียกใช้งานจริงเพียง 2.8B ต่อโทเค็น ช่วยเพิ่มประสิทธิภาพการประมวลผลให้รวดเร็วยิ่งขึ้น
การเปิดตัวครั้งนี้ AMD ได้เผยแพร่น้ำหนักโมเดล (weights) จากทุกขั้นตอนการฝึกฝน พร้อมด้วยชุดข้อมูลผสม (data mixtures) การตั้งค่าการฝึก และโค้ดสำหรับนำไปใช้งาน (inference) นอกจากนี้ยังมาพร้อมนวัตกรรมสำคัญอย่าง Gated Multi-head Latent Attention (Gated MLA) และระบบเชื่อมต่อ FarSkip-Collective ที่ช่วยเพิ่มขีดความสามารถในการจัดการข้อมูล
สามารถนำไปใช้งานได้จริงหรือไม่?
โมเดลนี้เปิดให้ใช้งานได้ในบางส่วน โดยน้ำหนักโมเดลถูกปล่อยภายใต้ สัญญาอนุญาต ResearchRAIL สำหรับวัตถุประสงค์ทางวิชาการและการวิจัยเท่านั้น จึงยังไม่สามารถนำไปใช้ในเชิงพาณิชย์ได้โดยตรง อย่างไรก็ตาม training codebase อยู่ภายใต้สัญญาอนุญาต MIT ซึ่งเปิดกว้างให้นักพัฒนานำไปปรับใช้ต่อได้สะดวกกว่า
กลุ่มเป้าหมายหลักคือห้องปฏิบัติการวิจัย AI และทีมวิจัยในองค์กรขนาดใหญ่ที่มีโครงสร้างพื้นฐาน GPU ในศูนย์ข้อมูลของตนเอง แต่ยังไม่เหมาะสำหรับสตาร์ทอัพที่ต้องการ API พร้อมใช้ ในด้านการใช้งานจริง โมเดลนี้โดดเด่นในการศึกษาโครงสร้าง MoE แบบ end-to-end การประเมินผลในบริบทที่ยาวถึง 64K และการทดลองฝึกฝนด้วยเทคนิค RL หลังการเรียนรู้
สำหรับการติดตั้งใช้งานจริง พารามิเตอร์ขนาด 16B ในรูปแบบ BF16 จะต้องใช้หน่วยความจำประมาณ 32 GB ซึ่งการใช้ตัวเร่งความเร็วเพียงตัวเดียวที่มีหน่วยความจำสูงก็เพียงพอต่อการรันโมเดลแล้ว โดย AMD ได้เตรียมโค้ด inference ผ่าน SGLang ไว้ให้พร้อมใช้งาน
สถาปัตยกรรม
Instella-MoE พัฒนาขึ้นบนโครงสร้างแบบ decoder-only ประกอบด้วย 27 เลเยอร์ มี hidden size 2048 และคำศัพท์ 128,896 โทเค็น ในแต่ละเลเยอร์จะใช้ shared experts 2 ตัว ควบคู่กับ routed experts 6 ตัวที่คัดเลือกจากทั้งหมด 64 ตัว ส่งผลให้มีพารามิเตอร์ขณะทำงานจริงเพียง 2.8B นอกจากนี้ยังใช้เทคนิค Multi-Token Prediction ในช่วงการฝึกฝนเพื่อเพิ่มความแม่นยำ
จุดเด่นด้านโครงสร้างที่สำคัญประกอบด้วย Gated MLA ที่เพิ่ม output gate แบบน้ำหนักเบาเพื่อช่วยปรับค่าตามอินพุตก่อนประมวลผล และ FarSkip-Collective ที่ช่วยให้การสื่อสารระหว่างผู้เชี่ยวชาญ (expert-parallel) ทำงานซ้อนทับไปกับการประมวลผลได้ทันที AMD ระบุว่าเทคนิคนี้ช่วยเร่งความเร็วในการฝึกได้ 12.7% และลดระยะเวลารอคอยโทเค็นแรก (TTFT) ได้สูงสุดถึง 39.2%
กระบวนการฝึกฝน (Training pipeline)
ในช่วง Pre-training โมเดลได้รับการฝึกฝนด้วยโทเค็นจำนวน 7.1T จากคลังข้อมูลเปิด เช่น Nemotron-CC-v2 และ RefineCode จากนั้นเข้าสู่ช่วง Mid-training ที่ใช้ชุดข้อมูล Dolma3 ผสมผสานผ่านการหาค่าเฉลี่ยน้ำหนัก (weight averaging) และทำการขยายหน้าต่างบริบทจาก 4K เป็น 64K โดยใช้ YaRN และเทคนิค document masking
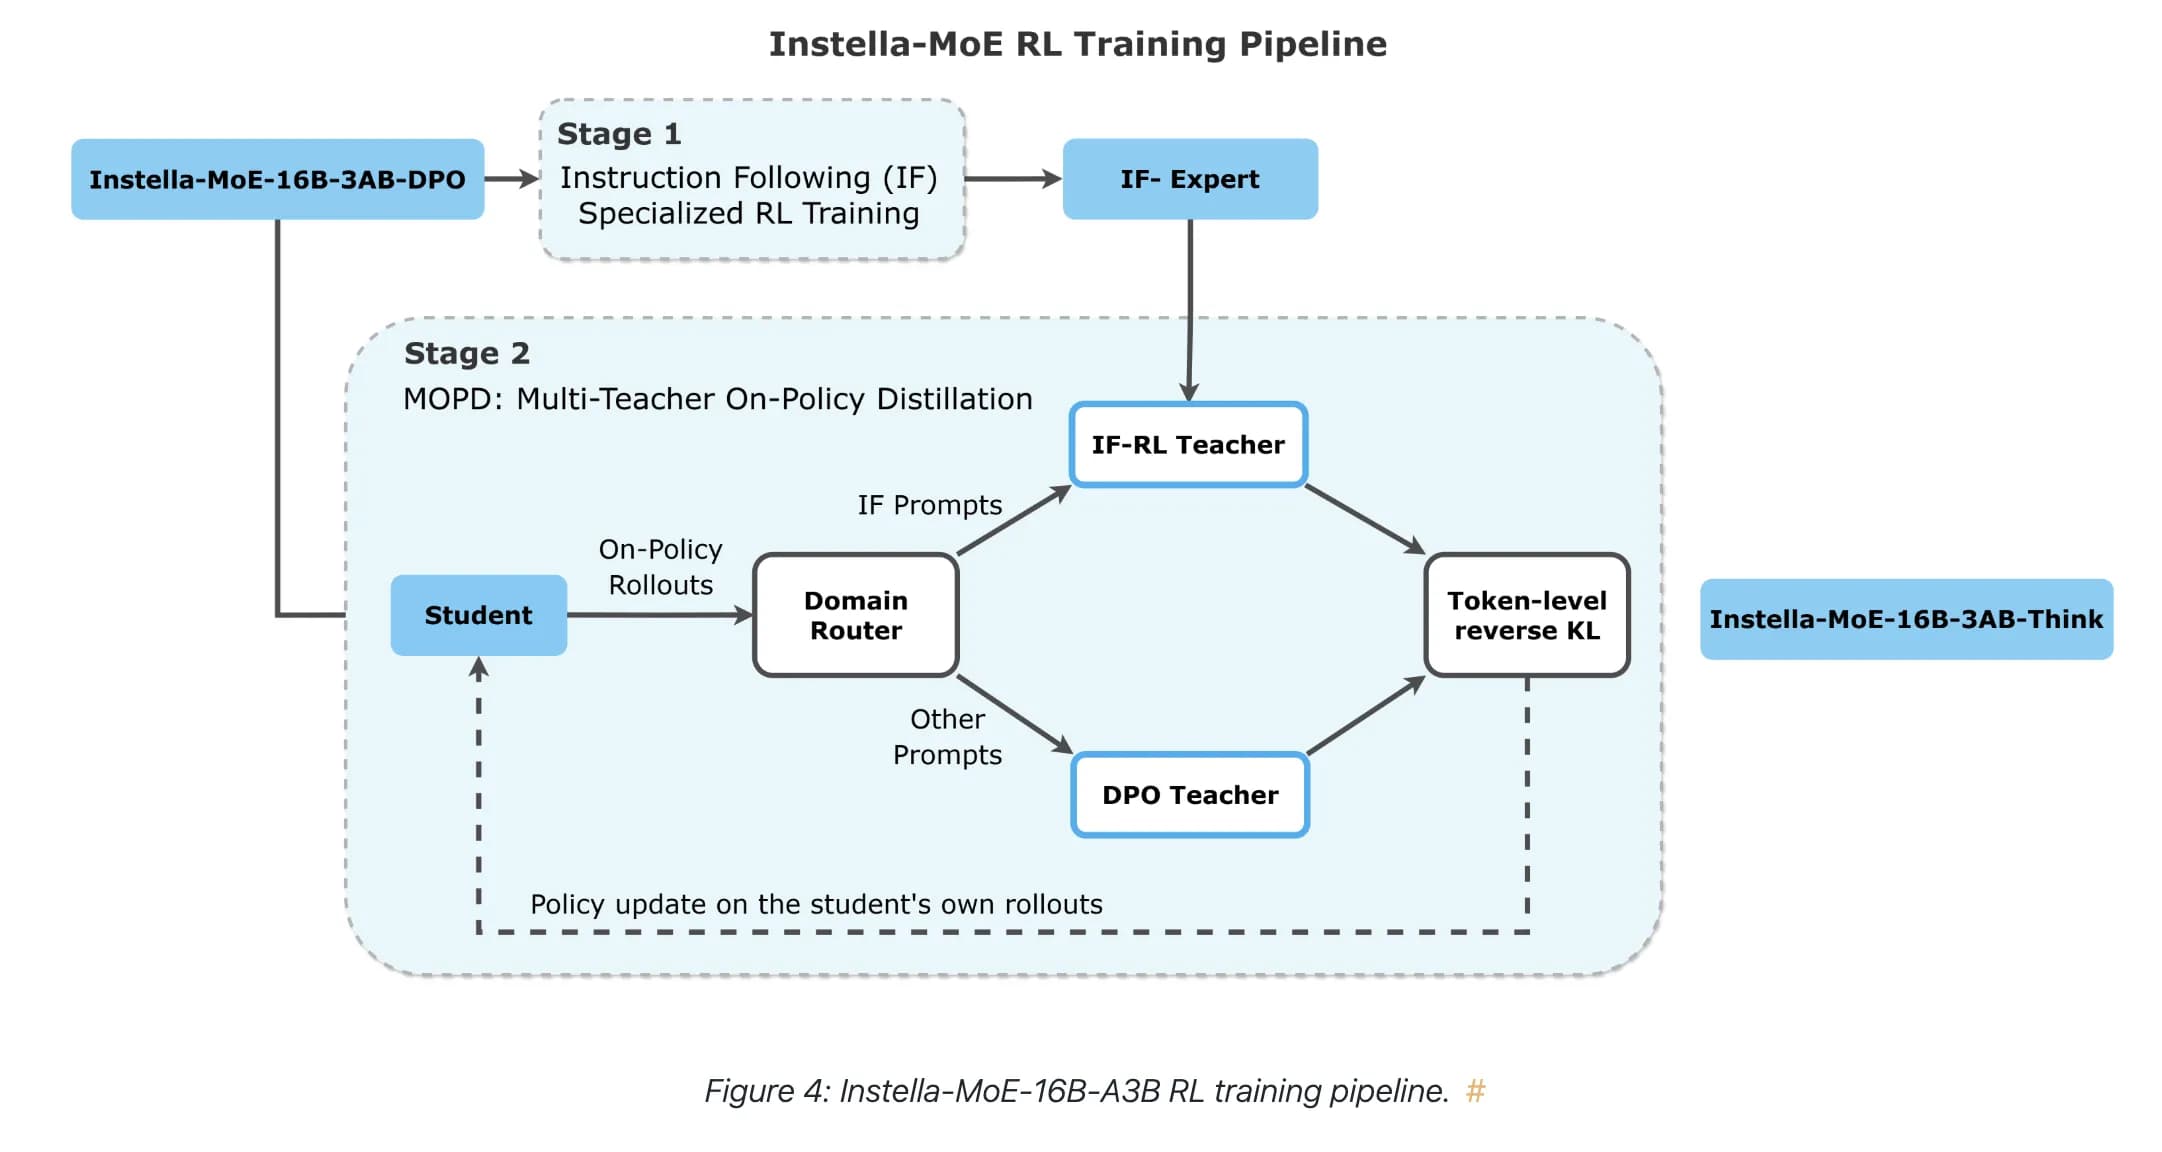
สำหรับการฝึกฝนหลังการเรียนรู้ (Post-training) ได้ดำเนินการผ่านขั้นตอน SFT และ DPO โดยมีการอัปเดต router bias และปิดการใช้งาน auxiliary load-balancing loss เพื่อรักษาคุณภาพโมเดล ในส่วนของ RL ทำงานภายใต้เฟรมเวิร์ก Miles ที่ใช้ RLVR เพื่อพัฒนาการทำตามคำสั่ง และตามด้วย Multi-Teacher On-Policy Distillation เพื่อดึงประสิทธิภาพสูงสุดกลับมาโดยไม่เสียความสามารถด้านคณิตศาสตร์และโค้ด
ผลการทดสอบ
โมเดลพื้นฐาน (checkpoint) ทำคะแนนเฉลี่ยได้ 76.7 ซึ่งสูงที่สุดในบรรดากลุ่มโมเดลที่เปิดกว้างเต็มรูปแบบ โดยชนะทั้ง Moonlight-16B-A3B (76.2) และ OLMo-3-7B (70.1) แม้จะยังตามหลัง Qwen3.5-4B-Base (79.5) อยู่เล็กน้อย แต่ก็ทำผลงานได้ดีเยี่ยมใน WinoGrande และได้คะแนนสูงใน HumanEval+ สำหรับการทดสอบความสามารถด้านโค้ด
ในส่วนของโมเดลที่ผ่านการฝึกหลังการเรียนรู้ (Think model) พบว่าประสิทธิภาพเพิ่มขึ้นอย่างต่อเนื่องจาก SFT (71.58) ไปจนถึง Think (73.22) ซึ่งสูงกว่าคู่แข่งในระดับเดียวกันอย่าง Gemma-4-E4B และ Qwen3.5-4B โดยเฉพาะคะแนน IFEval ที่พุ่งสูงขึ้นเป็น 83.70 สะท้อนถึงทักษะการเข้าใจคำสั่งที่แม่นยำขึ้น
ประเด็นสำคัญ
- ใช้พารามิเตอร์จริงเพียง 2.8B จาก 16B ผ่านกลไกเลือกผู้เชี่ยวชาญ 6 จาก 64 ตัว
- เทคโนโลยี Gated MLA และ FarSkip-Collective ช่วยเพิ่มประสิทธิภาพการฝึกและลดการหน่วงเวลา
- ฝึกฝนบน AMD Instinct MI300X และ MI325X โดยใช้ซอฟต์แวร์ ROCm, Primus และ Miles
- คะแนนทดสอบเฉลี่ยอยู่ในระดับแถวหน้าของกลุ่มโมเดล open-source ทั้งรุ่น Base และ Think
- เปิดให้วิจัยฟรีภายใต้ ResearchRAIL ส่วนโค้ดการฝึกใช้สัญญาอนุญาตแบบ MIT
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร