
Moonshot AI เปิดตัว Kimi K3: โมเดล Open MoE 2.8 ล้านล้านพารามิเตอร์ พร้อมเทคโนโลยี KDA และคอนเทกซ์ 1M
Moonshot AI ประกาศเปิดตัว Kimi K3 โมเดลภาษาขนาด 2.8 ล้านล้านพารามิเตอร์ที่มีความสามารถด้าน Vision ในตัว พร้อม Context Window ขนาดกว้างถึง 1 ล้าน Token โดย Moonshot ยกย่องให้เป็นโมเดลคลาส 3T แบบเปิดตัวแรกของโลก
Kimi K3 คืออะไร?
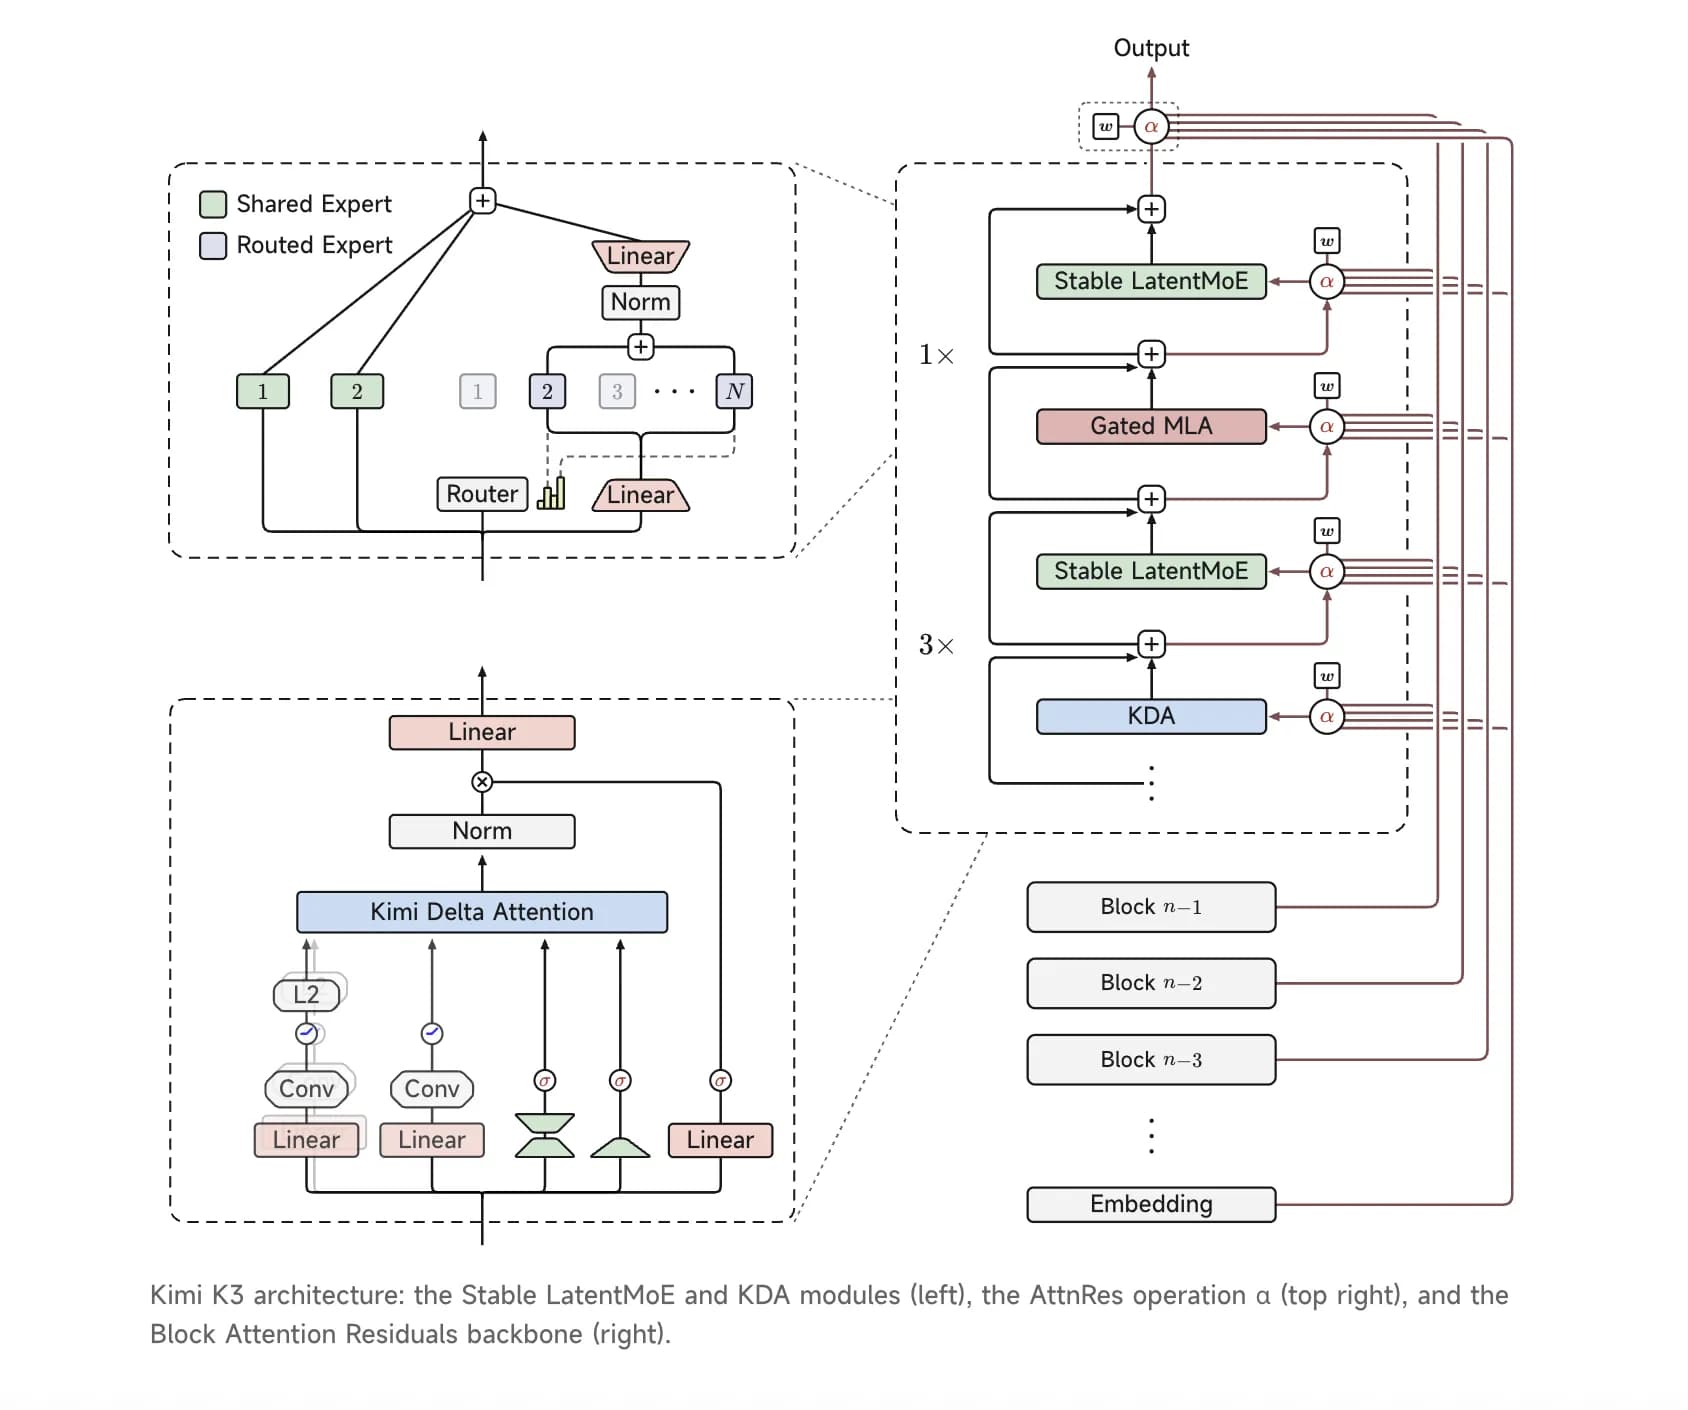
Kimi K3 คือโมเดลประเภท sparse Mixture-of-Experts (MoE) ที่พัฒนาขึ้นบนการอัปเกรดสถาปัตยกรรมสำคัญสองส่วน ได้แก่ Kimi Delta Attention (KDA) และ Attention Residuals (AttnRes) ซึ่งช่วยเพิ่มประสิทธิภาพการไหลของข้อมูลตามความยาวลำดับและความลึกของโมเดล โดย K3 ถูกออกแบบมาเพื่อรองรับงานด้านการเขียนโค้ด (Coding) ระยะยาว งานด้านคลังความรู้ และการใช้เหตุผลโดยเฉพาะ
ทีมงาน Moonshot ระบุว่า K3 เป็นโมเดลแบบเปิดรุ่นแรกที่มีพารามิเตอร์สูงถึง 2.8 ล้านล้านตัว ซึ่งตลอดช่วง 1 ปีที่ผ่านมา ผลิตภัณฑ์ในตระกูล Kimi ได้ทำลายสถิติขีดจำกัดด้านขนาดของโมเดลแบบเปิดมาอย่างต่อเนื่อง
อย่างไรก็ตาม Moonshot ยอมรับว่าประสิทธิภาพโดยรวมของ K3 ยังคงตามหลังโมเดลแบบปิด (Proprietary) ที่ทรงพลังที่สุดอย่าง Claude Fable 5 และ GPT 5.6 Sol แต่จากการทดสอบในชุดประเมินของ Moonshot เอง พบว่า K3 ทำผลงานได้เหนือกว่าโมเดลอื่นๆ ในระดับเดียวกันอย่างสม่ำเสมอ
สถาปัตยกรรมเบื้องหลัง
Kimi Delta Attention (KDA) เป็นกลไก Hybrid Linear Attention ที่ช่วยให้การ Decoding เร็วขึ้นถึง 6.3 เท่า เมื่อต้องประมวลผลคอนเทกซ์ระดับล้าน Token
ในขณะที่ AttnRes ทำงานกับความลึกของโมเดล โดยจะเลือกดึงการนำเสนอข้อมูล (Representation) จากระดับความลึกต่างๆ แทนการสะสมแบบสม่ำเสมอ ซึ่งช่วยให้ประสิทธิภาพในการฝึกฝนสูงขึ้นประมาณ 25% โดยมีต้นทุนเพิ่มขึ้นเพียงไม่ถึง 2%
ด้าน Sparsity โมเดล K3 ใช้เทคโนโลยี Stable LatentMoE ซึ่งเรียกใช้งาน Expert จำนวน 16 ตัวจากทั้งหมด 896 ตัวได้อย่างมีประสิทธิภาพ นอกจากนี้ยังมีการใช้ Quantile Balancing เพื่อแก้ปัญหาการจัดสรร Expert โดยตรงผ่าน Router-score Quantiles ช่วยลดปัญหาจาก Heuristic Updates และการปรับ Hyperparameter ที่ตอบสนองไวเกินไป ส่วน Per-Head Muon, Sigmoid Tanh Unit (SiTU) และ Gated MLA ต่างเข้ามาช่วยเพิ่มประสิทธิภาพในการควบคุมและเลือกใช้ Attention ตามลำดับ
ด้วยกระบวนการฝึกฝนและชุดข้อมูลที่ผ่านการคัดเกลาอย่างละเอียด ควบคู่ไปกับการปรับปรุงโครงสร้างเหล่านี้ ส่งผลให้ประสิทธิภาพการสเกล (Scaling Efficiency) โดยรวมของ K3 ดีขึ้นกว่ารุ่น Kimi K2 ถึง 2.5 เท่า
สำหรับการใช้งานจริง (Serving) K3 ได้ใช้แนวทาง Quantization-aware Training ตั้งแต่ขั้นตอน SFT โดยใช้น้ำหนักแบบ MXFP4 และ Activation แบบ MXFP8 เพื่อให้รองรับฮาร์ดแวร์ได้หลากหลาย ทีม Moonshot แนะนำให้ใช้งานบน Supernode ที่มี Accelerator 64 ตัวขึ้นไป และเนื่องจาก KDA มีความท้าทายใหม่ในด้าน Prefix Caching ทาง Moonshot จึงได้ร่วมผลักดันฟีเจอร์นี้ไปใช้ใน vLLM ด้วย
ประสิทธิภาพ
ผลคะแนนการทดสอบของ K3 ที่ประกาศออกมานั้นมาจากการตั้งค่าการใช้เหตุผล (Reasoning Effort) ไว้ที่ระดับสูงสุด (Max) โดยอ้างอิงจากเบนช์มาร์กหลักอย่าง KimiCode, Claude Code และ Codex ดังนี้:
| เบนช์มาร์ก | Kimi K3 | Fable 5 (พร้อม fallback) | GPT 5.6 Sol | Opus 4.8 | GLM-5.2 |
|---|---|---|---|---|---|
| DeepSWE | 67.5 | 70.0 | 73.0 | 59.0 | 46.2 |
| Program Bench | 77.8 | 76.8 | 77.6 | 71.9 | 63.7 |
| Terminal Bench 2.1 | 88.3 | 84.6 | 88.8 | 84.6 | 82.7 |
| FrontierSWE | 81.2 | 86.6 | 71.3 | 66.7 | 67.3 |
| SWE Marathon | 42.0 | 35.0 | 39.0 | 40.0 | 13.0 |
| BrowseComp | 91.2 | 88.0 | 90.4 | 84.3 | — |
| Automation Bench | 30.8 | 29.1 | 29.7 | 27.2 | 12.9 |
| GPQA-Diamond | 93.5 | 92.6 | 94.1 | 91.0 | 91.2 |
| HLE-Full | 43.5 | 53.3 | 44.5 | 49.8 | — |
| MMMU-Pro | 81.6 | 81.2 | 83.0 | 78.9 | — |
| OmniDocBench | 91.1 | 89.8 | 85.8 | 87.9 | — |
หมายเหตุ: 'With fallback' ของ Fable 5 หมายถึงกรณีที่คำขอถูกปฏิเสธตามนโยบายการใช้งาน ระบบจะส่งต่อไปยัง Opus 4.8 แทน และใน BrowseComp มีการใช้การบีบอัดคอนเทกซ์ (Context Compaction) เมื่อถึงระยะ 300K Token หากไม่มีการจัดการนี้ K3 จะได้คะแนนอยู่ที่ 90.4
สรุปผลการทดสอบ K3 เป็นผู้นำใน Program Bench, SWE Marathon, BrowseComp, Automation Bench และ OmniDocBench โดยเป็นรอง Fable 5 ใน FrontierSWE และ HLE-Full และตามหลัง GPT 5.6 Sol ใน DeepSWE
กรณีการใช้งานและตัวอย่าง
| กรณีการใช้งาน | ตัวอย่างที่มีการรายงาน | สิ่งที่อาศัยเป็นหลัก |
|---|---|---|
| วิศวกรรมระดับ Repo | เซสชันที่ยาวนาน, การควบคุมจากมนุษย์น้อยที่สุด | Kimi Code, /model |
| Vision ในการทำงาน | การสลับทำงานระหว่างโค้ดและภาพหน้าจอสด | Vision, ms://<file-id> |
| การจำลองงานวิจัย | ความสัมพันธ์ I–Love–Q: บทความ 20+ ฉบับ, Python 3,000+ บรรทัด | คอนเทกซ์ 1M, auto caching |
| รายงานวิจัยเชิงลึก | การศึกษา ASIC ระยะเวลา 42 ปี: การดึงข้อมูล 2.8k+ ครั้ง, 11k+ หน้า | Kimi Work, Widgets |
| การแยกวิเคราะห์เอกสาร | คะแนน OmniDocBench ที่ 91.1 | Vision, structured output |
ทั้งนี้ สถาปัตยกรรมแบบ Native Multimodal ของ Moonshot สามารถประมวลผลทั้งข้อความ, รูปภาพ และวิดีโอร่วมกันได้อย่างไร้รอยต่อ
การเข้าถึงและการใช้งานเบื้องต้น
K3 พร้อมใช้งานแล้วผ่าน Kimi.com, Kimi Work, Kimi Code และ API โดยสามารถเรียกใช้งานได้ผ่าน OpenAI SDK โดยระบุ Base URL ของ Moonshot ดังนี้:
from openai import OpenAI
import os
client = OpenAI(api_key=os.environ["MOONSHOT_API_KEY"],
base_url="https://api.moonshot.ai/v1")
completion = client.chat.completions.create(
model="kimi-k3",
reasoning_effort="max",
messages=[{"role": "user", "content": "Introduce Kimi K3 in one sentence."}],
)
print(completion.choices[0].message.content)
เงื่อนไขสำคัญคือ reasoning_effort รองรับเฉพาะค่า max เท่านั้น และไม่รองรับพารามิเตอร์ thinking จากรุ่น K2.x ส่วน temperature, top_p และ n ถูกกำหนดค่าตายตัวไว้แล้ว สำหรับ max_completion_tokens มีค่าเริ่มต้นที่ 131,072 และปรับสูงสุดได้ถึง 1,048,576
โครงสร้างราคาเป็นแบบอัตราคงที่: อินพุตเแบบ Cache-hit อยู่ที่ $0.30/MTok, Cache-miss อยู่ที่ $3.00/MTok และเอาต์พุตอยู่ที่ $15.00/MTok โดย Moonshot เผยว่าในงานด้าน Coding มีอัตรา Cache-hit สูงกว่า 90%
สรุปประเด็นสำคัญ
- Kimi K3 เป็นโมเดล Open MoE ขนาด 2.8T พารามิเตอร์ ที่เปิดใช้งาน Expert 16 จาก 896 ตัว
- มีประสิทธิภาพการสเกลดีขึ้น 2.5 เท่าเมื่อเทียบกับ K2 ด้วยเทคโนโลยี KDA, AttnRes และระบบ Sparsity แบบใหม่
- ครองอันดับหนึ่งในเบนช์มาร์ก BrowseComp, SWE Marathon และ OmniDocBench
- รองรับ OpenAI SDK ในราคาที่คุ้มค่า พร้อมรองรับคอนเทกซ์สูงสุด 1M
ตรวจสอบ รายละเอียทางเทคนิค และ
ทดลองใช้ที่นี่**.** นอกจากนี้ สามารถติดตามเราได้ที่
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร