
DeepSeek ปล่อย DeepSeek-V4.1-Flash รุ่นใหม่: มาพร้อม 1M Context และนวัตกรรมประหยัด KV Cache ถึง 437 เท่า
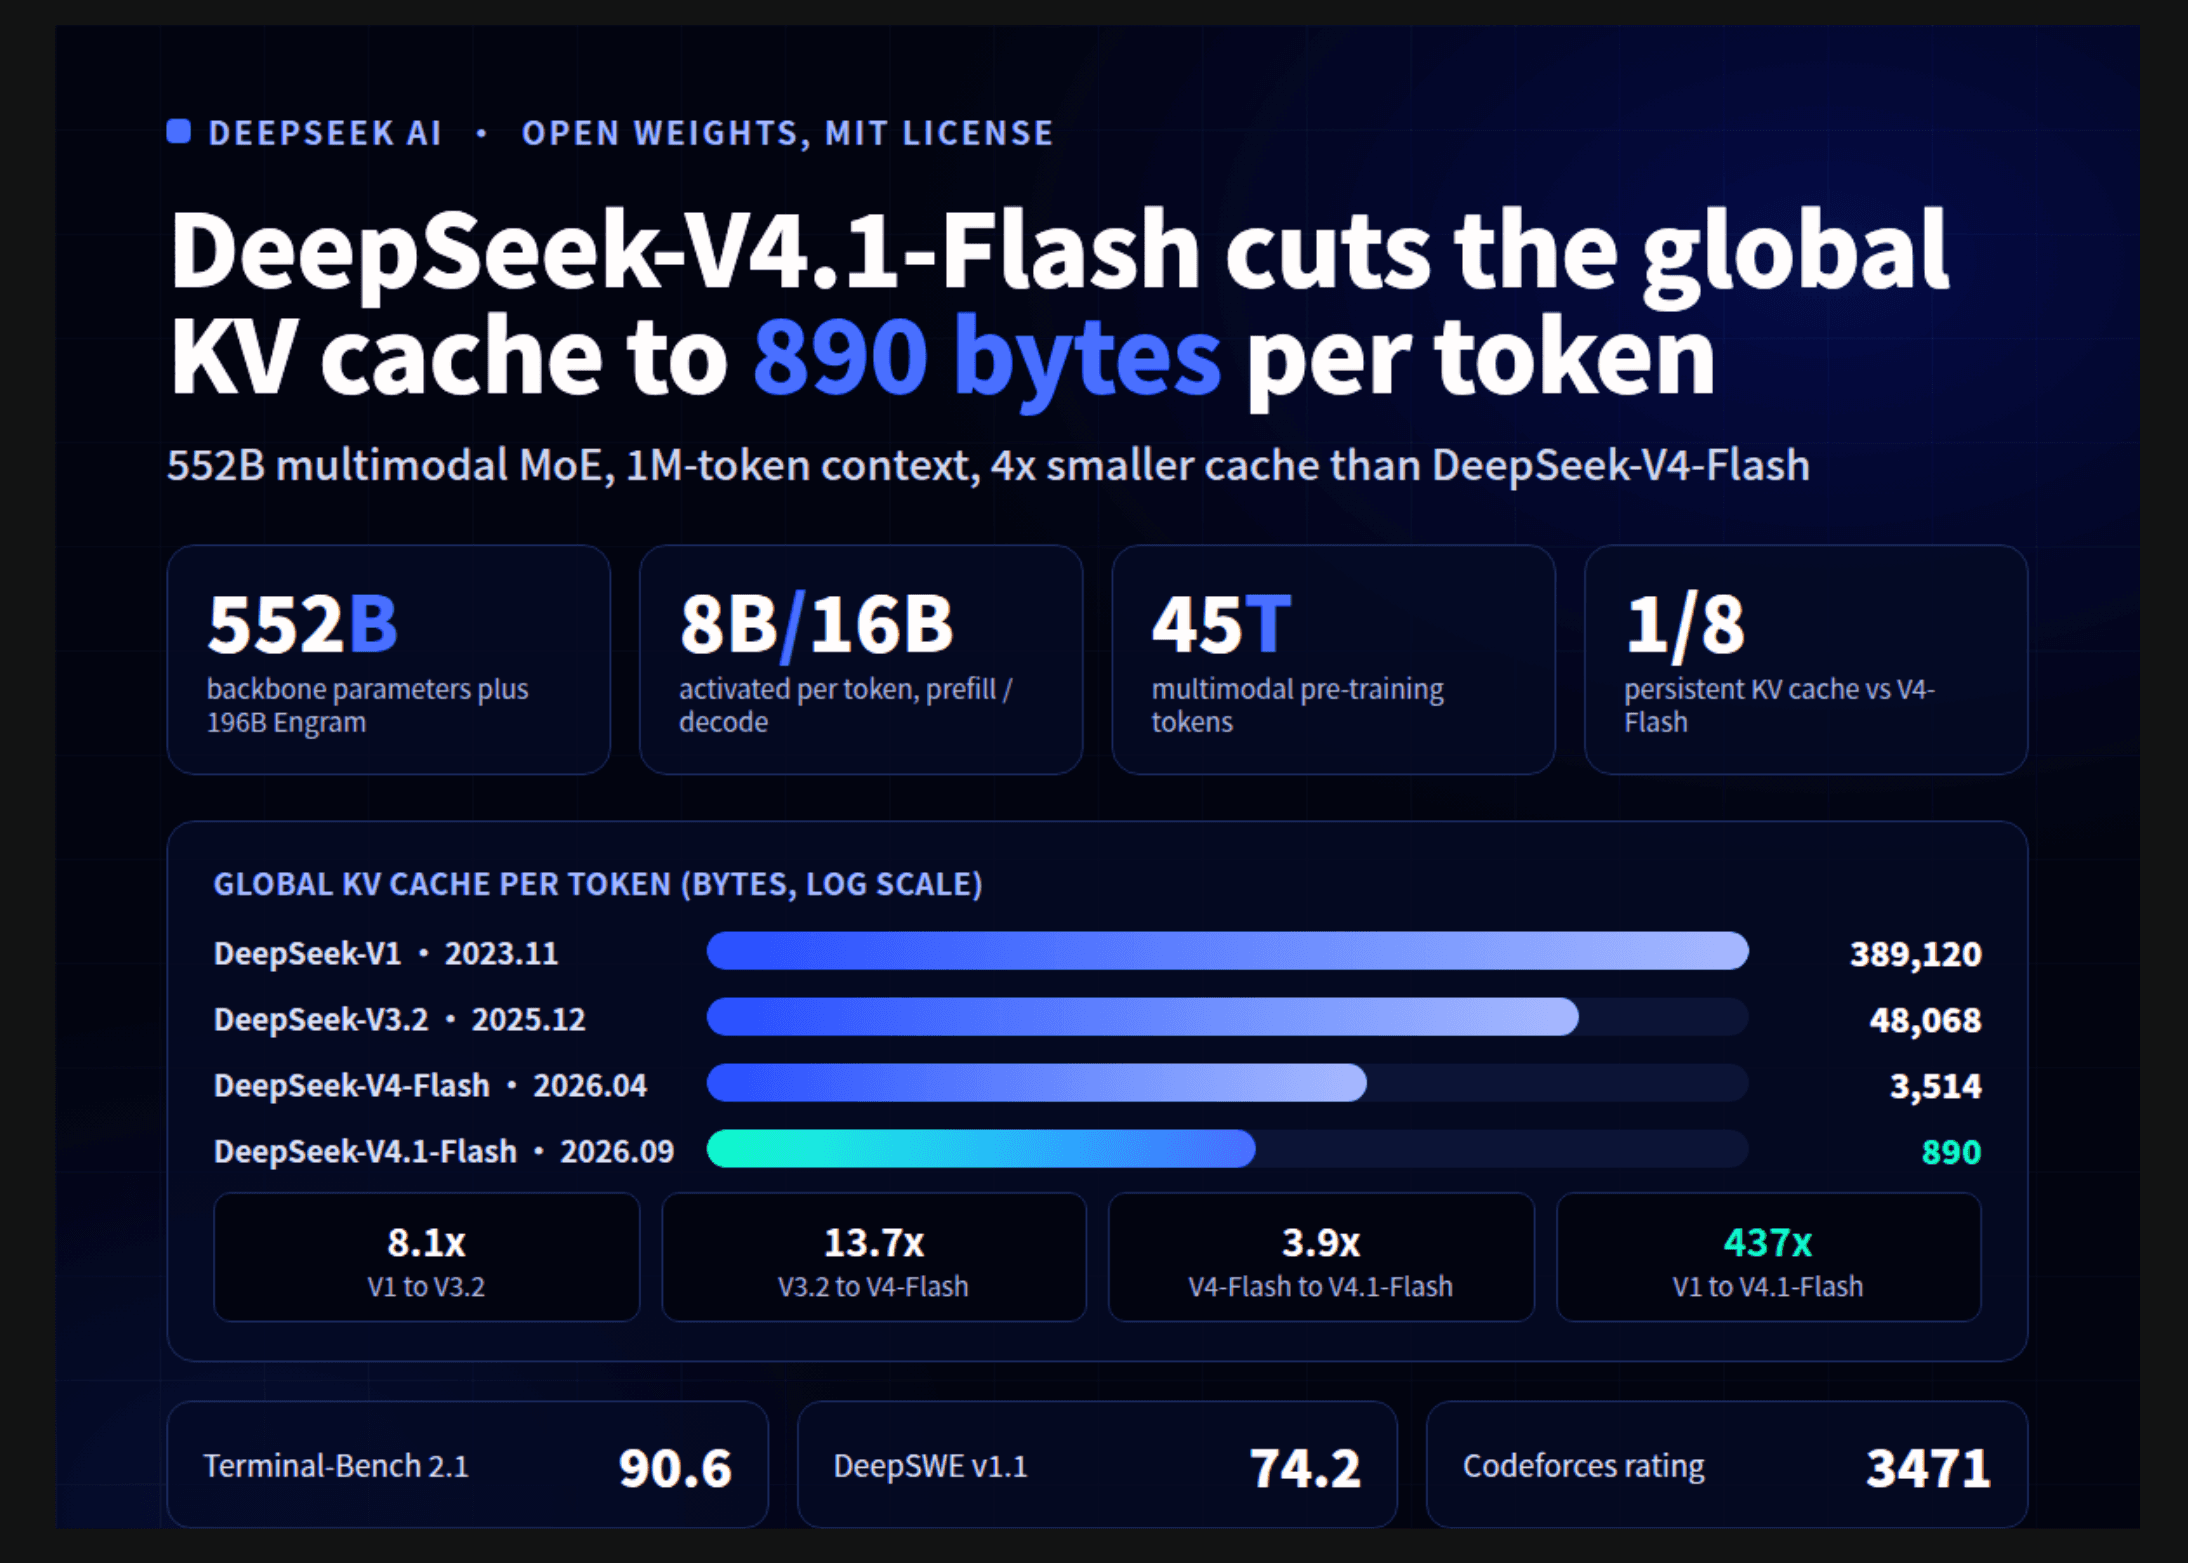
การมาถึงของเอเจนต์ที่ทำงานระยะยาว (Long-horizon agents) ได้เปลี่ยนรูปแบบการให้บริการ LLM ให้กลายเป็นงานที่เน้นการประมวลผลอินพุตจำนวนมหาศาล ซึ่งการทำ prefill ซ้ำๆ และการใช้ context ขนาดหลักล้านโทเคนส่งผลให้ KV caches กลายเป็นภาระหนักต่อทั้ง HBM, ความจุ SSD และแบนด์วิดท์ของระบบ
DeepSeek AI จึงได้พัฒนาโมเดลรุ่นล่าสุด DeepSeek-V4.1-Flash เพื่อแก้ปัญหาคอขวดนี้โดยเฉพาะ โดยเป็นโมเดล Mixture-of-Experts แบบมัลติโมดอลที่มีพารามิเตอร์ backbone 552B เสริมด้วยพารามิเตอร์ Engram อีก 196B และรองรับ context window ขนาด 1M โทเคน
โมเดลนี้จะเปิดใช้งานพารามิเตอร์ 8B ต่อโทเคนในช่วง prefill และเพิ่มเป็น 16B ในช่วง decode โดยมีจุดเด่นสำคัญคือการลด global KV cache footprint เหลือเพียง 890 ไบต์ต่อโทเคน ซึ่งคิดเป็น 1 ใน 4 ของรุ่น V4-Flash เดิม และมีขนาดเล็กลงถึง 437 เท่าเมื่อเทียบกับ DeepSeek-V1
สำหรับคำถามว่า สามารถนำไปใช้งานจริงได้หรือไม่? คำตอบคือ ใช่ เนื่องจากมีการปล่อยน้ำหนักโมเดลแบบ Open weights ภายใต้ MIT license พร้อมรองรับ vLLM, SGLang และ Transformers บน Hugging Face นอกจากนี้ทีมวิจัยยังระบุว่าจะมี public API ที่เลือกใช้ระดับการประมวลผล (reasoning tiers) ได้ตั้งแต่ระดับต่ำไปจนถึงสูงสุด
Causal Encoder-Decoder: ลดภาระการ Prefill ลงครึ่งหนึ่ง
โครงสร้าง backbone จำนวน 40 เลเยอร์ถูกแบ่งออกเป็น causal encoder 20 เลเยอร์ และ decoder 20 เลเยอร์ โดยได้รับแรงบันดาลใจจาก YOCO ซึ่งทำให้ decoder ไม่ต้องคำนวณ global KV ของตัวเอง แต่จะใช้น้ำหนักโปรเจกชันรายเลเยอร์เพื่อดึงข้อมูลจาก encoder hidden state ขั้นสุดท้ายแทน
กระบวนการนี้ทำให้ prompt โทเคนหยุดอยู่แค่ที่ encoder ซึ่งช่วยลดการคำนวณในช่วง prefill ลงได้เกือบครึ่งหนึ่ง ในขณะที่ระบบ sliding-window attention (SWA) ขนาด 128 โทเคนยังคงทำงานในทุกเลเยอร์ โดยสถานะ SWA ของ decoder จะถูกสร้างขึ้นใหม่ผ่านการรันซ้ำเฉพาะ 128 prompt โทเคนล่าสุด ซึ่งทีมวิจัยเรียกว่าเทคนิค Decoder SWA Bounded Replay
Compressed Sparse Attention 2 (CSA2)
ในขณะที่รุ่น DeepSeek-V4 ผสมผสาน CSA เข้ากับ Heavily Compressed Attention แต่ในรุ่น V4.1-Flash ได้เปลี่ยนมาใช้ pure CSA2 และจัดการขนาดแคชตามแนวแกนเลเยอร์ โดยแต่ละเลเยอร์ของ CSA2 จะถูกกำหนดโหมดการทำงานคงที่ไว้ 3 รูปแบบคือ:
- Full: ทำการคำนวณ main KV ของตัวเองและเลือกดัชนี Top-512 ใหม่
- Reindex: ใช้ main KV และ indexer K ซ้ำจากเลเยอร์ Full ล่าสุด แต่คำนวณคะแนนใหม่ด้วย Q ของตัวเอง
- Reuse: ใช้ทั้ง main KV และดัชนี Top-K ล่าสุดซ้ำทั้งหมดโดยข้ามขั้นตอน indexer ไปเลย
เลเยอร์ CSA2 ในส่วน encoder ทั้ง 18 เลเยอร์จะใช้อัตราส่วนการบีบอัดแบบกลุ่ม (1 Full ต่อ 5 Reuse) ส่วนใน decoder 20 เลเยอร์จะมีการใช้ Hierarchical Sparse Indexer ช่วยให้เลเยอร์ Full สร้างกลุ่มตัวเลือกได้สูงสุด 16,384 ตำแหน่ง เพื่อให้เลเยอร์ Reindex คำนวณคะแนนเฉพาะในชุดที่จำกัดไว้แทนที่จะคำนวณ context ทั้งหมด
FP4 KV, Bounded Replay และการเพิ่มประสิทธิภาพอื่นๆ
Main KV cache ได้รับการ Quantized เป็นรูปแบบ E2M1 ตามแนวทาง NVFP4 ซึ่งช่วยลดพื้นที่จัดเก็บลงเกือบครึ่งเมื่อเทียบกับ FP8 cache ในรุ่น V4 เดิม
ด้านการติดตั้งใช้งาน SWA KV จะถูกย้ายจาก SSD ไปเก็บไว้ใน distributed pool บน host DRAM แทน โดยมีระบบ Encoder SWA Bounded Replay ที่ช่วยให้การคำนวณใหม่ทำเพียง 128 โทเคนเท่านั้นเมื่อเกิดข้อมูลไม่พบ (miss)
นอกจากนี้ยังมีการปรับปรุงอื่นๆ เช่น Single-Pass mHC เพื่อลดทราฟฟิกหน่วยความจำ, โมดูลหน่วยความจำเงื่อนไข Engram และการใช้ DSpark speculative decoding ทำให้ FLOPs ในการ decode โทเคนเดี่ยวเพิ่มขึ้นเพียง 1/4 แม้ context จะขยายจาก 4K ไปถึง 1M ก็ตาม
การฝึกฝนและผลลัพธ์ประสิทธิภาพ
โมเดลนี้ผ่านการ pre-training ด้วยมัลติโมดอลโทเคนถึง 45T โทเคน โดยมีประสิทธิภาพทัดเทียมกับ DeepSeek-V4-Pro-Base ในด้านความรู้ทั่วไปและการเขียนโค้ด ทั้งที่ใช้พารามิเตอร์รวมเพียง 1 ใน 3 และใช้พารามิเตอร์ที่ทำงานจริง (activated parameters) เพียง 1 ใน 4 เท่านั้น
ผลการทดสอบในโหมดประสิทธิภาพสูงสุดแสดงให้เห็นว่า DeepSeek-V4.1-Flash สามารถทำคะแนนชนะคู่แข่งอย่าง Opus-5 และ GPT-5.6 Sol ในบางหมวดหมู่:
| Benchmark | DS-V4.1-Flash | DS-V4-Flash | Opus-5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 82.7 | 89.1 | 88.8 |
| DeepSWE v1.1 | 74.2 | 54.4 | 74.0 | 73.0 |
| Terminal-Bench 4.0 | 31.2 | 7.0 | 51.8 | 39.9 |
| Automation-Bench | 54.8 | 37.7 | 50.3 | 45.8 |
| GPQA Diamond | 90.9 | 89.9 | 93.4 | 94.1 |
| Codeforces (rating) | 3471 | 3289 | n/a | n/a |
Interactive Explainer
สรุปประเด็นสำคัญ
- Global KV cache ลดลงเหลือ 890 ไบต์ต่อโทเคน (ประหยัดกว่า V1 ถึง 437 เท่า)
- ใช้โครงสร้าง CED รันเพียง 20 encoder layers ในช่วง prefill ช่วยประหยัดการคำนวณ
- เทคโนโลยี CSA2 ช่วยแชร์ข้อมูลข้ามเลเยอร์อย่างมีประสิทธิภาพในโหมด Full, Reindex และ Reuse
- การใช้ FP4 KV ร่วมกับ SWA Bounded Replay ลดภาระ persistent cache เหลือเพียง 1 ใน 8 ของ V4-Flash
- ชนะ Opus-5 และ GPT-5.6 Sol ในการทดสอบ Terminal-Bench 2.1 และ DeepSWE v1.1
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร