
Meta เปิดตัว Muse Spark Open โมเดล MoE แบบ Open-weight ทรงพลังที่สุด
Muse Spark Open เป็นโมเดลแบบ open-weight ล่าสุดจาก Meta ที่ใช้สถาปัตยกรรม Mixture of Experts (MoE) โดยรวมความสามารถในการประมวลผลข้อความ, รูปภาพ, เสียง และวิดีโอเข้าไว้ด้วยกันในโมเดลเดียว มีพารามิเตอร์รวมประมาณ 816 พันล้านพารามิเตอร์ (พารามิเตอร์ที่ทำงานจริง 42 พันล้านพารามิเตอร์ต่อหนึ่ง token) และรองรับ context window สูงถึงหนึ่งล้าน tokens เพื่อช่วยให้นักพัฒนามีอินเทอร์เฟซมาตรฐานสำหรับจัดการอินพุตที่หลากหลาย
โมเดลนี้ต่อยอดจาก Muse Glimmer โดยนำเสนอสถาปัตยกรรม MoE ในสเกลที่ใหญ่ขึ้น และถือเป็นโมเดลแบบ open-weights ของสหรัฐฯ ที่มีความสามารถสูงที่สุดในขณะนี้ Meta ได้ฝึกฝน Muse Spark Open สำหรับงาน agentic coding โดยเฉพาะ ทั้งการอ่านฐานรหัส (codebase), การเขียนและดีบักโค้ด รวมถึงการเรียกใช้เครื่องมือ (tool calling) นอกจากนี้ยังสามารถวิเคราะห์ภาพหน้าจอ ฟังข้อความเสียง หรือดูวิดีโอบันทึกหน้าจอขณะทำงานกับโค้ดได้ ค้นหาโมเดลทั้งหมดได้ที่นี่
ความสามารถโดยรวมและสถาปัตยกรรม
Meta ระบุว่า Muse Spark Open คือโมเดลที่ปรับแต่งมาเพื่อการเขียนโค้ด (coding-optimized) โดยผ่านการฝึกฝนจากเวิร์กโฟลว์จริง เช่น การ refactor หลายไฟล์พร้อมกัน หรือการดีบักที่ต่อเนื่องยาวนาน โมเดลนี้เน้นความเป็น agentic ที่สามารถวางแผน ลงมือทำ สังเกตการณ์ และแก้ไขข้อผิดพลาดได้ด้วยตัวเอง รวมถึงความสามารถในการท่องเว็บผ่านรูปภาพ
| คุณสมบัติ | Muse Spark Open |
|---|---|
| ขนาดโมเดล | พารามิเตอร์รวม ~816B; พารามิเตอร์ที่ทำงานต่อ token ~42B |
| การเลือกผู้เชี่ยวชาญ (Expert routing) | 256 experts ต่อชั้น MoE; เลือก 8 experts ต่อ token |
| อินพุต | ข้อความ, รูปภาพ, เสียง และวิดีโอ |
| เอาต์พุต | ข้อความ |
| Context window | สูงสุด 1M tokens |
| รูปแบบ Checkpoint | BF16 และ NVFP4 |
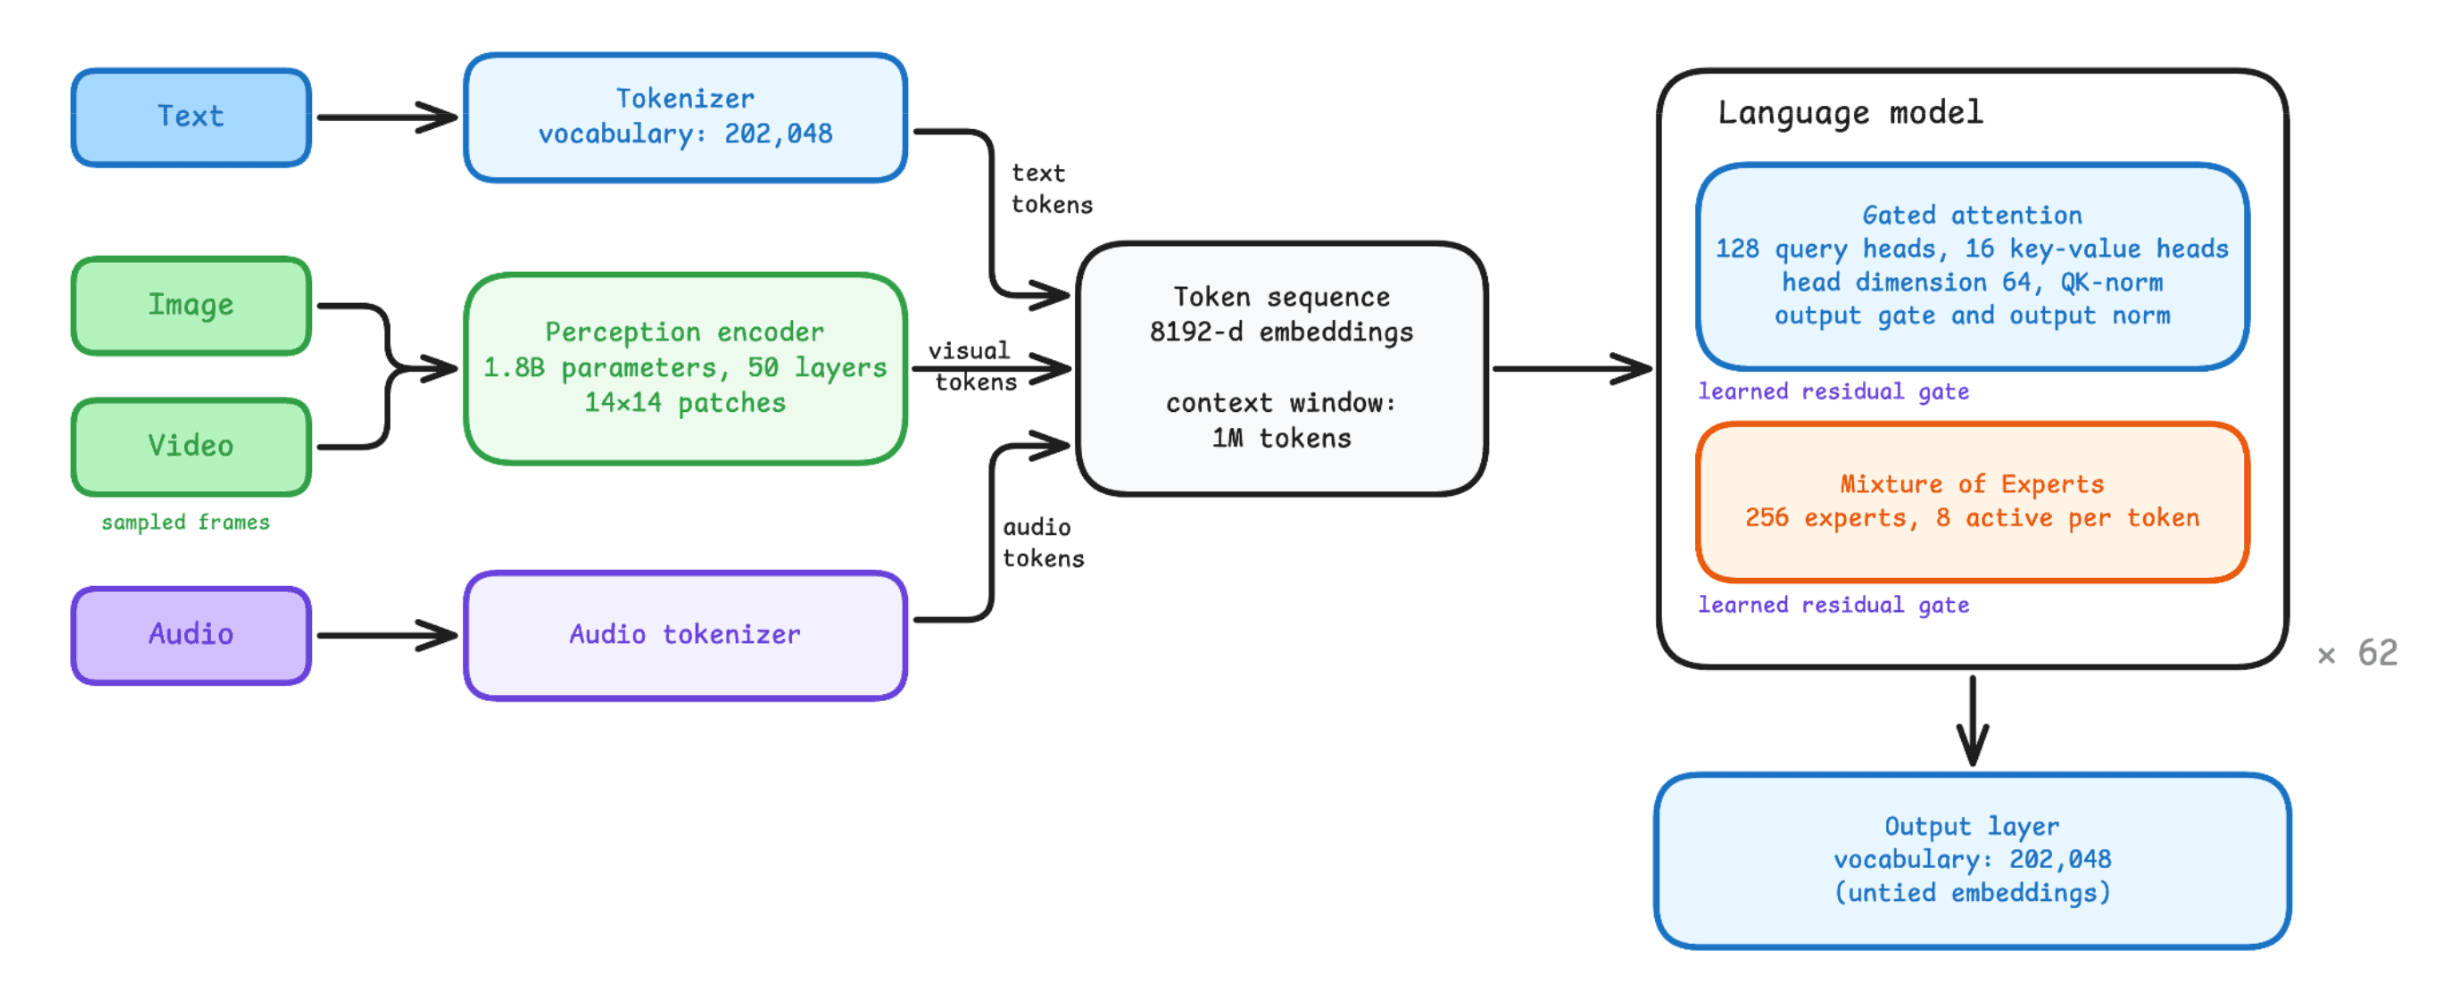
Muse Spark Open เป็นโมเดลขนาดเต็มในซีรีส์ Muse ต่างจาก Muse Glimmer ที่ปล่อยออกมาในเดือนสิงหาคมซึ่งเป็นโมเดลขนาดเล็กแบบ dense เหมาะสำหรับรันแบบโลคัล ทั้งสองใช้ tokenizer และ vocabulary เดียวกัน โดยโมเดลใหม่นี้มี input embedding และ output layer ที่แยกเมทริกซ์กันพร้อมพารามิเตอร์ส่วนละ 1.66B
Mixture of Experts
โมเดลประกอบด้วย 62 ชั้น และมิติที่ซ่อนอยู่ (hidden dimension) ขนาด 8192 ใช้การจัดการความสนใจแบบ grouped-query attention และ QK-norm ในแต่ละบล็อกจะรวมอินพุตและเอาต์พุตผ่าน residual gate ที่เรียนรู้มาแทนการบวกธรรมดา
ในแต่ละบล็อก MoE จะมีผู้เชี่ยวชาญ 256 ราย โดย router จะเลือก 8 รายต่อหนึ่ง token ผู้เชี่ยวชาญเหล่านี้ถือครองพารามิเตอร์ถึง 97% ของทั้งหมด ทำให้แม้จะมีพารามิเตอร์รวมมหาศาล แต่รันด้วยความเร็วเสมือนโมเดลขนาด 42B สำหรับการ deploy รูปแบบ BF16 ต้องการหน่วยความจำประมาณ 1.5 TB ส่วนรูปแบบ NVFP4 แบบ 4-bit ออกแบบมาเป็นพิเศษสำหรับ GPU NVIDIA Blackwell ทำให้รันบนโหนด B200 เพียงโหนดเดียวได้
Perception Encoder
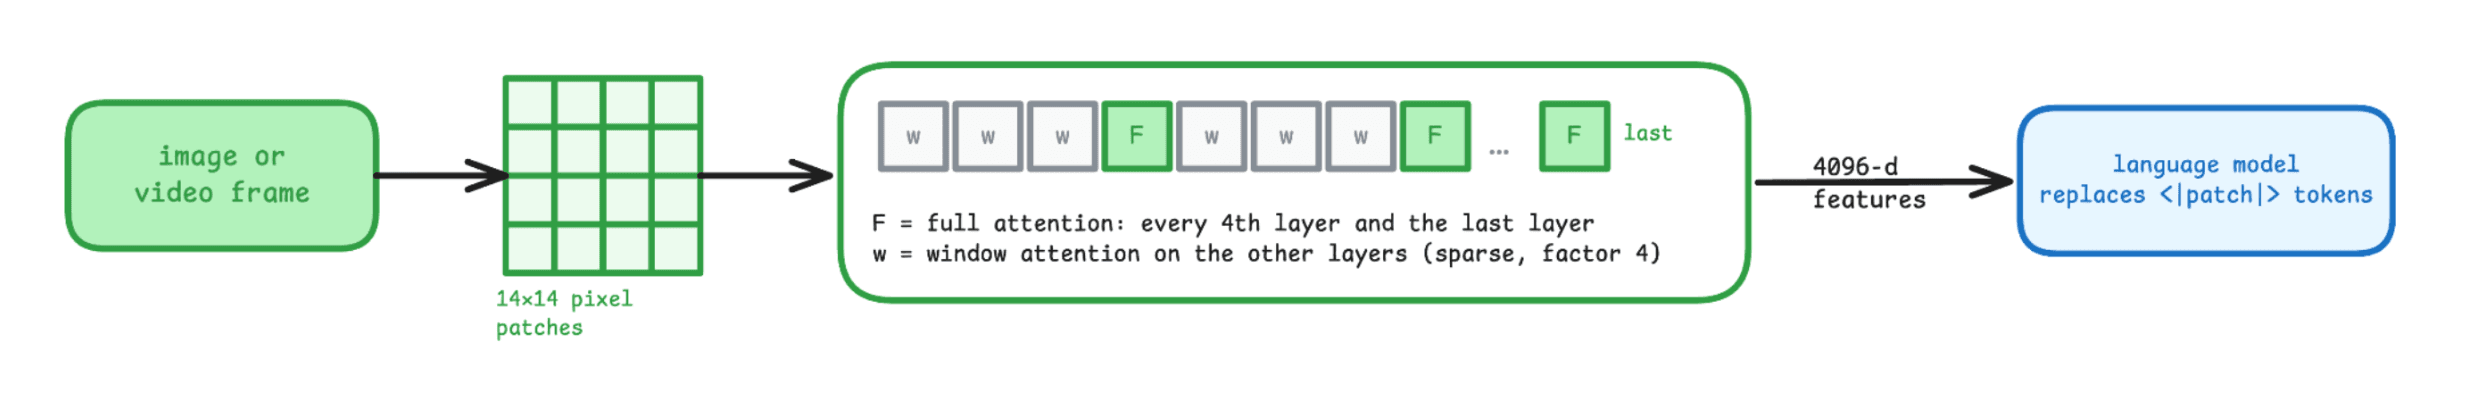
ทำหน้าที่แปลงรูปภาพและวิดีโอเป็น tokens สำหรับโมเดลภาษา มีพารามิเตอร์ 1.8B โดยใช้สถาปัตยกรรม 50 ชั้น แบ่งภาพเป็น patches ขนาด 14×14 และสร้างฟีเจอร์ 4096 มิติ การออกแบบนี้อ้างอิงจากงานวิจัย Perception Encoder ของ Meta
Audio Encoder
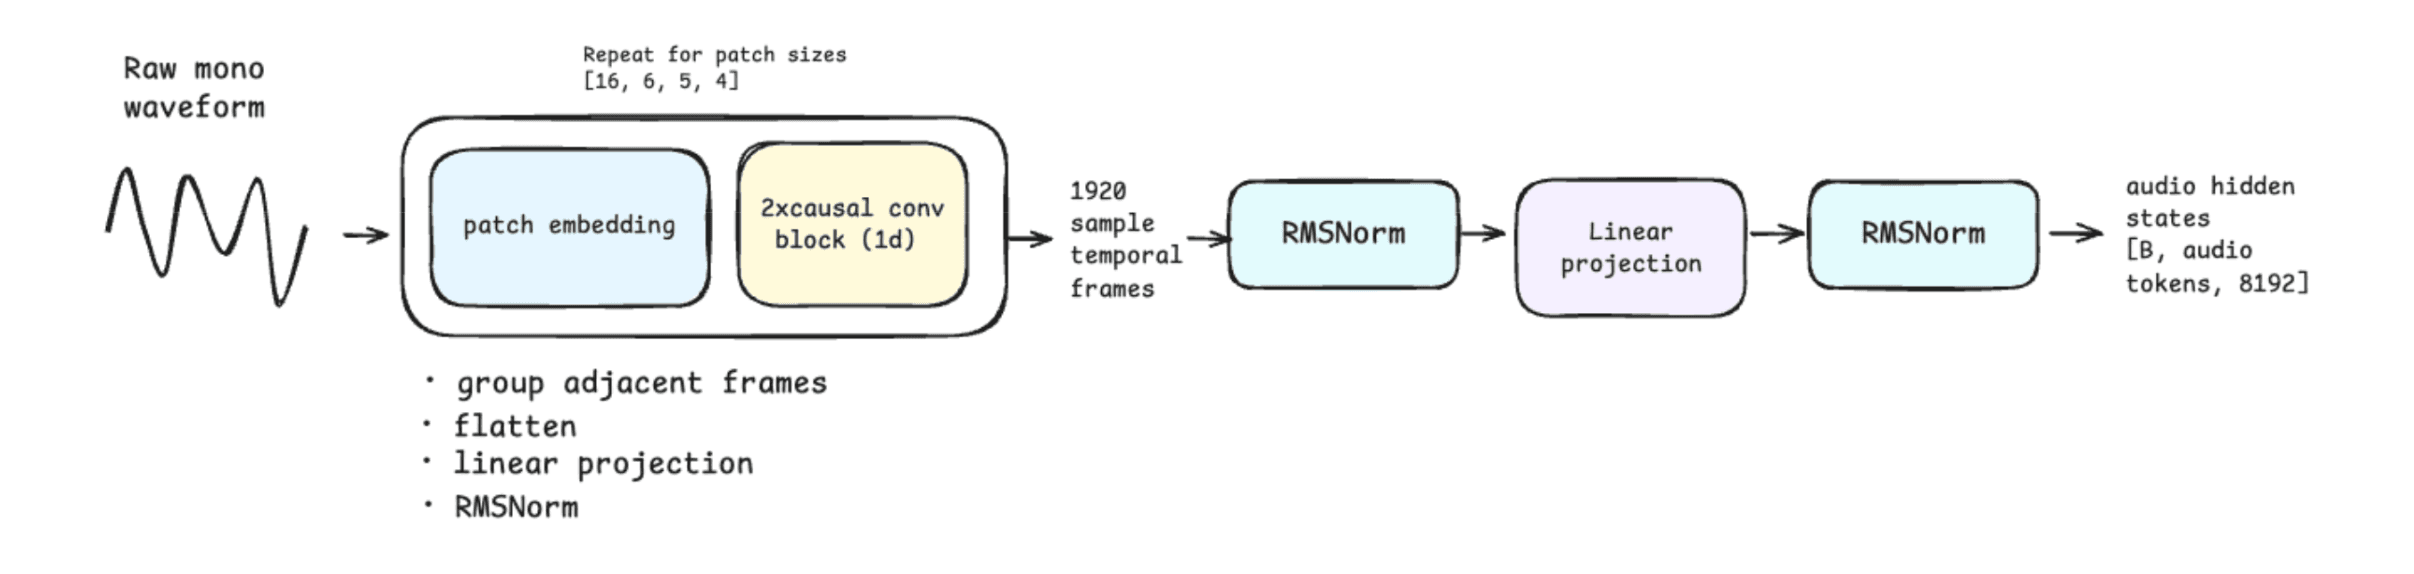
Muse Spark Open รับเสียงผ่าน audio encoder โดยแปลงเสียงเป็น tokens ทุกๆ 80 ms (12.5 tokens ต่อวินาที) ใช้สถาปัตยกรรมแบบ convolutional pyramid เพื่อประมวลผลสัญญาณเสียงให้เป็นโทเค็น <|audio|> ใน chat template
Long Context
รองรับ context window สูงสุด 1M tokens ซึ่งรวมทั้งข้อความ ภาพ วิดีโอ และเสียงไว้ด้วยกัน การใช้ Grouped-query attention ช่วยประหยัดพื้นที่ KV cache โดยในรูปแบบ BF16 จะใช้พื้นที่ประมาณ 266 GB สำหรับ context ขนาดเต็มความจุ
การสนับสนุน Inference
Transformers
Meta จัดเตรียม MuseSparkForConditionalGeneration และ MuseSparkProcessor สำหรับการสร้างข้อความจากอินพุตหลายรูปแบบ รวมถึงรองรับ DistributedConfig เพื่อจัดการ parallelism
import os

from transformers import AutoModelForMultimodalLM, AutoTokenizer, DistributedConfig

distributed_config = DistributedConfig(
    tp_size=int(os.environ["WORLD_SIZE"]),
    ep_size=int(os.environ["WORLD_SIZE"]),
)

tokenizer = AutoTokenizer.from_pretrained("meta-models/Muse-Spark-Open-816B-A42B")
model = AutoModelForMultimodalLM.from_pretrained(
    "meta-models/Muse-Spark-Open-816B-A42B",
    distributed_config=distributed_config,
)

messages = [
    {"role": "user", "content": "Explain in one sentence why the sky is usually blue."},
]
inputs = tokenizer.apply_chat_template(
    messages,
    reasoning_effort="medium",  # default: xhigh, options: low/medium/high/xhigh
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device).to(model.dtype)

input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=2000)
Text-only Inference
ผู้ใช้สามารถปรับระดับความพยายามในการใช้เหตุผล (reasoning effort) ได้ตั้งแต่ low ถึง xhigh โดยไม่สามารถปิดฟังก์ชันการใช้เหตุผลได้ แต่เลือกใช้ระดับ "low" ได้หากต้องการประหยัด tokens ในโจทย์ที่ง่าย
รูปภาพและข้อความ
ตัวประมวลผลจะขยายเครื่องหมายรูปภาพเป็น patch tokens ตามความเหมาะสม และสามารถจัดการรูปภาพหลายรูปใน prompt เดียวกันได้
Video Inference
รองรับวิดีโอพร้อมเสียง โดยสามารถสุ่มตัวอย่างเฟรมและเสียงให้สอดคล้องกัน ค่าเริ่มต้นอยู่ที่ 2 FPS แต่สามารถปรับเพิ่มเพื่อความแม่นยำได้
Audio Inference
รับสัญญาณเสียงดิบ (raw waveform) แบบ mono 24 kHz และแปลงเป็น tokens โดยอัตโนมัติผ่าน apply_chat_template
Tool Calling
รองรับการเรียกใช้เครื่องมือทั้งแบบข้อความและ multimodal โดยใช้ chat template แบบ Harmony ซึ่งสามารถตรวจสอบกระบวนการใช้เหตุผลผ่านช่องทาง to=self ได้
Llama.cpp
รองรับการรันผ่าน llama.cpp พร้อม quants หลายรูปแบบ เช่น Q2_K ที่รันได้ 18 tokens/s บน Mac M3 Ultra โดยใช้พื้นที่ 304 GB ไฟล์ quants พร้อมใช้งานที่นี่
SGLang
รองรับการรันข้าม GPU GB300 สี่ตัวด้วย NVFP4 โดยมี OpenAI-compatible API ที่แยกส่วน reasoning_content ออกจากคำตอบจริง
vLLM
รองรับ checkpoint แบบ NVFP4 บน GPU ซีรีส์ Blackwell โดยกำหนด context ได้ที่ 128K tokens ผ่านปลั๊กอินที่รองรับ
MLX
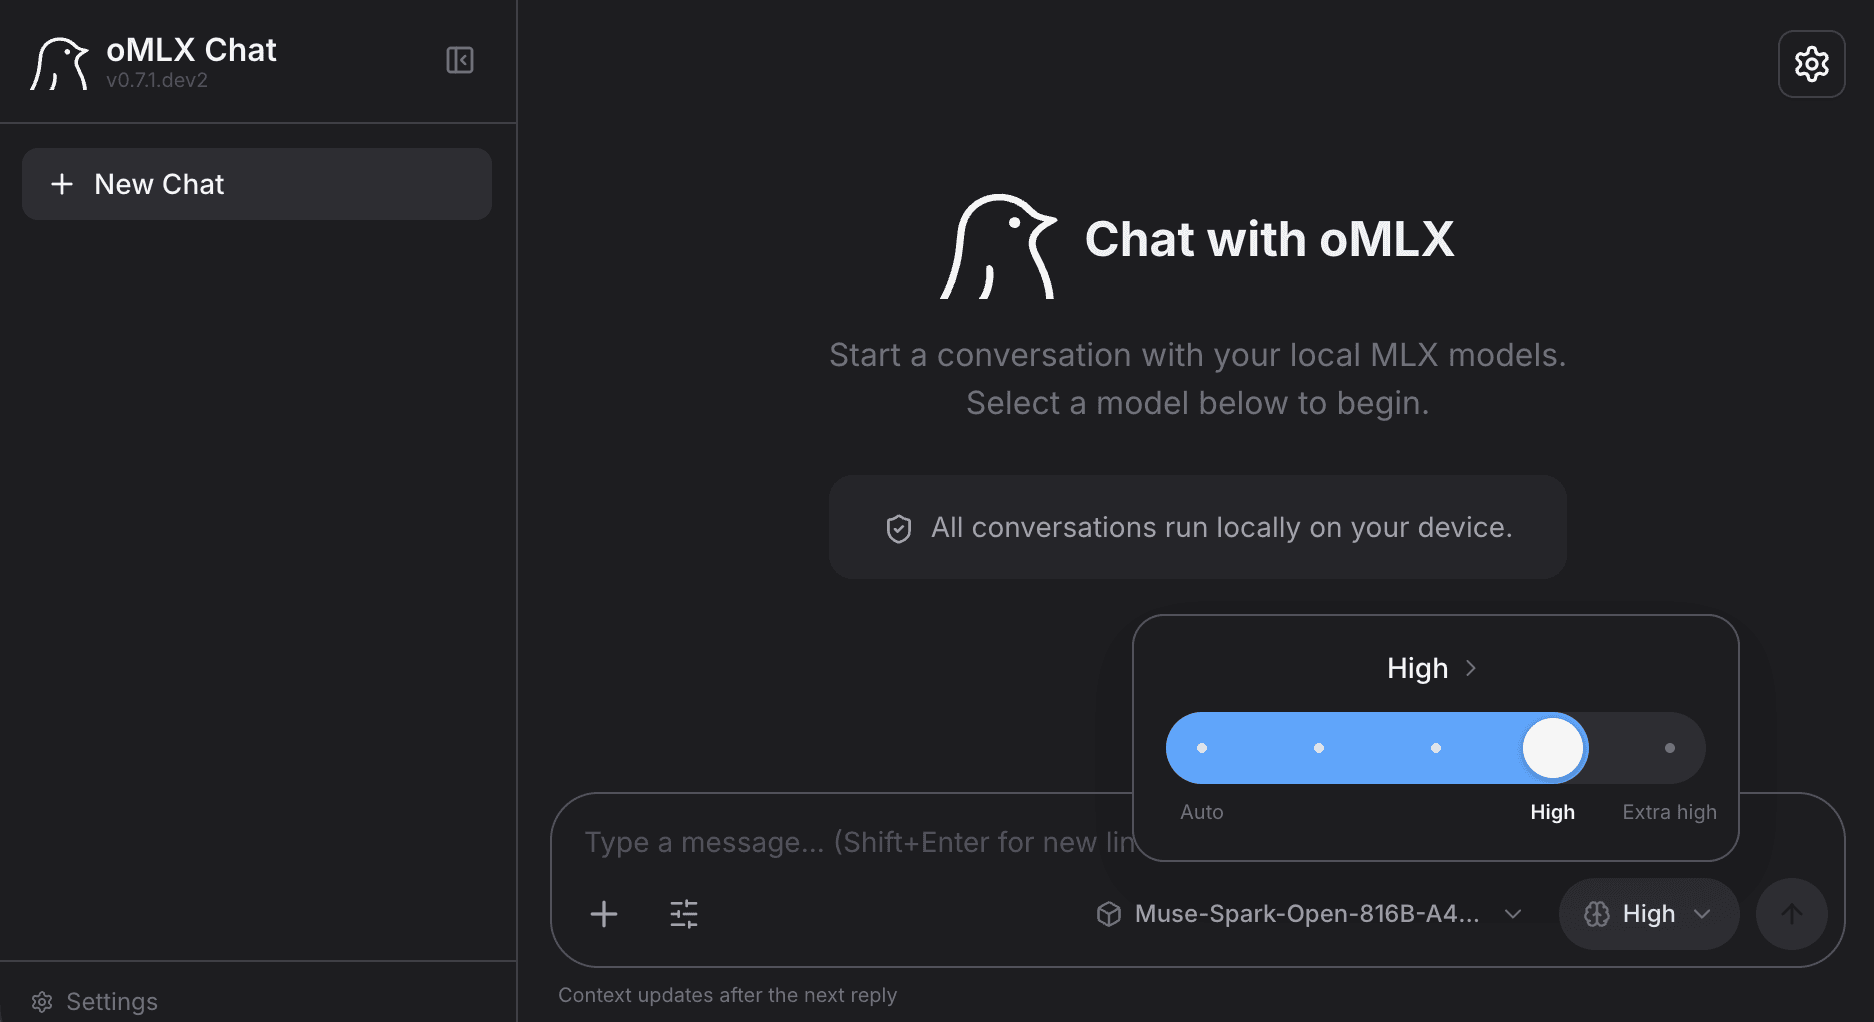
Muse Spark Open พร้อมใช้งานบน oMLX และ mlx-lm โดยมี quants แบบ 3-bit และ 4-bit ที่ปรับแต่งประสิทธิภาพมาแล้ว ซึ่งการรันแบบ 3-bit บน M3 Ultra สามารถทำความเร็วในช่วง generation ได้ที่ 21 tok/s
การ Deploy ด้วย Inference Endpoints
สามารถ deploy รุ่น NVFP4 บน NVIDIA RTX Pro 6000 จำนวน 8 ตัว หรือใช้ NVIDIA H200 เพื่อรองรับ context 1M tokens ผ่านการคลิกเพียงครั้งเดียวบน Hugging Face
การ Fine-tuning ด้วย TRL
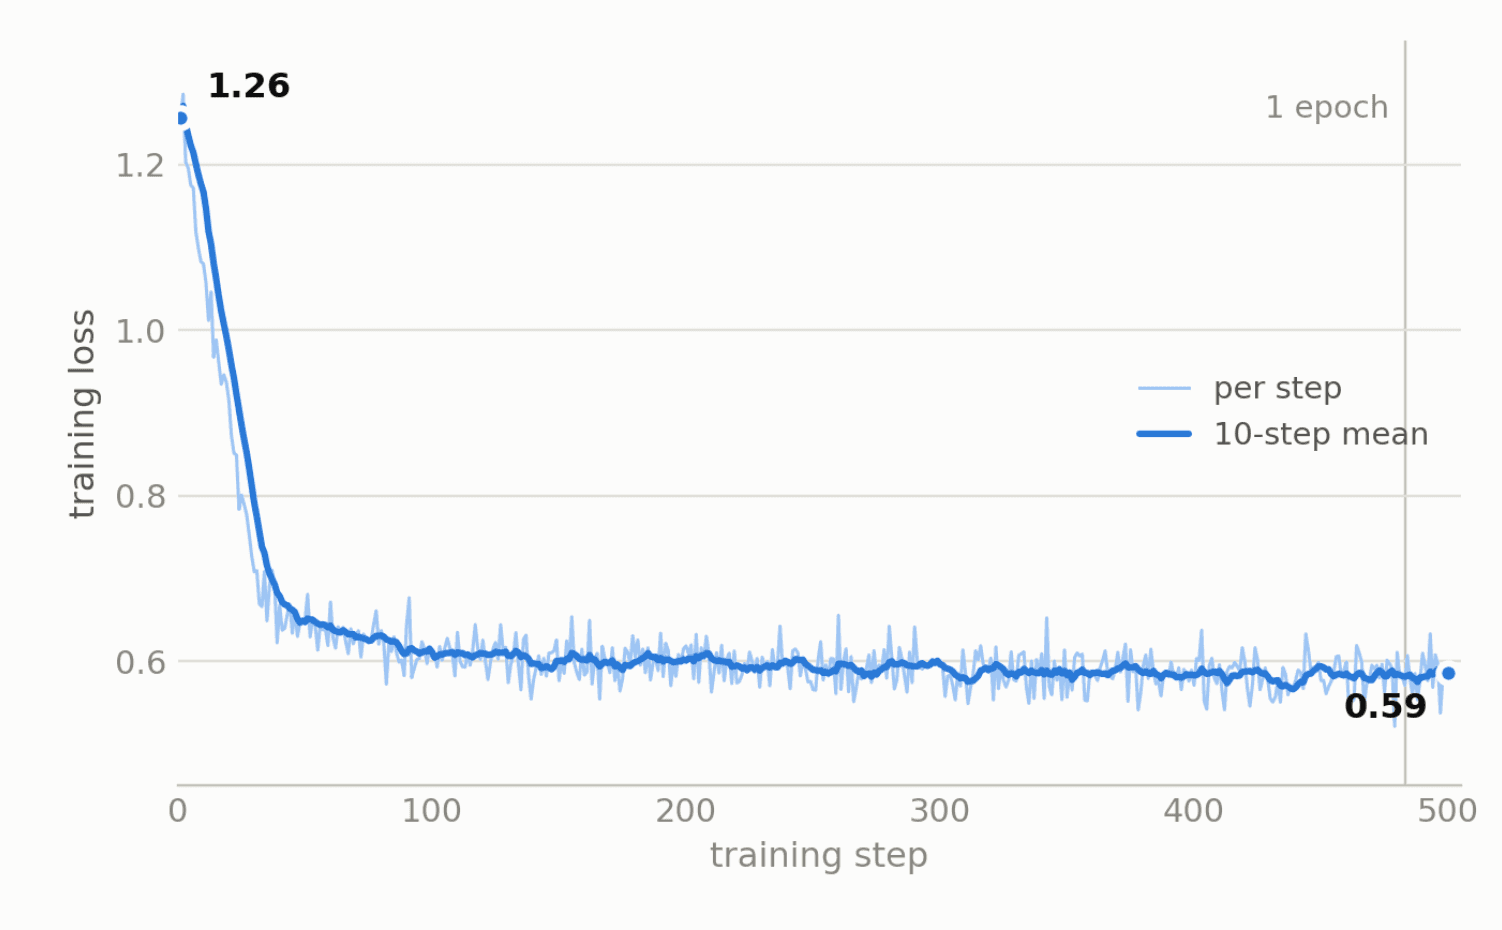
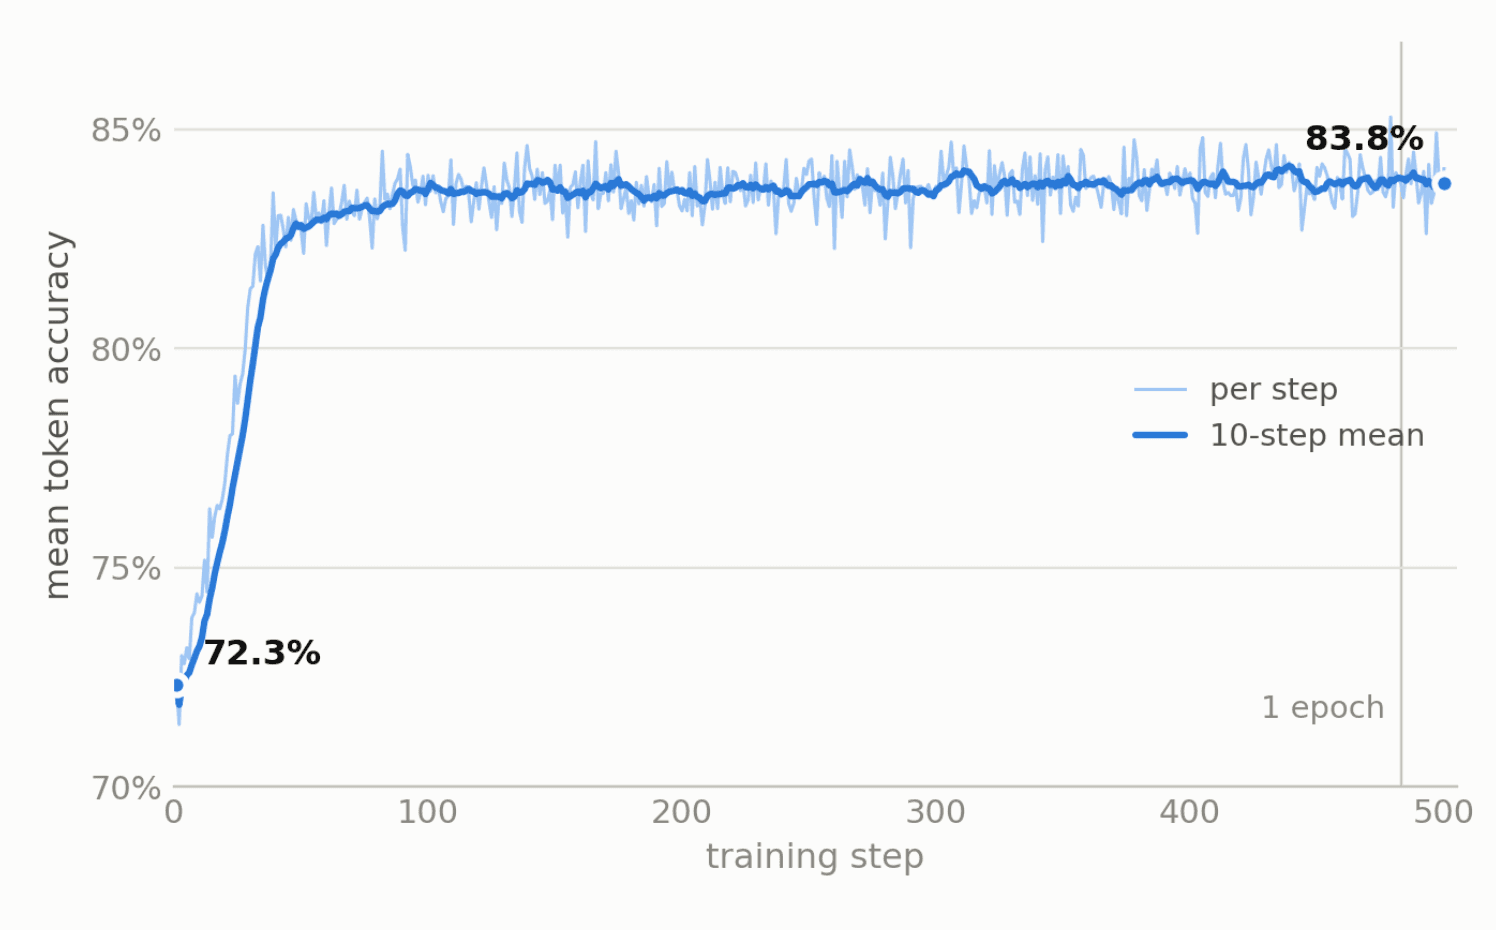
นักพัฒนาสามารถ fine-tune โมเดลขนาด 816B ได้โดยใช้ SFTTrainer ของ TRL ผ่านเทคนิค LoRA บนชั้น attention ในขณะที่แช่แข็งส่วน experts ไว้ ซึ่งการทดสอบบน GPU H100 จำนวน 64 ตัว พบว่าค่าความแม่นยำเพิ่มขึ้นจาก 72% เป็น 84% ภายในเวลา 2 ชั่วโมง
เดโม
เครื่องมือสร้าง 3D Asset
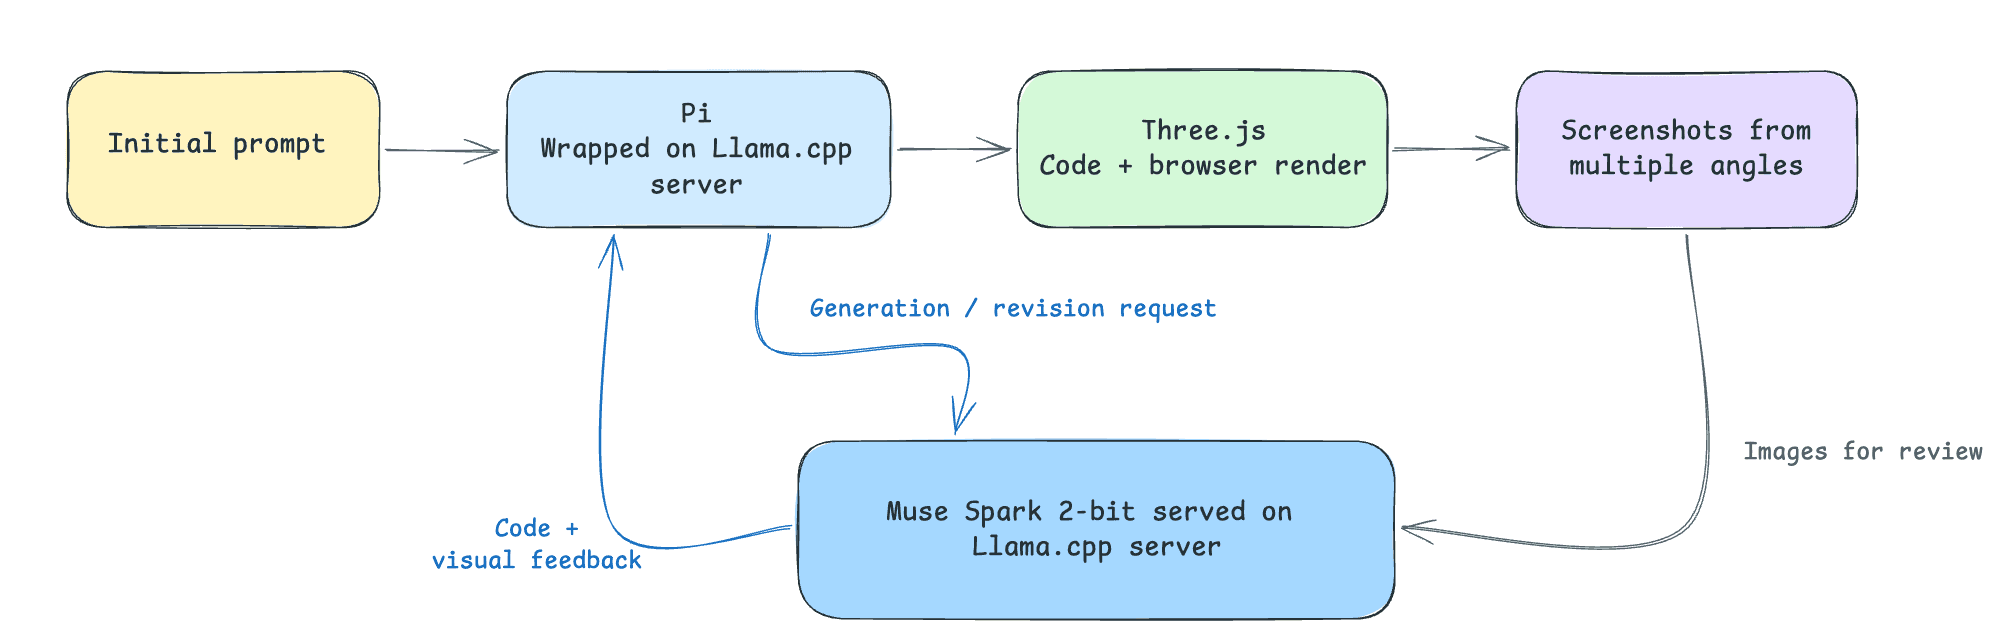
ทดสอบการทำงานร่วมกับ Pi coding agent เพื่อสร้าง 3D assets ใน Three.js โดยโมเดลจะรับข้อมูลภาพหน้าจอเพื่อนำมาแก้ไขโค้ดและปรับปรุงผลลัพธ์อย่างต่อเนื่อง
ปฏิสัมพันธ์กับเบราว์เซอร์ผ่าน OpenEnv
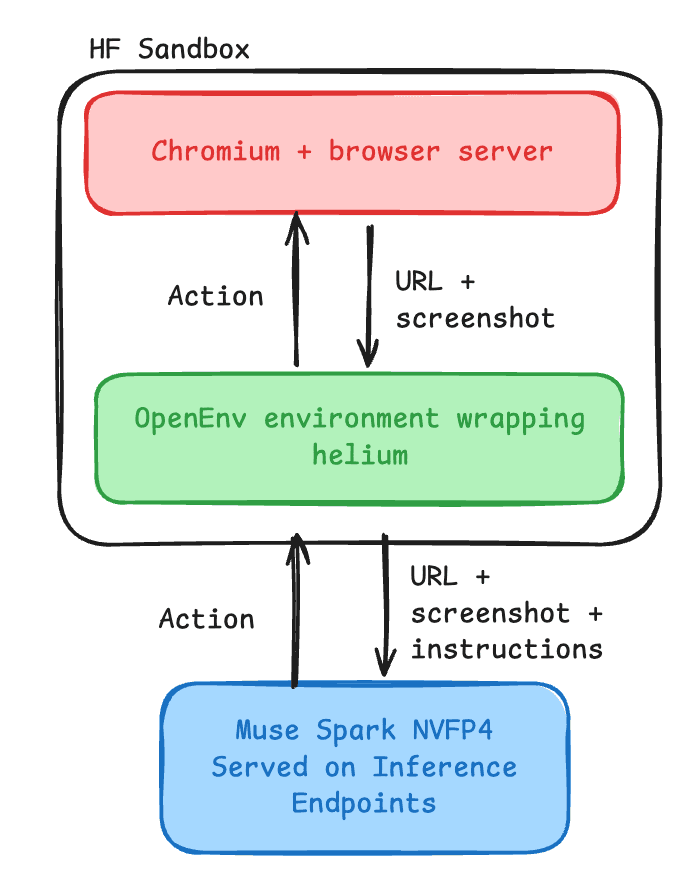
สร้าง Browser Agent แบบ multimodal ที่มองเห็นภาพหน้าจอและสั่งการผ่าน web driver ในสภาพแวดล้อม sandbox เพื่อทำงานต่างๆ โดยไม่ต้องใช้ข้อมูล HTML
โทรหาเบราว์เซอร์ของคุณ
เดโมที่รวบรวมความสามารถทั้งเสียงและภาพเข้าด้วยกัน เพื่อให้เอเจนต์ค้นหาผลิตภัณฑ์บน Amazon ตามคำอธิบายที่ได้รับทางเสียง
บทสรุป
Muse Spark Open เป็นโมเดล open-weight ระดับเรือธงที่มีความสามารถรอบด้าน พร้อมใช้งานแล้วทั้งในรูปแบบ BF16 และ NVFP4 รวมถึงเวอร์ชัน quantized สำหรับอุปกรณ์ปลายทาง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร