
GLM-5.3-Flash ปะทะ Qwen3.8-Flash-Next: สองยักษ์ใหญ่ AI จีนกับสถาปัตยกรรมโมเดลที่เหมือนกันโดยไม่ได้นัดหมาย
วงการ AI พบการเปิดตัวโมเดล open-weight ระดับแถวหน้าสองรุ่นที่ห่างกันเพียงวันเดียวในสัปดาห์นี้ เริ่มจาก Z.ai เปิดตัว GLM-5.3-Flash โมเดล MoE แบบ multimodal ขนาด 320B พารามิเตอร์ (ใช้งานจริง 18B) ตามมาด้วย ทีม Qwen ของ Alibaba ที่เปิดตัว Qwen3.8-Flash-Next ขนาด 125B (ใช้งานจริง 6B) ซึ่งเป็นการพรีวิวเทคโนโลยีที่จะใช้ใน Qwen4 ต่อไป
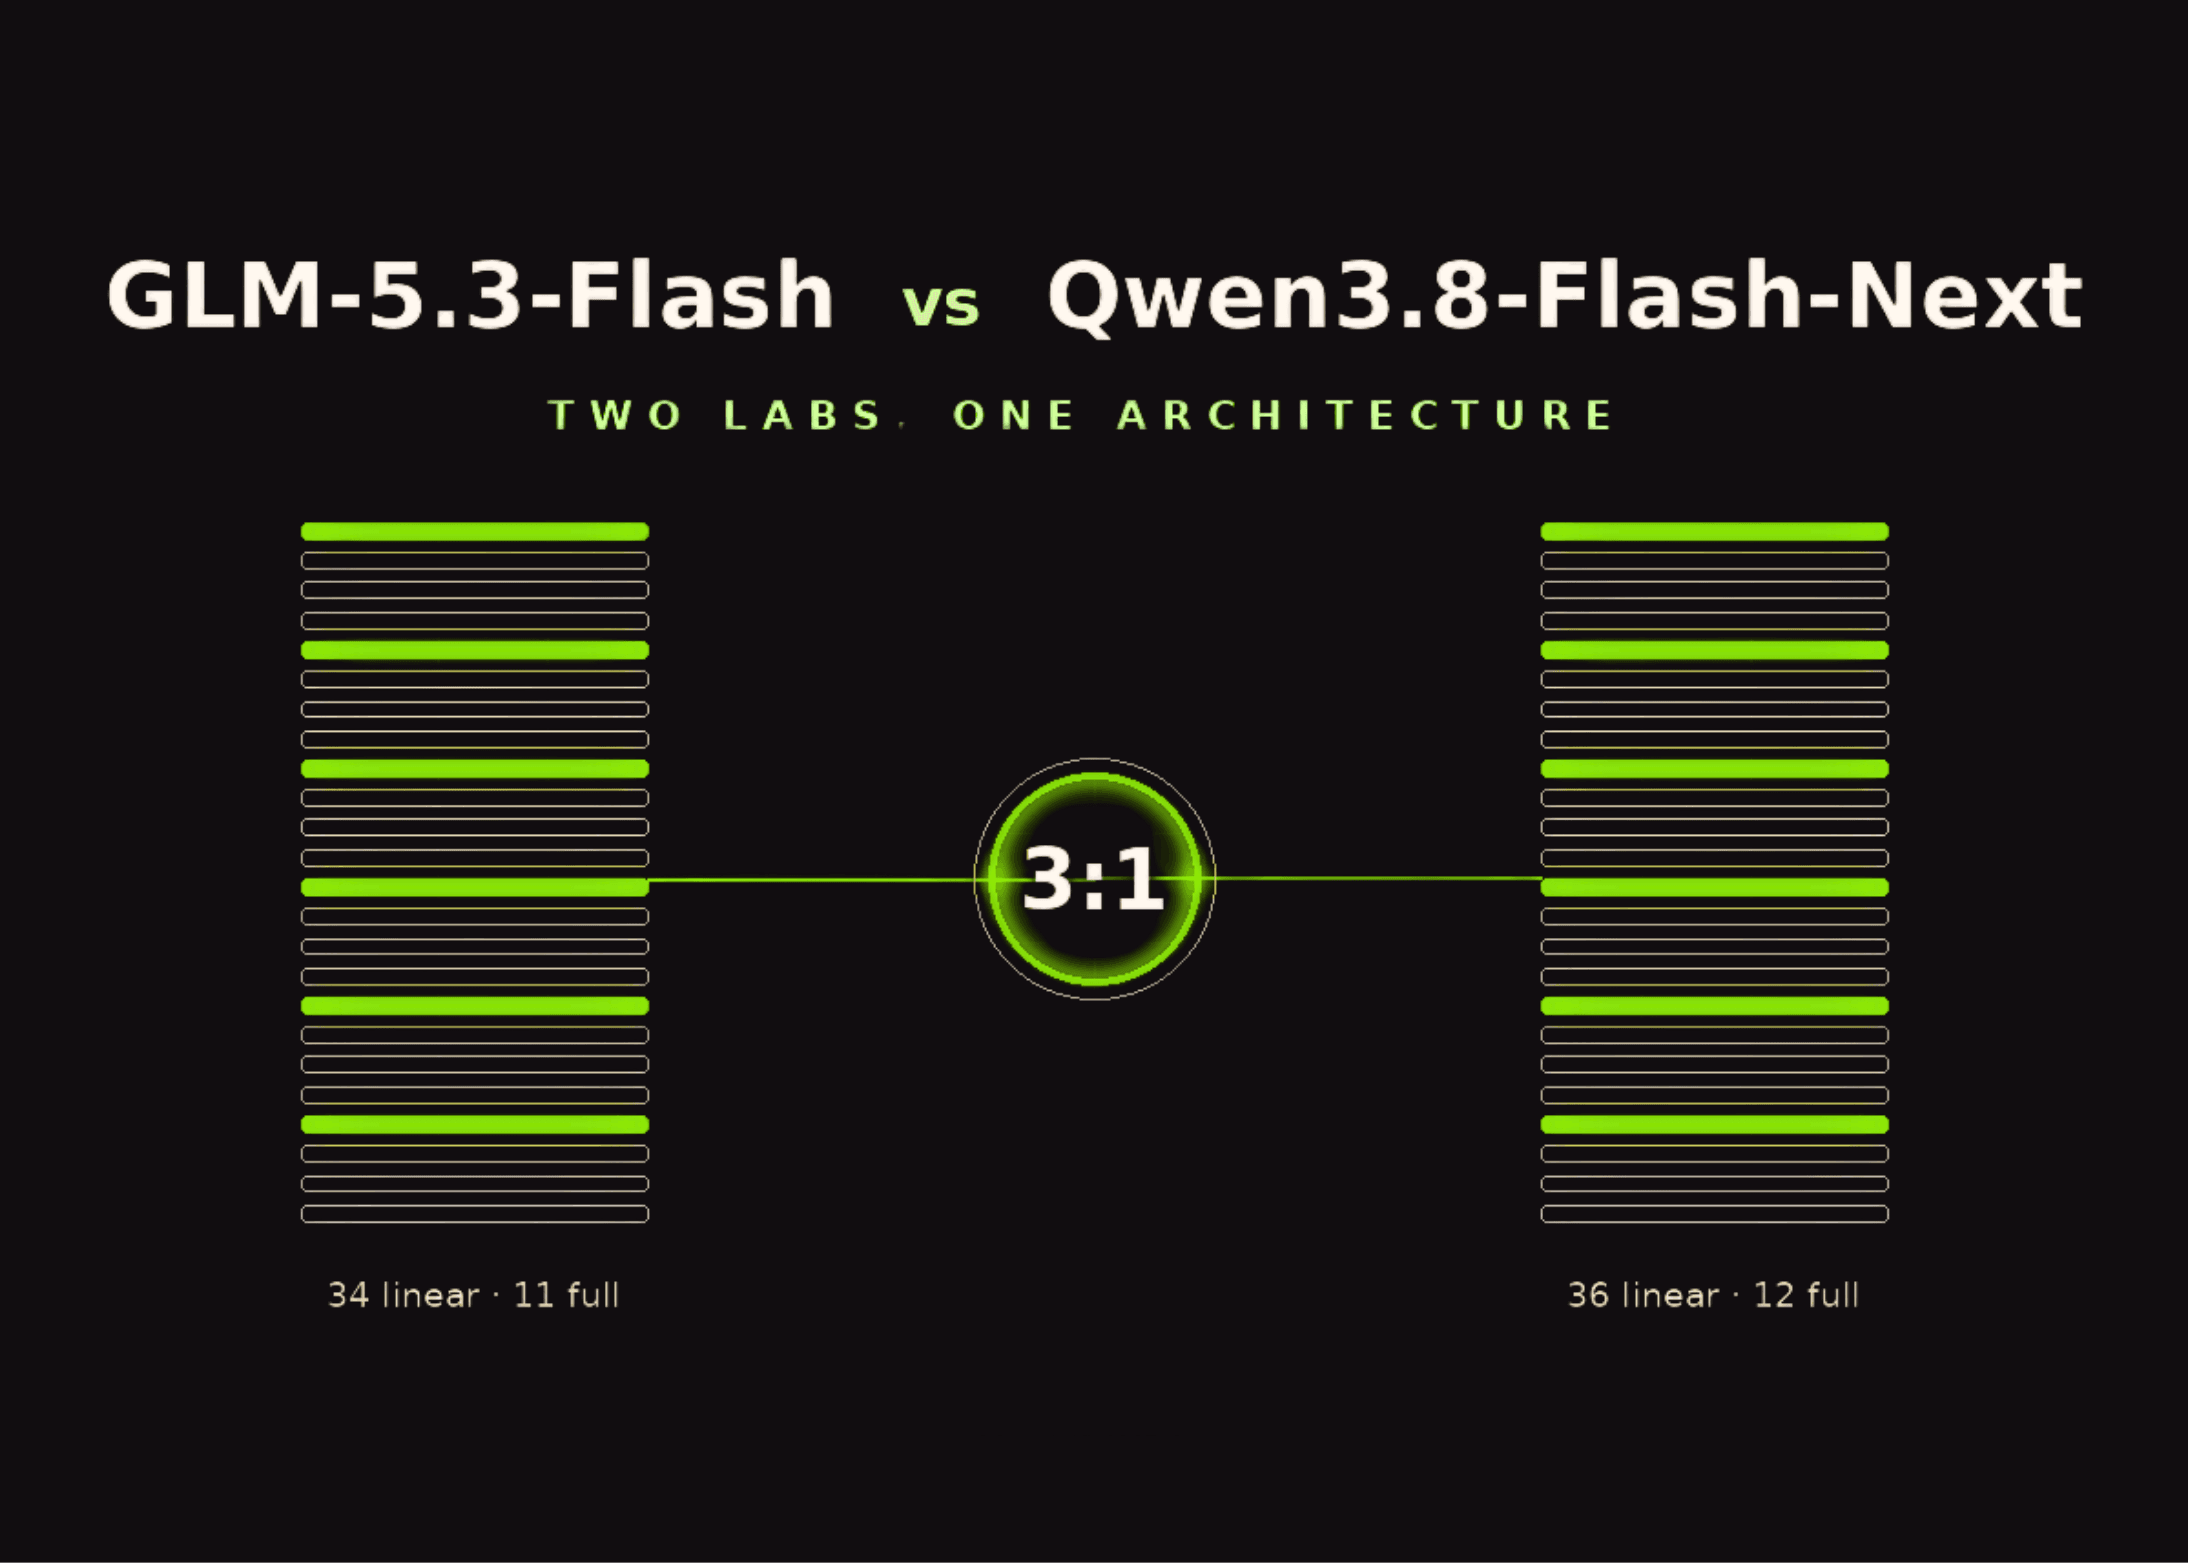
สิ่งที่น่าสนใจคือแม้ทั้งสองทีมจะพัฒนาแยกกันอย่างอิสระ แต่โครงสร้างทางเทคนิคกลับเหมือนเป็นสำเนาของกันและกัน ทั้งคู่เลือกใช้ไฮบริดระหว่าง Linear และ Full Attention ในอัตราส่วน 3:1 พร้อมตัวทำดัชนีแบบบีบอัด (Compressed Indexers) ที่จำกัดไว้ 2048 token รวมถึงการขยาย Residual Stream เป็น 4 กิ่งแบบ Gated และฝึกด้วยตัวเพิ่มประสิทธิภาพ Muon เหมือนกัน บทความนี้จะเจาะลึกถึงสูตรสำเร็จที่ทั้งสองค่ายใช้ร่วมกัน และจุดที่พวกเขามีความเห็นต่างกัน
สรุปการเปิดตัวทั้งสองโมเดลแบบย่อ
GLM-5.3-Flash คือโมเดล multimodal โดยกำเนิดรุ่นแรกในซีรีส์ GLM-5 เปิดตัวภายใต้ ใบอนุญาต MIT บน Hugging Face โดยก่อนหน้านี้ Z.ai ได้ทดสอบแบบนิรนามในชื่อ Ox Alpha บน OpenRouter ซึ่งได้รับความนิยมสูงสุดในสัปดาห์นั้น โมเดลนี้ฝึกบนข้อมูล 30T token รองรับบริบท 1M token และมีประสิทธิภาพใกล้เคียงกับ Claude Opus 4.8 ในงานเขียนโค้ดและ Agentic Benchmark ในราคาที่ถูกกว่าเดิมถึง 10 เท่า
Qwen3.8-Flash-Next ทำหน้าที่เป็นตัวพรีวิวสถาปัตยกรรมรุ่นถัดไปของตระกูล Qwen โดยใน model card ระบุว่าเป็นโมเดลหลักขนาด 125B เสริมด้วย n-gram embedding อีก 51B รองรับบริบทเริ่มต้น 262,144 token และขยายได้ถึง 1M ด้วย YaRN ทีม Qwen เผยว่าการฝึกโมเดลนี้ใช้พลังงานประมวลผลเพียง 1 ใน 9 ของ Qwen3.7-Plus เท่านั้น
จุดบรรจบที่ 1: สามในสี่ของเลเยอร์ Attention เป็นแบบ Linear
ทั้งสองโมเดลลงเอยที่อัตราส่วน 3:1 ของเลเยอร์ Attention เหมือนกัน โดย GLM-5.3-Flash ใช้เลเยอร์ซ้อนกัน 45 เลเยอร์ แบ่งเป็น linear-attention 34 เลเยอร์ และ full-attention 11 เลเยอร์ ขณะที่ Qwen3.8-Flash-Next ใช้ 48 เลเยอร์ แบ่งเป็น Gated DeltaNet 3 เลเยอร์สลับกับ Qwen Sparse Attention 1 เลเยอร์
เลเยอร์แบบ Linear ช่วยประหยัดทรัพยากรโดยบีบอัดข้อมูลลงในสถานะคงที่ (Recurrent State) ทำให้การประมวลผลต่อ token สม่ำเสมอไม่ว่าบริบทจะยาวเพียงใด โดย GLM ใช้ Kimi Delta Attention (KDA) ที่ทำ Gating รายช่องสัญญาณ ส่วน Qwen ใช้ Gated DeltaNet (GDN) ที่ทำ Gating รายหัว แม้รายละเอียดจะต่างกันแต่ให้ผลลัพธ์ในทิศทางเดียวกัน
จุดบรรจบที่ 2: บีบอัด 4 เท่า และจำกัดไว้ที่ 2048 Token
ทั้งสองค่ายติดตั้งตัวทำดัชนี (Indexer) ขนาดเล็กเพื่อคัดเลือกเฉพาะข้อมูลสำคัญจากประวัติการสนทนา โดย GLM ใช้ IndexPool เพื่อบีบอัดเวกเตอร์คีย์ 4 ตัวเหลือ 1 ตัวก่อนให้คะแนน ขณะที่ Qwen ใช้ความละเอียดระดับ Micro-block บีบอัดบล็อกขนาด 4 token และเลือกเก็บไว้ 512 บล็อก ซึ่งเท่ากับ 2048 token พอดี
การออกแบบนี้ช่วยลดภาระการประมวลผลได้อย่างมหาศาล Z.ai รายงานว่าสถาปัตยกรรม Flash ช่วยลดการประมวลผล Attention ลง 3 เท่า และลดขนาด KV Cache ลง 4.4 เท่า ส่วน Qwen ระบุว่าช่วยให้การประมวลผล Prefill เร็วขึ้นสูงสุด 7.6 เท่า เมื่อเทียบกับ Full Attention ปกติ
จุดบรรจบที่ 3: สี่ Residual Stream แทนที่จะเป็นหนึ่ง
การทิ้งมาตรฐาน Residual Stream เดี่ยวที่ใช้กันมาตั้งแต่ปี 2017 คืออีกหนึ่งความเหมือน โดยทั้งคู่ขยายออกเป็น 4 กิ่งขนานกันและมี Gate ควบคุมการไหลของข้อมูล GLM ใช้โครงสร้าง Manifold-Constrained Hyper-Connections (mHC) จาก DeepSeek ขณะที่ Qwen พัฒนา Gated Residual ของตนเองขึ้นมา ซึ่งช่วยลดการเข้าถึงหน่วยความจำและจัดการกับค่า Activation ที่ผิดปกติได้ดีขึ้น
จุดบรรจบที่ 4: ฝึกด้วย Muon และแยก Fused Matrices
ในขั้นตอนการฝึก ทั้งคู่ใช้ตัวเพิ่มประสิทธิภาพ Muon และใช้เทคนิคแยก Fused Projection Matrices ออกเป็นตัวแปรอิสระก่อนทำ Orthogonalization โดย Qwen ยังได้ปรับปรุงกฎการปรับขนาด (Scaling Laws) และยกเลิกกระบวนการ Batch-size Warmup เนื่องจากพบว่าไม่ได้ช่วยให้ผลลัพธ์ดีขึ้นแต่กลับทำให้ต้องใช้ขั้นตอนการประมวลผลเพิ่มขึ้น
จุดที่เห็นต่าง: การเข้ารหัสตำแหน่ง (Positional Encoding)
ความแตกต่างที่ชัดเจนที่สุดคือการจัดการ Rotary Position Embeddings (RoPE) โดย GLM-5.3-Flash เลือกตัดออกทั้งหมด (NoPE) โดยเชื่อว่าข้อมูลตำแหน่งจะไหลผ่านเลเยอร์ Linear เอง แต่ทาง Qwen เลือกคง RoPE ไว้เนื่องจากพบว่าในขั้นตอน Post-training โมเดลเวอร์ชัน NoPE มักจะมีปัญหาล้มเหลวในการหยุดสร้างข้อความ
มุมมองจากผู้คัดค้าน: บทเรียนจาก MiniMax
แม้เทรนด์ของค่ายยักษ์ใหญ่จีนอย่าง Z.ai, Qwen, DeepSeek และ Kimi จะมุ่งไปทางไฮบริด Linear 3:1 แต่ MiniMax กลับเห็นต่างออกไป จากการทดสอบในระดับสเกลใหญ่พบว่า Linear Attention ทำลายความสามารถในการใช้เหตุผลแบบหลายขั้นตอน (Multi-hop Reasoning) ทำให้โมเดลรุ่น M2 และ M3 ของ MiniMax ยังคงยืนหยัดใช้เพียง Sparse Softmax Attention โดยไม่มีเลเยอร์ Linear เลยแม้แต่เลเยอร์เดียว
ประเด็นสำคัญ:
- GLM-5.3-Flash และ Qwen3.8-Flash-Next ใช้อัตราส่วน Linear-to-full Attention ที่ 3:1 เหมือนกัน
- ทั้งคู่จำกัดงบประมาณ Sparse Attention ไว้ที่ 2048 token ตามแนวทางของ DeepSeek
- มีการเปลี่ยนจาก 1 Residual Stream เป็น 4 กิ่งแบบ Gated เพื่อประสิทธิภาพที่ดีขึ้น
- ข้อโต้แย้งหลักยังคงอยู่ที่การใช้ Linear Attention ซึ่ง MiniMax เชื่อว่าส่งผลเสียต่อการใช้เหตุผลในบริบทที่ซับซ้อน
แหล่งที่มา: GLM-5.3-Flash บน Hugging Face, เอกสาร Z.ai GLM-5.3-Flash, รายงานทางเทคนิค GLM-5 (arXiv:2602.15763), Qwen3.8-Flash-Next บน Hugging Face, Qwen3.8-Flash-Next GitHub, บล็อกทางเทคนิคของ NVIDIA, รายงาน MiniMax-M2 (arXiv:2605.26494), และ MiniMax Sparse Attention (arXiv:2606.13392)
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร