
Prime Intellect เปิดตัว Prime Mega MoE เร่งการเทรน AI เร็วขึ้นสูงสุด 55%
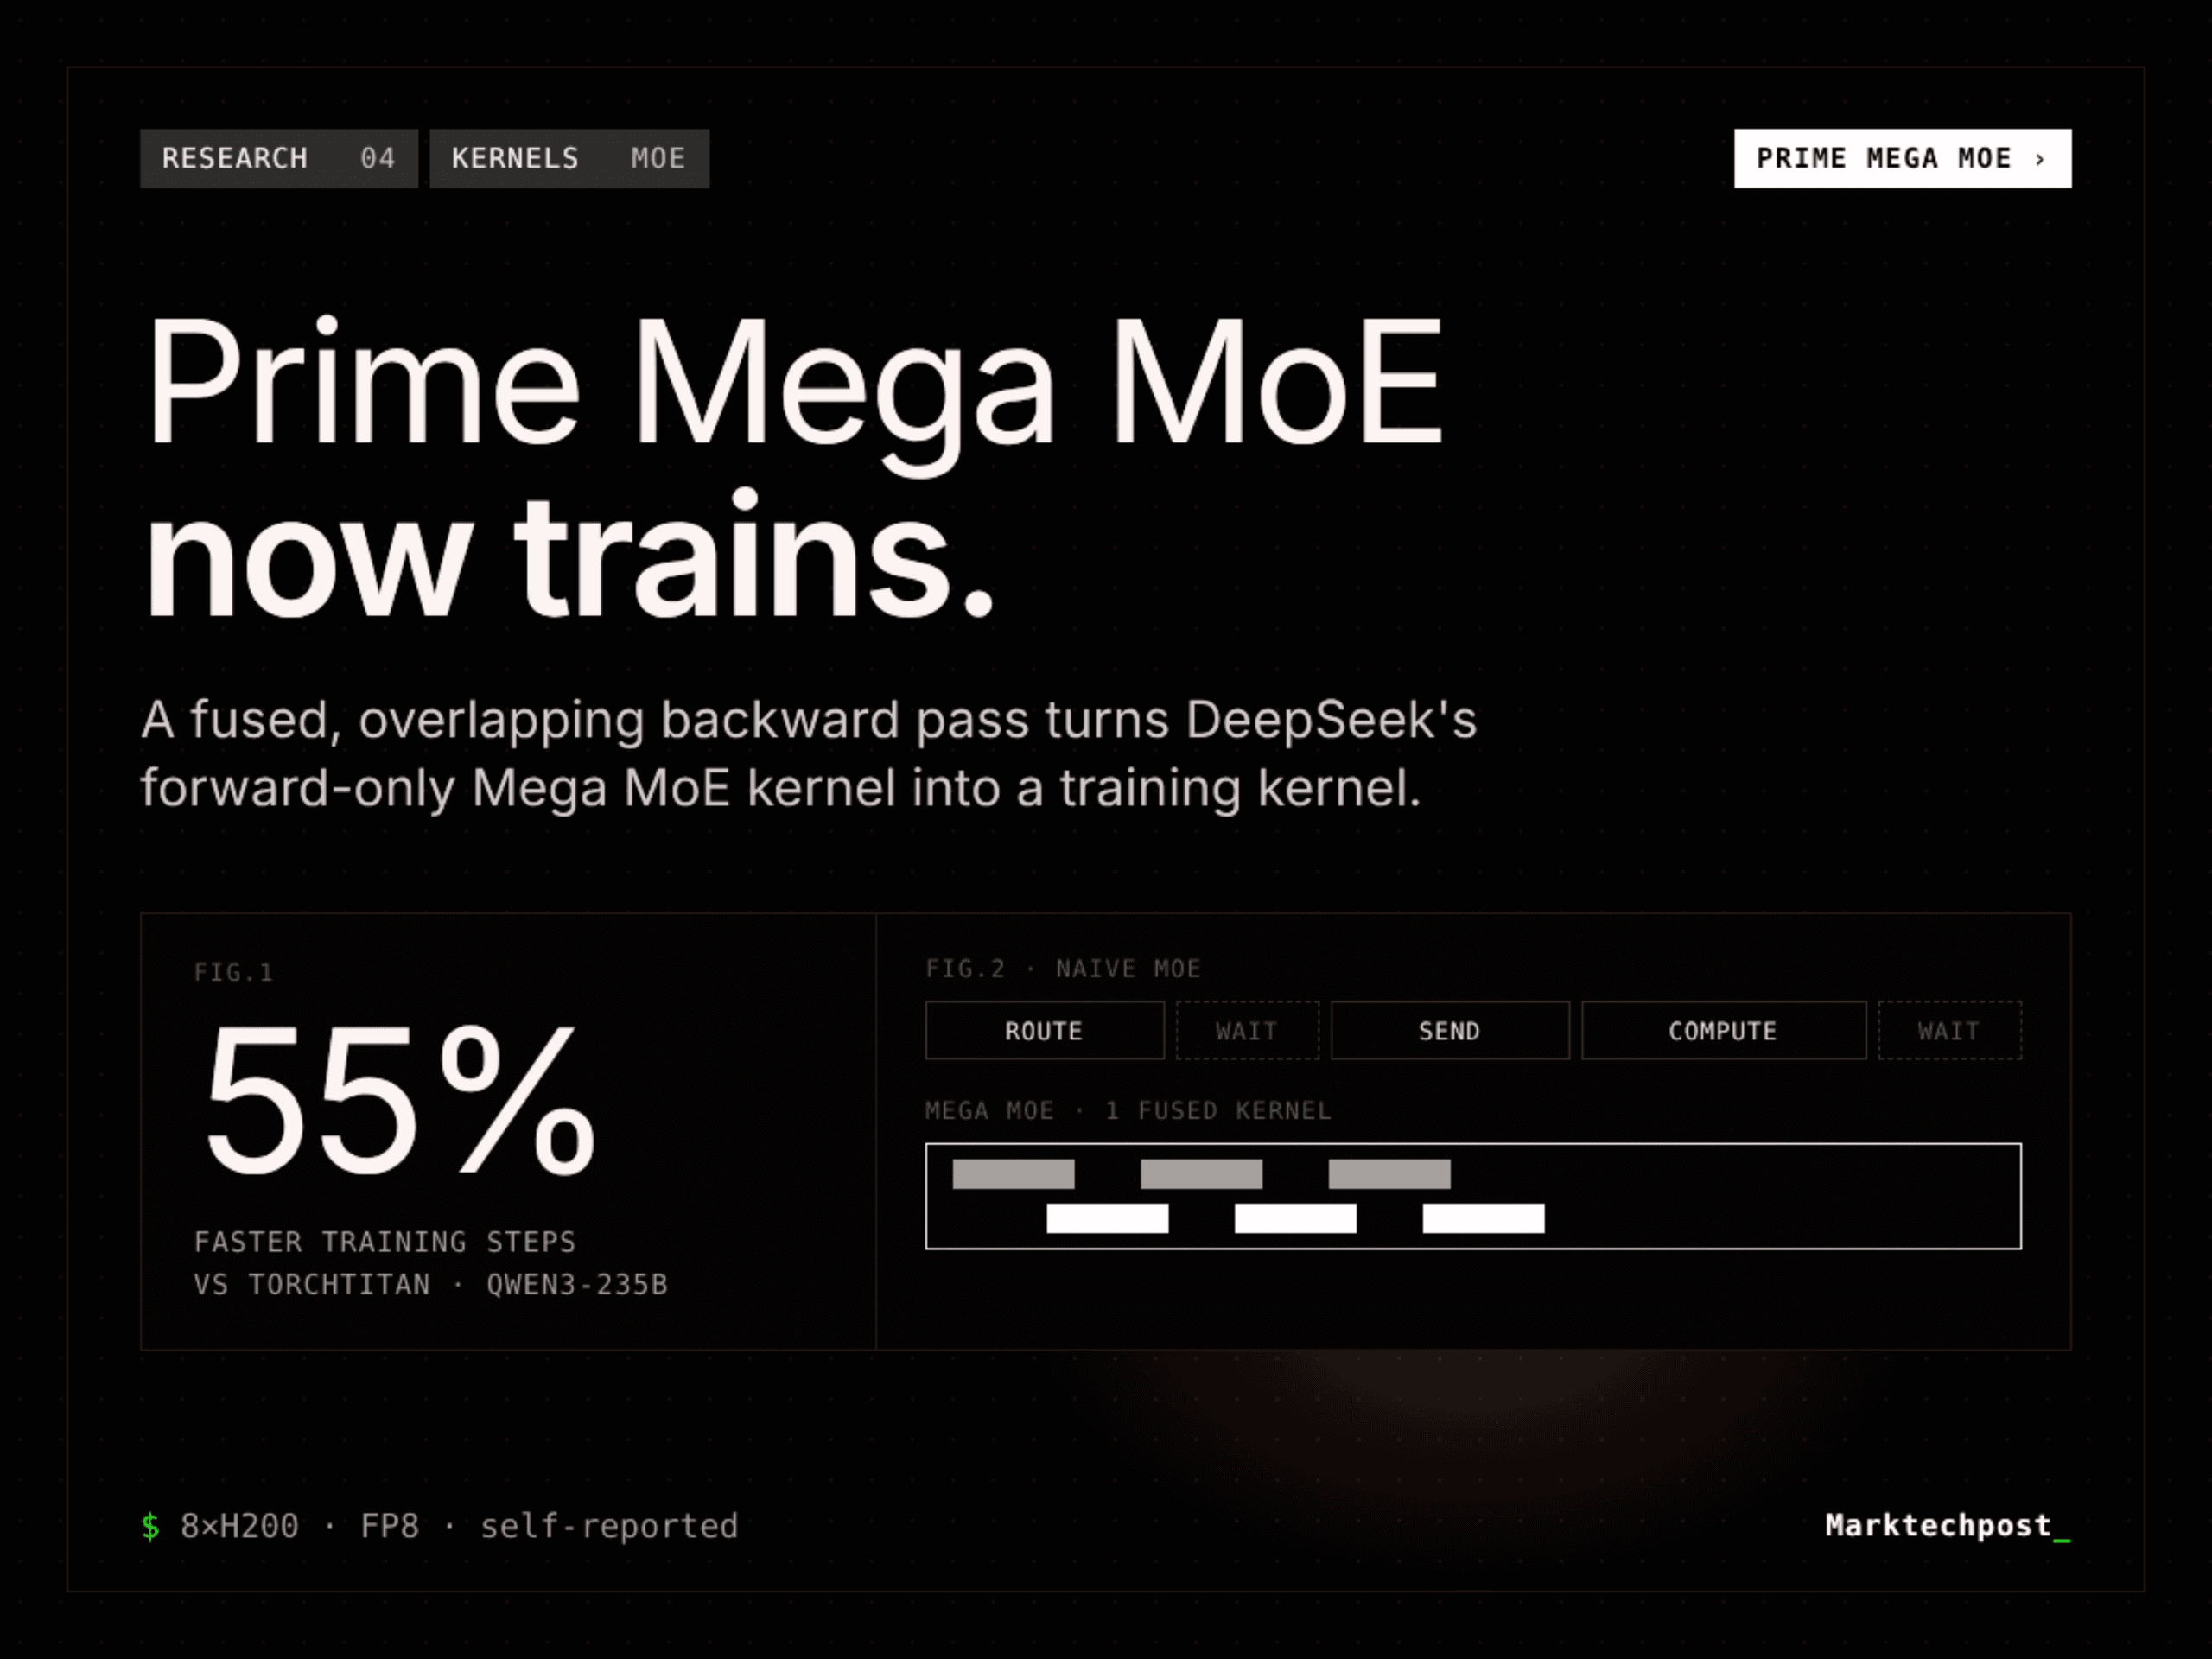
Prime Intellect เปิดตัว Prime Mega MoE ซึ่งเป็นส่วนขยายด้านการเทรนของ fused Mega MoE kernel จาก DeepSeek โดยเดิมที kernel ของ DeepSeek รองรับเพียงการทำ forward pass เท่านั้น แต่ทาง Prime Intellect ได้พัฒนาและเพิ่ม backward pass แบบ overlapping ที่มีความรวดเร็วเข้าไป
การอัปเกรดครั้งนี้ส่งผลให้ fused kernel ดังกล่าวสามารถใช้งานในการเทรนได้สมบูรณ์ ไม่ใช่แค่การทำ inference เพียงอย่างเดียว ในตัวเทรนเนอร์ prime-rl ของบริษัทพบว่าขั้นตอนการเทรนเต็มรูปแบบบนโมเดล Qwen3 MoE รันได้เร็วขึ้นสูงสุด 34% และเมื่อเทียบกับ TorchTitan ประสิทธิภาพจะเพิ่มขึ้นถึง 55% ซึ่งช่วยลดชั่วโมงการใช้ GPU สำหรับทีมที่เทรนโมเดล mixture-of-experts (MoE) โดยตรง
TL;DR
- ขนาด: เป็น GPU kernel ไม่ใช่โมเดล ทดสอบกับ Qwen3-30B-A3B และ Qwen3-235B-A22B (128 experts, top-8 routing)
- รันบน: NVIDIA Hopper (blockwise FP8) และ Blackwell (MXFP8) GPUs รวมถึง BF16 บนทั้งสองสถาปัตยกรรม ตัวเลขที่เผยแพร่ใช้โหนด 8×H200 จำนวน 32 ถึง 128 GPU
- ประสิทธิภาพ: ขั้นตอนการเทรนเต็มรูปแบบเร็วขึ้น 32% ถึง 34% เมื่อเทียบกับ prime-rl baseline และเร็วขึ้น 48% ถึง 55% เมื่อเทียบกับ TorchTitan
- ดีที่สุด: forward pass เร็วขึ้น 3.11 เท่าบนเลเยอร์ MoE ของ Qwen3-30B-A3B (จาก 12.0 ms เหลือ 3.9 ms)
- ต่ำสุด: backward pass เร็วขึ้น 1.24 เท่าบนเลเยอร์ MoE ของ Qwen3-235B-A22B (จาก 30.5 ms เหลือ 24.6 ms)
Prime Mega MoE คืออะไร?
Prime Mega MoE คือ fused, overlapping MoE kernel สำหรับการเทรนจาก Prime Intellect โดยต่อยอดมาจาก Mega MoE kernel ในไลบรารีโอเพนซอร์ส DeepGEMM ของ DeepSeek
ทำไมการเทรน MoE ถึงติดคอขวดที่การสื่อสาร (Communication-bound)?
ในโมเดล MoE แต่ละ token จะถูกส่งไปยังกลุ่มผู้เชี่ยวชาญ (experts) ขนาดเล็กซึ่งกระจายอยู่บน GPU คนละตัวกัน ทำให้ทุกเลเยอร์ต้องส่ง token ออกไป คำนวณ และส่งผลลัพธ์กลับมาทั้งในส่วน forward pass และ backward pass
ในการตั้งค่ามาตรฐาน การทำงานเหล่านี้จะเป็นการดำเนินการที่แยกจากกัน โดย GPU จะต้องจัดเรียง token และรอที่ transport layer ก่อนจะคำนวณและส่งผลคืน ซึ่งช่วงเวลาการรอเหล่านั้นคือเวลาที่ GPU ถูกปล่อยว่าง (idle) โดยเปล่าประโยชน์
Fused kernel ทำงานอย่างไร?
Mega MoE ของ DeepSeek ที่เพิ่มเข้าไปใน DeepGEMM เมื่อเดือนเมษายน 2026 ได้เปลี่ยนห่วงโซ่การทำงานเดิมด้วยการเรียกใช้ kernel เพียงครั้งเดียว โดยทำการฟิวส์ (fuse) ทั้ง expert-parallel dispatch, expert linear layers 2 ชั้น, SwiGLU และการ combine เข้าด้วยกัน
ในขณะที่ token กลุ่มหนึ่งกำลังถูกส่งผ่าน kernel ระบบจะทำการคำนวณกลุ่มที่มาถึงแล้วไปพร้อมกัน และข้ามการสร้าง intermediate tensors โดยใช้ scratch buffers บน GPU เท่านั้น อย่างไรก็ตาม เดิมทีมันรองรับเพียงการทำงานส่วน forward เท่านั้น Prime Intellect จึงได้เขียน backward kernel ที่เป็นแบบ overlapping เพิ่มเติม โดยรองรับประเภทข้อมูล BF16, MXFP8 (เฉพาะ Blackwell) และ blockwise FP8 (เฉพาะ Hopper)
นอกจากนี้ใน prime-rl ยังมีโหมด fp8_bwd ให้เลือกใช้งาน ซึ่งจะใช้ BF16 สำหรับ forward และใช้ FP8 สำหรับ backward เพื่อประสิทธิภาพสูงสุด
Prime Mega MoE เร็วแค่ไหน?
ข้อมูลรายงานโดย Prime Intellect ระบุว่าการเทรนใช้โหนด 8×H200, FP8 ความยาว sequence 16,384 token และใช้ activation checkpointing เต็มรูปแบบ โดยผลลัพธ์เป็นค่าเฉลี่ยของขั้นตอนที่ 6 ถึง 20
ขั้นตอนการเทรนเต็มรูปแบบ, วินาที (ยิ่งน้อยยิ่งดี):
| โมเดล (คลัสเตอร์) | prime-rl baseline | TorchTitan (FP8) | Prime Mega MoE | ประสิทธิภาพที่เพิ่มขึ้นเทียบกับ baseline | ประสิทธิภาพที่เพิ่มขึ้นเทียบกับ TorchTitan |
|---|---|---|---|---|---|
| Qwen3-30B-A3B (32 H200) | 2.78 | 3.07 | 2.08 | 34% | 48% |
| Qwen3-235B-A22B (128 H200) | 12.72 | 14.98 | 9.65 | 32% | 55% |
เมื่อเทียบกับ TorchTitan อัตรา throughput เพิ่มขึ้นจาก 5,337 เป็น 7,886 tokens/s/GPU ในโมเดล 30B และในโมเดล 235B เพิ่มขึ้นจาก 1,094 เป็น 1,697 โดย prime-rl baseline ใช้ torch all-to-all ร่วมกับ DeepGEMM FP8 experts
Single MoE layer, มิลลิวินาที (1 โหนด, 8×H200, EP=8, 128 experts, top-8, random routing):
| เลเยอร์ | Forward | Backward | Full layer (2x fwd + bwd) |
|---|---|---|---|
| Qwen3-30B-A3B | 12.0 ไปเป็น 3.9 (3.11x) | 15.4 ไปเป็น 8.2 (1.87x) | 39.3 ไปเป็น 15.9 (2.47x) |
| Qwen3-235B-A22B | 20.7 ไปเป็น 9.5 (2.17x) | 30.5 ไปเป็น 24.6 (1.24x) | 71.9 ไปเป็น 43.7 (1.64x) |
รูปแบบความเร็วที่ได้นั้นชัดเจน โดยความเร็วในส่วน Forward เพิ่มขึ้นสูงมาก ขณะที่ส่วนของ backward จะเพิ่มขึ้นในสัดส่วนที่น้อยกว่า ตัวเลขหัวข้อข่าวที่ระบุว่า "สูงสุด 3.11 เท่า" จึงหมายถึงเฉพาะส่วน forward pass เท่านั้น
เปรียบเทียบกับตัวเลือก Fused MoE อื่นๆ ได้อย่างไร?
| คุณสมบัติ | Prime Mega MoE | DeepGEMM Mega MoE | TorchTitan + DeepEP | AMD Primus MegaMoE |
|---|---|---|---|---|
| ผู้พัฒนา | Prime Intellect | DeepSeek | PyTorch, Nebius | AMD |
| การเทรน (backward) | ใช่, fused และ overlapping | ไม่, เฉพาะ forward | ใช่ (แยก dispatch kernels) | ใช่ |
| Fused ทั้ง compute และ comms | ใช่ | ใช่ | ไม่ | ใช่ |
| GPUs | Hopper, Blackwell | SM90, SM100 | B200 | MI355X (gfx950) |
| ประเภทข้อมูล | BF16, MXFP8, blockwise FP8 | FP8xFP8, FP8xFP4 | BF16, MXFP8 | BF16, MXFP8 |
| ความเร็วที่เพิ่มขึ้น | สูงสุด 55% เทียบกับ TorchTitan | ไม่เปิดเผย | สูงสุด 41% บน DeepSeek-V3 | ไม่เปิดเผย |
| สัญญาอนุญาต | Apache 2.0 | MIT | BSD-3-Clause | MIT |
ทั้งนี้ ประสิทธิภาพที่เพิ่มขึ้น 41% ของ TorchTitan มาจากการทดสอบในสภาพแวดล้อมที่ต่างกัน (B200, โมเดล 671B) จึงไม่สามารถเปรียบเทียบกับ Prime Mega MoE ได้โดยตรง
นักพัฒนาใช้งานอย่างไร?
Prime Mega MoE ทำหน้าที่เป็น dispatch backend ใน prime-rl โดยตั้งค่า type = "mega_moe" ภายใต้ [trainer.model.moe.dispatch] นักพัฒนาสามารถเลือกความแม่นยำ (precision) ได้ตั้งแต่ bf16, mxfp8, fp8 หรือ fp8_bwd โดยตัว kernel จะมาในรูปของ DeepGEMM wheel ที่บิลด์ไว้ล่วงหน้าจาก prime-kernels เนื่องจากบิลด์มาตรฐานของ DeepGEMM จะไม่มีส่วนประกอบนี้
สรุปสาระสำคัญ
- Prime Mega MoE เพิ่ม backward pass แบบ fused และ overlapping ให้กับ Mega MoE ของ DeepSeek ทำให้การเทรนทำได้รวดเร็วขึ้น
- ขั้นตอนการเทรนเต็มรูปแบบเร็วขึ้นสูงสุด 34% เมื่อเทียบกับ prime-rl baseline และสูงสุด 55% เมื่อเทียบกับ TorchTitan ในโมเดล Qwen3 MoE
- ความเร็วส่วน forward เพิ่มขึ้นก้าวกระโดดถึง 3.11 เท่า ขณะที่ส่วน backward เพิ่มขึ้น 1.24 เท่าในเลเยอร์ขนาดใหญ่
- เปิดให้ใช้งานแล้วใน prime-rl ในฐานะ mega_moe dispatch backend
Asif Razzaq คือ CEO ของ Marktechpost AI Media Inc. วิศวกรและผู้ประกอบการผู้มุ่งมั่นใช้ปัญญาประดิษฐ์เพื่อสังคม เขาเป็นผู้ก่อตั้ง Marktechpost แพลตฟอร์มสื่อ AI ที่นำเสนอข่าวสารเชิงเทคนิคในด้าน machine learning และ deep learning ให้เข้าใจง่าย โดยมียอดเข้าชมกว่า 2 ล้านครั้งต่อเดือน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร