
Infini-AI-Lab เปิดตัว Hermit เฟรมเวิร์ก Open-Source สำหรับ AI Agents
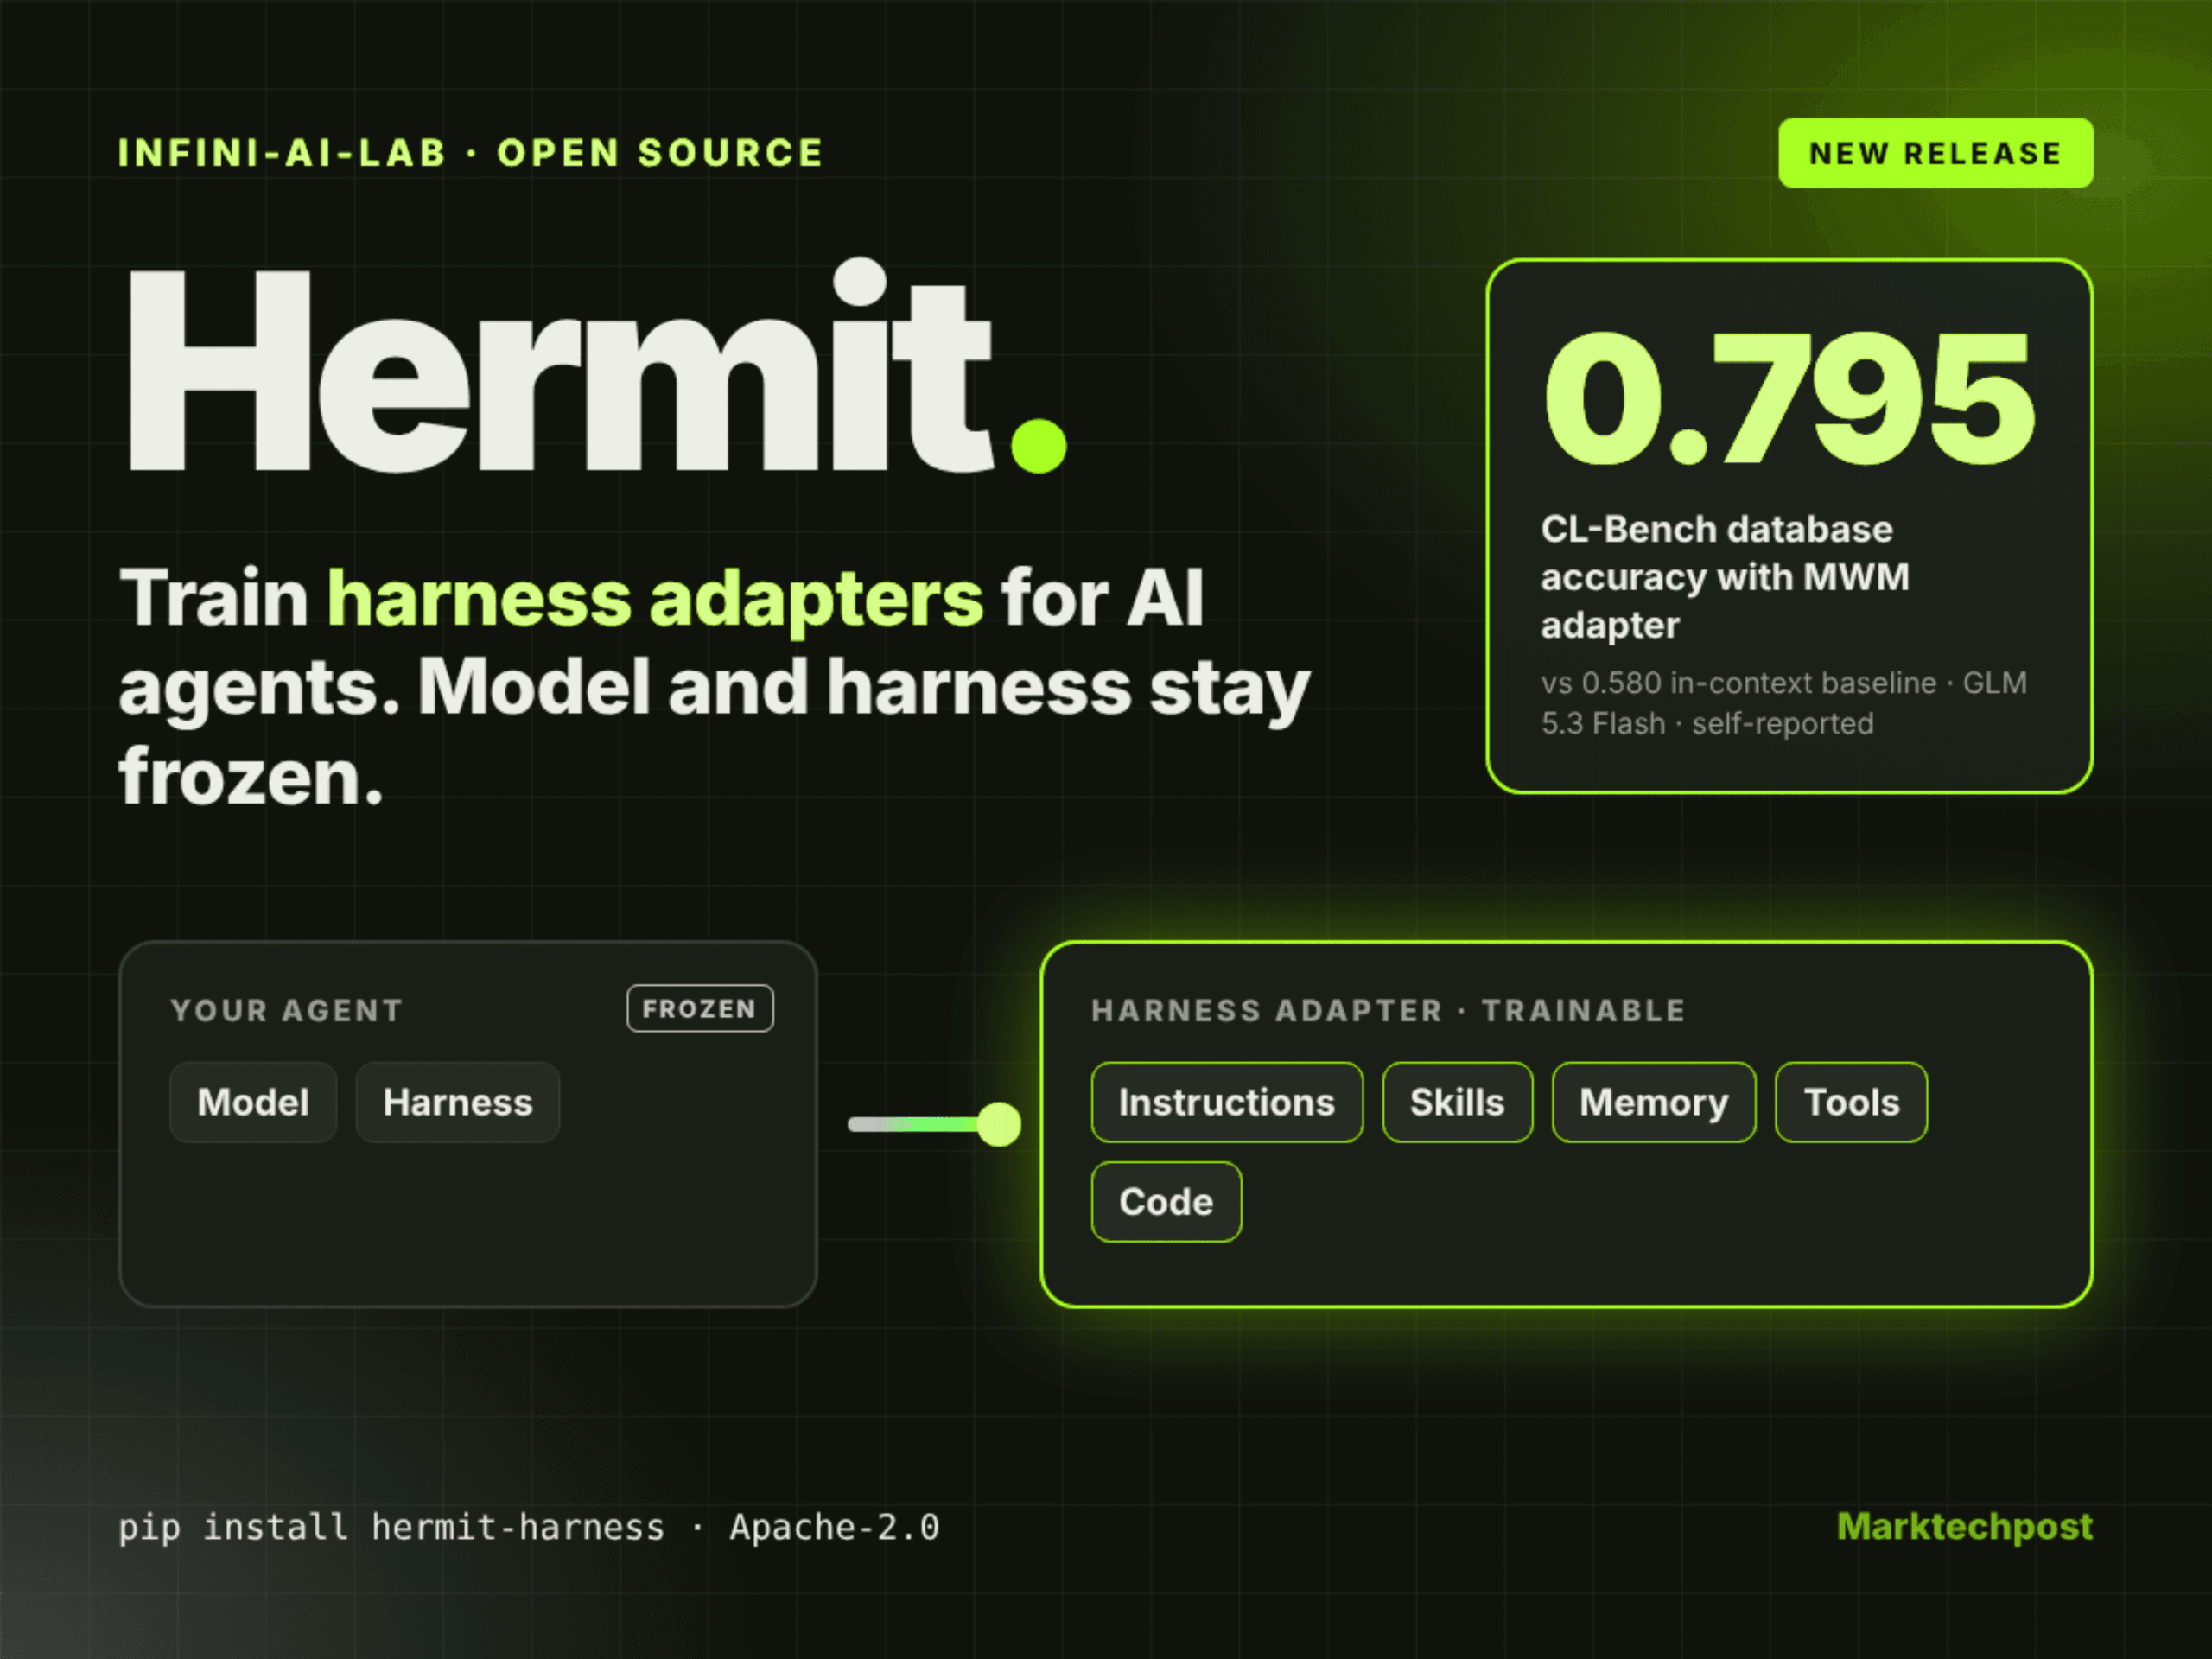
Infini-AI-Lab เปิดตัว Hermit เฟรมเวิร์ก harness adapter แบบ open-source สำหรับ AI agents ที่ออกแบบมาเพื่อฝึกฝน ‘harness adapter’ ภายนอก โดยปล่อยให้โมเดลและ harness ของเอเจนต์คงเดิมในลักษณะแช่แข็ง (frozen)
เวอร์ชันแรก v0.1.0 เริ่มเผยแพร่เมื่อวันที่ 25 ตุลาคม 2026 โดย Haizhong Zheng นักวิจัยหลังปริญญาเอกของ CMU ได้ประกาศผ่าน X เมื่อวันที่ 27 ตุลาคม สำหรับนักพัฒนาแล้ว จุดขายของ Hermit คือความเรียบง่ายในการปรับแต่งเอเจนต์อย่าง Codex หรือ Claude Code ให้เข้ากับงานใหม่ได้โดยไม่ต้องทำ fine-tuning หรือ forking ตัว harness
TL;DR
- Footprint: เป็นเฟรมเวิร์กภาษา Python ไม่มีพารามิเตอร์ของตัวเอง ใช้สัญญาอนุญาต Apache-2.0 ติดตั้งได้ผ่าน
pip install hermit-harness - การรัน: ในส่วน Quick Start แบบออฟไลน์ไม่จำเป็นต้องใช้ GPU, บัญชีโมเดล หรือชุดข้อมูล ส่วนการใช้งานจริงสามารถใช้ API backend ใดก็ได้ หรือเซิร์ฟเวอร์ vLLM, SGLang หรือ Ollama แบบ local
- ประสิทธิภาพ: มีรายงานการปรับปรุงผลลัพธ์ที่ดีขึ้นเมื่อเทียบกับ baseline ที่ไม่มี adapter บน OfficeQA, CL-Bench และ ServeLearnBench โดยทั้งหมดใช้ GLM 5.3 Flash
- ดีที่สุด: MWM adapter ทำความแม่นยำได้ 0.795 ในการสำรวจฐานข้อมูลของ CL-Bench เทียบกับ 0.580 สำหรับ in-context baseline
- แย่ที่สุด: Adapter แบบ prompt-only ทำคะแนนได้ 0.470 ในสนามทดสอบเดียวกัน ซึ่งต่ำกว่า baseline ที่ 0.580
- สรุปภาพรวม: ข้อดีคือมี training loop เดียวสำหรับวิธีวิวัฒนาการ harness 5 วิธี ส่วนข้อเสียคือผลลัพธ์ส่วนใหญ่เป็นการรันครั้งเดียวและเป็นรายงานจากผู้พัฒนาเอง
harness adapter คืออะไร?
harness adapter คือส่วนเสริมภายนอกที่สามารถฝึกฝนได้ ทำงานเหมือนปลั๊กอินที่มีระบบสนับสนุนการฝึกในตัว ต่างจาก model adapter อย่าง LoRA ที่ปรับจูนที่ตัวโมเดล แต่ harness adapter จะเน้นปรับจูนที่เอเจนต์ที่มีอยู่เดิมแทน
adapter นี้สามารถบรรจุได้ทั้งคำสั่ง, ทักษะ, หน่วยความจำ, เครื่องมือ, โค้ดที่รันได้ ไปจนถึงตรรกะการประสานงานของเอเจนต์ ซึ่งครอบคลุมได้แม้กระทั่ง repository ทั้งหมด โดยโมเดลฐานและโครงสร้างหลักจะไม่เปลี่ยนแปลง
ทีมงานให้เหตุผล 3 ประการในการออกแบบเช่นนี้ คือ harness จำนวนมากเป็น closed-source, การแก้ไขโครงสร้างแบบ open-source อาจกระทบการทำงานของคอมโพเนนต์อื่น และ adapter ที่เรียนรู้แล้วสามารถย้ายไปใช้กับโมเดลหรือ harness อื่นที่เข้ากันได้ทันที
Hermit ฝึกฝน adapter อย่างไร?
Hermit ใช้ training loop สไตล์ RL โดยมีระบบ Trainer รันชุดงานผ่านเอเจนต์ร่วมกับ adapter ปัจจุบัน จากนั้น Judge จะให้คะแนนผลลัพธ์ และ Evolver จะวิเคราะห์เส้นทางการทำงาน (trajectories) พร้อมคำติชมเพื่อเสนอ adapter เวอร์ชันใหม่ โดย Trainer จะตรวจสอบกับเทมเพลตและบันทึกผล
adapter ทุกเวอร์ชันจะถูกเก็บไว้ใน git tree ทำให้สามารถตรวจสอบ ย้อนกลับ หรือเลือกใช้งานเวอร์ชันใดก็ได้ ทั้งนี้โปรแกรมการเรียนรู้อาจทำงานใน sandbox ซึ่งต้องใช้ระบบปฏิบัติการ Linux พร้อม bubblewrap
ปัจจุบันมีวิธีวิวัฒนาการ 5 วิธีที่มาพร้อมตัวเครื่อง ได้แก่ GEPA, SkillOpt, MetaWorld Model (MWM), Harness² และ Continual Harness โดยมี ACE และ ReHarness ที่กำลังจะตามมาในอนาคต นอกจากนี้ผู้ใช้ยังสามารถเขียน Evolver ของตนเองได้ด้วย
ผลลัพธ์ของ benchmark เป็นอย่างไร?
การทดสอบทั้งหมดใช้ GLM 5.3 Flash เป็นโมเดลหลัก โดยตัวเลขเป็นรายงานจากผู้พัฒนาผ่านไฟล์ README ของโปรเจกต์
ในการทดสอบ OfficeQA (recipe) ซึ่งมีคำถาม 172 ข้อเกี่ยวกับ U.S. Treasury Bulletins วัดผลด้วยความแม่นยำแบบ exact match ได้ผลลัพธ์ดังนี้:
| Method | Accuracy |
|---|---|
| No adapter | 0.541 |
| Initial skill | 0.576 |
| GEPA | 0.580 |
| SkillOpt | 0.600 |
| Continual Harness | 0.634 |
| Harness² | 0.651 |
GEPA และ SkillOpt ฝึกฝนจากคำถามและทดสอบแบบคงที่ ส่วน Continual Harness และ Harness² เรียนรู้ขณะประมวลผลแบบสตรีมมิ่ง ซึ่งทีมงานรายงานว่า Harness² มีคะแนนเพิ่มขึ้น +7.6 จุดเมื่อเทียบกับค่าอ้างอิง
สำหรับการทดสอบ CL-Bench ในส่วนการสำรวจฐานข้อมูล MWM ทำความแม่นยำได้ 0.795 ขณะที่ in-context baseline ทำได้ 0.580 ส่วนใน ServeLearnBench MWM ทำคะแนนได้ 45.3 สูงกว่าค่าเฉลี่ยของวิธีอื่นบนลีดเดอร์บอร์ดอย่างชัดเจน
Hermit เปรียบเทียบกับตัวเพิ่มประสิทธิภาพเอเจนต์อื่นๆ อย่างไร?
| Feature | Hermit | GEPA | ACE | Agent Lightning |
|---|---|---|---|---|
| สิ่งที่ฝึกฝน | External harness adapter | พารามิเตอร์ข้อความใดๆ (prompts, code) | Context playbook | Prompts และน้ำหนักโมเดล |
| เปลี่ยนน้ำหนักโมเดลหรือไม่ | ไม่ | ไม่ | ไม่ระบุ | ใช่ ผ่าน RL หรือ SFT |
| วิธีการ | 5 วิธีในตัว, Evolvers แบบกำหนดเอง | Reflective evolution, Pareto selection | Generator, Reflector, Curator | RL, prompt optimization, SFT |
| เป้าหมายการใช้งาน | Codex, Claude Code, Pi; ส่งออกปลั๊กอิน | DSPy (dspy.GEPA) | ไม่ระบุ | LangChain, OpenAI Agents SDK, AutoGen, CrewAI และอื่นๆ |
| สัญญาอนุญาต | Apache-2.0 | MIT | Apache-2.0 | MIT |
| ผลลัพธ์หลัก | 0.795 บน CL-Bench database | AIME 2025: 46.6% ถึง 56.6% | +10.6% บน AppWorld | ไม่ระบุ |
วิธีการติดตั้งและใช้งาน?
ติดตั้งผ่าน PyPI ด้วยคำสั่ง bash pip install hermit-harness หรือโคลน repository เพื่อใช้งาน CLI ที่ครอบคลุมทั้ง check, train, eval, deploy และ convert โดยรองรับ backend หลากหลาย เช่น Fireworks, OpenAI, Anthropic, DeepSeek, vLLM, SGLang และ Ollama
คำสั่ง hermit deploy จะสร้าง workspace สำหรับ Codex, Claude Code หรือ Pi ส่วน hermit convert จะส่งออก adapter เป็นปลั๊กอินดั้งเดิม เช่น การส่งออก adapter สำหรับงานด้านคณิตศาสตร์เพื่อประสานการทำงานของเอเจนต์ Codex 5 ตัวร่วมกัน
ประเด็นสำคัญ
- Hermit เน้นฝึกฝน adapter ภายนอกเพื่อให้โมเดลและโครงสร้างหลักยังคงเสถียร
- Asif Razzaq ซีอีโอของ Marktechpost AI Media Inc. และวิศวกรผู้มีวิสัยทัศน์ มุ่งมั่นใช้ AI เพื่อประโยชน์ต่อสังคม ผ่านแพลตฟอร์มสื่อด้าน machine learning ที่มียอดเข้าชมกว่า 2 ล้านครั้งต่อเดือน เพื่อนำเสนอข้อมูลทางเทคนิคที่ถูกต้องและเข้าใจง่ายสำหรับทุกคน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร