
เปิดตัว Le Chonk: Mistral Large 4 โมเดล MoE พลังแรงบน Hugging Face
Mistral Large 4 (หรือที่รู้จักในชื่อ Le Chonk) เป็นโมเดลแบบ multimodal, multilingual และ Mixture-of-Experts (MoE) รุ่นใหม่จาก Mistral รองรับการนำเข้าข้อมูลทั้งข้อความและรูปภาพ พร้อมสร้างผลลัพธ์เป็นข้อความ โดยมีพารามิเตอร์รวมประมาณ 1T total, 49B active parameter และมี context window ขนาดใหญ่ถึง 1M tokens
โมเดลนี้เปิดตัวอย่างเป็นทางการในสองเวอร์ชันหลัก:
นอกจากนี้ยังมีเวอร์ชัน GGUFs ที่สร้างโดย Unsloth และทีม llama.cpp โดยเผยแพร่ภายใต้ Mistral Ecosystem Open-Weight License ซึ่งเป็นสัญญาอนุญาตที่ดัดแปลงมาจาก MIT ที่มีข้อจำกัดสำหรับการให้บริการแบบ model-as-a-service
Mistral Large 4 มีความแข็งแกร่งเป็นพิเศษในด้านความปลอดภัยไซเบอร์ (cybersecurity), coding agents และความเป็นมัลติโมดัล ในบทความนี้เราจะพาไปเจาะลึกการทำงาน ความสามารถ และสถาปัตยกรรมของโมเดลนี้กัน
สารบัญ
สิ่งใหม่ใน Mistral Large 4
Mistral Large 4 ผสมผสานกลุ่มผู้เชี่ยวชาญ (experts) ขนาดใหญ่เข้ากับ sparse attention และ Pixtral vision encoder โดยตัวโมเดลภาษาจะเลือกกลุ่มผู้เชี่ยวชาญขนาดเล็กสำหรับแต่ละ token ในขณะที่ attention indexer จะเลือกว่าตำแหน่ง token ก่อนหน้าใดที่ควรให้ความสนใจ
โครงสร้างนี้คือความเบาบาง (sparsity) สองรูปแบบที่แตกต่างกัน โดยรูปแบบหนึ่งทำหน้าที่เลือก feed-forward networks และอีกรูปแบบหนึ่งเลือกตำแหน่งบริบท (context positions) โดยคุณสามารถค้นหา checkpoint ทั้งหมดได้ใน Mistral Large 4 collection
ความสามารถด้านความปลอดภัยไซเบอร์
Mistral Large 4 ทำคะแนนได้ 82% ในแบบทดสอบ Artificial Analysis Cyber Index ที่กำหนดให้โมเดลจำลองช่องโหว่จริงในซอฟต์แวร์โอเพนซอร์สแล้วทำการแก้ไข (patch) ซึ่ง Mistral รายงานว่า closed frontier models หลายตัวทำคะแนนได้เกือบศูนย์ในการทดสอบเดียวกันเนื่องจากปฏิเสธที่จะทำงานดังกล่าว
ความสามารถนี้สำคัญมากสำหรับผู้ป้องกัน (defenders) เพราะการแก้ไขมักต้องจำลองช่องโหว่ขึ้นมาใหม่ก่อน ในการทดสอบภายในของ Mistral พบว่า Mistral Large 4 ยังมีประโยชน์สำหรับการวิเคราะห์มัลแวร์ การจัดลำดับความสำคัญของช่องโหว่ และการเขียนกฎการตรวจจับ ซึ่งเป็นสิ่งที่โมเดลไม่ได้ถูกฝึกมาโดยเฉพาะ
Mistral วางตำแหน่งโมเดลนี้สำหรับงานความปลอดภัยเชิงรับเป็นหลัก เนื่องจากการวิจัยช่องโหว่อาจดูเหมือนการโจมตี ทำให้โมเดลแบบ closed source มักจะบล็อกงานเหล่านี้ ทีมที่พึ่งพา API ยังอาจสูญเสียการเข้าถึงในช่วงเกิดเหตุการณ์สำคัญ แต่ open weight models ช่วยให้ผู้ใช้ควบคุมนโยบายการใช้งานและการปรับใช้ได้เอง อย่างไรก็ตามโมเดลยังคงปฏิเสธคำขอที่เป็นอันตราย โดยมีอัตราการปฏิเสธ cyber prompts จาก JailbreakBench, StrongREJECT และ AgentHarm สูงกว่า open weight model อื่นๆ
การมีโมเดลอย่าง Mistral Large 4 ช่วยปลดล็อกการใช้งานสำหรับนักพัฒนาในชุมชนได้มาก คุณสามารถสร้างระบบไซเบอร์รอบๆ ฐานโค้ดและ Logs ของคุณเอง หรือใช้ TRL เพื่อ fine-tune โมเดลขนาดเล็กจากร่องรอยการทำงานของ Mistral Large 4 ก็ได้ ซึ่งความสามารถในรูปแบบเปิดนี้ถือเป็นแรงผลักดันมหาศาลสำหรับชุมชนไอที
เราร่วมพูดคุยกับ Pierre Stock เกี่ยวกับความสามารถด้านไซเบอร์ของโมเดล คุณสามารถรับชมได้ที่นี่
สถาปัตยกรรม (Architecture)
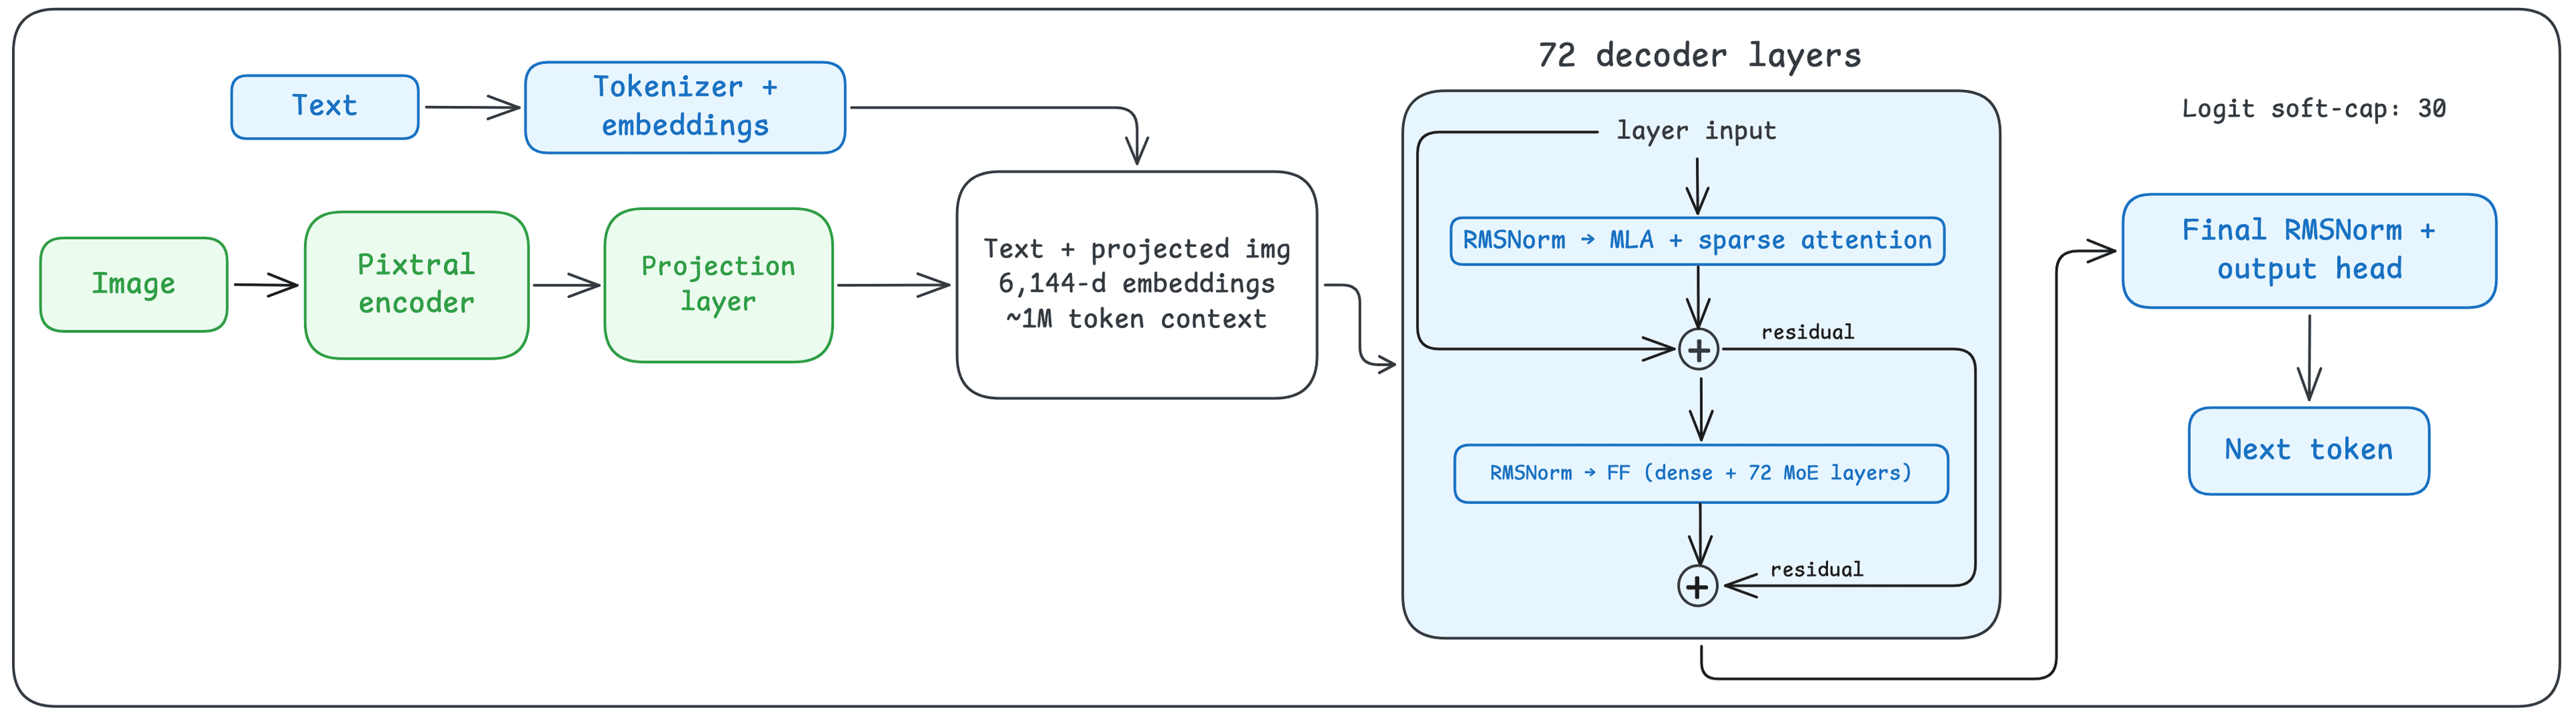
text decoder ของ Mistral Large 4 ประกอบด้วย 72 เลเยอร์, hidden dimension ขนาด 6,144 และ attention heads 64 หัว บล็อก attention รวม Multi-head Latent Attention (MLA) เข้ากับ DeepSeek Sparse Attention (DSA) indexer (คล้ายกับ GLM 5.3) โดย MLA จะเก็บ KV ที่ถูกบีบอัดไว้ และ DSA จะเลือกตำแหน่ง key ได้สูงสุด 2,048 ตำแหน่งสำหรับแต่ละ query
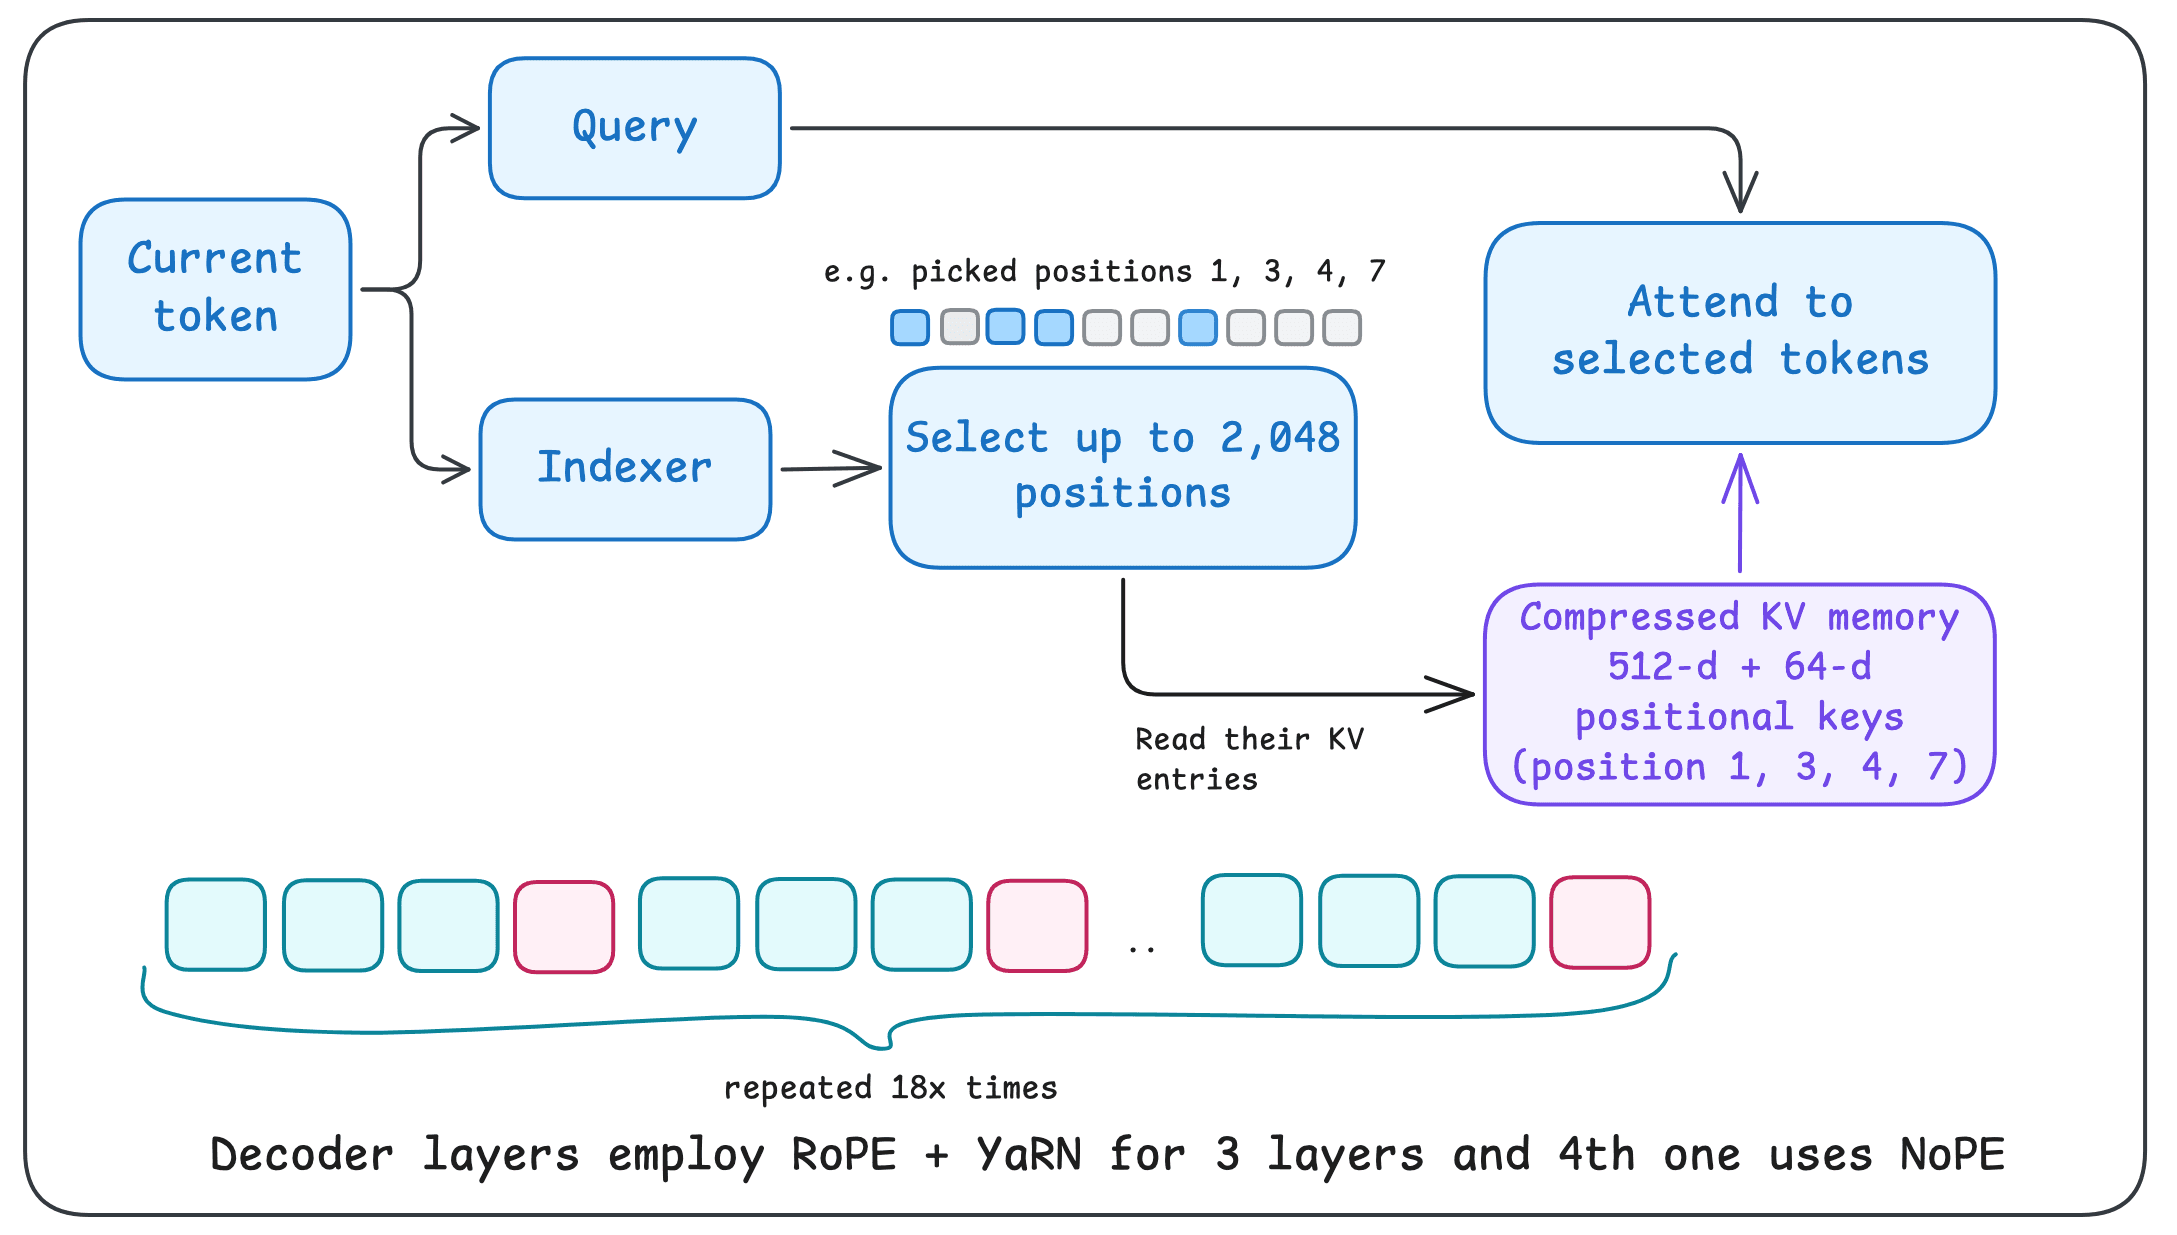
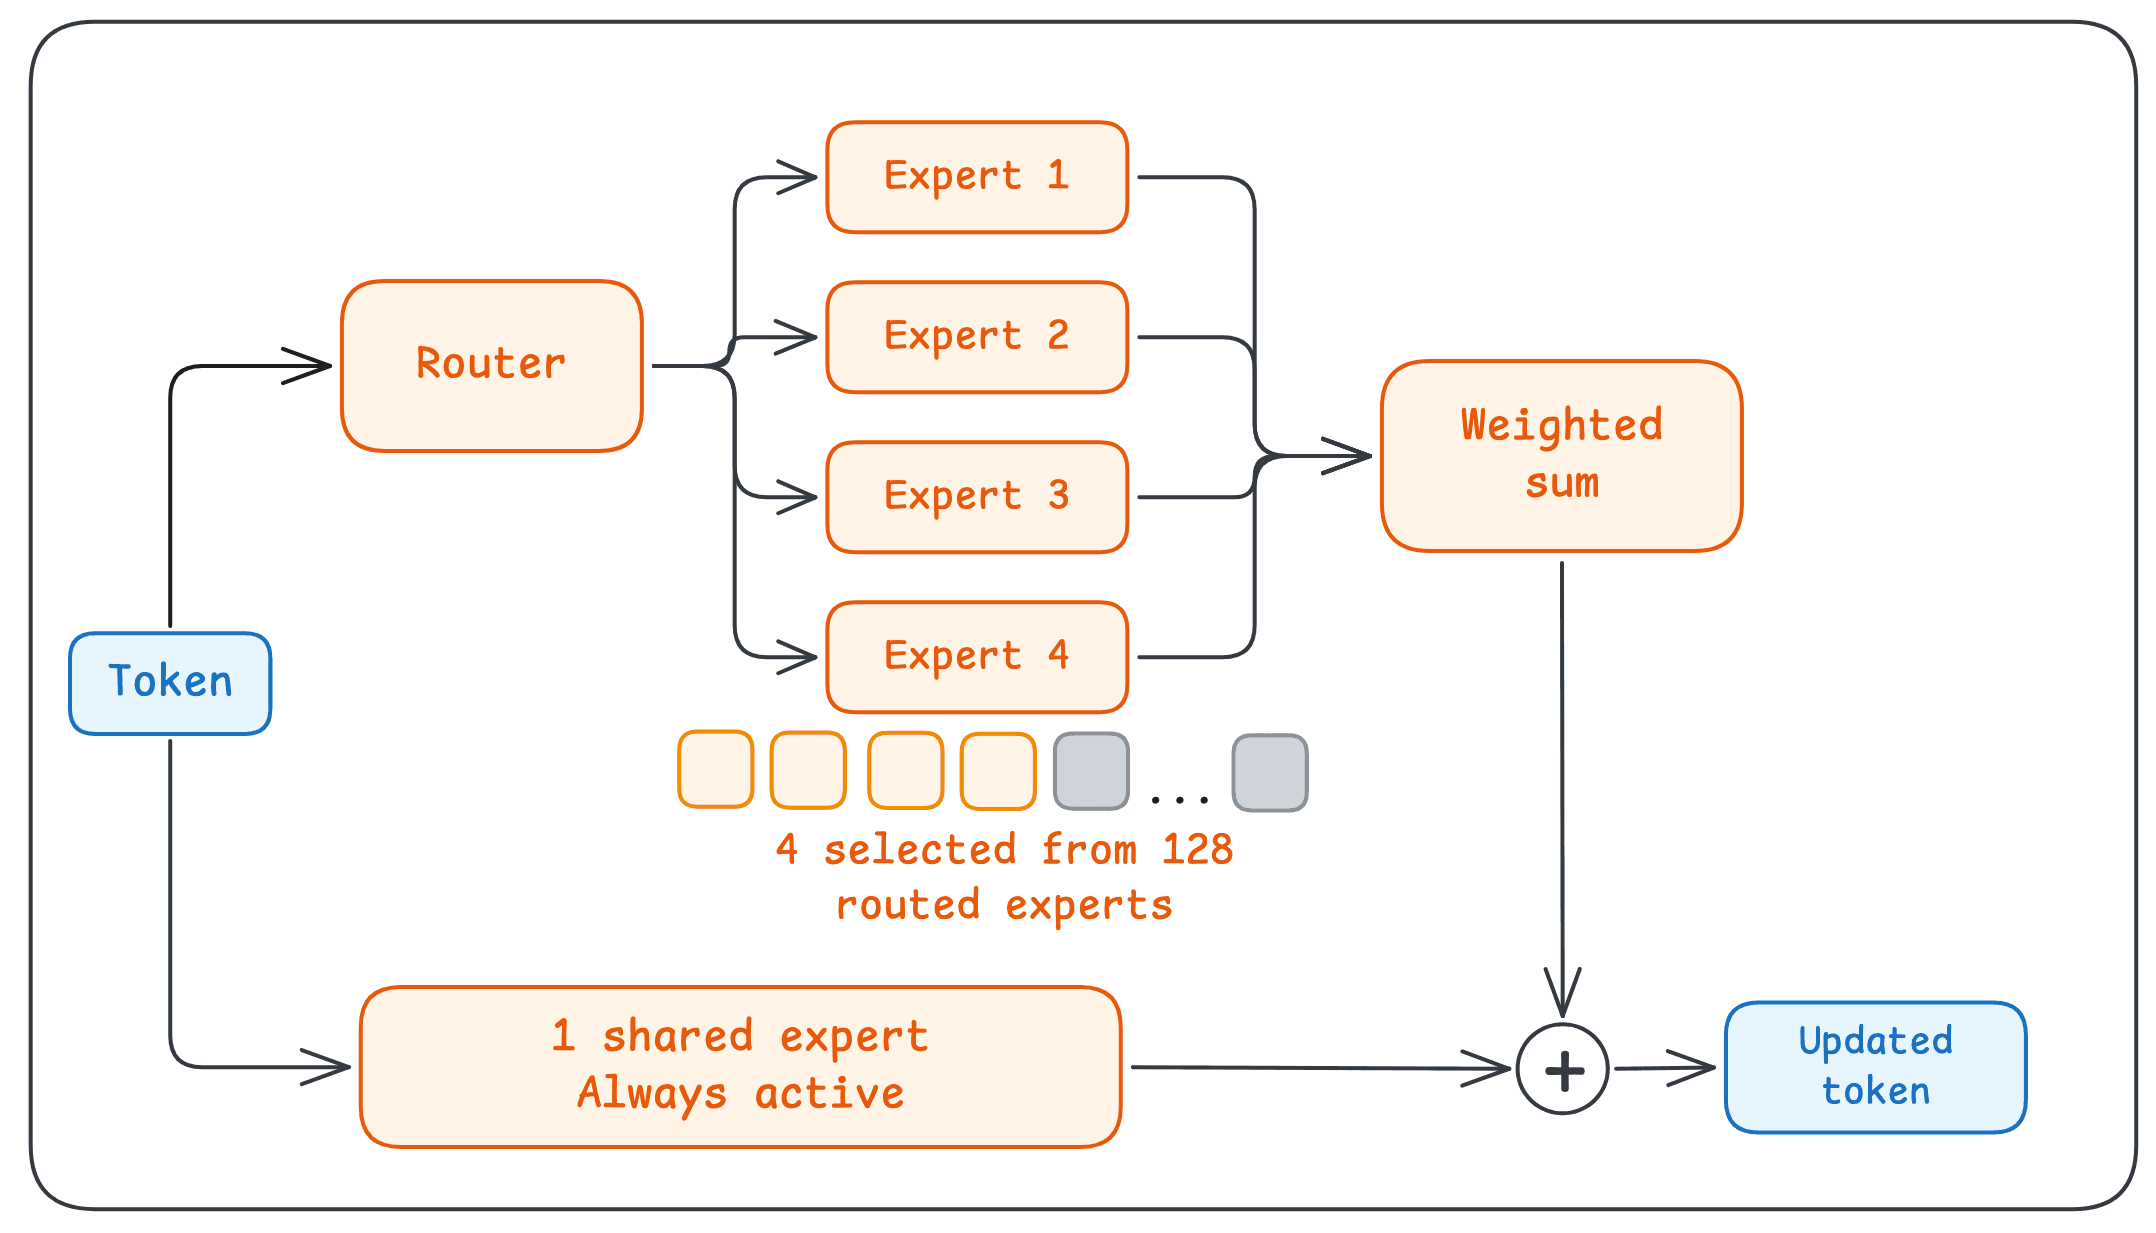
ในแต่ละ decoder block จะมีรูปแบบ RoPE ต่อ NoPE ในอัตราส่วน 3:1 (ใช้ RoPE 3 ชั้น และ NoPE ในชั้นที่ 4) โมเดลใช้สถานะ KV ร่วมกันในแต่ละเลเยอร์ โดยเลเยอร์แรกใช้ dense feed-forward network ส่วนอีก 71 เลเยอร์ที่เหลือใช้ MoE blocks ซึ่ง softmax router จะเลือกผู้เชี่ยวชาญ 4 คนจาก 128 คนต่อหนึ่ง token ร่วมกับผู้เชี่ยวชาญส่วนกลาง (shared expert) อีก 1 คน รวมเป็น 5 active experts
สำหรับการจัดการ RoPE นั้น Mistral ใช้ LeRope ซึ่งเป็น YaRN-scaled RoPE ที่มีตัวคูณที่เรียนรู้ได้หนึ่งตัวต่อหนึ่งความถี่
Vision encoder
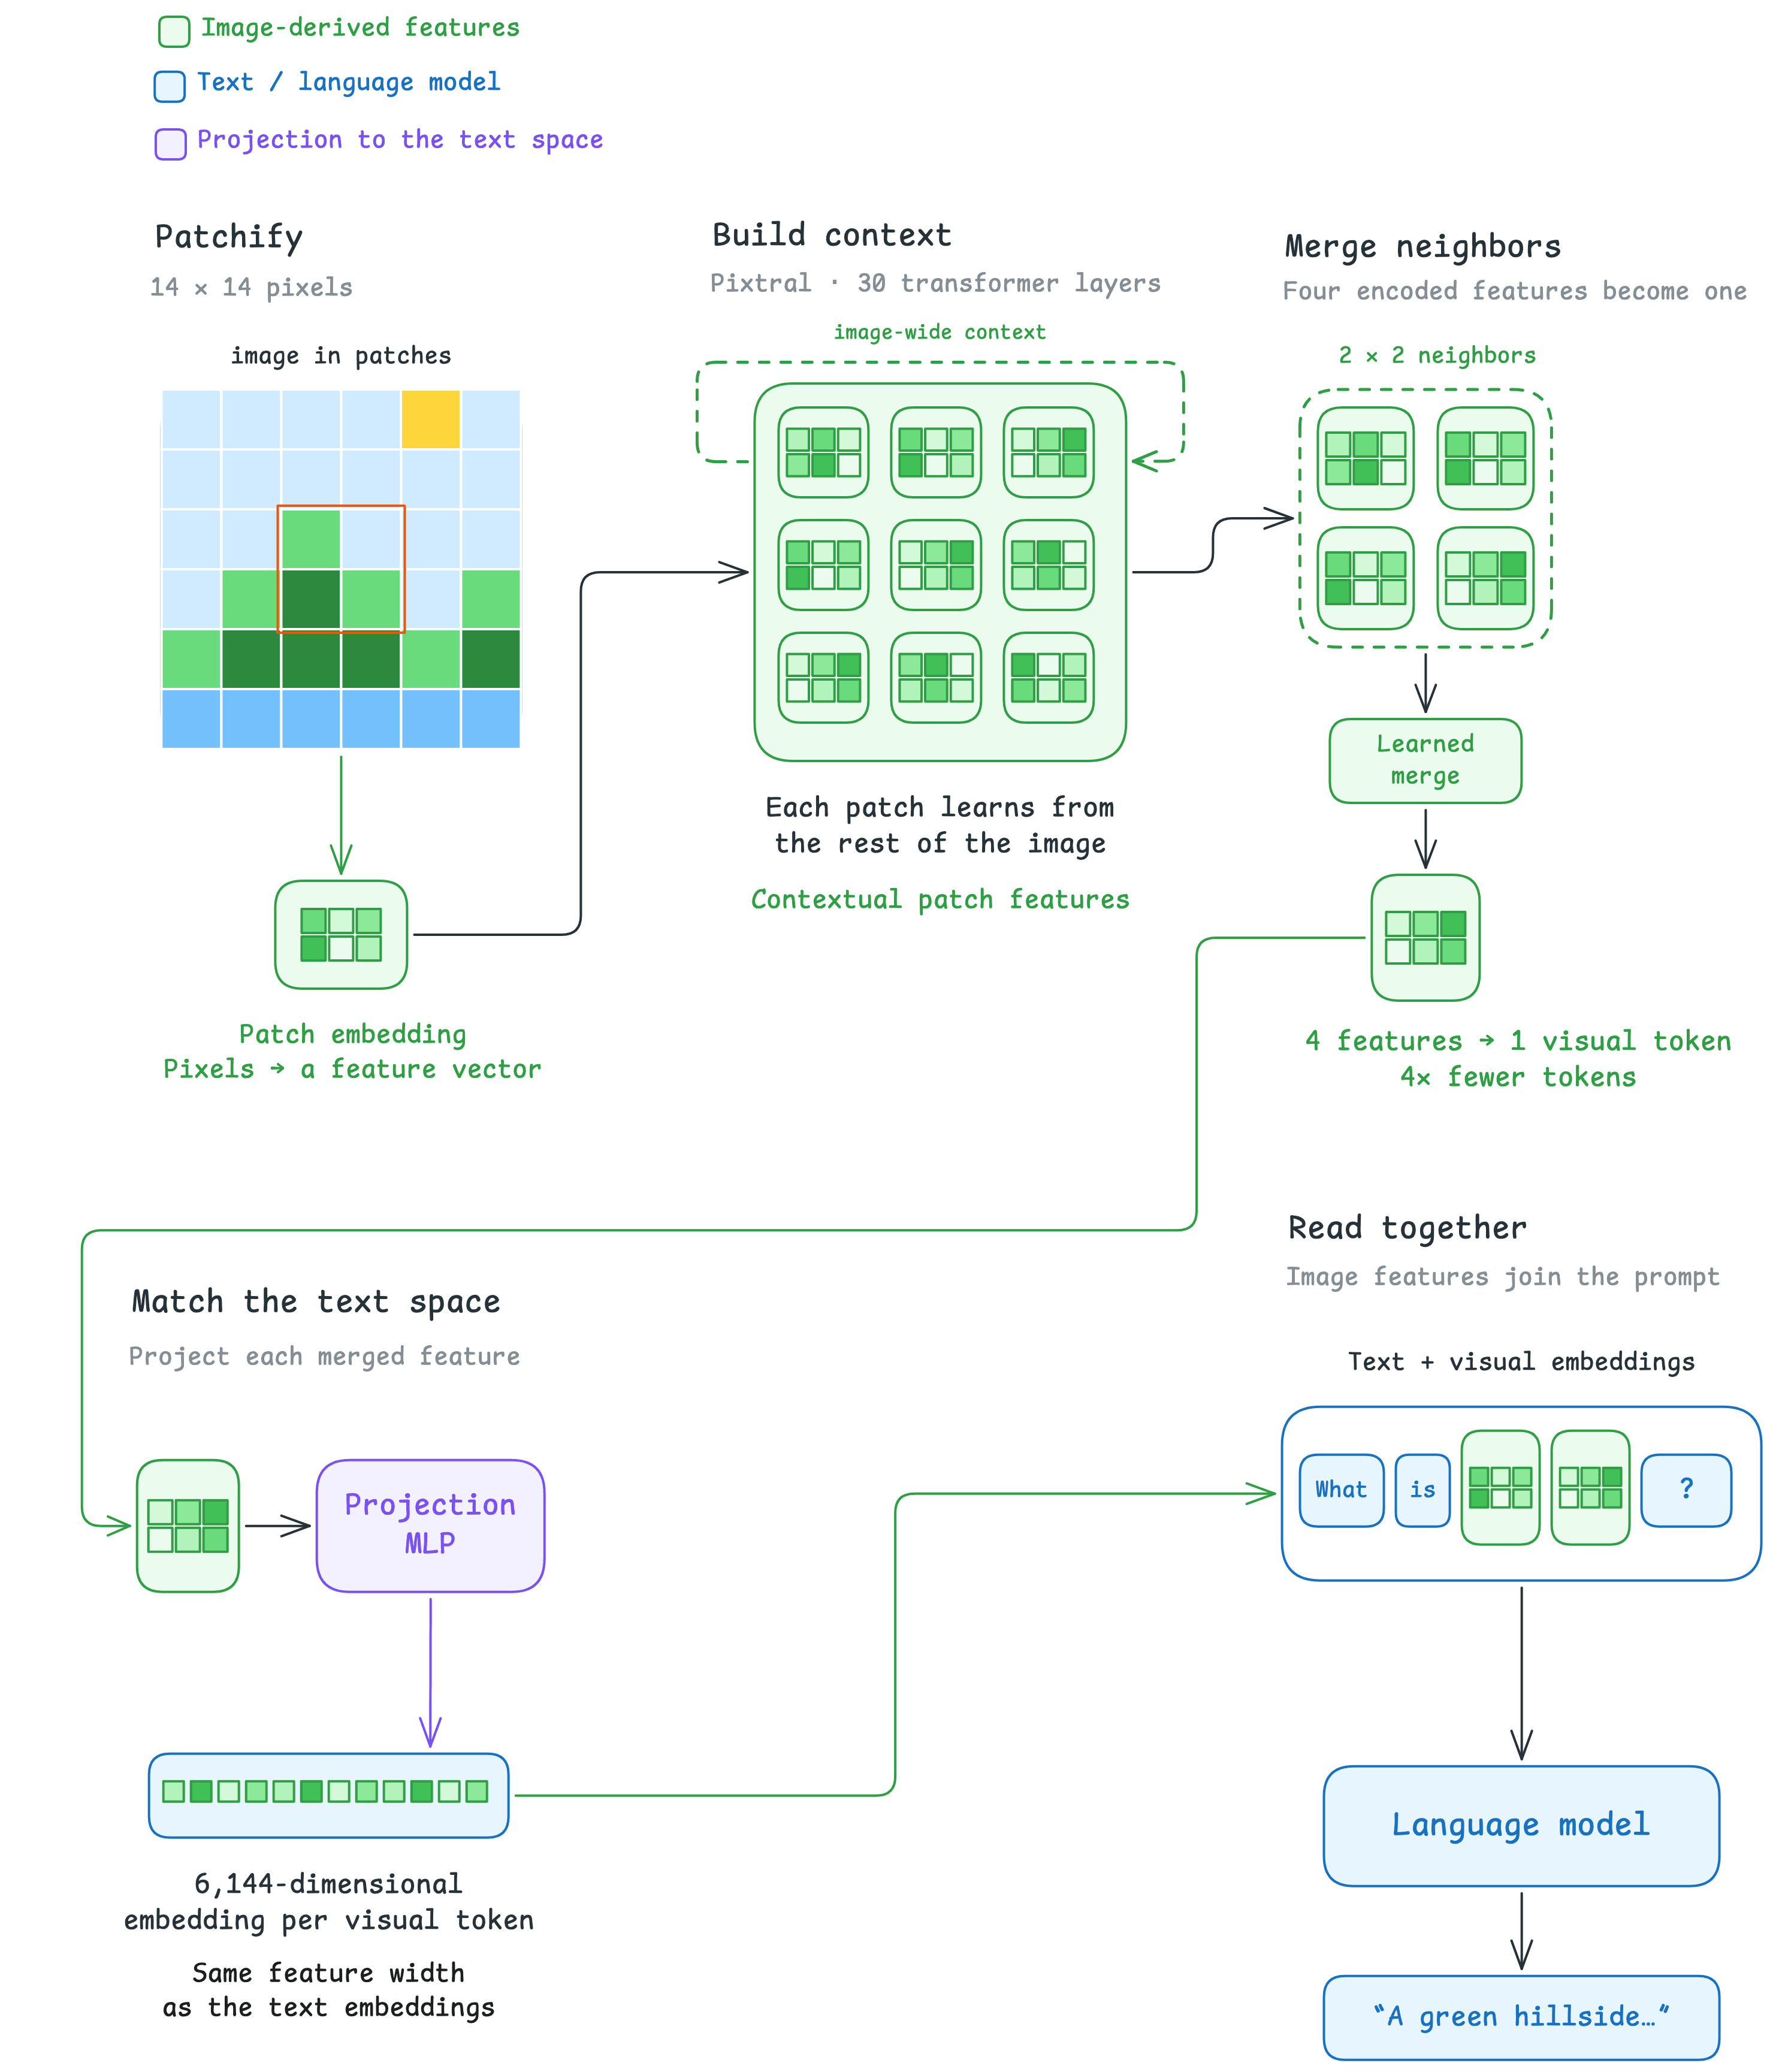
Mistral Large 4 ใช้ Pixtral encoder ขนาด 1.6B ซึ่งประกอบด้วย 30 เลเยอร์, 16 attention heads และใช้ 14 × 14 patches โดยมี spatial merge เท่ากับ 2 คุณสามารถดูรายละเอียดขั้นตอนของ encoder ได้ตามภาพด้านล่าง
ผลการทดสอบ (Benchmark Results)
Mistral Large 4 ให้ประสิทธิภาพที่แข็งแกร่งทั้งด้านการเขียนโค้ด ความเข้าใจมัลติโมดัล และงานแบบ agentic ข้อมูล ณ วันที่ 29 ตุลาคม 2026 ระบุว่าโมเดลนี้เป็น open weights model ที่ดีที่สุดอันดับ 5 ในดัชนี Artificial Analysis Intelligence
ด้านการเขียนโค้ด ML4 ทำคะแนนได้ 61.7% บน DeepSWE v1.1 และ Coding Agent Index อยู่ที่ 49.8% ซึ่งแซงหน้า DeepSeek V4 Pro 0813 และ Qwen3.8 Max นอกจากนี้ยังทำคะแนนได้ดีในงานระดับมืออาชีพด้วยคะแนน 59.9% บน AutomationBench และ 1,393 Elo บน AA-Briefcase
ความปลอดภัยไซเบอร์คือจุดเด่นที่สุด โดยมีผลลัพธ์ที่สำคัญดังนี้:
- Artificial Analysis Cyber Index: ติดอันดับ ท็อป 5 ของโลก ในการประเมินอิสระด้านการแก้ไขช่องโหว่
- Vulnerability reproduction and patching: ทำได้ถึง 82% ซึ่งเป็นคะแนนสูงสุดในดัชนี
- Cybench: แก้ไขโจทย์ได้ 93% จากชุดความท้าทายในการแข่งขันด้านความปลอดภัย
นอกจากนี้ยังแสดง ความต้านทานการโจมตี 93.3% บน Lakera B3 benchmark ซึ่งยืนยันความทนทานต่อ prompt-injection ได้เป็นอย่างดี
การสนับสนุน Inference
Mistral Large 4 รองรับการใช้งานตั้งแต่วันแรกผ่าน Transformers, vLLM และ llama.cpp โดยมี GGUF quants ให้บริการจากทีม llama.cpp และรองรับการ deploy ผ่าน Inference Endpoints และ Inference Providers
Transformers
การใช้งานผ่าน Transformers ใช้ AutoModelForMultimodalLM และ AutoProcessor เพื่อเตรียมข้อมูล ข้อควรระวังคือฟังก์ชันเหตุผล (reasoning effort) จะถูกตั้งค่าเป็น high โดยค่าเริ่มต้นและไม่สามารถปิดได้ (แม้จะตั้งเป็น none ก็ตาม)
อัปเกรดแพ็กเกจ:
pip install --upgrade transformersตัวอย่างโค้ดการใช้งาน:
import os
from transformers import AutoProcessor, AutoModelForMultimodalLM, DistributedConfig

distributed_config = DistributedConfig(
    tp_size=int(os.environ["WORLD_SIZE"]),
    ep_size=int(os.environ["WORLD_SIZE"]),
)

model_id = "mistralai/Mistral-Large-4-1T-A52B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(
    model_id,
    distributed_config=distributed_config,
)

# only text
text_messages = [
    {
        "role": "user",
        "content": "Who are you?"
    }
]

# text + image
multimodal_messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "image": "https://huggingface.co/datasets/huggingface/cats-image/resolve/main/cats_image.jpeg",
            },
            {
                "type": "text",
                "text": "How many cats are in the image?",
            },
        ],
    },
]

for messages in [text_messages, multimodal_messages]:
    inputs = processor.apply_chat_template(
        messages,
        add_generation_prompt=True,
        tokenize=True,
        return_dict=True,
        return_tensors="pt",
        reasoning_effort="medium",
    ).to(model.device).to(model.dtype)
    input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=100)
    if int(os.environ["RANK"]) == 0:
        print(processor.decode(outputs[0][input_len:], skip_special_tokens=False))
รันสคริปต์ด้วยคำสั่ง:
torchrun --nproc-per-node 8 script.pyvLLM
vLLM รองรับ NVFP4 checkpoint ที่ประหยัดหน่วยความจำและทำงานได้ดีบน NVIDIA Blackwell โดยเริ่มเซิร์ฟเวอร์ได้ดังนี้:
vllm serve mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --config-format mistral \
  --load-format mistral \
  --tensor-parallel-size 8 \
  --decode-context-parallel-size 8 \
  --enable-expert-parallel \
  --dtype bfloat16 \
  --max-model-len 131072 \
  --max-num-seqs 16 \
  --max-num-batched-tokens 2048 \
  --gpu-memory-utilization 0.85 \
  --enable-prefix-caching \
  --enforce-eager \
  --mm_processor_cache_gb 0.0
Llama.cpp
สามารถติดตั้ง Llama App และเริ่มเซิร์ฟเวอร์เพื่อใช้งานผ่าน WebUI หรือ API ได้ทันที:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
สำหรับ quants รุ่น Q2_K บน M3 Ultra สามารถทำ prefill ได้ 90 tokens/s และสร้างคำตอบได้ 15 tokens/s ส่วนบน 4 x RTX6000 Pro เวอร์ชัน NVFP4 ทำความเร็วการสร้างได้ประมาณ 10 tokens/s
การ Fine-tuning ด้วย TRL
คุณสามารถ fine-tune Mistral Large 4 ได้ทันทีผ่าน TRL โดยตัวอย่างด้านล่างเป็นการฝึกให้โมเดลใช้เหตุผลแบบหลายภาษา (multilingual thinking):
# torchrun --nproc-per-node 8 sft.py
import os

from datasets import load_dataset
from peft import LoraConfig
from transformers import AutoModelForImageTextToText, DistributedConfig
from trl import SFTConfig, SFTTrainer

world_size = int(os.environ["WORLD_SIZE"])
model_id = "mistralai/Mistral-Large-4-1T-A52B"
model = AutoModelForImageTextToText.from_pretrained(
    model_id,
    distributed_config=DistributedConfig(fsdp_size=world_size, ep_size=world_size),
    dtype="auto",
)

dataset = load_dataset("HuggingFaceH4/Multilingual-Thinking", split="train")
dataset = dataset.map(lambda x: {"chat_template_kwargs": {"reasoning_effort": "high"}})

trainer = SFTTrainer(
    model=model,
    args=SFTConfig(
        packing=True,
        max_length=4096,
        assistant_only_loss=True,
        learning_rate=1e-4,
        lr_scheduler_type="cosine",
        warmup_steps=10,
    ),
    train_dataset=dataset,
    peft_config=LoraConfig(
        r=16,
        lora_alpha=32,
        target_modules=r".*language_model.*\.(q_proj|kv_a_proj_with_mqa|kv_b_proj|o_proj|gate_proj|up_proj|down_proj)",
    ),
)
trainer.train()
Inference Endpoints และ Dell Hub
Mistral Large 4 พร้อมใช้งานบน Inference Endpoints โดยใช้ 8 x NVIDIA H200 รองรับ context สูงถึง 131K tokens และประมวลผลคำตอบได้เร็วสูงสุด 138 tok/s เมื่อใช้งาน DSpark
สำหรับผู้ใช้ Dell AI Servers สามารถใช้ dell-ai CLI เพื่อ deploy โมเดลบนแพลตฟอร์มอย่าง NVIDIA B300 ได้โดยตรงผ่าน Dell Enterprise Hub (DEH)
เริ่มต้นใช้งาน
คุณสามารถดาวน์โหลด weights ได้จาก Mistral Large 4 collection หรือทดลองใช้ GGUFs บนเครื่องของคุณเอง และร่วมแบ่งปันผลงานการปรับแต่งบน Hub ได้ทันที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร