
You.com เปิดตัว Inference Router สำหรับ 12 โมเดล Open-Weight
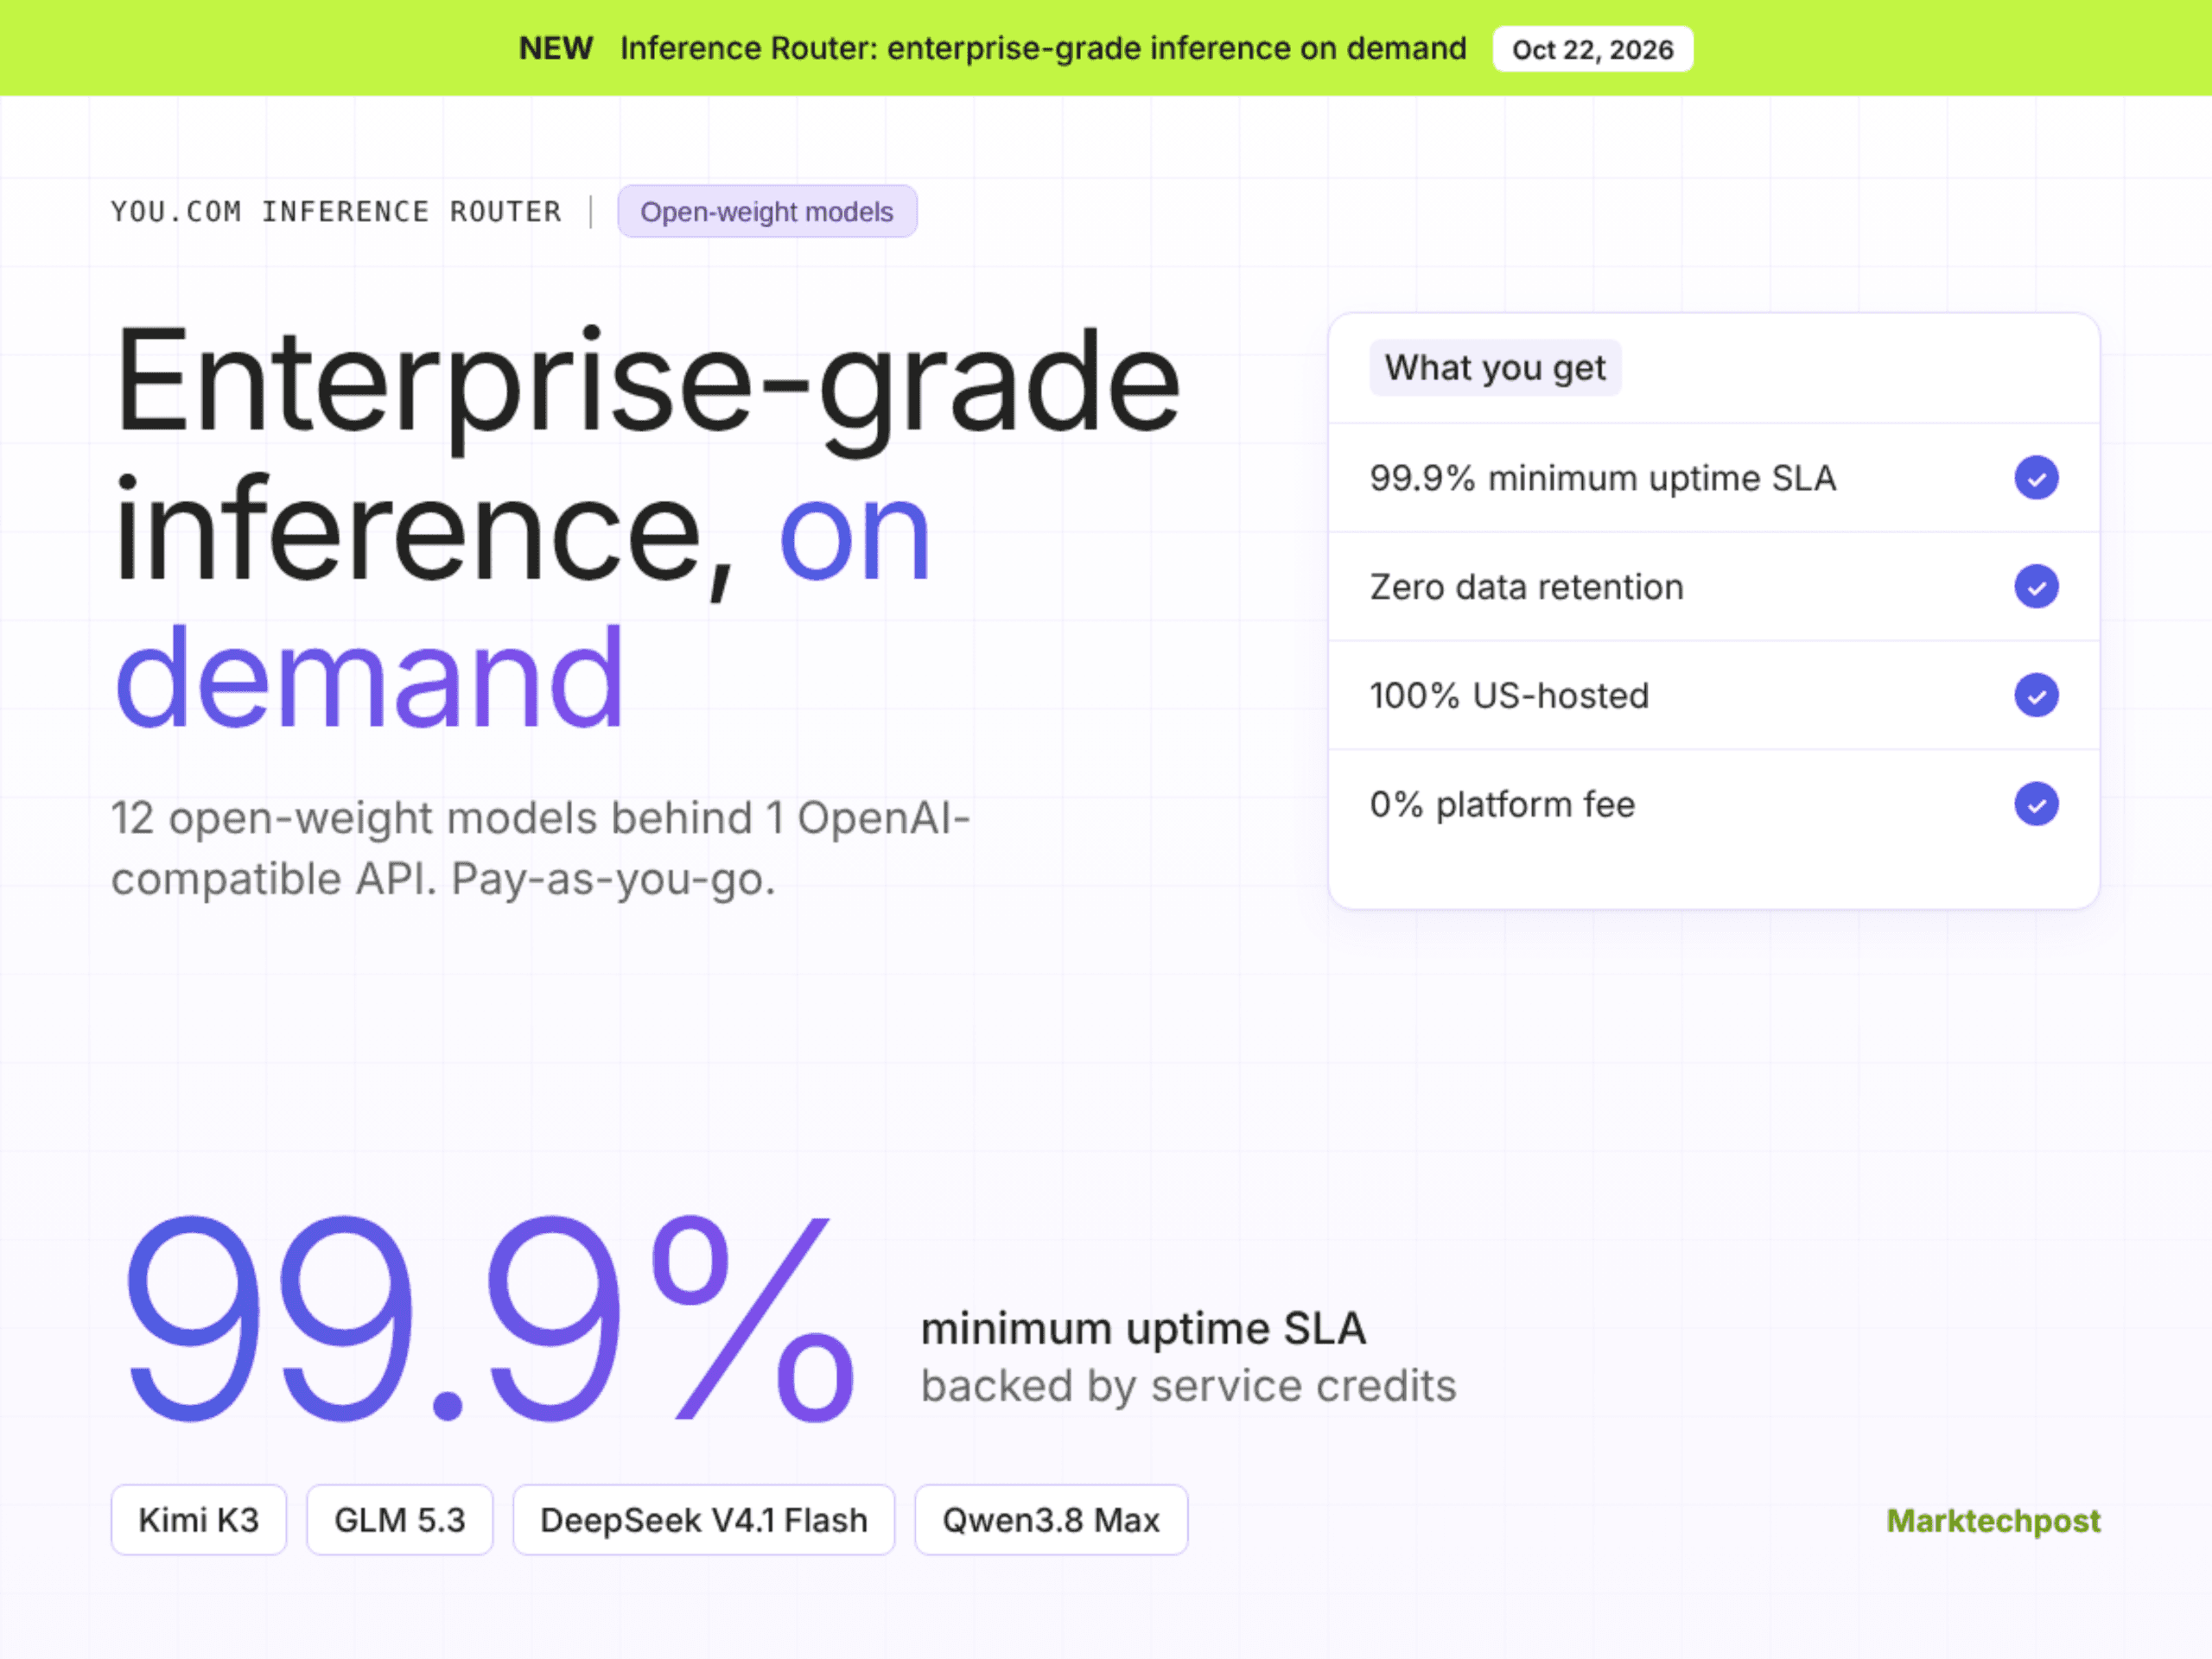
You.com ได้ launched Inference Router ซึ่งเป็น API แบบจัดการสำเร็จรูปสำหรับการรันโมเดล open-weight ในสภาพแวดล้อมการใช้งานจริง
You.com Inference Router เป็นบริการที่รองรับการใช้งานร่วมกับ OpenAI โดยจะเลือกเส้นทาง (route) คำขอไปยัง 12 โมเดลที่พร้อมใช้งาน มาพร้อมกับการรับประกัน SLA อัปไทม์ขั้นต่ำ 99.9% และนโยบายไม่เก็บรักษาข้อมูล (zero data retention หรือ ZDR) นอกจากนี้ยังมีจุดเด่นที่การโฮสต์ในสหรัฐอเมริกา 100% และการค้นหาเว็บฝั่งเซิร์ฟเวอร์ โดยคิดค่าบริการตามการใช้งานจริง (pay-as-you-go) และไม่มีค่าธรรมเนียมแพลตฟอร์ม
TL;DR
- ขนาด: รองรับ 12 โมเดล ตั้งแต่ GPT-OSS 120B (context 125K) ไปจนถึง Kimi K3 และ Qwen3.8 Max (context 1M) โดย Kimi K3 มีขนาด 2.8T พารามิเตอร์ และ Qwen3.8 Max เป็นแบบ MoE ขนาด 2.4T
- ระบบการทำงาน: รันบนระบบจัดการเต็มรูปแบบ โดยคำขอจะส่งไปยัง You.com Inference Direct ก่อน หากระบบขัดข้องจะสลับไปยังพาร์ทเนอร์ที่โฮสต์ในสหรัฐฯ โดยอัตโนมัติ ทำให้ผู้ใช้ไม่ต้องจัดการ GPU เอง
- ประสิทธิภาพ: ผลทดสอบ LiveNewsBench พบว่าโมเดล open-weight เมื่อใช้ร่วมกับระบบค้นหาของ You.com ให้ผลลัพธ์เทียบเท่าโมเดลระดับแนวหน้า (frontier models) แต่ต้นทุนต่ำกว่า
- ดีที่สุด: GLM-5.3 พร้อมการค้นหาของ You.com ทำคะแนนได้ 86.53% โดยมีต้นทุน $0.0485 ต่อคำถาม เทียบกับ $0.0920 สำหรับ Claude Sonnet 5.5
- ราคา: ราคาต่อโทเคนอยู่ในระดับใกล้เคียงกับตลาด โดย Kimi K3 อยู่ที่ $2.85/$14.25 ซึ่งต่ำกว่าราคาของ Together AI ประมาณ 5%
You.com Inference Router คืออะไร?
บริการนี้คือ API หนึ่งเดียวสำหรับเข้าถึงโมเดล open-weight หลากหลายรุ่นผ่าน endpoint https://api.you.com พร้อม เส้นทางที่รองรับ OpenAI และ Anthropic ช่วยให้นักพัฒนาสามารถย้ายโค้ด SDK เดิมมาใช้งานได้ทันทีเพียงเปลี่ยน base URL และ API key
ทีมงาน You.com วางตำแหน่งผลิตภัณฑ์เพื่อแก้ปัญหาการย้ายระบบที่มักติดขัดในขั้นตอนการตรวจสอบความปลอดภัย โดยเฉพาะประเด็นเรื่อง ZDR, การโฮสต์ในสหรัฐฯ และ DPA ซึ่งผู้ให้บริการเฉพาะทางรายอื่นมักมีข้อตกลงการใช้งานขั้นต่ำที่สูงเกินไป Inference Router จึงเข้ามาอุดช่องว่างนี้เพื่อให้ธุรกิจเข้าถึงโมเดลประสิทธิภาพสูงได้ง่ายขึ้น
การกำหนดเส้นทางและการสลับการทำงาน (failover) ทำงานอย่างไร?
ทุกคำขอจะถูกส่งไปยัง You.com Inference Direct ซึ่งเป็นทรัพยากรประมวลผลของบริษัทเองเป็นอันดับแรก หากระบบหนาแน่นหรือขัดข้อง คำขอจะสลับไปยังพาร์ทเนอร์ที่ผ่านการตรวจสอบแล้ว เช่น Parasail, Wafer, Alibaba Cloud, Meta และ Inception โดยมี Prime Intellect ที่กำลังจะเข้าร่วมในอนาคต
พาร์ทเนอร์ทั้งหมดถูกโฮสต์ในสหรัฐฯ 100% และปฏิบัติตามกฎ ZDR อย่างเคร่งครัด ทั้งนี้การสลับการทำงานจะไม่ส่งผลต่อค่าบริการ เนื่องจากแต่ละโมเดลมีการประกาศราคาต่อโทเคนที่คงที่เพียงราคาเดียว นอกจากนี้ยังมีระบบตั้งเพดานการใช้จ่ายและแสดงข้อมูลการใช้งานรายวันอย่างละเอียดภายใต้มาตรฐาน SOC 2
การไม่เก็บรักษาข้อมูล (zero data retention) ครอบคลุมอะไรบ้าง?
นโยบาย ZDR ระบุว่าทั้ง prompt และ output จะถูกประมวลผลในหน่วยความจำเท่านั้นและไม่มีการจัดเก็บข้อมูลถาวร ครอบคลุมทั้งการเรียกใช้โมเดลและการค้นหาเว็บ
You.com จะเก็บเฉพาะเมทาดาต้าที่จำเป็นต่อการดำเนินงาน เช่น จำนวนโทเคนและประทับเวลา แต่จะไม่มีการเก็บ hash ของ prompt หรือข้อความที่ระบุตัวตนได้ รวมถึงไม่มีการเก็บแคชของ prompt ลงในดิสก์อย่างเด็ดขาด
มีโมเดลใดบ้างที่ใช้งานได้ และราคาเท่าไหร่?
ปัจจุบันมี 12 โมเดลที่พร้อมใช้งานบนโฮสต์ในสหรัฐฯ โดยราคาต่อ 1 ล้านโทเคน (input / output) มีดังนี้:
- Kimi K3 (Moonshot AI): $2.85 / $14.25 (context 1M)
- Qwen3.8 Max (Alibaba): $1.85 / $5.55 (context 1M)
- GLM 5.3 (Z.ai): $1.35 / $4.25 (context 1M)
- DeepSeek V4 Pro: $1.65 / $3.65 (context 1M)
- DeepSeek V4.1 Flash: $0.30 / $1.20 (context 1M)
- Mercury 3 (Inception): $0.10 / $0.35 (context 1M)
- GPT-OSS 120B (OpenAI): $0.097 / $0.73 (context 125K)
นอกจากนี้ยังมีโมเดลอื่นๆ เช่น Muse Wonder, Muse Spark 1.3, GLM 5.3 Flash, Qwen3.8 Flash และ MiniMax M3 รวมอยู่ในรายการด้วย
ระบบการค้นหาเว็บในตัวทำงานอย่างไร?
นักพัฒนาสามารถเรียกใช้เครื่องมือ web_search หรือ web_extract ผ่าน router เพื่อให้โมเดลทำการค้นหาข้อมูลได้ทันที เอกสารคู่มือ ระบุว่ารองรับผลลัพธ์สูงสุด 20 รายการต่อการค้นหา และกำหนดค่าเริ่มต้นได้ 30 รอบ โดยจะส่งคืนข้อมูลพร้อมการอ้างอิง (citations)
การค้นหาทำงานบนเซิร์ฟเวอร์เดียวกับโมเดล ซึ่ง You.com พบว่าช่วยลดความหน่วง (latency) ได้สูงสุดถึง 15% เมื่อเทียบกับระบบทั่วไป
ผลการทดสอบ benchmark เป็นอย่างไร?
You.com รายงานผลการทดสอบ LiveNewsBench จำนวน 1,329 คำถาม ผ่าน การประเมินการค้นหาแบบโอเพนซอร์สของ Braintrust โดยมีข้อมูลดังนี้:
| การตั้งค่า | ความแม่นยำ | ต้นทุนเฉลี่ยต่อคำถาม |
|---|---|---|
| GPT-6.1 Sol พร้อมการค้นหาในตัว | 86.53% | $0.0591 |
| GLM-5.3 + การค้นหาของ You.com | 86.53% | $0.0485 |
| Claude Sonnet 5.5 พร้อมการค้นหาในตัว | 86.38% | $0.0920 |
| DeepSeek V4.1 Flash + การค้นหาของ You.com | 84.12% | $0.0215 |
DeepSeek V4.1 Flash มีต้นทุนถูกกว่า Claude Sonnet 5.5 ประมาณ 77% โดยมีคะแนนประสิทธิภาพตามหลังเพียงเล็กน้อยเท่านั้น
นอกจากนี้ You.com ยังร่วมกับ NVIDIA และ CoreWeave ในการทำ post-training ให้กับ Nemotron 3.5 Lightning ซึ่งช่วยยกระดับคะแนน BrowseComp และลดการเรียกใช้เครื่องมือ (tool calls) ลงได้ถึง 30%
เปรียบเทียบกับ OpenRouter, Together AI และ Fireworks AI
จุดเด่นที่ชัดเจนของ You.com Inference Router คือการรับประกัน SLA 99.9% ในรูปแบบจ่ายตามจริง และการโฮสต์ในสหรัฐฯ 100% ซึ่งหาได้ยากในผู้ให้บริการรายอื่นที่มักเป็นแบบ best-effort หรือต้องจ่ายเพิ่มพิเศษสำหรับ US-only
ด้านค่าธรรมเนียม You.com คิดที่ 0% ขณะที่ OpenRouter มีค่าธรรมเนียมการซื้อเครดิต 5.5% และในแง่ของราคาโมเดลอย่าง Kimi K3 นั้น You.com มีราคาถูกกว่าตัวเลือก US-only ของ Fireworks AI ถึง 37% ในส่วนของค่า input
ประเด็นสำคัญ
- รวมโมเดล open-weight ชั้นนำไว้ใน API เดียวที่ใช้งานง่ายและยืดหยุ่น
- เน้นความปลอดภัยสูงสุดด้วย ZDR และการโฮสต์ข้อมูลในสหรัฐฯ ทั้งระบบ
- ให้ความคุ้มค่าด้วยค่าธรรมเนียม 0% และประสิทธิภาพที่เทียบเท่าโมเดลระดับเรือธงในราคาที่ถูกกว่า
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร