
Architect เปิดตัว Liquid Inference ตลาดประมูลค่าประมวลผล LLM แบบเรียลไทม์
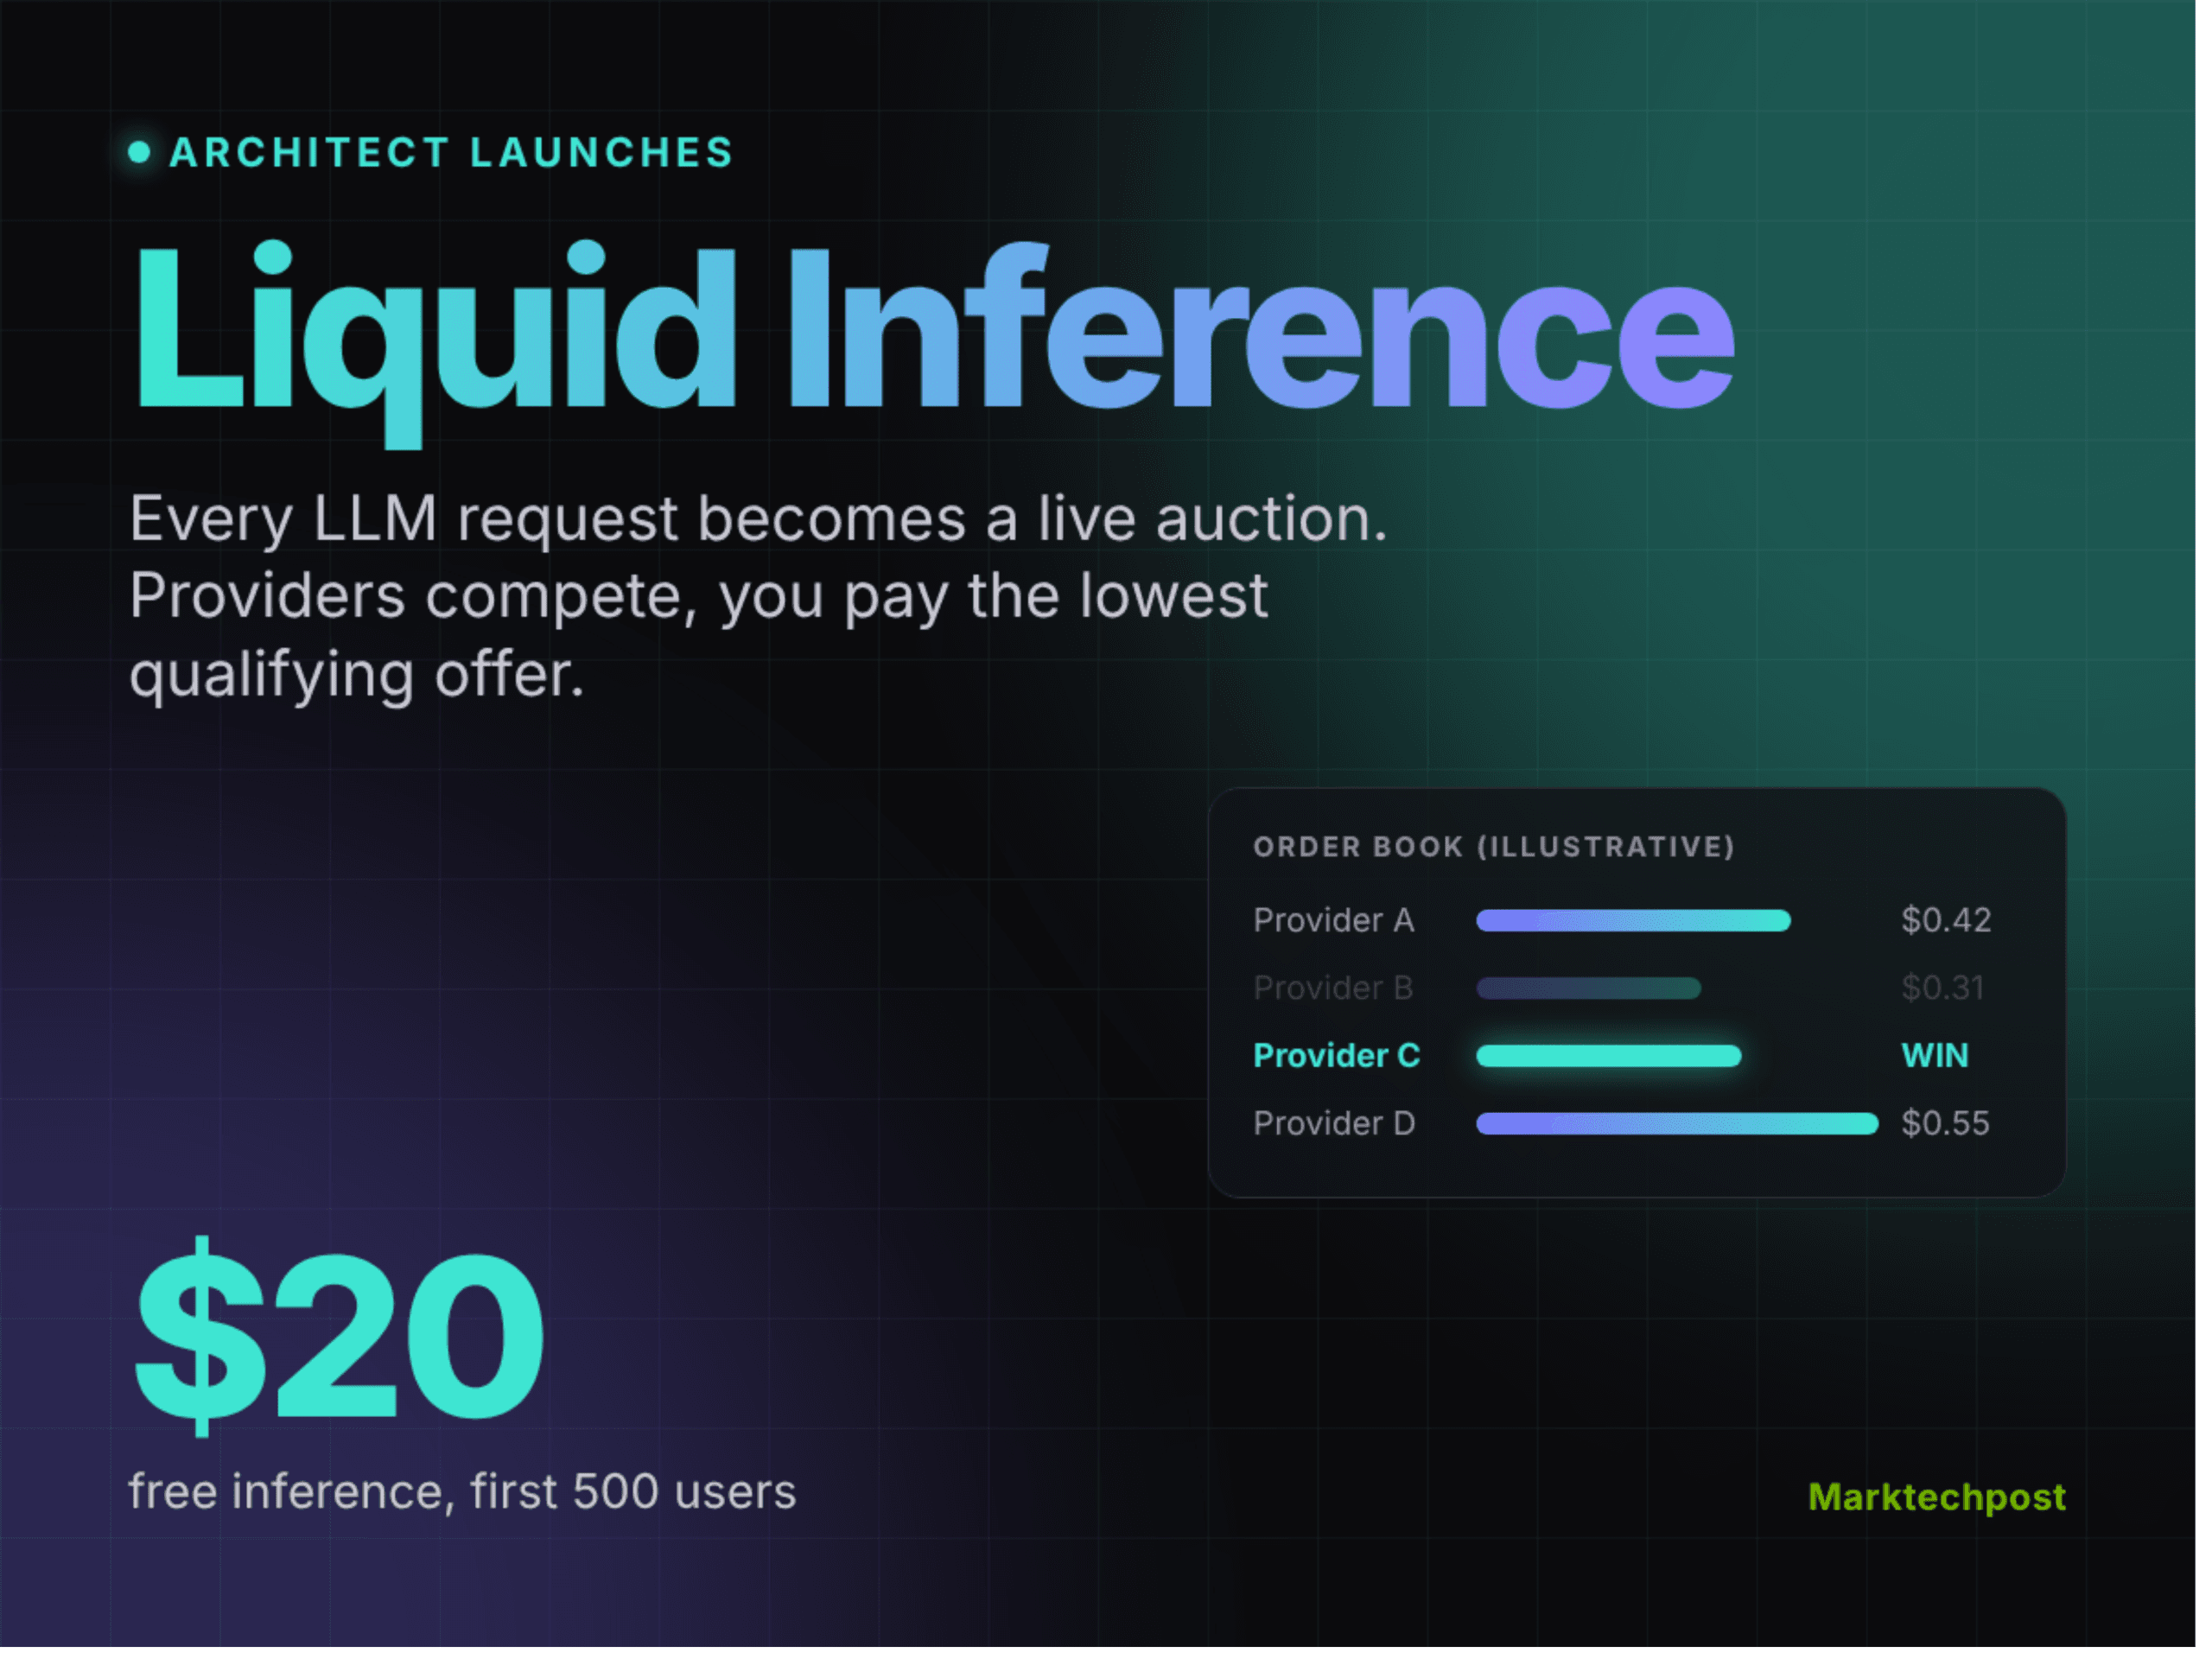
Architect Financial Technologies เปิดตัว Liquid Inference แพลตฟอร์ม LLM router รูปแบบใหม่ที่นำระบบประมูลสดมาใช้กับทุกคำขอ (request) โดย Liquid Inference ทำหน้าที่เป็นตลาดกลางสำหรับการประมวลผล LLM (Inference) ที่เปิดให้ผู้ให้บริการเข้ามาเสนอราคา (bid) แข่งขันกันเพื่อรับส่งข้อมูลในแต่ละ prompt ซึ่งผู้ซื้อจะจ่ายในราคาต่ำที่สุดตามกฎที่ตั้งไว้
สำหรับนักพัฒนา การใช้งานแพลตฟอร์มนี้ทำได้ง่ายเพียงแค่เปลี่ยน base URL โดยไม่ต้องแก้ไขโค้ดเดิม และปล่อยให้ระบบจัดการหาผู้ให้บริการที่เสนอราคาดีที่สุดให้โดยอัตโนมัติ
Liquid Inference คืออะไร?
Liquid Inference คือ router ประมวลผล LLM ในรูปแบบตลาดแลกเปลี่ยน (exchange-style) ข้อมูลจาก Architect ระบุว่าผู้ให้บริการจะลงประกาศข้อเสนอสำหรับโมเดลที่กำหนด และทุกคำขอจะเข้าสู่การประมูลในกลุ่มผู้ให้บริการรายต่างๆ โดยข้อเสนอที่ราคาต่ำที่สุดและตรงตามเกณฑ์ของผู้ซื้อจะเป็นผู้ชนะ
ผลิตภัณฑ์นี้พัฒนาโดยบริษัทเชี่ยวชาญด้านการซื้อขายสินทรัพย์อย่าง Architect ซึ่งเป็นผู้ดำเนินงาน AX perpetual futures exchange โดยในเดือนพฤษภาคม 2026 บริษัทได้ เข้าซื้อ US Designated Contract Market เพื่อเตรียมจดทะเบียนซื้อขาย GPU compute futures ซึ่งกำลังรอการตรวจสอบจากหน่วยงานกำกับดูแล ทีมงานจึงนำประสบการณ์จากตลาดการเงินมาสร้างระบบค้นหาราคาแบบสองทางสำหรับการประมวลผล AI
การประมูลการประมวลผล (Inference auction) ทำงานอย่างไร?
กระบวนการทำงานแบ่งออกเป็น 4 ขั้นตอนหลัก:
- Request: ลูกค้าส่งคำสั่งใช้งาน API ตามมาตรฐาน OpenAI หรือ Anthropic
- Rules: ระบบกรองข้อเสนอตามเงื่อนไขและข้อจำกัดที่ผู้ซื้อตั้งไว้
- Auction: ผู้ให้บริการแข่งขันกันเสนอราคา โดยรายที่ผ่านเกณฑ์และให้ราคาต่ำสุดจะเป็นผู้ชนะ
- Receipt: ระบบจะล็อคราคาสูงสุดไว้ก่อนเริ่มสร้างข้อความ และเรียกเก็บเงินตามการใช้งานจริงเท่านั้น
ผู้ซื้อสามารถกำหนดเงื่อนไขได้ละเอียด เช่น เพดานต้นทุนต่อหนึ่งงาน, ขีดจำกัดเวลาจนถึงโทเคนแรก (time to first token) และอัตราการประมวลผลขั้นต่ำ (minimum throughput) นอกจากนี้ยังระบุภูมิภาคที่อนุญาต, การไม่จัดเก็บข้อมูล (zero data retention) และรายการอนุญาต (allow lists) ของผู้ให้บริการได้ โดยใน โพสต์บน LinkedIn ของ Harrison ระบุว่าระบบรองรับ multi-modal เต็มรูปแบบ
ความโดดเด่นอีกประการคือเจ้าของบัญชีสามารถดู order books แบบสดๆ รวมถึงรายการธุรกรรมที่ชำระบัญชีแล้ว ซึ่งเป็นระดับข้อมูลตลาดที่ไม่ค่อยพบเห็นในบริการ LLM API ทั่วไป
ผู้ซื้อจะได้รับอะไร?
- ความเข้ากันได้แบบ drop-in กับเครื่องมือช่วยเขียนโค้ด อาทิ Claude Code, Codex, OpenCode, Cursor, Pi และ Cline ตามที่ระบุใน โพสต์
- สิทธิประโยชน์สำหรับผู้ใช้ 500 รายแรก จะได้รับเครดิต inference ฟรี 20 ดอลลาร์
- โปรแกรมแนะนำเพื่อน: รับเครดิตคืน 20% จากค่าธรรมเนียมของผู้ที่แนะนำ และรับเพิ่ม 10% จากการแนะนำในระดับที่สอง
ผู้ให้บริการการประมวลผล (Inference providers) จะได้รับอะไร?
ผู้ให้บริการสามารถเชื่อมต่อผ่านแอป Liquid Inference โดย Harrison เผยว่ารายใหม่สามารถผ่านการตรวจสอบได้ภายในไม่กี่นาที ทุก prompt จะใช้มาตรฐาน OpenAI API และมี REST/WebSocket API สำหรับลงทะเบียนโมเดลและเสนอราคา
ระบบนี้เปิดโอกาสให้ผู้ให้บริการอัปเดตราคาตามต้นทุนจริง ช่วยให้สามารถขายความจุ GPU ที่ว่างอยู่ได้ตามต้องการ โดยการชำระเงินจะดำเนินการผ่าน Stripe พร้อมบันทึกรายละเอียดงานอย่างครบถ้วน
Liquid Inference เปรียบเทียบกับ OpenRouter และ Hugging Face อย่างไร?
| คุณสมบัติ | Liquid Inference | OpenRouter | Hugging Face Inference Providers |
|---|---|---|---|
| รูปแบบการเลือกเส้นทาง (Routing model) | ประมูลต่อคำขอท่ามกลางผู้ให้บริการที่เสนอราคา | การจัดสมดุลภาระงานตามน้ำหนักราคา (inverse square of price) | ผู้ให้บริการที่เร็วที่สุดโดยค่าเริ่มต้น; ต่อท้ายด้วย :cheapest เป็นตัวเลือกเสริม |
| จำนวนโมเดล / ผู้ให้บริการ | โมเดล "หลายร้อย" แบบ; ไม่เปิดเผยรายชื่อผู้ให้บริการ | 500+ โมเดล, 80+ ผู้ให้บริการ | พาร์ทเนอร์ที่ระบุไว้ 18 ราย |
| ความเข้ากันได้ของ API | เข้ากันได้กับ OpenAI และ Anthropic | เข้ากันได้กับ OpenAI | เข้ากันได้กับ OpenAI, เฉพาะ chat เท่านั้น |
| เพดานราคา | ล็อคราคาสูงสุดก่อนโทเคนแรก | พารามิเตอร์ max_price | ไม่เปิดเผย |
| การควบคุมข้อมูล | ZDR, ภูมิภาค, allow lists | zdr, data_collection, only/ignore | ลำดับความชอบของผู้ให้บริการ |
| ค่าธรรมเนียมแพลตฟอร์ม | ไม่เปิดเผย | ค่าธรรมเนียมบัตรเครดิต 5.5%, ขั้นต่ำ $0.80 | ไม่มีค่าส่วนต่าง |
| เครดิตฟรี | $20 สำหรับผู้ใช้ 500 รายแรก | ไม่เปิดเผย | ฟรี $0.10/เดือน, $2.00 สำหรับ PRO |
| ข้อมูลตลาดสาธารณะ | Order books สดและรายการเทรดที่ชำระบัญชีแล้ว | ไม่เปิดเผย | ไม่เปิดเผย |
สรุปประเด็นสำคัญ
Liquid Inference พลิกโฉมการใช้ LLM ด้วยระบบประมูลรายคำขอที่โปร่งใส รองรับการใช้งานร่วมกับเครื่องมือยอดนิยมอย่าง Claude Code และ Cursor ได้ทันที พร้อมการล็อคราคาสูงสุดเพื่อป้องกันงบประมาณบานปลาย
อย่างไรก็ตาม ข้อมูลสำคัญบางส่วน เช่น รายชื่อผู้ให้บริการทั้งหมด อัตราค่าธรรมเนียมแพลตฟอร์มที่ชัดเจน และสถิติความหน่วง (latency) แบบสาธารณะ ยังไม่มีการเปิดเผยออกมาในขณะนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร