
BottleCap AI เปิดตัว ThinkingCap-Qwen3.8-27B ลดโทเคนการคิดลง 37%
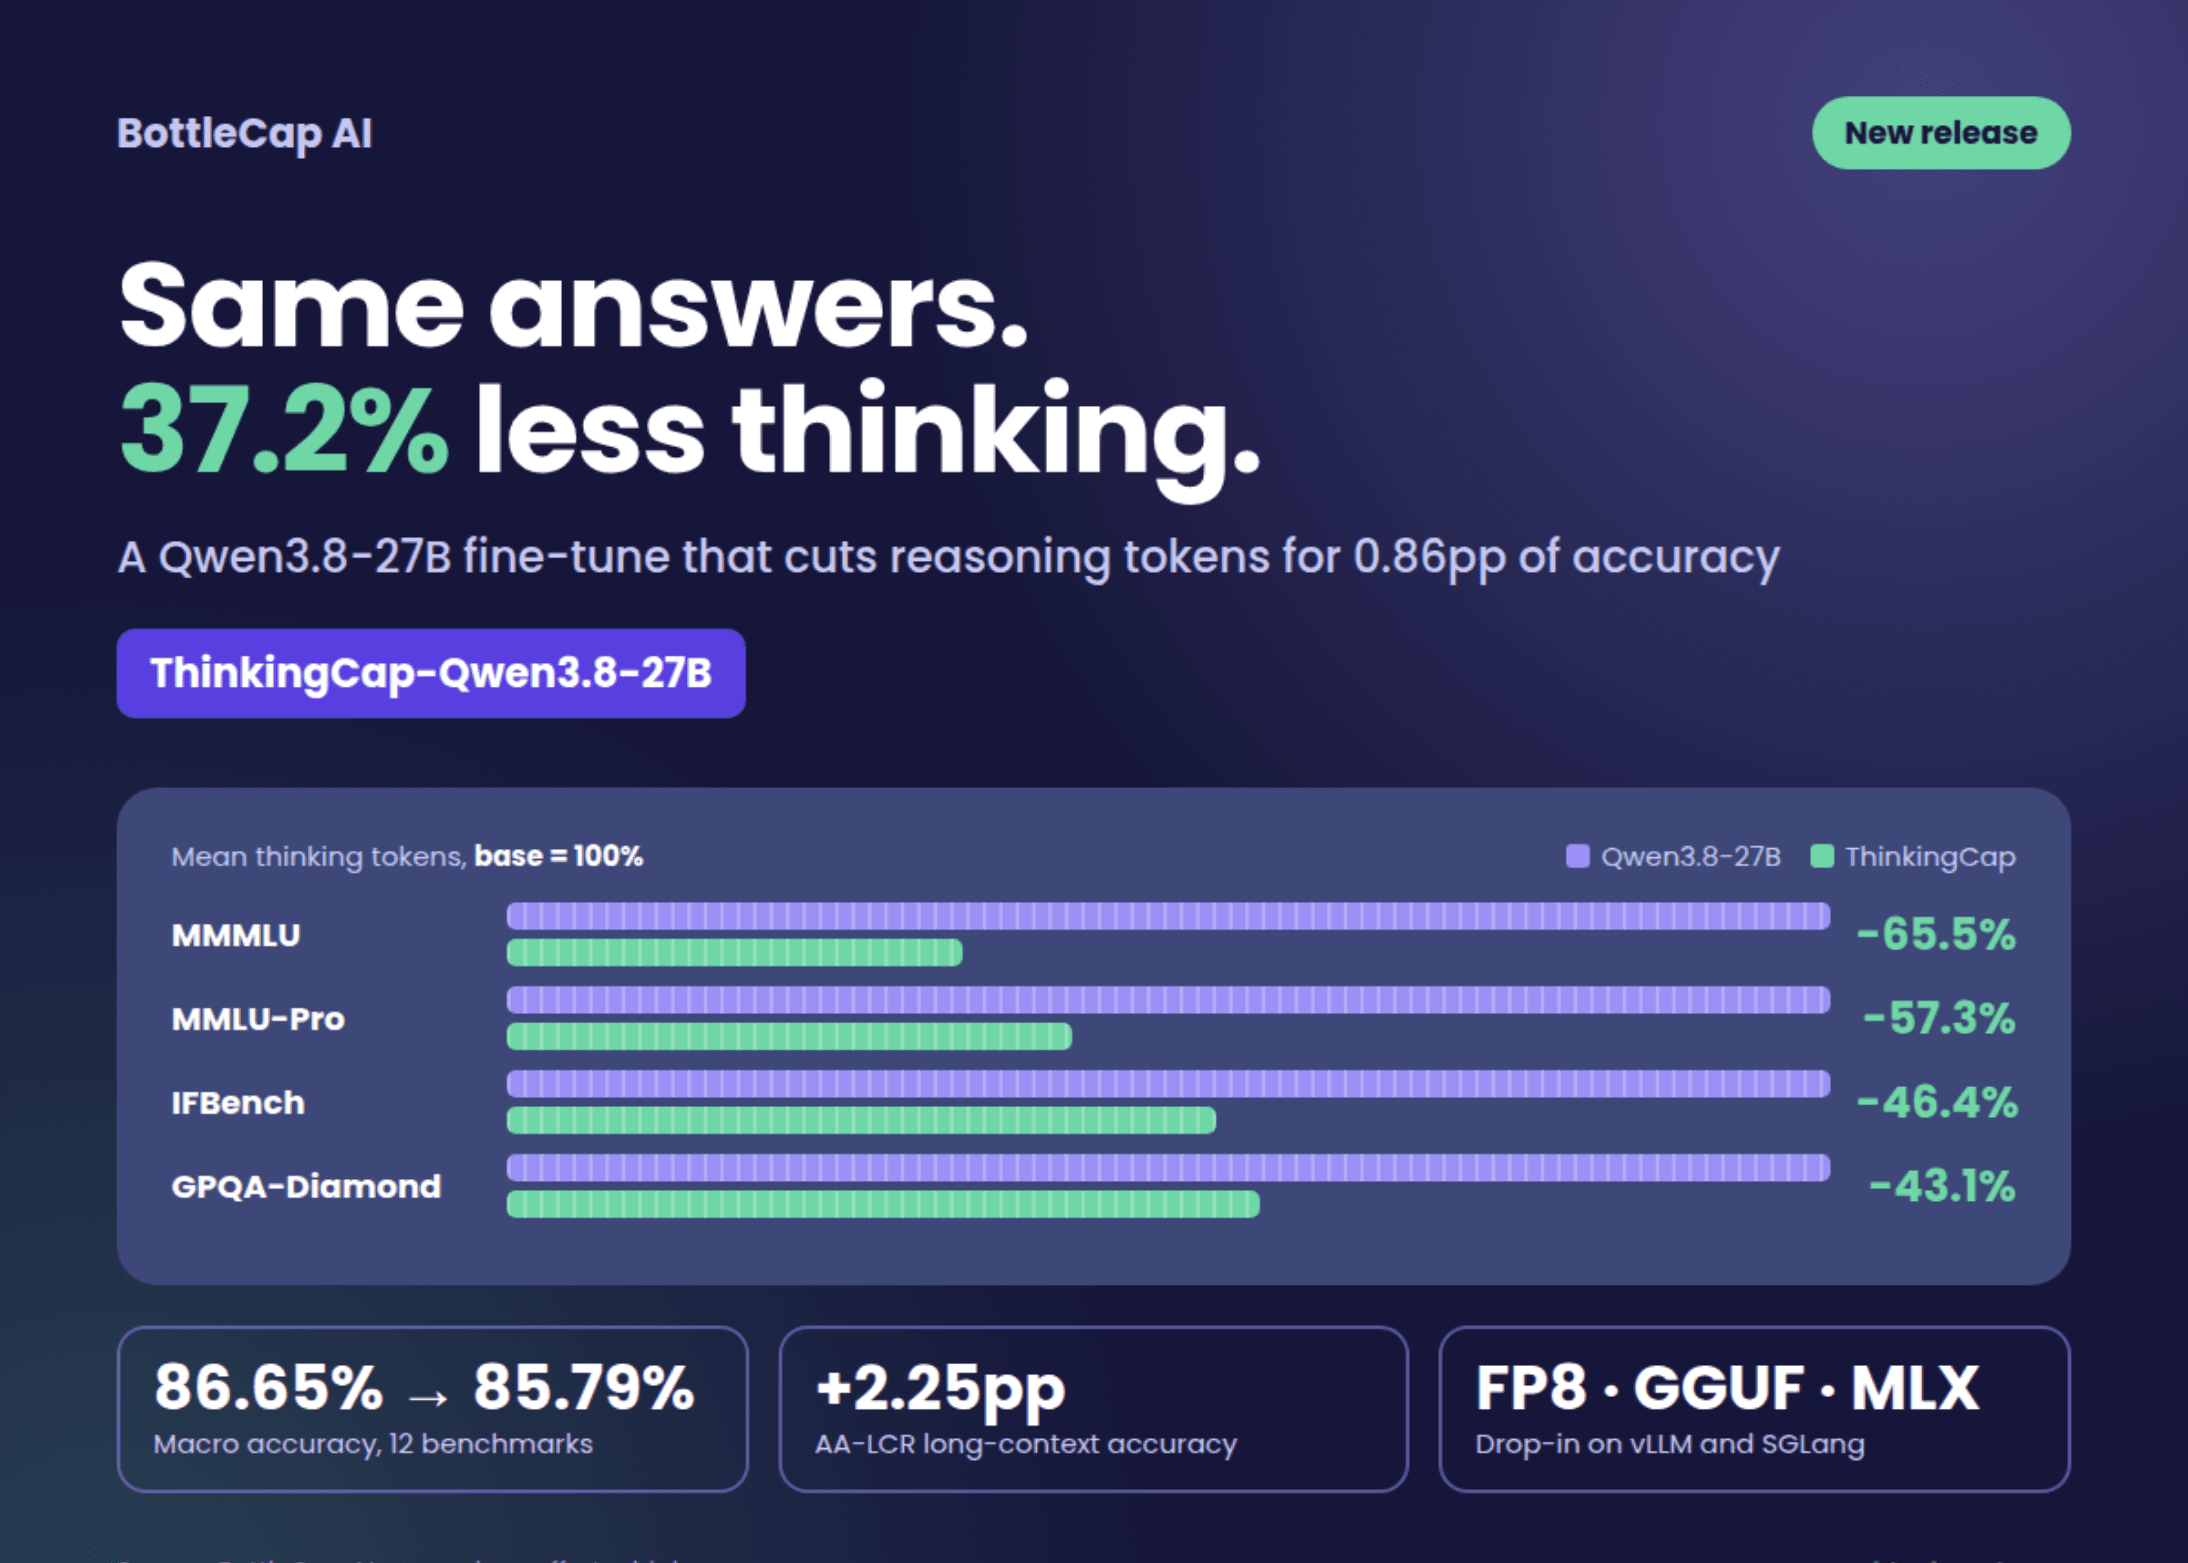
BottleCap AI ได้เปิดตัว ThinkingCap-Qwen3.8-27B โมเดลลำดับที่สองในซีรีส์ ThinkingCap ที่ผ่านการ fine-tune จาก Qwen3.8-27B โดยเน้นเป้าหมายหลักคือการทำให้กระบวนการใช้เหตุผล (reasoning traces) สั้นลง
จากการทดสอบ 12 benchmark พบว่าโมเดลนี้ใช้ thinking tokens น้อยลงเฉลี่ย 37.2% ขณะที่ความแม่นยำเฉลี่ยแบบ Macro-average ลดลงเพียงเล็กน้อยจาก 86.65% เหลือ 85.79% หรือต่างกันเพียง 0.86pp เท่านั้น ซึ่งผู้ใช้งานสามารถนำไปใช้แทนโมเดลเดิมบน vLLM หรือ SGLang ได้ทันที โดยมีให้เลือกทั้งเวอร์ชัน FP8, NVFP4, GGUF และ MLX
ThinkingCap ตั้งเป้าแก้ปัญหาอะไร?
ปัจจุบันโมเดลการใช้เหตุผล (reasoning models) มักสร้าง thinking tokens มากเกินความจำเป็น ซึ่ง BottleCap มองว่าโทเคนส่วนเกินเหล่านี้ไม่ได้ส่งผลต่อคำตอบสุดท้าย แนวคิดนี้เคยถูกนำมาใช้แล้วใน การเปิดตัวครั้งแรกในซีรีส์นี้ กับโมเดล Qwen3.6-27B
สำหรับการพัฒนาครั้งนี้ ทีมวิจัยมุ่งเน้นความสามารถในการใช้เหตุผล การปฏิบัติตามคำสั่ง และความปลอดภัยให้คงเดิม โดยให้ความสำคัญเป็นพิเศษกับ benchmark ด้านคณิตศาสตร์ การใช้เหตุผล บริบทข้อมูลยาว (long-context) และการทำงานแบบ agentic
ผลการทดสอบ Benchmark ที่ระดับความพยายาม xhigh
ในการทดสอบด้วยค่า reasoning_effort=xhigh พบว่าความยาวของโทเคนลดลงในทุก benchmark ตั้งแต่ 10.7% ไปจนถึง 65.5% โดยเฉพาะงานด้านความรู้และภาษาที่ลดลงอย่างเห็นได้ชัด เช่น MMMLU ลดลงถึง 65.5% และ MMLU-Pro ลดลง 57.3% ขณะที่ IFBench ใช้การคิดน้อยลง 46.4% โดยรักษาความแม่นยำไว้ได้เกือบเท่าเดิมที่ 79.71%
จุดเด่นที่น่าสนใจคือการดึงข้อมูลจากบริบทที่ยาว (Long-context retrieval) ซึ่งทำได้ดีขึ้น โดยความแม่นยำ AA-LCR เพิ่มขึ้น 2.25pp เป็น 84.00% แม้จะใช้โทเคนน้อยลง 38.6% ก็ตาม ส่วนงานด้าน Agentic ยังคงมีประสิทธิภาพใกล้เคียงกับโมเดลฐาน โดยลดการใช้โทเคนได้ 10.7% ถึง 30.9% ขึ้นอยู่กับรูปแบบการทดสอบ
อย่างไรก็ตาม การประหยัดโทเคนนี้แลกมาด้วยความแม่นยำที่ลดลงในบางจุด โดยเฉพาะ AIME 2026 ที่ลดลง 3.85pp เหลือ 94.27% นอกจากนี้ BottleCap ยังพบว่า ThinkingCap ช่วยลดปัญหาการตอบแบบถูกตัดตอน (truncated traces) และการทำงานวนซ้ำ (looping) ได้ดีกว่าโมเดลฐานเมื่อจำกัดงบประมาณโทเคนที่ 16K
การโต้ตอบกับระดับความพยายาม (Effort Dial)
ThinkingCap ยังคงรองรับการตั้งค่าระดับความพยายามในการใช้เหตุผลของ Qwen3.8-27B ได้อย่างสมบูรณ์ จากการเปรียบเทียบ 11 benchmark พบว่าในระดับ medium และ low โมเดลนี้สามารถลดการใช้โทเคนได้มากกว่าโมเดลฐาน แต่ความแม่นยำจะลดลงตามสัดส่วน
ทีม BottleCap แนะนำให้ผู้ใช้ตั้งค่าไว้ที่ระดับ xhigh เพื่อให้ได้ความสมดุลระหว่างความแม่นยำและจำนวนโทเคนที่เหมาะสมที่สุด โดยโหมดการคิดในแต่ละระดับจะได้รับการปรับปรุงประสิทธิภาพเพิ่มเติมในการอัปเดตครั้งต่อไป
วิธีการทดสอบ
โมเดลทั้งสองถูกรันบนระบบเดียวกันโดยใช้ NVIDIA H200 และ vLLM 0.29.0 ด้วยการตั้งค่า sampling ที่เหมือนกันทุกประการ ทีมงานใช้การคำนวณค่าเฉลี่ยแบบ multi-seed เพื่อความแม่นยำ โดยมีช่วงความเชื่อมั่น 95% นอกจากนี้ยังทดสอบเทคนิค MTP speculative decoding ซึ่งพบว่าไม่มีผลกระทบต่อความแม่นยำใน AIME 2026
การใช้งาน: เวอร์ชันต่างๆ, การให้บริการ และใบอนุญาต
โมเดลเวอร์ชันหลักมีพารามิเตอร์ 28B รองรับทั้งภาพและข้อความ โดย BottleCap ได้เผยแพร่เวอร์ชัน quantized ทั้งหมด 5 รูปแบบ:
- FP8: สำหรับ vLLM และการ์ดจอ NVIDIA สถาปัตยกรรม Hopper/Blackwell
- NVFP4 weight-only: ขนาด 21 GB สำหรับ vLLM
- NVFP4 W4A4 (AWQ): เฉพาะสถาปัตยกรรม Blackwell
- GGUF: สำหรับ llama.cpp, LM Studio และ Ollama
- MLX 4-bit DWQ: สำหรับ Apple Silicon Mac (RAM 32 GB ขึ้นไป)
สำหรับการใช้งานเชิงพาณิชย์จะอยู่ภายใต้ใบอนุญาต PolyForm Small Business 1.0.0 ซึ่งต้องขอสิทธิ์จาก BottleCap หากไม่เข้าเกณฑ์ธุรกิจขนาดเล็ก ส่วนข้อมูลต้นทางจาก Qwen ยังคงใช้ใบอนุญาต Apache-2.0 เช่นเดิม
ประเด็นสำคัญ
- ใช้ thinking tokens น้อยลงเฉลี่ย 37.2% จากการทดสอบ 12 benchmark
- ความแม่นยำรวมลดลงเพียง 0.86pp (จาก 86.65% เหลือ 85.79%)
- ประสิทธิภาพในบริบทข้อมูลยาวดีขึ้น (AA-LCR เพิ่มขึ้น 2.25pp)
- ใช้งานแทน Qwen3.8-27B ได้ทันที พร้อมรองรับ flag เดิมบน vLLM และ SGLang
- แจกจ่ายภายใต้ใบอนุญาตจำกัดการเข้าถึง (Gated) สำหรับธุรกิจขนาดเล็ก
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร