
Google เปิดตัว AI video co-director เฟรมเวิร์กสร้างวิดีโอยาวแบบไร้รอยต่อ
ความก้าวหน้าล่าสุดในการแพร่กระจายวิดีโอ (video diffusion) แสดงให้เห็นถึงการสร้างวิดีโอที่มีความแม่นยำสูง (high-fidelity) ได้อย่างน่าทึ่งภายในเวลาไม่กี่วินาที อย่างไรก็ตาม แม้โมเดล diffusion จะสร้างคลิปสั้นๆ ได้อย่างยอดเยี่ยม แต่การเชื่อมโยงคลิปเหล่านั้นให้กลายเป็นการเล่าเรื่องที่ยาวและมีความสอดคล้องกันยังคงเป็นเรื่องที่ท้าทาย
ปัจจุบันไปป์ไลน์แบบเอเจนต์ (agentic pipelines) ส่วนใหญ่ มักประสบปัญหา ความเบี่ยงเบนทางอรรถศาสตร์ (semantic drift) เช่น เครื่องแต่งกายตัวละครหรือทิวทัศน์เปลี่ยนไปในแต่ละช็อต และ ความล้มเหลวแบบต่อเนื่อง (cascading failures) ที่ข้อผิดพลาดในระยะแรกแพร่กระจายจนทำลายความสอดคล้องในระยะยาว เนื่องจากระบบใช้พรอมต์แยกกันและเขียนด้วยมือ ทำให้ต้องอาศัยมนุษย์คอยแก้ไขตลอดเวลา สิ่งนี้สะท้อนถึงปัญหาการมอบหมายความดีความชอบแบบคลาสสิก (classical credit assignment problem) เพราะยากจะระบุว่าความล้มเหลวในตอนท้ายเกิดจากพรอมต์ใด ยิ่งไปกว่านั้นยังพบปัญหา ความเบี่ยงเบนของฟีเจอร์ (feature drift) ที่เอนทิตีค่อยๆ เปลี่ยนไป และ การล่มสลายของเนื้อหา (content collapse) ที่เนื้อเรื่องไม่คืบหน้า
ล่าสุดเราจึงได้แนะนำงานวิจัยเกี่ยวกับ "ผู้กำกับสนร่วม AI สำหรับวิดีโอ (AI video co-director)" ซึ่งเป็นเฟรมเวิร์กมัลติเอเจนต์ (multi-agent) แบบครบวงจรเพื่อวางแผนความต่อเนื่องทางสายตาในเรื่องเล่าแบบหลายช็อต โดยถูกสร้างเป็นเลเยอร์การจัดเตรียม (orchestration layer) บน Gemini และ Veo พร้อมสืบทอดกลไกความปลอดภัยโดยกำเนิดอย่าง การใส่ลายน้ำ SynthID (SynthID watermarking)
การจัดการสร้างวิดีโอยาวถูกมองเป็นปัญหาการเพิ่มประสิทธิภาพระดับโลก (global optimization) และการติดตามสถานะของโลก จนเกิดเป็นชุดเฟรมเวิร์ก ได้แก่ Co-Director (เตรียมเผยแพร่ที่ COLM 2026), CANVAS (เตรียมเผยแพร่ที่ EMNLP 2026), A²RD, และ VQQA ซึ่งช่วยแปลงความต้องการสร้างสรรค์ของมนุษย์ไปสู่การปฏิบัติ โดยจัดการงานที่ซ้ำซากจำเจให้แบบอัตโนมัติ ตั้งแต่การใช้พรอมต์กับหลายโมเดล การเชื่อมโยงช็อต ไปจนถึงการปรับแต่งภาพแบบวงปิด (closed-loop visual refinement)
เฟรมเวิร์กเหล่านี้ถูกออกแบบมาเพื่อเป็นพันธมิตรทางความคิดสร้างสรรค์ ช่วยรักษาความต่อเนื่องทางสายตาเพื่อให้ผู้ใช้จดจ่อกับการเล่าเรื่องได้อย่างเต็มที่ สถาปัตยกรรมนี้แยกการสังเคราะห์ความคิดสร้างสรรค์ออกจากความสอดคล้อง โดยจำลองคุณภาพเป็นวัตถุประสงค์ในเวลาทดสอบ (test-time objective) ซึ่งจากการประเมินพบว่าช่วยพัฒนาความสอดคล้องของการเล่าเรื่องและความคงอยู่ของตัวละครในวิดีความยาวหลายนาทีได้อย่างมีนัยสำคัญ พร้อมลดความเบี่ยงเบนทางสายตาและข้อผิดพลาดในไปป์ไลน์
วิธีการทำงาน
เราได้แบ่งงานวิจัยออกเป็นสี่เสาหลักพื้นฐาน เพื่อแก้ปัญหาคอขวดที่เฉพาะเจาะจงในไปป์ไลน์การสร้างสรรค์วิดีโอระยะยาว
1. การจัดเตรียมเจตนาเชิงสร้างสรรค์ด้วยผู้กำกับสนร่วม AI สำหรับวิดีโอ เพื่อควบคุมความสอดคล้องทางอรรถศาสตร์ เรานำเสนอ ผู้กำกับสนร่วม AI สำหรับวิดีโอ (AI video co-director) เฟรมเวิร์กมัลติเอเจนต์แบบลำดับชั้นที่เปลี่ยนการเล่าเรื่องเป็นปัญหาการเพิ่มประสิทธิภาพระดับโลก แทนที่จะใช้โซ่พรอมต์แบบเส้นตรงที่เข้มงวด เราใช้การกำหนดพารามิเตอร์แบบลำดับชั้นร่วมกับ multi-armed bandit (MAB) ในการระบุทิศทางสร้างสรรค์ในระดับโลก
กระบวนการนี้สร้างขึ้นเพื่อค้นหาความสมดุลระหว่างการสำรวจกลยุทธ์เล่าเรื่องแบบใหม่ กับการใช้ประโยชน์จากองค์ประกอบเดิมที่มีประสิทธิภาพ ระบบจะสุ่มตัวอย่างเส้นทางความคิดสร้างสรรค์ที่เป็นนามธรรม เช่น การผสมกลยุทธ์ข้อมูลเข้ากับโหมดการเล่าเรื่องสั้น (vignette) และอาร์คิไทป์สุนทรียศาสตร์ (aesthetic archetype) แล้วแทรกเข้าระบบพรอมต์ของเอเจนต์ย่อยอย่างไดนามิก การควบคุมจากบนลงล่างนี้ทำให้ไปป์ไลน์ทำงานภายใต้วิสัยทัศน์เดียวกัน โดยเฟรมเวิร์กจะป้อนพรอมต์ที่มีโครงสร้างไปยัง Gemini และ Veo โดยตรง (แต่สถาปัตยกรรมนี้เป็นแบบ model-agnostic จึงใช้กับโมเดลพื้นฐานใดก็ได้) ช่วยให้มั่นใจว่ารูปภาพ วิดีโอ และเสียง มีระบบป้องกันความปลอดภัยรวมถึงการใส่ลายน้ำ SynthID ทั้งยังสามารถใช้ตัวจำแนกความปลอดภัยเพิ่มเติมกับวิดีโอสุดท้ายเพื่อป้องกันปฏิสัมพันธ์เชิงบริบทที่ไม่ตั้งใจระหว่างคลิปได้ด้วย
ไปป์ไลน์ดำเนินการเพิ่มประสิทธิภาพระดับโลกผ่านสองลูปที่เชื่อมต่อกัน คือ การควบคุมเชิงกลยุทธ์และการผลิตหลายขั้นตอน เริ่มจากเอเจนต์ผู้จัดเตรียม (Orchestrator Agent) ประเมินข้อมูลนำเข้าด้วย MAB เพื่อเลือกองค์ประกอบสร้างสรรค์ใน 3 มิติ ได้แก่ (1) กลยุทธ์การสร้างสรรค์ (เจตนา), (2) โหมดการเล่าเรื่อง (โครงสร้างเรื่องราว), และ (3) อาร์คิไทป์สุนทรียศาสตร์ (โทนภาพและภาพยนตร์)
องค์ประกอบนี้จะขับเคลื่อนลำดับชั้นการผลิต โดยเอเจนต์ก่อนการผลิต (Pre-Production Agent) จะสังเคราะห์โครงเรื่องฉากสั้นและสินทรัพย์ภาพลงสตอรี่บอร์ด จากนั้นเอเจนต์การผลิต (Production Agent) จะแปลสตอรี่บอร์ดเป็นสื่อภาพและเสียงผ่านเอเจนต์ย่อยเฉพาะทาง ได้แก่ เอเจนต์คีย์เฟรม (Keyframe Agent) ยึดภาพตัวละครและฉาก, เอเจนต์วิดีโอ (Video Agent) เพิ่มการเคลื่อนไหว, และเอเจนต์เสียง (Audio Agent) ใส่เสียงบรรยายและดนตรีประกอบ
ในท้ายที่สุด ผู้ตัดสิน LLM หลายรูปแบบ (multimodal LLM) (MLLM) จะวิจารณ์วิดีโอใน 3 มิติข้างต้น และส่งสัญญาณรางวัลกลับไปยัง MAB เพื่อปรับแต่งและเพิ่มประสิทธิภาพตัวเลือกซ้ำๆ ในลูปการสร้างต่อเนื่อง
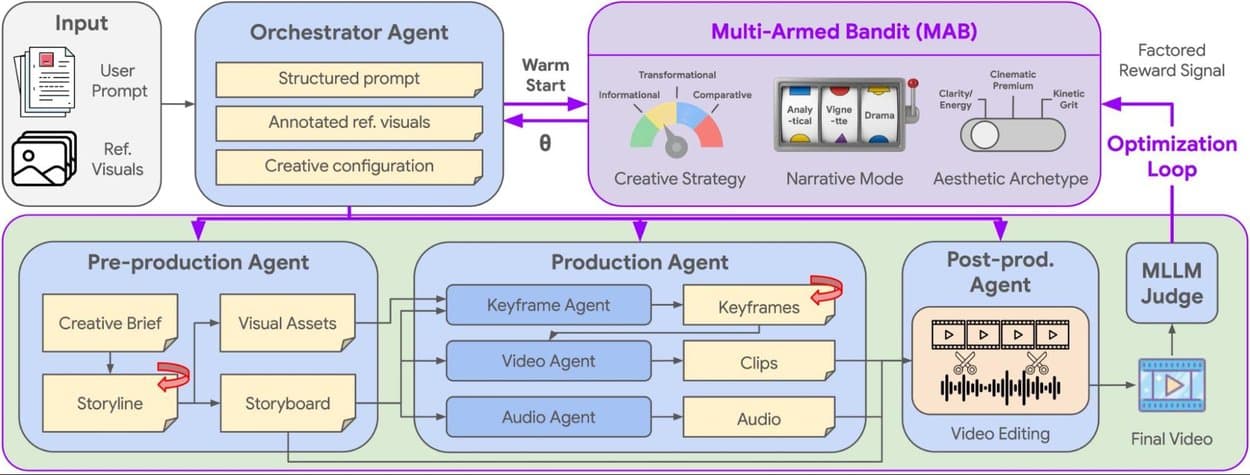
ไปป์ไลน์มัลติเอเจนต์ของผู้กำกับสนร่วม AI สำหรับวิดีโอ บน: เอเจนต์ผู้จัดเตรียมใช้ MAB เพื่อนำทางพื้นที่การดำเนินการสร้างสรรค์ที่แยกย่อย ล่าง: เอเจนต์ก่อนการผลิตสังเคราะห์บทสรุปความคิดสร้างสรรค์ โครงเรื่อง และสินทรัพย์ภาพเพื่อสร้างสตอรี่บอร์ดที่สอดคล้องกัน ซึ่งเอเจนต์การผลิตจะแปลเป็นคีย์เฟรม คลิปวิดีโอ และเสียงที่ซิงโครไนซ์กัน ผู้ตัดสิน MLLM จะประเมินวิดีโอสุดท้ายเพื่อสร้างสัญญาณรางวัลที่แยกย่อย ซึ่งจะถูกส่งกลับไปยัง MAB เพื่อปรับแต่งองค์ประกอบสร้างสรรค์ซ้ำๆ ในลูปการเพิ่มประสิทธิภาพ
2. การสร้างสตอรี่บอร์ดภาพด้วย CANVAS
แม้จะมีสคริปต์ที่รวมเป็นหนึ่งเดียว แต่การสร้างช็อตต่อเนื่องยาวๆ มักนำไปสู่ความเบี่ยงเบนของตัวละครและสภาพแวดล้อมที่ไม่เสถียร เราจึงนำเสนอ Continuity-Aware Narratives via Visual Agentic Storyboarding (CANVAS) เฟรมเวิร์กมัลติเอเจนต์ที่ใช้วางแผนความต่อเนื่องทางสายตาในเรื่องเล่าหลายช็อตโดยเฉพาะ
CANVAS บังคับใช้ความสอดคล้องด้วยการรักษาโครงสร้างของตัวละคร สถานที่ และวัตถุในขณะที่เรื่องราวดำเนินไป โดยถูกสร้างเป็นเลเยอร์การจัดเตรียมบน Gemini และพึ่งพาหน่วยความจำภาพที่คงอยู่ ด้วยการดึงสมอภาพ (visual anchors) จากหน่วยความจำหรือเริ่มต้นใหม่เมื่อจำเป็น ทำให้ CANVAS มั่นใจได้ถึงการเปลี่ยนแปลงที่ราบรื่นภายในสภาพแวดล้อมเดียวกัน ช่วยให้ตัวละครคงเอกลักษณ์และรักษารูปแบบเชิงพื้นที่เมื่อกล้องกลับมาจับภาพที่เดิม
ตัวอย่างภาพด้านล่างแสดงลำดับการปล้นพิพิธภัณฑ์แบบหลายช็อต เพื่อเปรียบเทียบ CANVAS กับวิธีอื่นอย่างการสร้างโดยตรงด้วยโมเดลฐาน (Gemini-3.1-Pro) และเฟรมเวิร์กมัลติเอเจนต์อย่าง (AutoStudio) พรอมต์ด้านล่างเน้นย้ำถึงองค์ประกอบที่เกิดขึ้นซ้ำๆ เช่น หัวขโมย ห้องจัดแสดง และอัญมณี ซึ่งต้องรักษาลักษณะทางสายตาให้เหมือนเดิม โดยแสดงให้เห็นวิธีรับมือกับการเปลี่ยนแปลงแบบต่อเนื่อง (เช่น เสื้อผ้าตัวละคร) และแบบไม่ต่อเนื่อง (เช่น กล้องตัดกลับมาที่ห้องโถงหลัก)
การสร้างด้วย Gemini-3.1-Pro เพียงอย่างเดียวพบความไม่สอดคล้องของอุปกรณ์ประกอบฉากและความเบี่ยงเบนของพื้นหลัง ส่วน AutoStudio ก็เกิดความเบี่ยงเบนเช่นกัน โดยหมวกของหัวขโมยหายไปและพื้นหลังไม่สอดคล้องกัน ในทางตรงกันข้าม หน่วยความจำภาพที่คงอยู่ของ CANVAS ช่วยให้มั่นใจได้ว่าตัวละคร เรขาคณิตเชิงพื้นที่ และสถานะวัตถุจะยังคงสอดคล้องกันอย่างสมบูรณ์ตลอดเรื่องราว
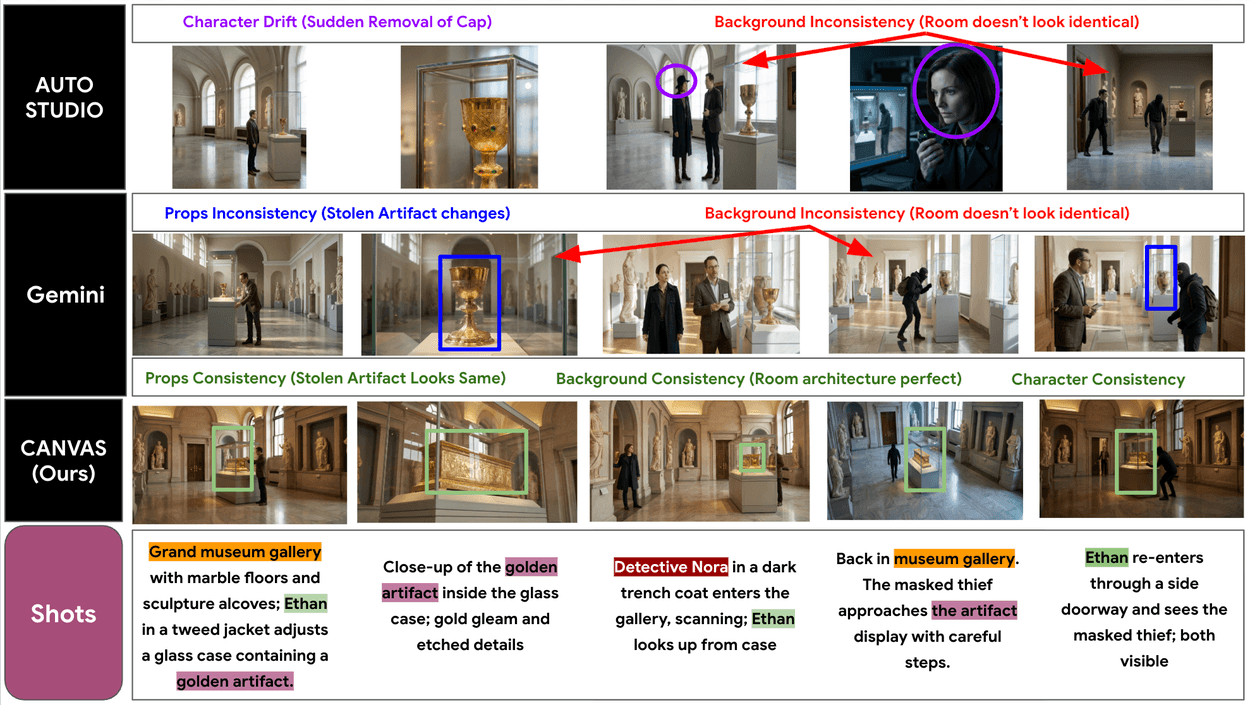
การเปรียบเทียบสตอรี่บอร์ดภาพในลำดับการปล้นพิพิธภัณฑ์จาก HardContinuityBench โดยเปรียบเทียบ CANVAS กับบรรทัดฐาน AutoStudio และ Gemini-3.1-Pro
3. การขยายพลวัตชั่วคราวด้วย A²RD เพื่อแปลงสตอรี่บอร์ดเป็นวิดีโอจริงที่มีความยาวหลายนาที เราได้พัฒนา A²RD สถาปัตยกรรมสร้างวิดีโอแบบ autoregressive ของเอเจนต์ มีคุณลักษณะสร้างทีละเซกเมนต์ (segment-by-segment) เพิ่มพูนด้วยหน่วยความจำวิดีโอหลายรูปแบบเพื่อติดตามบริบทและพลวัต
ในแต่ละเซกเมนต์ ระบบจะทำงานในลูปดึงข้อมูล-สังเคราะห์-ปรับแต่ง-อัปเดต (retrieve-synthesize-refine-update loop) โดยเอเจนต์จะกำหนดโหมดการสร้างอย่างปรับตัว สลับระหว่างการคาดการณ์นอกช่วง (extrapolation) เพื่อให้เนื้อเรื่องดำเนินไปตามธรรมชาติ และการประมาณค่าในช่วง (interpolation) เพื่อยึดเซกเมนต์ไว้กับเอนทิตีและสภาพแวดล้อมเดิม สร้างสมดุลระหว่างการดำเนินเรื่องและความสมจริงทางกายภาพของฉาก
จากการทดสอบด้วยภาพยนตร์ความยาว 10 นาทีด้านล่าง วิดีโอเน้นย้ำวิธีที่ระบบสลับสองโหมดนี้อย่างไดนามิก ขณะที่เครื่องสร้างวิดีโอมาตรฐานจะเกิดการเสื่อมสภาพทางสายตาอย่างรุนแรงจนตัวละครกลายพันธุ์และสถานที่เปลี่ยนรูป แต่ A²RD จะสืบค้นหน่วยความจำวิดีโอหลายรูปแบบอย่างต่อเนื่องเพื่อรักษาเอกลักษณ์ตัวละคร รายละเอียดเครื่องแต่งกาย และเรขาคณิตเชิงโครงสร้างไว้ได้ตั้งแต่ช็อตแรกจนถึงเฟรมสุดท้าย
รับชมภาพยนตร์
วิดีโอขนาดยาวที่แสดงให้เห็นถึงความสามารถของ A²RD ในการรักษาความสอดคล้องทางสายตาที่เข้มงวดและความก้าวหน้าของการเล่าเรื่องตลอดระยะเวลาสิบนาทีอย่างต่อเนื่อง
4. การปรับแต่งแบบวงปิดด้วย VQQA
ท้ายที่สุด เราต้องการให้ระบบตรวจจับและแก้ไขสิ่งประดิษฐ์ทางสายตาได้ด้วยตนเอง แต่วิธีการเพิ่มประสิทธิภาพในเวลาทดสอบที่มีอยู่มักมี ค่าใช้จ่ายในการคำนวณสูง หรือ ต้องการการเข้าถึงภายในโมเดลแบบกล่องขาว เราจึงพัฒนา Video Quality Question Answering (VQQA) เฟรมเวิร์กมัลติเอเจนต์แบบครบวงจรที่รองรับข้อมูลนำเข้าและงานสร้างวิดีโอที่หลากหลาย
VQQA จะสร้างคำถามภาพแบบไดนามิกที่ปรับตามพรอมต์ และใช้คำวิจารณ์ของ Vision-Language Model (VLM) ในรูปแบบเกรเดียนต์ทางอรรถศาสตร์ (semantic gradients) เพื่อให้ข้อเสนอแนะเชิงทิศทางด้วยภาษาธรรมชาติในการแนะนำการปรับแต่งซ้ำๆ แทนที่เมทริกซ์ประเมินแบบพาสซีฟดั้งเดิม ระบบสามารถดำเนินการลูปข้อเสนอแนะซ้ำๆ ผ่านอินเทอร์เฟซภาษาธรรมชาติ และเพื่อป้องกันความเบี่ยงเบนทางอรรถศาสตร์ในระหว่างนี้ VQQA จะใช้กลไก การเลือกทั่วโลก (Global Selection) โดยให้ผู้ประเมิน VLM ทั่วโลกตรวจสอบวิดีโอทั้งหมดเทียบกับพรอมต์ดั้งเดิม แล้วเลือกผู้สมัครที่ได้คะแนนสูงสุด เพื่อไม่ให้การแก้ไขในท้องถิ่นทำลายบริบทในภาพรวม
ในทางปฏิบัติ VQQA ทำหน้าที่เป็นเครื่องมือเพิ่มประสิทธิภาพพรอมต์แบบกล่องดำ (black-box prompt optimizer) แทนที่จะแก้ไขในระดับพิกเซล โดยจะปรับแต่งพรอมต์ข้อความซ้ำๆ เพื่อแก้ข้อบกพร่องระดับสูง เช่น ข้อผิดพลาดในการผูกมัดแอตทริบิวต์ (attribute binding errors) หรือแอตทริบิวต์ตัวละครที่ไม่สอดคล้องกัน ตัวอย่างด้านล่าง VQQA ไม่ได้มาสก์หรือระบายสีทับเฟรมเดิม แต่แก้ไขปัญหาการผูกมัดวัสดุด้วยการเรนเดอร์พื้นผิวลูกโป่งไมลาร์บนเรขาคณิตทรงลูกบาศก์ และแก้ไขการเปลี่ยนเครื่องดนตรีกลางคัทให้อยู่กับนักดนตรีอย่างสอดคล้องกัน
[
เล่นวิดีโอวนซ้ำแบบไม่มีเสียง หยุดวิดีโอวนซ้ำแบบไม่มีเสียง
เปิดเสียงวิดีโอ ปิดเสียงวิดีโอ
การแก้ไขข้อผิดพลาดในการผูกมัดแอตทริบิวต์ พรอมต์: "A cuboid balloon drifts past a circular window, sunlight streaming through the glass panes." ในขณะที่การสร้างแบบธรรมดา (ซ้าย) ล้มเหลวในการจับคุณสมบัติของลูกโป่งโดยการเรนเดอร์ลูกบาศก์ที่แข็งและไม่มีพื้นผิว VQQA (ขวา) สามารถบังคับใช้รูปทรงลูกบาศก์ที่ตั้งใจไว้ได้สำเร็จในขณะที่รักษาพื้นผิวและคุณสมบัติของวัสดุของลูกโป่งที่สูบลม ด้วยการใช้ข้อเสนอแนะทางสายตาซ้ำๆ พรอมต์ที่ได้รับการเพิ่มประสิทธิภาพจะแนะนำเครื่องสร้างให้เรนเดอร์ลูกโป่งไมลาร์รูปทรงกล่องที่ชัดเจนพร้อมขอบและตะเข็บที่กำหนดซึ่งลอยผ่านหน้าต่างที่มีแสงแดดส่องถึงอย่างราบรื่น
[
](https://storage.googleapis.com/gweb-research2023-media/media/AI-video-co-director4_violinist.mp4)
เล่นวิดีโอวนซ้ำแบบไม่มีเสียง หยุดวิดีโอวนซ้ำแบบไม่มีเสียง
เปิดเสียงวิดีโอ ปิดเสียงวิดีโอ
การแก้ไขความไม่สอดคล้องชั่วคราว พรอมต์: "Violinist and pianist captivate with harmonious duet performance." การสร้างแบบธรรมดา (ซ้าย) ประสบปัญหาความต่อเนื่องที่ขาดหายไปอย่างรุนแรงในการเปลี่ยนผ่านช็อต โดยแสดงนักเปียโนหญิงและนักไวโอลินชายในตอนแรก แต่จู่ๆ ก็พรรณนาถึงผู้หญิงที่เล่นไวโอลินหลังจากคัท VQQA (ขวา) รักษาความสอดคล้องทางอรรถศาสตร์ที่เข้มงวดตลอดการแสดง โดยให้นักเปียโนหญิงและนักไวโอลินชายยึดติดกับเครื่องดนตรีของตนอย่างต่อเนื่อง
ผลลัพธ์หลักและเกณฑ์มาตรฐาน
เราได้พัฒนาเกณฑ์มาตรฐานเฉพาะทาง 3 รายการ เพื่อประเมินเฟรมเวิร์กในระดับการผลิตวิดีโอมืออาชีพ:
- GenAD-Bench: ใช้ไปป์ไลน์แบบมนุษย์ในวงลูปจับคู่ Gemini 3 Pro กับโมเดลภาพเฉพาะทาง สร้างแบรนด์สมมติ 50 แบรนด์ที่มีผลิตภัณฑ์ต่างกัน 4 รายการ ใน 400 สถานการณ์เพื่อทดสอบข้อจำกัดทางการตลาดโดยไม่พึ่งพาข้อมูลที่มีลิขสิทธิ์
- HardContinuityBench: ประเมินความต่อเนื่องเชิงพื้นที่และสภาพแวดล้อมผ่านสตอรี่บอร์ดซับซ้อนจาก GPT-5.2 ท้าทายโมเดลด้วยช่องว่างการปรากฏตัวซ้ำของฉาก การเปลี่ยนเครื่องแต่งกาย และการเปลี่ยนสถานะอุปกรณ์ประกอบฉาก
- LVBench-C: ทดสอบพลวัตชั่วคราวระยะยาว มี 120 สถานการณ์เฉพาะข้อความ เช่น สถานะตัวละครที่พัฒนา คุณสมบัติวัตถุที่เปลี่ยน โดยรักษากฎเข้มงวดที่สินทรัพย์ภาพสำคัญต้องหายไปอย่างน้อย 10 เซกเมนต์ก่อนกลับมาปรากฏอีกครั้ง
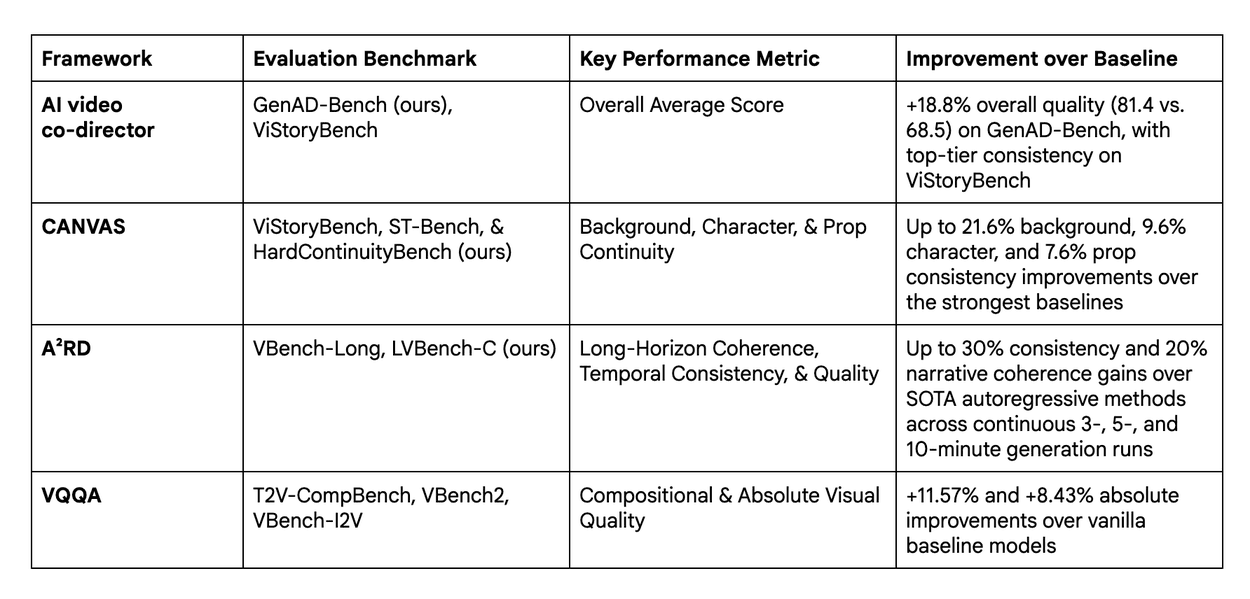
การประเมินชี้ว่าเฟรมเวิร์กของเราปรับปรุงประสิทธิภาพเหนือสถาปัตยกรรมเดิม โดย AI video co-director ทำคะแนนคุณภาพสูงสุดที่ 81.4 ใน GenAD-Bench และเพิ่มความสอดคล้องใน ViStoryBench ด้าน CANVAS ช่วยลดความเบี่ยงเบนของฉาก เพิ่มความต่อเนื่องใน ST-Bench และ HardContinuityBench ส่วน A²RD ลดความเบี่ยงเบนเลย์เอาต์ใน VBench-Long และ LVBench-C และ VQQA ช่วยแก้ไขความไม่สอดคล้องทางกายภาพ เพิ่มคุณภาพใน T2V-CompBench, VBench2, และ VBench-I2V
ทิศทางในอนาคต
เฟรมเวิร์กเหล่านี้นับเป็นก้าวสำคัญในการปลดล็อกการเล่าเรื่องทางสายตาระยะยาว ในอนาคตเรากำลังสำรวจวิธีผสานรวมเวิร์กโฟลว์แบบมนุษย์ในวงลูป (human-in-the-loop workflows) โดยเป้าหมายไม่ใช่การแทนที่มนุษย์ แต่เป็นการเพิ่มขีดความสามารถและขจัดความซับซ้อนน่าเบื่อหน่ายออกไป เพื่อให้ครีเอเตอร์ยังคงควบคุมทิศทางความคิดสร้างสรรค์ได้อย่างเต็มที่
กิตติกรรมประกาศ
งานนี้เกิดขึ้นได้จากความพยายามของทีมวิจัยทั่ว Google เราขอขอบคุณ Andrew Pan, Brett Slatkin, Burak Gokturk, Carina Claassen, Daniel Vlasic, Do Xuan Long, Ishani Mondal, Jasmine Leon, Jingyun Liu, Joe Timmons, Jordan Boyd-Graber, Khanh G. LeViet, Kuang Su, Long T Le, Mihir Parmar, Min-Yen Kan, Nathan Hodson, Nick Losier, Palash Goyal, Rhyard Zhu, Sebastian Ko, Scott Penberthy, Yan Xu, Yang Li, Ye Jin, และ Tomas Pfister สำหรับการสนับสนุนอันมีค่าในชุดงานวิจัยนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร