
GitHub Security Lab เปิดตัว Taskflow Agent ทำ Fuzzing ด้วย AI
หากคุณยังใหม่กับการทำ fuzzing และต้องการเรียนรู้พื้นฐานก่อน สามารถดูคอร์ส Fuzzing 101 ของเราได้ที่ gh.io/fuzzing101
การทำ Continuous fuzzing ไม่ใช่ทางแก้ปัญหาแบบเวทมนตร์ที่จะจัดการทุกอย่างได้ แม้แต่โปรเจกต์ที่เข้าร่วม OSS-Fuzz มานานหลายปีก็ยังอาจมีบั๊กวิกฤตซ่อนอยู่ เหตุผลมักจะเหมือนเดิมคือ ต้องมีคนคอยตรวจสอบความครอบคลุม (coverage) เขียน harness ใหม่สำหรับโค้ดที่ยังเข้าไม่ถึง และคัดกรอง (triage) การล่มของโปรแกรม (crashes) ที่เกิดขึ้น พูดง่ายๆ คือการทำ fuzzing ยังคงต้องมีมนุษย์อยู่ในกระบวนการ (human in the loop)
ดังนั้นคำถามที่ผมเฝ้าถามตัวเองคือ เราจะสามารถส่งต่อภาระงานของมนุษย์เหล่านั้นให้กับตัวแทน LLM (LLM agent) ได้มากน้อยแค่ไหน?
นั่นคือสิ่งที่นำไปสู่การสร้าง Fuzzing Taskflow ซึ่งเป็นไปป์ไลน์การทำ fuzzing อัตโนมัติสำหรับโปรเจกต์ C/C++ คุณเพียงแค่ระบุไปที่คลังเก็บโค้ด (repository) บน GitHub แล้วที่เหลือมันจะจัดการเอง ตั้งแต่ระบุจุดเข้า (entrypoints) ที่เหมาะสม, วิเคราะห์ระบบการ build, เขียน harness, รัน AFL++, อ่านรายงาน coverage, ปรับปรุง harness, คัดกรองทุกการ crash และเขียนรายงานช่องโหว่สำหรับแต่ละบั๊กที่ไม่ซ้ำกัน ทั้งหมดนี้ทำได้โดยไม่ต้องมีมนุษย์คอยเฝ้าดู
Fuzzing Taskflow ถูกสร้างขึ้นบน GitHub Security Lab Taskflow Agent ซึ่งเป็นเฟรมเวิร์กของเราสำหรับการเขียนระบบความปลอดภัยอัตโนมัติที่ขับเคลื่อนด้วย LLM ดังนั้นไปป์ไลน์จึงถูกแสดงออกมาในรูปแบบของชุด taskflow ที่ agent จะรันตั้งแต่ต้นจนจบ
ในโพสต์นี้ ผมจะพาคุณไปดูวิธีการทำงานและเหตุผลในการตัดสินใจออกแบบเบื้องหลัง มาเริ่มกันเลย!
วิธีการใช้งาน
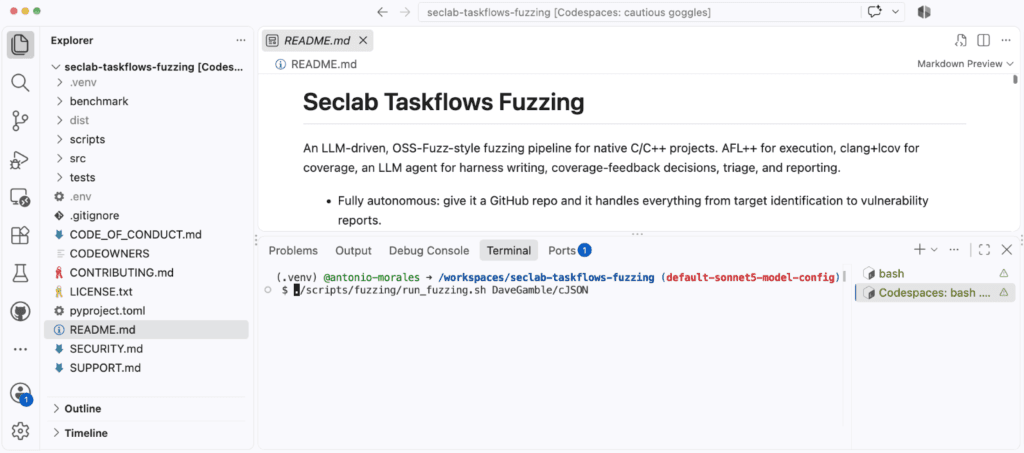
วิธีที่ง่ายที่สุดในการรันคือเข้าไปที่ https://github.com/GitHubSecurityLab/seclab-taskflows-fuzzing แล้วเริ่มใช้งาน codespace
จากนั้น รันสคริปต์ดังนี้:
./scripts/fuzzing/run_fuzzing.sh PROJECTตัวอย่างเช่น:
./scripts/fuzzing/run_fuzzing.sh tukaani-project/xzเพียงเท่านี้ โดยอาร์กิวเมนต์เป็นแค่ชื่อ GitHub owner/repo จากนั้นตัว agent จะจัดการขั้นตอนเบื้องต้นทั้งหมดด้วยตัวมันเอง:
- ติดตั้งซอฟต์แวร์ เช่น AFL
- โคลนคลังเก็บโค้ด
- ระบุฟังก์ชันที่เกี่ยวข้องที่สุดในโค้ด
- สร้างเป้าหมายการ fuzz (fuzz targets) สำหรับฟังก์ชันเหล่านั้น
หากคุณต้องการแค่การทดสอบเบื้องต้น (smoke test) สั้นๆ ก่อนเริ่มแคมเปญยาว ให้ระบุไปที่โปรเจกต์เล็กๆ:
./scripts/fuzzing/run_fuzzing.sh DaveGamble/cJSONคำเตือนก่อนที่คุณจะรัน: taskflow นี้จะรัน afl-fuzz, clang และ คำสั่ง build ใดๆ ที่ LLM เลือก โดยตรงบนโฮสต์ โดยไม่มีคอนเทนเนอร์คั่นกลาง ซึ่งโดยหลักการแล้ว agent ที่ถูกโจมตีด้วย prompt injection อาจทำอะไรก็ได้ที่ผู้ใช้ของคุณทำได้ ดังนั้นโปรดรันเฉพาะในสภาพแวดล้อมที่ใช้แล้วทิ้งได้ (เช่น Codespace หรือ VM ที่ไม่ใช้แล้ว) โดยไม่มีสิทธิ์ระดับสูง (elevated privileges)
การเลือกโมเดล
โมเดลชั้นนำบางตัวมีการกำหนดมาตรการป้องกันความปลอดภัย (security guardrails) ต่อผลลัพธ์ สำหรับ fuzzing taskflow เราใช้ Claude Sonnet 5 เป็นค่าเริ่มต้น เพราะมันผ่านการทดสอบภายในทั้งหมดของเราโดยไม่มีปัญหา คุณสามารถเลือกโมเดลอื่นได้โดยแก้ไขไฟล์: src/seclab_taskflows_fuzzing/configs/model_config.yaml
สถาปัตยกรรมในหนึ่งนาที
ก่อนจะเข้าสู่ส่วนที่น่าสนใจ การเข้าใจว่าแต่ละส่วนประกอบกันอย่างไรจะช่วยได้มาก โดยมีสามชั้นดังนี้:
- ตัวขับเคลื่อนเชลล์ (run_fuzzing.sh) ที่เชื่อมต่อขั้นตอนต่างๆ ของไปป์ไลน์เข้าด้วยกัน
- ชุดของ ไฟล์ YAML สำหรับ taskflow หนึ่งไฟล์ต่อหนึ่งขั้นตอน ซึ่งโดยพื้นฐานแล้วคือ prompt ที่บอก LLM agent ว่าต้องทำอะไรในแต่ละขั้นตอน
- ชุดของ เครื่องมือ MCP ที่ agent จะเรียกใช้เพื่อทำงานจริง: เช่น รัน AFL, คอมไพล์ harness, จัดเก็บ crash, อ่านรายงาน coverage และอื่นๆ
กฎการออกแบบที่ผมให้ความสำคัญที่สุดคือการแยกความรับผิดชอบอย่างชัดเจน: LLM agent เป็นเจ้าของการตัดสินใจ และเครื่องมือ MCP เป็นเจ้าของการดำเนินการ ตัว agent จะตัดสินใจว่าจะ fuzz อะไร, เขียน harness อย่างไร และจะไล่ตามช่องว่าง coverage จุดไหนต่อ ส่วนเครื่องมือจะแสดงคำสั่งพื้นฐานอย่าง run_afl_for หรือ compile_harness เท่านั้น ตัว agent จะไม่เรียก AFL หรือ clang โดยตรง แต่มันจะประกอบไปป์ไลน์จากบล็อกตัวต่อเหล่านี้ สถานะทั้งหมดจะถูกเก็บไว้ในฐานข้อมูล SQLite (fuzz_context.db) ดังนั้นในแต่ละขั้นตอนจะไม่มีการส่งข้อมูลหากันในหน่วยความจำ แต่จะส่งผ่านฐานข้อมูลเท่านั้น
รายละเอียดเล็กๆ แต่สำคัญอย่างหนึ่งคือ: แต่ละ harness จะถูก build สองครั้ง ระบบการวัดขอบเขต (edge instrumentation) ของ AFL นั้นดีมากสำหรับการนำทาง fuzzer แต่ไม่มีประโยชน์สำหรับรายงาน coverage ที่มนุษย์อ่านเข้าใจ ดังนั้นทุก harness จะกลายเป็นทั้งไฟล์ไบนารี .afl (build ด้วย afl-clang-lto -fsanitize=address,undefined) และไฟล์ไบนารี .cov (build ด้วย clang -fprofile-instr-generate -fcoverage-mapping) โดย .afl จะทำหน้าที่ fuzzing และ .cov จะรันคิวของ AFL ซ้ำหลังจากนั้นเพื่อสร้างรายงาน coverage ของบรรทัดซอร์สโค้ดและกิ่งก้าน (branch) ที่แท้จริง
ลูปข้อมูลย้อนกลับความครอบคลุม (coverage-feedback loop)
นี่คือหัวใจของไปป์ไลน์ทั้งหมด และเป็นส่วนที่ทำหน้าที่เป็นระบบอัตโนมัติแทนเวิร์กโฟลว์แบบทำมือที่ผมอธิบายไว้ตอนต้นได้โดยตรงที่สุด
หากคุณเคยพยายามปรับปรุง coverage ของการ fuzz ด้วยตัวเอง คุณจะรู้ว่ามันเป็นกระบวนการทำซ้ำที่มีลักษณะดังนี้:
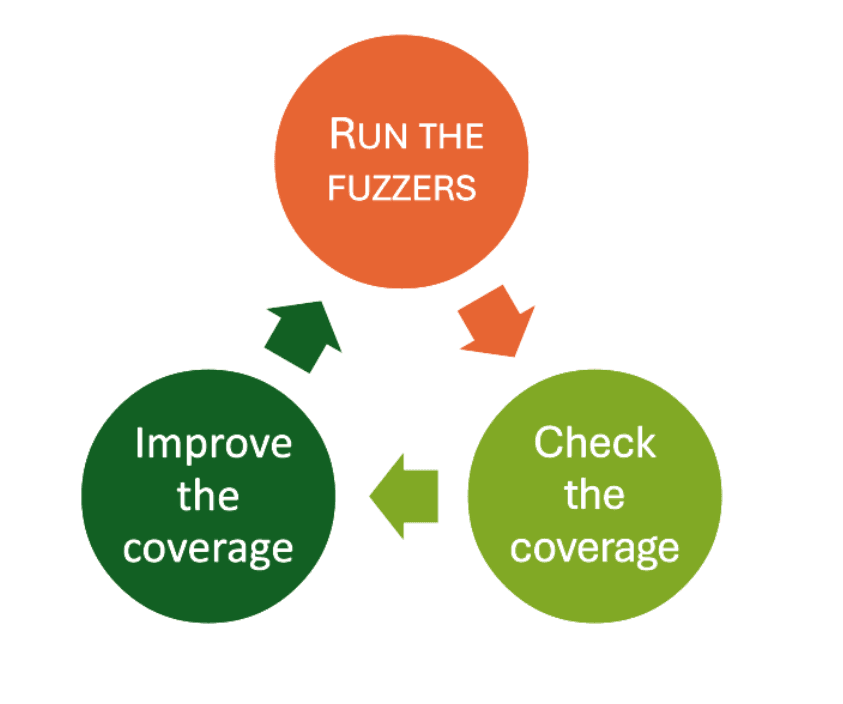
ขั้นตอน "ตรวจสอบ coverage" เมื่อก่อนเคยทำโดยผมเอง ที่ต้องอ่านรายงาน LCOV เพื่อหา branch ที่ยังไม่ครอบคลุม ส่วนขั้นตอน "ปรับปรุง coverage" ก็ทำโดยผมเช่นกัน ซึ่งเป็นการเขียน harness ใหม่หรือสร้างข้อมูลนำเข้า (input) ใหม่ Fuzzing Taskflow จะส่งต่อทั้งสองขั้นตอนนี้ให้ตัว agent จัดการ
ในการทำงานแต่ละรอบ สำหรับแต่ละ harness ตัว agent จะรัน AFL ตามงบประมาณเวลาที่กำหนด แล้วรันคิวซ้ำกับไบนารี .cov เพื่อให้ได้รายงาน coverage จริง จากนั้นจะอ่านรายการ branch ที่ยังไม่ครอบคลุม ตามสิ่งที่พบ มันจะเลือกทำอย่างใดอย่างหนึ่งจากตัวเลือกต่อไปนี้:
- เพิ่ม seed ใหม่ที่สร้างขึ้นเพื่อให้เข้าถึง branch ที่ยังไม่ครอบคลุม
- แก้ไขซอร์สโค้ดของ harness เพื่อเรียก API เพิ่มเติม
- เพิ่มค่าคงที่ (magic constants) ที่พบในจุดตรวจสอบ (guard) ลงในดิกชันนารีของ AFL โดยอัตนัย
- ข้ามช่องว่างนั้นไปหากเป็นส่วนของข้อผิดพลาดที่เกิดขึ้นได้ยาก (cold error path) หรือเป็นโค้ดของผู้พัฒนาภายนอก (vendor code) ที่ไม่คุ้มจะไล่ตาม
งบประมาณเวลาจะ เพิ่มเป็นสองเท่าในทุกรอบการทำงาน:
30 วินาที → 60 วินาที → 120 วินาที → 240 วินาที → 480 วินาที → 960 วินาที (≈ 32 นาทีต่อเป้าหมาย)
แนวคิดคือการใช้รอบการทำงานที่สั้นและราคาถูกในช่วงแรก (เมื่อมี coverage ที่เก็บได้ง่ายจำนวนมาก) และใช้รอบที่ยาวขึ้นในช่วงหลัง (เมื่อ fuzzer ต้องการเวลามากขึ้นในการเจาะผ่านจุดตรวจสอบที่ยากๆ)
และเช่นเดียวกับในเวิร์กโฟลว์แบบทำมือของผม ผมต้องการคำตอบสำหรับคำถามที่ว่า: เราควรหยุดเมื่อไหร่? ในที่นี้ ลูปจะใช้ การตรวจจับจุดอิ่มตัว (plateau detection): เมื่อการทำงานสองรอบติดต่อกันมี coverage เพิ่มขึ้นน้อยกว่าเกณฑ์ที่กำหนดไว้ (โดยค่าเริ่มต้นคือ 1% ของบรรทัดทั้งหมด) ลูปจะตัดสินใจว่ามันถึงจุดที่ไม่คุ้มค่าที่จะทำต่อและย้ายไปขั้นตอนอื่น วิธีนี้ช่วยป้องกันไม่ให้ agent เผาผลาญทรัพยากรคำวณนานหลายชั่วโมงเพื่อเพิ่ม coverage เพียงเศษเสี้ยวเปอร์เซ็นต์สุดท้าย
การทำ Fuzzing แบบรับรู้โครงสร้าง (Structure-aware fuzzing)
ตัวเปลี่ยนข้อมูลระดับไบต์ (byte-level mutators) เริ่มต้นของ AFL (เช่นการกลับบิต, คณิตศาสตร์, การต่อบล็อก) ทำงานได้ดีกับรูปแบบไบนารี แต่ลำบากกับข้อมูลนำเข้าที่มีโครงสร้างหรือเป็นข้อความ ทางแก้แบบดั้งเดิมคือการเขียนตัวเปลี่ยนข้อมูล (mutators) เฉพาะสำหรับแต่ละรูปแบบด้วยมือ ซึ่งเป็นงานที่น่าเบื่อ ครั้งนี้ผมต้องการให้ไปป์ไลน์ทำงานนั้นแทนผม มันจึงมาพร้อมกับ สี่กลไกเสริม เพื่อสร้างข้อมูลนำเข้าที่รับรู้โครงสร้าง
1. ดิกชันนารีเฉพาะรูปแบบและตัวเปลี่ยนข้อมูลแบบกำหนดเอง สำหรับเป้าหมายที่รูปแบบข้อมูลนำเข้าเป็นที่รู้จัก (เช่น JSON, XML, regex, PNG, binary TLV ที่มีฟิลด์ความยาว) taskflow จะจัดส่งดิกชันนารี AFL ที่สร้างไว้ล่วงหน้าและไฟล์ C LLVMFuzzerCustomMutator มาให้ โดยตัวเปลี่ยนข้อมูล JSON จะทำหน้าที่ต่อโทเค็นและทำซ้ำวงเล็บให้สมดุล ส่วนของ XML จะรู้จักแท็ก, entities และโทเค็นประเภท billion-laughs และของ regex จะมีรูปแบบ ReDoS จริงๆ มาให้ ซึ่งตัวเปลี่ยนข้อมูลแต่ละตัวจะมอบหมายการเปลี่ยนข้อมูลครึ่งหนึ่งกลับไปให้ตัวเปลี่ยนไบต์เริ่มต้นของ AFL เพื่อให้เรายังคงความสุ่มของเอนจินไว้โดยไม่ไปขัดขวางมัน
2. ดิกชันนารีระดับซอร์สโค้ด สำหรับรูปแบบที่ไปป์ไลน์ไม่รู้จัก มันจะสร้างตัวเปลี่ยนข้อมูลแบบกำหนดเองขึ้นมาทันทีโดยการสแกนไฟล์ .c/.h ของเป้าหมาย มันจะดึงข้อมูลสตริง (string literals) และค่าคงที่ตัวเลข 32 บิต (จาก #define, case, และ enum) กรองส่วนที่ไม่จำเป็นออก และใช้สิ่งเหล่านั้นเป็นโทเค็นในการต่อข้อมูล สัญชาตญาณนั้นง่ายมาก: ค่าพิเศษ (magic values) ที่น่าสนใจที่สุดที่ตัวแยกวิเคราะห์ (parser) ตรวจสอบ มักจะถูกเขียนไว้ที่ไหนสักแห่งในซอร์สโค้ดของมันเอง
3. ดิกชันนารี AFL ที่สร้างขึ้นแบบไดนามิกพร้อมการเพิ่มข้อมูลตาม coverage ชุดโทเค็นจากซอร์สโค้ดเดียวกันจะถูกส่งออกมาเป็นดิกชันนารี AFL แบบคลาสสิกก่อนรอบที่ 1 (ค่าคงที่ตัวเลขในทั้งสองระบบ endian เพื่อให้ fuzzer สามารถผ่านการตรวจสอบ memcmp กับค่าพิเศษ 4 ไบต์ได้ไม่ว่าโฮสต์จะเป็นระบบไหน) จากนั้นหลังจากทุกขั้นตอน coverage ไปป์ไลน์จะดูที่จุดตรวจสอบใกล้กับบรรทัดที่ยังไม่ครอบคลุม (strncmp, memcmp, case 0xN, == ‘X’) และเพิ่มโทเค็นใหม่ที่พบลงไป ดิกชันนารีจะขยายตัวไปยังโค้ดที่ fuzzer ยังเข้าไม่ถึง
4. ตัวดำเนินการเชื่อมต่อคลังข้อมูล (Corpus-splice operator) ตัวเปลี่ยนข้อมูลอัจฉริยะยังสามารถโหลดไฟล์จากไดเรกทอรีคลังข้อมูล (corpus) และนำส่วนย่อยๆ ของไฟล์มาต่อกันแบบสุ่ม ซึ่งเป็นตัวดำเนินการสไตล์การรวมใหม่ (recombination) ที่ตัว havoc ของ AFL เดิมๆ ทำได้ไม่ดีนัก
คลังข้อมูลที่มีการพัฒนา (Evolving corpus)
สิ่งหนึ่งที่ทำให้ประสิทธิภาพการทำ fuzzing ลดลงอย่างเงียบๆ คือการทิ้งความคืบหน้าไป หากทุกการรันเริ่มจาก seed เดิม คุณจะต้องเสียค่าใช้จ่ายในการค้นหาเส้นทางเดิมซ้ำแล้วซ้ำเล่า เพื่อหลีกเลี่ยงปัญหานั้น ทุก harness จะได้รับ ไดเรกทอรีคลังข้อมูลที่เสถียร ซึ่งจะคงอยู่ข้ามรอบการทำงานและข้ามแคมเปญทั้งหมด:
<workspace>/corpus/harness_<id>/เมื่อสิ้นสุดแต่ละรอบ คิวของ AFL จะถูกรวมเข้ากับไดเรกทอรีนี้และรันผ่าน afl-cmin เพื่อจำกัดขนาดไม่ให้ใหญ่เกินไป ผลลัพธ์คือข้อมูลนำเข้าที่น่าสนใจของเมื่อวานจะถูกส่งต่อไปยังการรันในวันนี้ และข้อมูลนำเข้าที่คุณพบในแคมเปญสัปดาห์ที่แล้วจะถูกส่งมายังแคมเปญนี้ หากคุณหยุดและเริ่มแคมเปญใหม่ คุณจะไม่สูญเสียอะไรเลย
การคัดกรองและรายงานช่องโหว่
การพบการล่ม (crash) เป็นเพียงครึ่งหนึ่งของงาน ดังที่ใครก็ตามที่เคยวิเคราะห์หาสาเหตุที่แท้จริง (root-cause analysis) จะทราบดี การคัดกรองมักเป็นส่วนที่น่าเบื่อที่สุดของกระบวนการทั้งหมด และนี่คืออีกจุดหนึ่งที่ตัว agent แสดงฝีมือ
หลังจากลูปการ fuzz สิ้นสุดลง สามขั้นตอนจะทำงานโดยอัตโนมัติ อันดับแรก ทุก crash จะถูกย่อขนาดด้วย afl-tmin แล้วรันซ้ำภายใต้ ASan เพื่อบันทึก stack trace และกำจัดตัวที่ซ้ำกันด้วย stack-top hash (เฟรมส่วนบนที่ถูกทำให้เป็นมาตรฐาน โดยตัดเอาเทมเพลต, inline namespaces และ LTO suffixes ออกเพื่อให้ crash ที่มีความหมายเหมือนกันถูกรวมเข้าด้วยกัน) อันดับที่สอง crash ที่เคยรู้จักจะถูกรันซ้ำกับไบนารีปัจจุบันเพื่อดูว่าการแก้ไขจากต้นทางได้แก้ปัญหาไปแล้วหรือยัง อันดับที่สาม ตัว agent จะอ่านซอร์สโค้ดของ harness และฟังก์ชันที่ล่ม ไล่สายการเรียกย้อนกลับจาก API สาธารณะ และเขียนรายงานรูปแบบ markdown สำหรับการล่มแต่ละประเภท
แต่ละรายงานจะถูกระบุสถานะ (verdict) อย่างใดอย่างหนึ่งดังนี้:
- vulnerability (ช่องโหว่)
- library_hardening (การเพิ่มความปลอดภัยให้ไลบรารี)
- harness_bug (บั๊กที่ตัว harness เอง)
- OOM (หน่วยความจำเต็ม)
- timeout (หมดเวลา)
- assertion_failure (การตรวจสอบเงื่อนไขล้มเหลว)
- duplicate (ซ้ำ)
การแยกความแตกต่างระหว่าง vulnerability จริงๆ (ที่เข้าถึงได้และใช้โจมตีได้ผ่าน API สาธารณะ) และเป็นเพียง harness_bug (บั๊กอยู่ใน harness ของเราเอง ไม่ใช่ในไลบรารี) คือการตัดสินใจประเภทที่เมื่อก่อนผมต้องมานั่งไล่ดูโค้ดด้วยตัวเอง ทุกรายงานจะรวมถึงการวิเคราะห์สาเหตุที่แท้จริงพร้อมการอ้างอิง ไฟล์:บรรทัด, การโต้แย้งเรื่องการเข้าถึงได้ (reachability), การประเมินความเป็นไปได้ในการโจมตี (exploitability), การเสนอวิธีแก้ไขในรูปแบบ unified diff และร่างการทดสอบเพื่อป้องกันการกลับมาเป็นซ้ำ (regression-test sketch) เพื่อความชัดเจน: แพตช์ที่เสนอจะถูกทำเครื่องหมายว่า "ต้องผ่านการตรวจสอบ" (review required) ด้วยเหตุผลบางประการ การวิเคราะห์ของ agent นั้นจำกัดอยู่เพียงความเข้าใจของโมเดลต่อโค้ดเป้าหมาย และมันสามารถทำผิดพลาดได้ ให้ถือว่าสถานะเหล่านี้เป็นจุดเริ่มต้นที่มีการเตรียมการมาอย่างดีสำหรับมนุษย์ ไม่ใช่ผลลัพธ์สุดท้าย
แดชบอร์ดแบบสด
การรันแคมเปญอัตโนมัติโดยที่ไม่เห็นว่ามันกำลังทำอะไรอยู่นั้นเป็นเรื่องที่น่าอึดอัด ดังนั้นไปป์ไลน์จึงเผยแพร่ทุกอย่างไปยังแดชบอร์ด HTML แบบสด มันจะเริ่มทำงานอัตโนมัติในเบื้องหลังทันทีที่คุณเริ่มแคมเปญ บนพอร์ต 8765 ใน Codespace พอร์ตนั้นจะถูกส่งต่อ (forwarded) อัตโนมัติ คุณจึงสามารถเปิดในเบราว์เซอร์ใดก็ได้และเฝ้าดูความคืบหน้าของแคมเปญแบบเรียลไทม์บนแดชบอร์ด
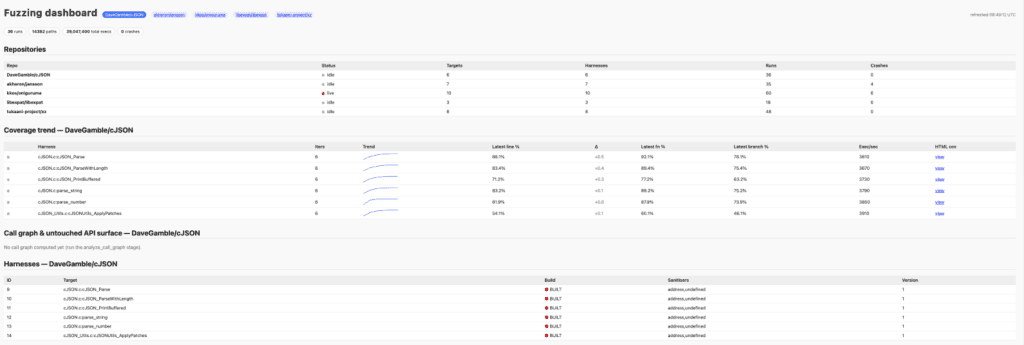
หน้านี้จะแสดงข้อมูลต่างๆ เช่น:
- สถานะความเคลื่อนไหว "running" ของแต่ละ harness
- ตารางแนวโน้ม coverage พร้อมกราฟ sparkline ในตัว
- Heatmap ของการล่ม (crash heatmap)
- ไทม์ไลน์การทำงานแต่ละรอบ
บทสรุป
ผมเริ่มโปรเจกต์นี้ด้วยแรงจูงใจจากข้อจำกัดที่นักวิจัยด้านความปลอดภัยทุกคนรู้จักดี: การทำ fuzzing นั้นได้ผลจริง แต่มันไม่สามารถขยายขนาดได้หากไม่มีมนุษย์คอยใส่ใจ และความใส่ใจของมนุษย์นั่นแหละคือคอขวด Fuzzing Taskflow คือความพยายามของผมที่จะขจัดคอขวดนั้นออกไปโดยส่งต่องานส่วนที่ซ้ำซาก (การเขียน harness, การอ่าน coverage, การตามเก็บช่องว่าง, การคัดกรอง crash) ให้กับ LLM agent ในขณะที่ยังคงแยกความแตกต่างระหว่างการตัดสินใจของ agent และเครื่องมือที่ทำงานจริงอย่างชัดเจน
หากคุณเป็นผู้ดูแลโปรเจกต์ C/C++ โปรด ลองใช้งานดู หากโปรเจกต์ของคุณไม่เคยถูก fuzz มาก่อน เครื่องมือนี้จะช่วยให้คุณเริ่มต้นได้อย่างรวดเร็ว หรือหากโปรเจกต์ของคุณ เคย ถูก fuzz มาก่อนแล้ว เครื่องมือนี้อาจช่วยค้นพบบั๊กใหม่ๆ โดยการเพิ่มความครอบคลุมของการทำ fuzzing ให้มากขึ้น
ซอร์สโค้ดนี้เป็นโอเพนซอร์ส ดังนั้นโปรดสร้าง issue หากคุณพบบั๊กใดๆ และเรายินดีต้อนรับการร่วมพัฒนา (contributions) เช่นกัน!
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร