
เปิดตัว d3-ultra โมเดลการตัดสินใจ Multimodal โอเพนซอร์สขนาด 27B
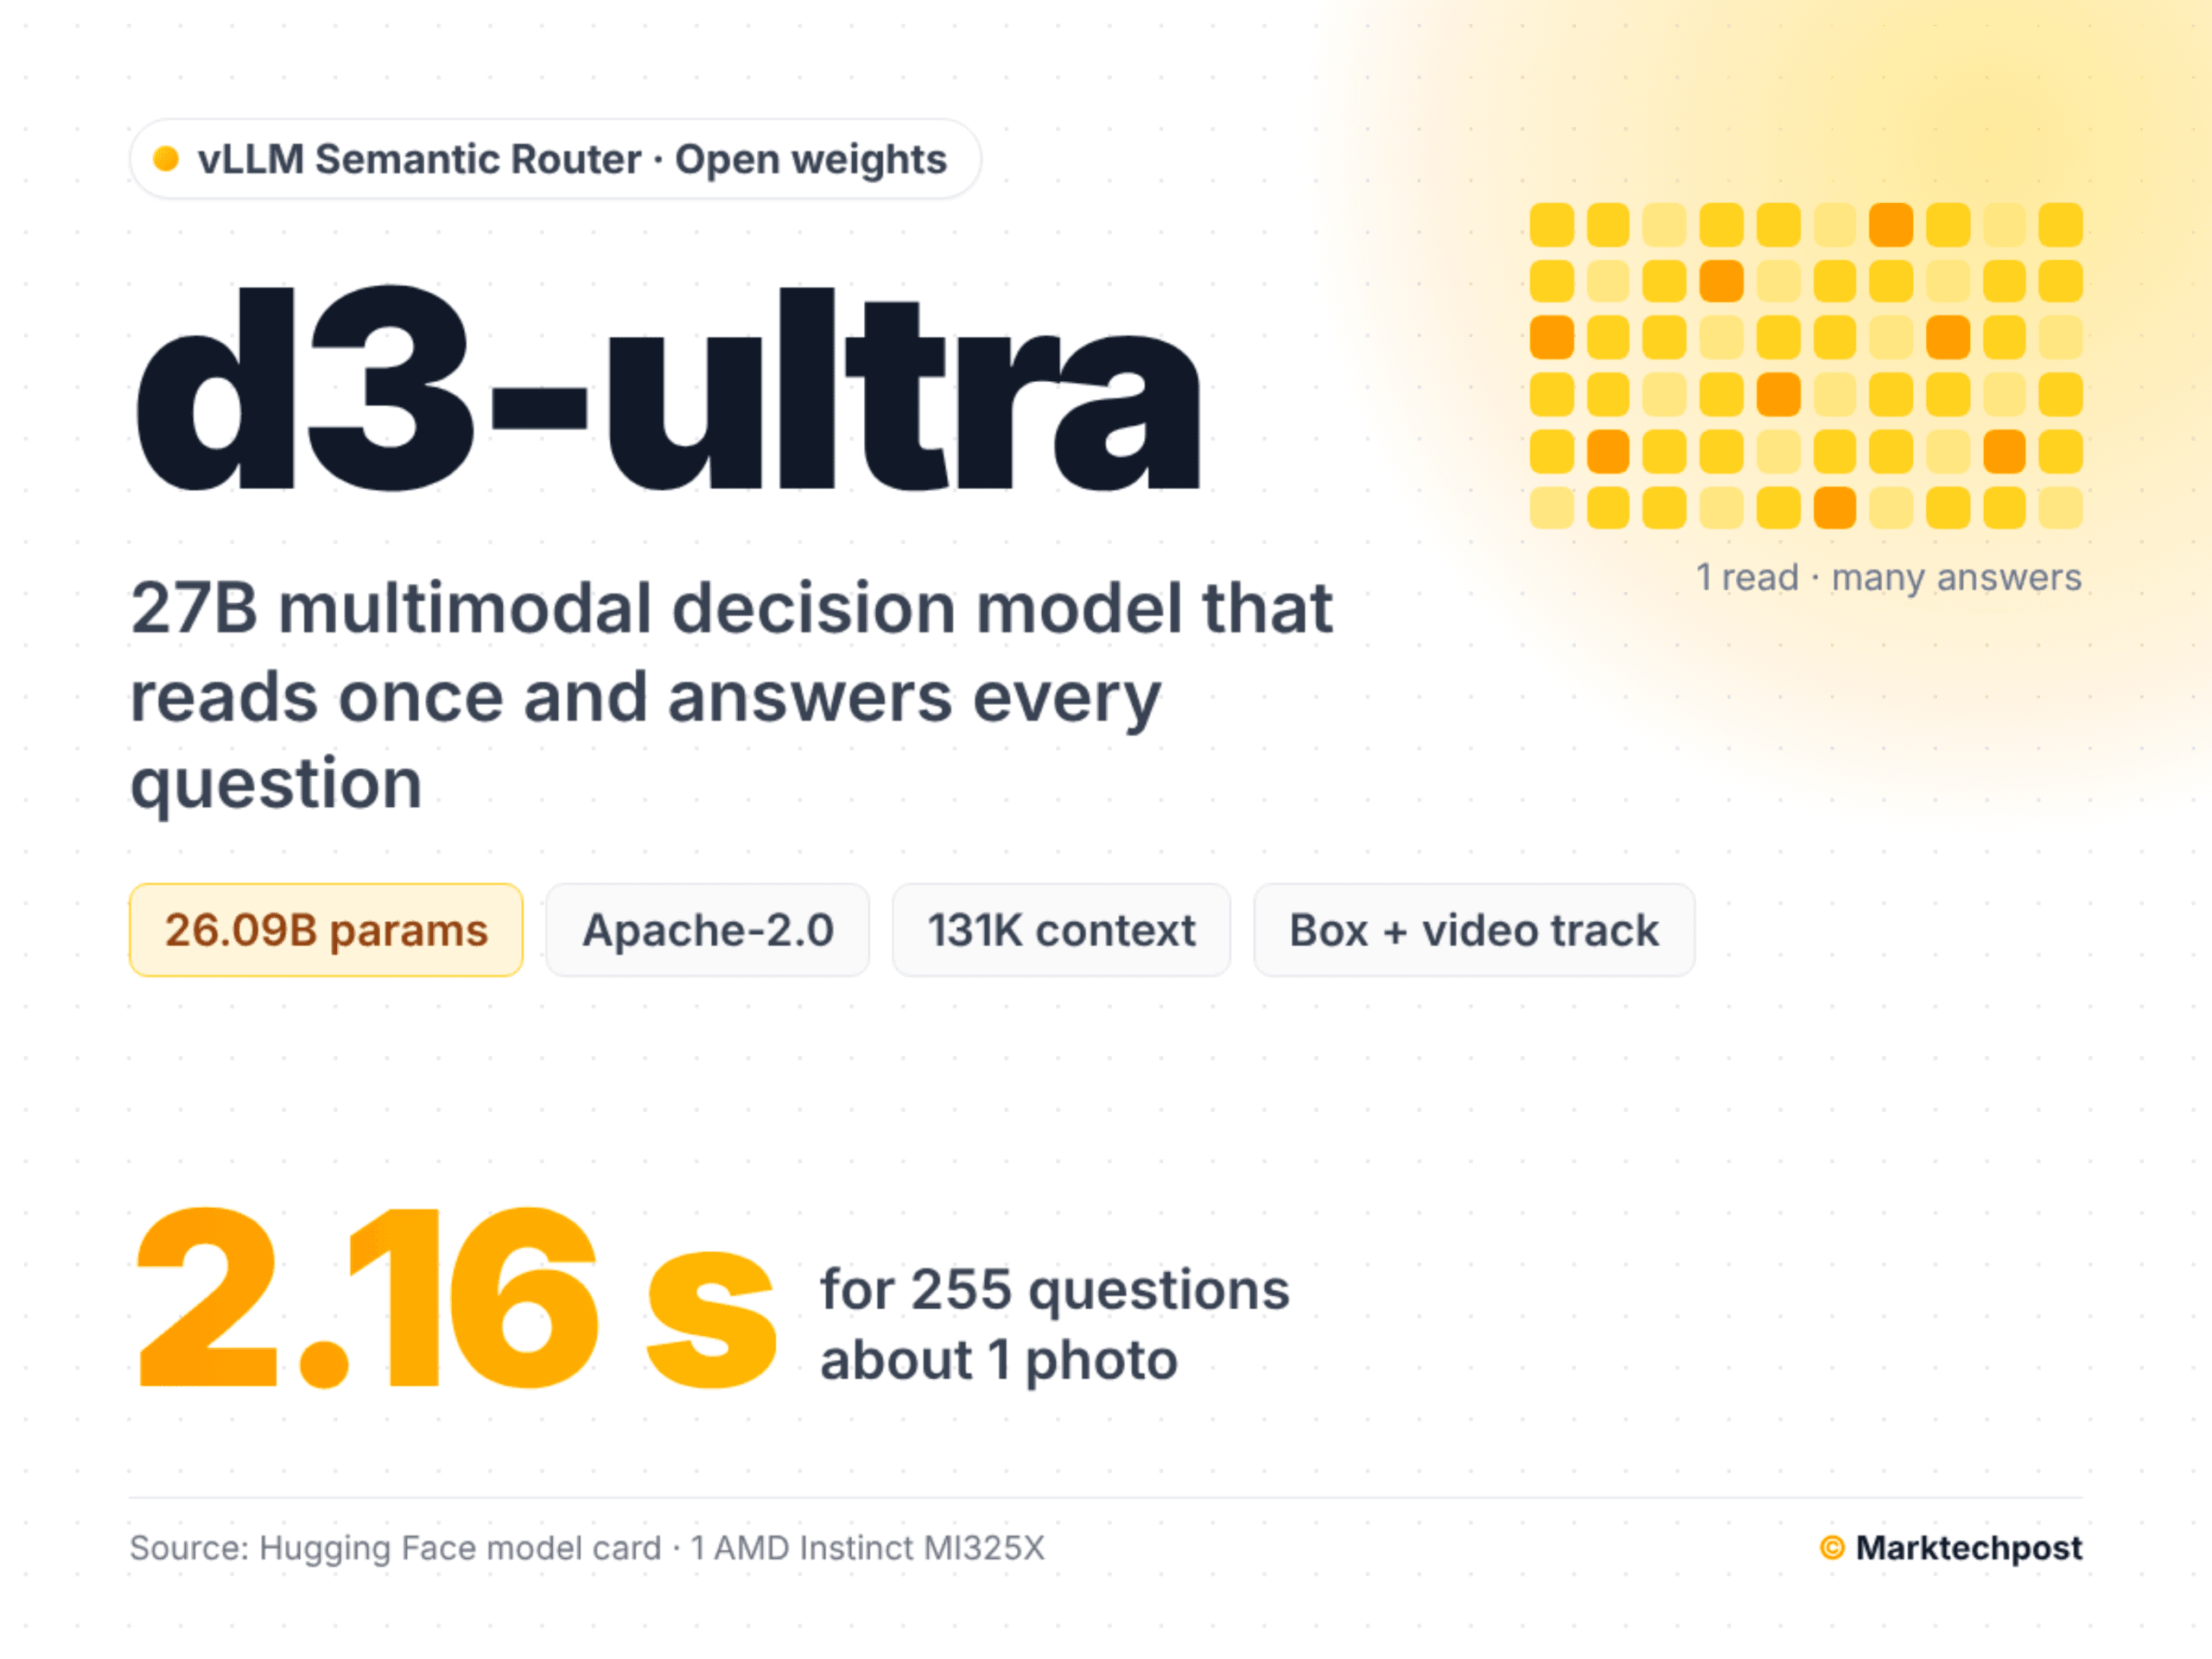
ทีม vLLM Semantic Router ได้เปิดตัว d3-ultra ซึ่งเป็นโมเดลการตัดสินใจแบบ multimodal ขนาด 27B ภายใต้ลิขสิทธิ์ Apache-2.0 โดยความโดดเด่นของโมเดลนี้คือไม่ได้ทำหน้าที่สร้างข้อความ (Text Generation) แต่จะอ่านอินพุตเพียงครั้งเดียวและส่งคืนค่าความน่าจะเป็นสำหรับทุกคำตอบของทุกคำถาม
สำหรับนักพัฒนา ความสามารถนี้ช่วยให้จัดการทั้งระบบ routing, การจัดหมวดหมู่ (classification), visual grounding และการตรวจสอบวิดีโอได้ครบจบภายในการเรียกใช้งาน open-weight เพียงครั้งเดียว
TL;DR
- ขนาด: พารามิเตอร์ 26.09B (แบบ dense รวมถึง vision encoder ขนาด 0.46B) รองรับ context 131,072 tokens ต่อคำถาม
- การรันโมเดล: ทดสอบบน AMD Instinct MI325X จำนวน 1 ตัวด้วย weights แบบ BF16 ปัจจุบันยังไม่มีการระบุรุ่น quantized อย่างเป็นทางการ
- ประสิทธิภาพ: ทำคะแนน SR-Text ได้สูงสุดในบรรดาโมเดลการตัดสินใจ 6 โมเดลจากการทดสอบภายใน
- จุดเด่น: ทำคะแนนได้ 97.8 ในด้านเครื่องมือ SR-Text และระบบอัตโนมัติ (เป็นความแม่นยำที่ปรับแก้ค่าความน่าจะเป็นจากการเดาแล้ว)
- จุดด้อย: ทำคะแนนในส่วน SR-Box (9 โดเมน) ได้ 54.6% ซึ่งต่ำกว่าโมเดลรุ่นพี่น้องอย่าง d3-turbo อยู่ 5.0 จุด
d3-ultra คืออะไร?
d3-ultra คือโมเดลการตัดสินใจแบบ System One จากตระกูล Decision 3.0 ของ vLLM Semantic Router ที่มีขนาดตั้งแต่ 0.6B ถึง 27B โดยเน้นการตอบคำถามด้วยค่าความน่าจะเป็น
กระบวนการทำงานเริ่มจากการส่งสถานะ (ข้อความ หรือ JSON พร้อมรูปภาพหรือวิดีโอ) และชุดคำถาม ซึ่งแต่ละคำถามสามารถระบุประเภทได้หลากหลาย เช่น Choice (เลือกตอบ), Yes / No (คืนค่าความน่าจะเป็นของคำว่า ใช่), Score (ให้คะแนนตามสเกล), Box (ระบุตำแหน่งในภาพหรือวิดีโอ) และ Track (ติดตามเป้าหมายในวิดีโอ)
นอกจากนี้ รูปภาพยังสามารถแทรกอยู่ภายในคำถามและตัวเลือกได้ เช่น ในการทำควิซที่อาจแสดงรูปถ่าย 1 รูป แล้วให้เลือกคำตอบจากภาพลายเส้น 4 ภาพ
กลไกการทำงานของ d3-ultra
โมเดลนี้ใช้แนวคิดหลักคือ state once โดยจะอ่านอินพุตเพียงครั้งเดียวต่อการร้องขอ และตอบทุกคำถามจากการอ่านครั้งเดียวนั้น ซึ่งช่วยเพิ่มประสิทธิภาพในการประมวลผล
โครงสร้างหลักใช้สถาปัตยกรรม Qwen3.5 พร้อม 64 layers แบ่งเป็น linear-attention 48 layers และ full-attention 16 layers แม้ใน card จะไม่ได้ระบุชื่อ base checkpoint แต่ข้อมูลจาก vLLM ระบุว่า d3 รุ่นพี่น้องถูกพัฒนาต่อยอดมาจาก Qwen3.8-27B
สำหรับการตอบแบบ Box โมเดลจะคืนค่ากล่อง 1 กล่องเสมอพร้อมค่าความเชื่อมั่น (confidence) หากค่าความเชื่อมั่นใกล้ 0 หมายความว่าเป้าหมายไม่อยู่ในภาพ ทั้งนี้หากคำถามเกินขีดจำกัด 131,072 tokens ระบบจะแจ้งเตือนด้วยข้อความ max_length_exceeded ทันทีโดยไม่มีการตัดทอนข้อมูลทิ้งอย่างเงียบๆ
ประสิทธิภาพในแบบทดสอบ Benchmarks
ทีมวิจัยได้เปรียบเทียบ d3-ultra กับโมเดลชั้นนำอย่าง GLiDE V1.2, d1-ultra, d3-turbo, d3 และ Jev 1.14 ในการทดสอบภายใน 2 รายการหลัก
รายการแรกคือ SR-Text ซึ่งประกอบด้วยการร้องขอแบบข้อความกว่า 1 หมื่นรายการและคำถามกว่า 7 หมื่นข้อ ครอบคลุมทักษะจาก 34 public benchmarks และงานใหม่ๆ เช่น การตรวจสอบ SQL และ ticket routing โดยผลคะแนน (0-100) มีดังนี้:
- d3-ultra: 87.2
- GLiDE V1.2: 85.1
- d1-ultra: 83.4
- d3-turbo: 83.1
- d3: 81.4
- Jev 1.14: 73.1
d3-ultra เป็นผู้นำในเกือบทุกด้าน ยกเว้นด้านศิลปะและรสนิยมของมนุษย์ (arts and human taste) ที่ d1-ultra ยังคงทำได้ดีกว่าเล็กน้อย
ส่วนการทดสอบ SR-Box ที่เน้นการระบุตำแหน่งวัตถุ d3-ultra ทำคะแนนรวมได้ 58.2% ซึ่งทีมงานระบุว่า d3-turbo ยังคงแข็งแกร่งกว่าในรูปภาพธรรมชาติ แต่ d3-ultra จะโดดเด่นกว่ามากในด้านการวิเคราะห์แผนภูมิ (charts)
ในด้านความเร็ว (Latency) เมื่อรันบน AMD Instinct MI325X การตอบ 1 คำถามเกี่ยวกับภาพถ่ายใช้เวลาเพียง 304 ms และหากเพิ่มเป็น 255 คำถามจะใช้เวลารวม 2.16 วินาที หรือเฉลี่ยเพิ่มขึ้นเพียง 7.3 ms ต่อคำถามเท่านั้น
วิธีการติดตั้งและใช้งาน
ผู้ใช้งานสามารถเลือกใช้งาน d3-ultra ได้ผ่าน 4 ช่องทางหลัก:
- Transformers:
AutoModel.from_pretrained("vllm-sr/d3-ultra", trust_remote_code=True)ควรใช้ร่วมกับ transformers==5.17.0 และแพ็คเกจเสริม flash-linear-attention เพื่อความเร็วสูงสุด
- vLLM Semantic Router Engine:
vllm-sr serve -e vllm-sr/d3-ultra- Free API: สามารถใช้บริการผ่าน decision.vllm-sr.ai พร้อมคีย์ฟรีตามที่ระบุใน card
Asif Razzaq ในฐานะ CEO ของ Marktechpost AI Media Inc. และวิศวกรผู้มีวิสัยทัศน์ ยังคงมุ่งมั่นนำเสนอเนื้อหาทางเทคนิคที่แข็งแกร่งผ่านแพลตฟอร์ม Marktechpost ซึ่งมียอดการเข้าชมกว่า 2 ล้านครั้งต่อเดือน เพื่อเผยแพร่ความรู้ด้าน machine learning และ deep learning ให้เข้าถึงผู้ชมในวงกว้างอย่างต่อเนื่อง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร