
อดีตนักวิจัย Deepmind มั่นใจใช้แนวทาง AlphaGo แก้ปัญหา AI ประสาทหลอน
ประเด็นสำคัญ
- Thore Graepel อดีตนักวิจัย Deepmind ก่อตั้ง Metis Reasoning เพื่อยกระดับความน่าเชื่อถือของ AI โดยใช้กลไกของ AlphaGo เป็นต้นแบบในการตรวจสอบผลลัพธ์
- แนวทางใหม่นี้แยกความรู้ออกจากน้ำหนักโมเดล (model weights) โดยเก็บไว้ในบัญชีแยกประเภทภายนอกที่มีโมดูลอิสระคอยตรวจสอบสมมติฐานเทียบกับหลักฐาน
- แม้เป้าหมายหลักคือการลดอาการประสาทหลอน (hallucinations) และเพิ่มการอ้างอิงแหล่งที่มา แต่ปัจจุบันโครงการนี้ยังอยู่ในขั้นกรอบแนวคิดทางทฤษฎีและยังไม่มีระบบที่ใช้งานได้จริง
Thore Graepel อดีตนักวิจัย Deepmind มุ่งมั่นสร้างระบบ AI ที่สามารถติดตามสิ่งที่ตนเองรู้และตรวจสอบทุกข้อสรุปเทียบกับหลักฐานจริง โดยเขาระบุว่าเพียงแค่การขยายขนาดโมเดลภาษาให้ใหญ่ขึ้นไม่สามารถแก้ปัญหาความไม่แน่นอนนี้ได้
Graepel เชื่อว่าหลักการที่ทำให้ AlphaGo เอาชนะ Lee Sedol ยอดฝีมือโกะระดับโลกได้ในปี 2016 สามารถนำมาปรับใช้เพื่อเพิ่มความเชื่อมั่นให้กับ AI และหุ่นยนต์ได้ เขาได้นำเสนอแนวทางของ Metis Reasoning ในงาน GTC ของ Nvidia ที่เบอร์ลิน ซึ่งเป็นจังหวะเดียวกับที่ Nvidia กำลังขยายแพลตฟอร์มสำหรับหุ่นยนต์และ physical AI โดยมีเป้าหมายในการ เปลี่ยนปัญหาด้านข้อมูลของหุ่นยนต์ให้กลายเป็นปัญหาด้านการประมวลผล
บัญชีแยกประเภทความรู้แทนความรู้ที่ฝังอยู่ใน model weights
Metis มองว่าโมเดลภาษาปัจจุบันเปรียบได้กับเครือข่ายทำนายของ AlphaGo ที่ทำได้เพียงเสนอตาเดินที่เป็นไปได้เท่านั้น แต่ AlphaGo เหนือกว่าด้วยการจับคู่เครือข่ายนั้นกับการค้นหาอย่างเป็นระบบ จนนำไปสู่การ ค้นพบ Move 37 อันโด่งดัง ซึ่งเป็นท่าเดินที่มนุษย์มีโอกาสทำเพียงหนึ่งในหมื่น Metis จึงต้องการนำพลังการค้นหาลักษณะนี้มาใช้กับการให้เหตุผลทั่วไป
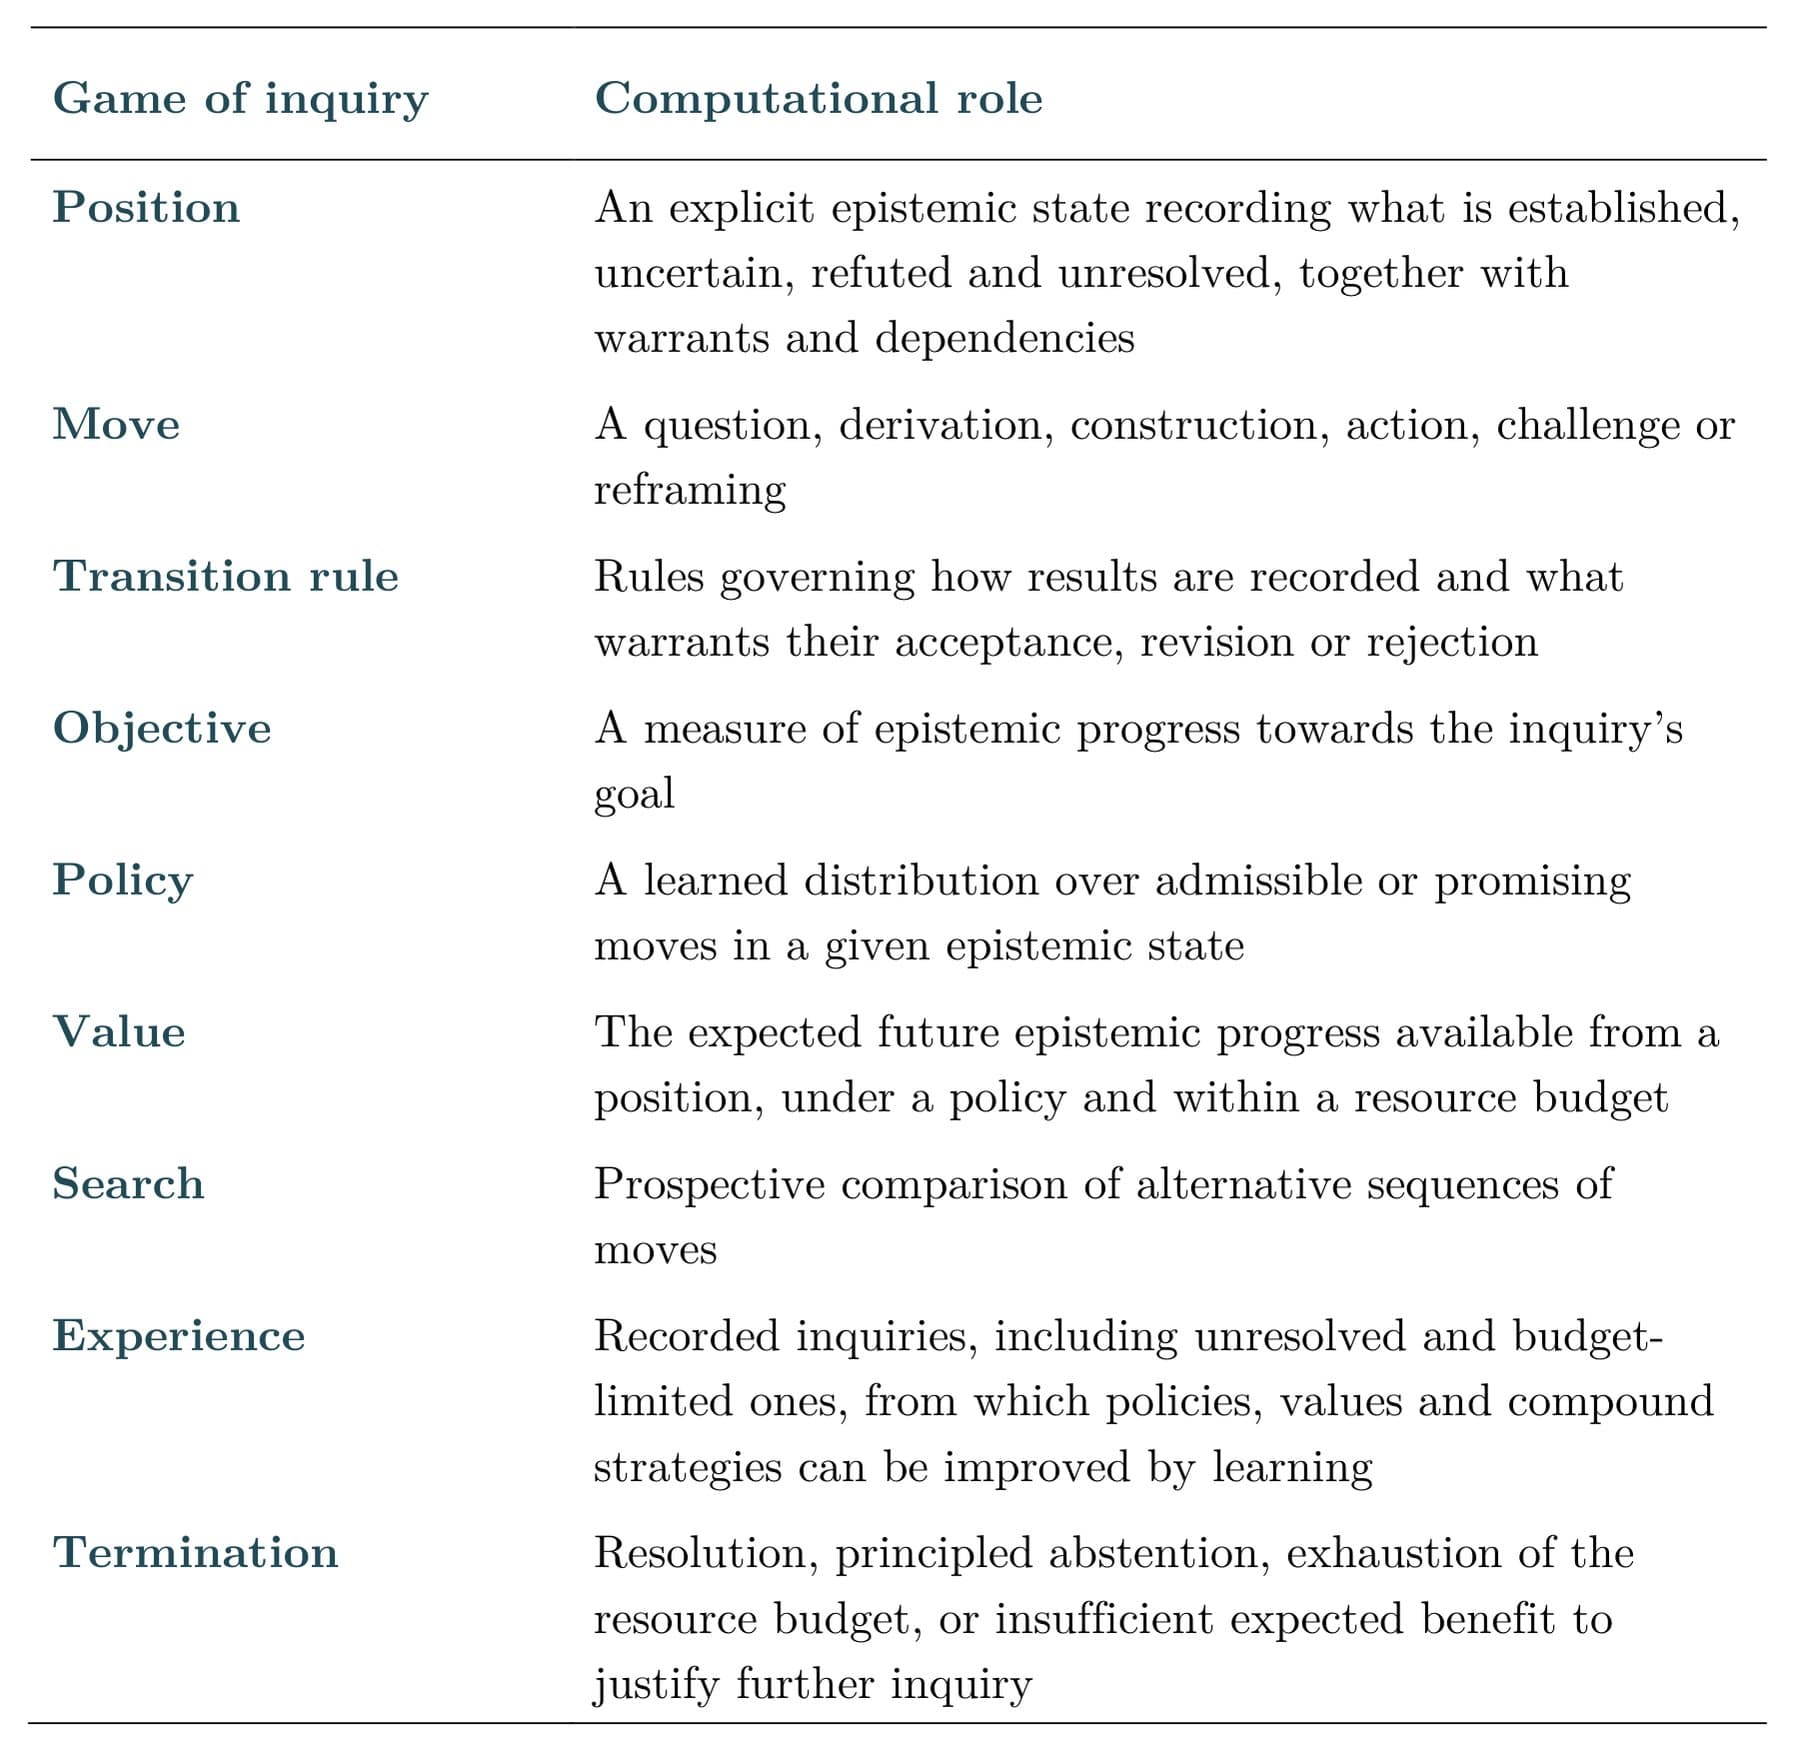
หัวใจสำคัญของแนวคิดนี้คือ "บัญชีแยกประเภทความรู้ที่ชัดเจน" (explicit knowledge ledger) ซึ่งทำหน้าที่เหมือนกระดานเกม แนวคิดคล้ายคลึงกันนี้เคยปรากฏใน GraphRAG ของ Microsoft ที่จัดระเบียบข้อมูลเป็นกราฟความรู้ และ AlphaGeometry2 ของ Google ที่ใช้เอนจินสัญลักษณ์ตรวจคำตอบคณิตศาสตร์ แต่ Metis ต้องการขยายผลไปสู่คำถามปลายเปิดในโลกความจริง
ระบบนี้จะบันทึกสิ่งที่รับรู้ ระดับความมั่นใจ และประเด็นที่ยังสงสัยไว้ในบัญชีแยกประเภท โดยมีโมดูลแยกส่วนคอยตรวจสอบข้อมูลใหม่เทียบกับการพิสูจน์หรือหลักฐานเชิงประจักษ์ หากสมมติฐานใดถูกตีตก ระบบจะประเมินผลกระทบที่เชื่อมโยงกันใหม่ทั้งหมด โดย AI จะเลือก "ตาเดิน" หรือแนวทางการตั้งคำถามและการทดลองที่ช่วยลดความไม่แน่นอนได้มากที่สุดก่อนจะให้คำตอบ
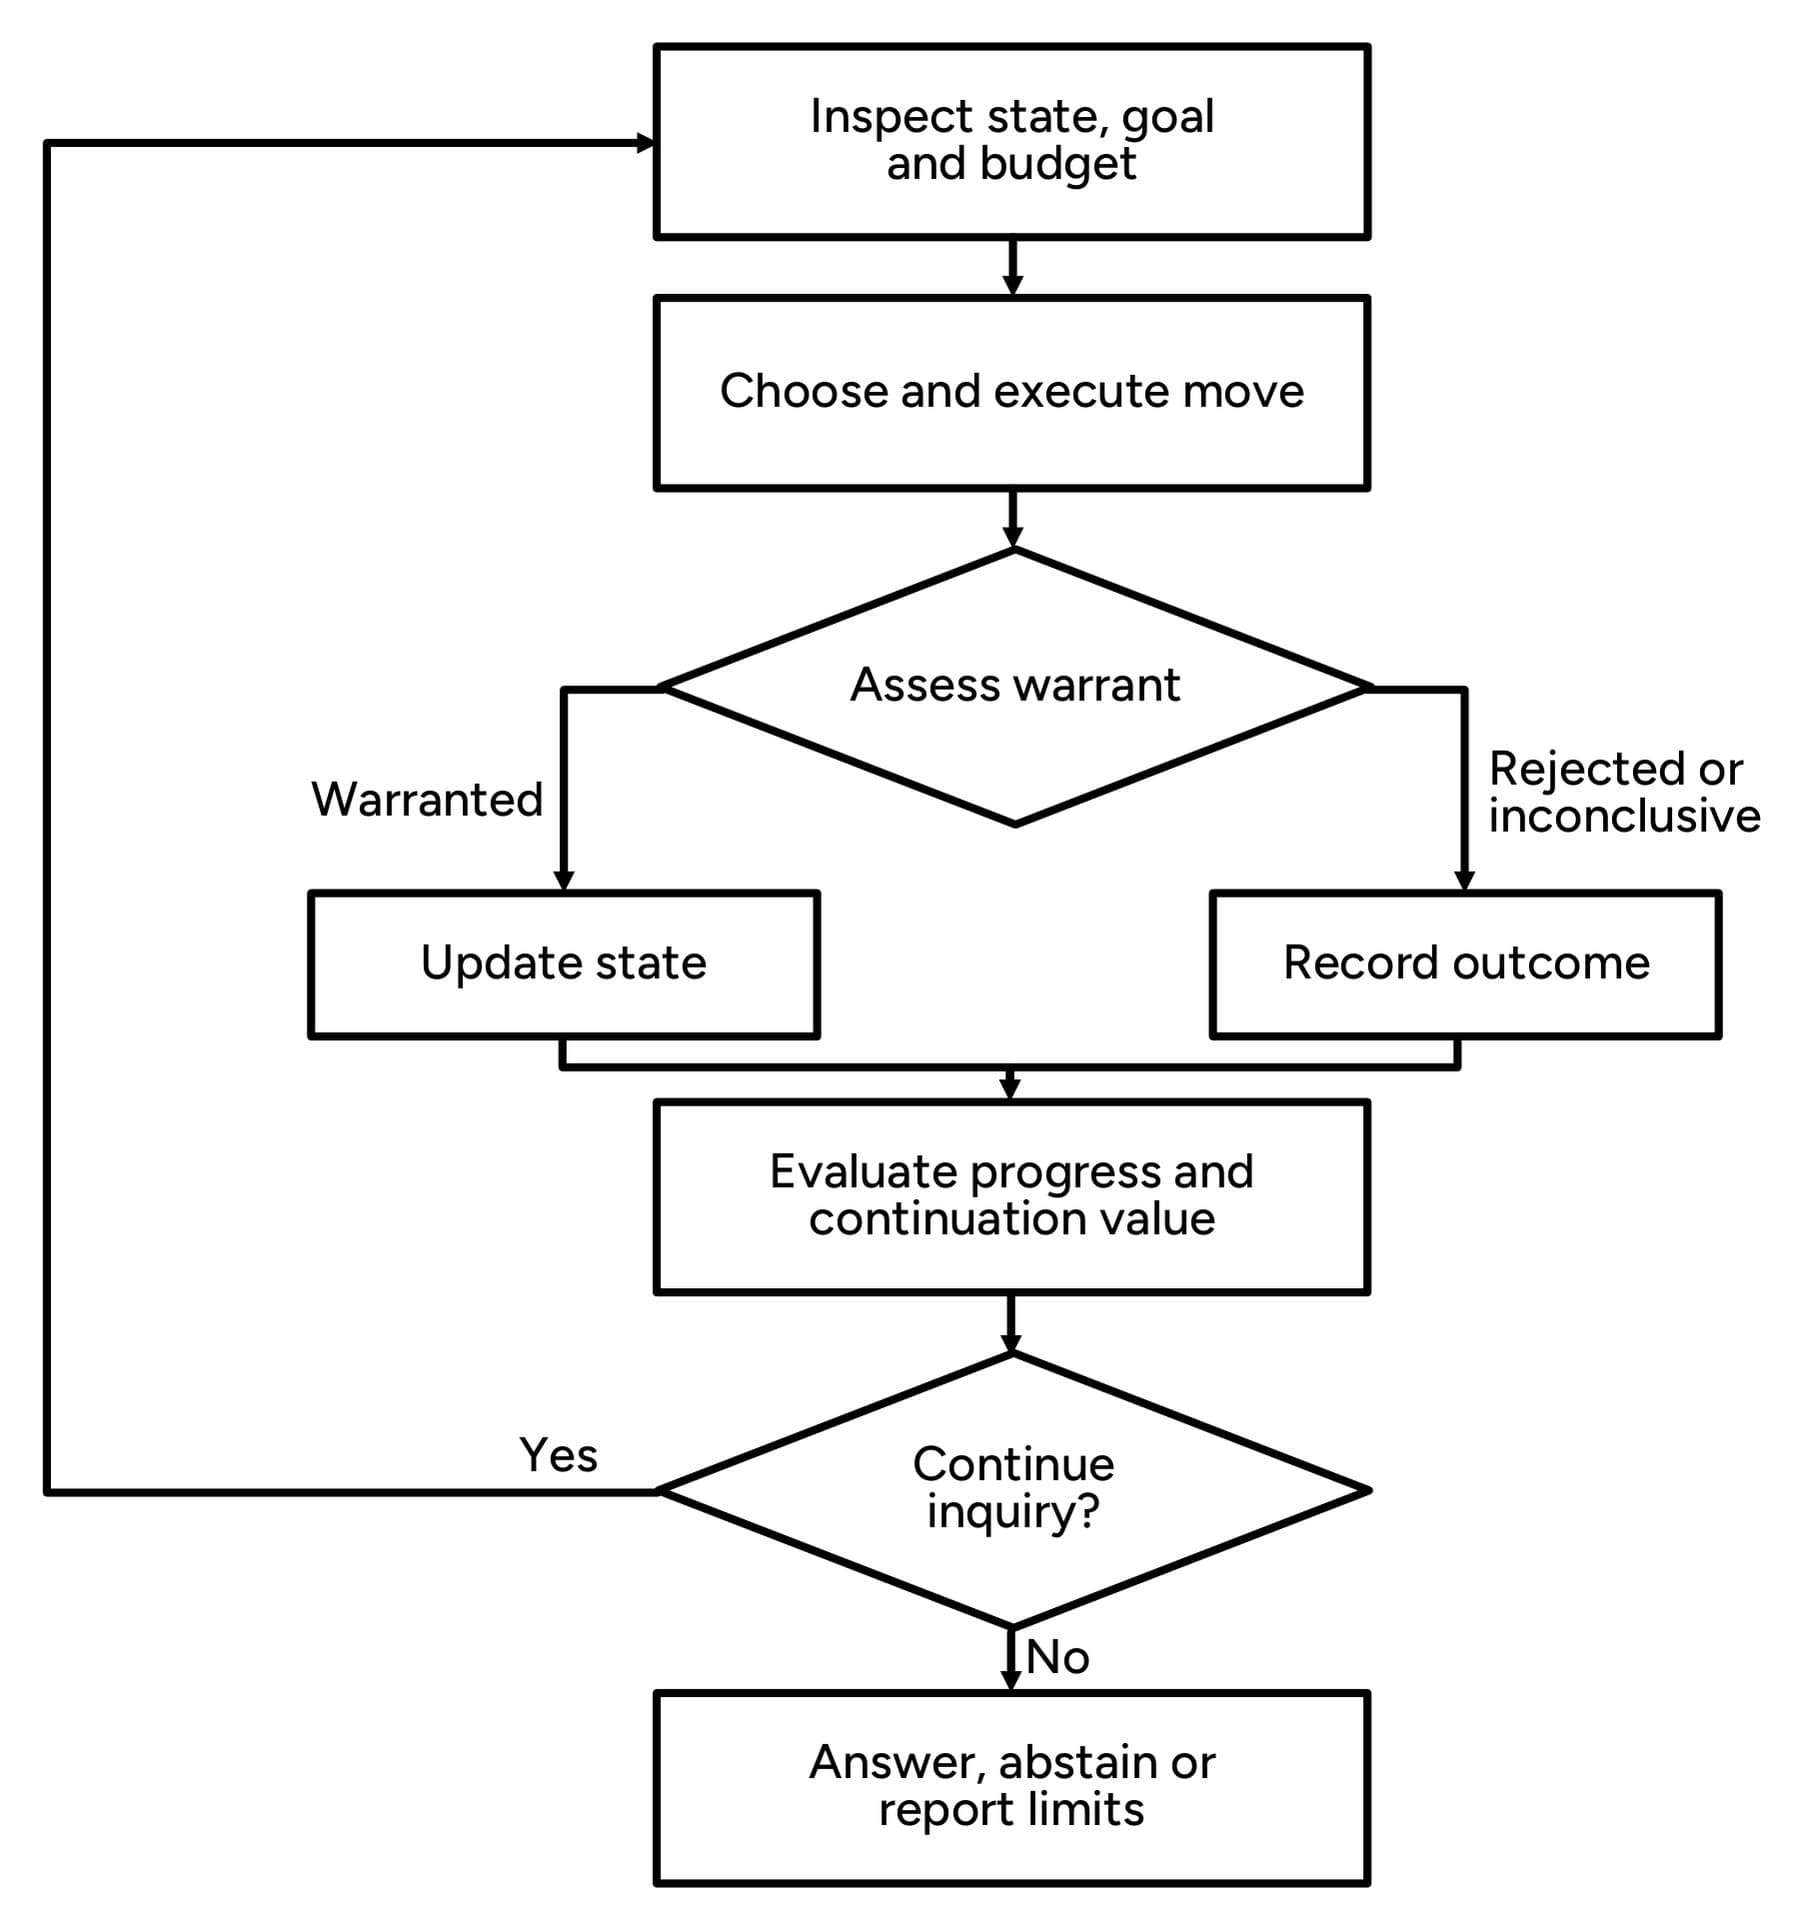
โครงข่ายประสาทเทียมสองชุดจะทำหน้าที่เสนอและประเมินทางเลือกเช่นเดียวกับ AlphaGo ซึ่ง Metis ระบุว่าโครงสร้างนี้จะช่วยลดอาการประสาทหลอน ให้คำอธิบายที่อ้างอิงแหล่งที่มาได้ และสามารถแก้ไขหรือลบความรู้ที่ผิดพลาดได้ทันทีโดยไม่ต้องฝึกฝนโมเดลใหม่ ซึ่งจะเป็นประโยชน์อย่างมากต่อโมเดลขนาดเล็กบนอุปกรณ์ edge และหุ่นยนต์
บริษัทยังไม่ไว้ใจโมเดลภาษาในภารกิจวิกฤต
แม้การเพิ่มข้อมูลและกำลังประมวลผลจะทำให้ AI เก่งขึ้น แต่ Metis แย้งว่านั่นไม่ได้แก้ปัญหาพื้นฐานที่โมเดลสร้างคำตอบขึ้นมาเองโดยตรวจสอบย่อยไม่ได้ รายงานวิจัยชี้ว่า อาการประสาทหลอนเกิดจากกระบวนการฝึกฝนเอง ที่เน้นความสมเหตุสมผลของข้อความมากกว่าความเป็นจริง และแม้แต่ กลไก chain of thought ในปัจจุบันก็มักจะซ่อนกระบวนการสรุปผลที่แท้จริงเอาไว้
ข้อบกพร่องเหล่านี้ส่งผลให้ AI มีผลกระทบทางเศรษฐกิจน้อยกว่าที่ควร เพราะในงานด้านการแพทย์ การเงิน หรือหุ่นยนต์ ความผิดพลาดที่ไม่สามารถสืบหาต้นตอได้เป็นความเสี่ยงที่ยอมรับไม่ได้ Metis จึงเชื่อว่า AI จำเป็นต้องมีระบบตรวจสอบได้ตั้งแต่ระดับรากฐาน
อย่างไรก็ตาม สมุดปกขาว (white paper) นี้ยังคงเป็นเพียงแผนงานวิจัยที่ยังไม่มีระบบจริงหรือผลทดสอบประสิทธิภาพ (benchmarks) มารองรับ ทีมงานยอมรับว่าความท้าทายใหญ่คือโลกความจริงซับซ้อนกว่าเกมโกะ เพราะข้อมูลมักไม่ครบถ้วนและมีราคาสูง ซึ่งต้องจับตาดูว่าระบบแบบสัญลักษณ์นี้จะก้าวข้ามขีดจำกัดเดิมๆ ในอดีตได้หรือไม่
คลื่นลูกใหม่ของศิษย์เก่า Deepmind บนเส้นทางสตาร์ทอัพ
Graepel คือหนึ่งในสถาปนิกผู้อยู่เบื้องหลังความสำเร็จอย่าง AlphaGo, AlphaZero และ MuZero โดยเขามีประสบการณ์ทั้งจาก Microsoft Research และ Google Deepmind ก่อนจะลาออกมาเปิดบริษัทเองในช่วงฤดูร้อนที่ผ่านมา ปัจจุบันเขากำลังระดมทุนรอบแรกประมาณหลักสิบล้านดอลลาร์ และมีแผนขยายระดมทุนต่อเนื่องอีกหลายร้อยล้านดอลลาร์ในอนาคต
เขากลายเป็นบุคลากรระดับเก๋าคนล่าสุดที่ออกจาก Google ตามรอย David Silver ผู้ก่อตั้ง Ineffable Intelligence และ Tim Rocktäschel จาก Recursive ท่ามกลางกระแสการไหลออกของบุคลากรใน Deepmind ที่ส่วนหนึ่งระบุว่าเกิดจากปัญหาด้านระบบราชการ การเข้าถึงทรัพยากรชิป และการสูญเสียอิสระในการบริหารงานภายใต้ Google
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร