tag: Multimodal AI

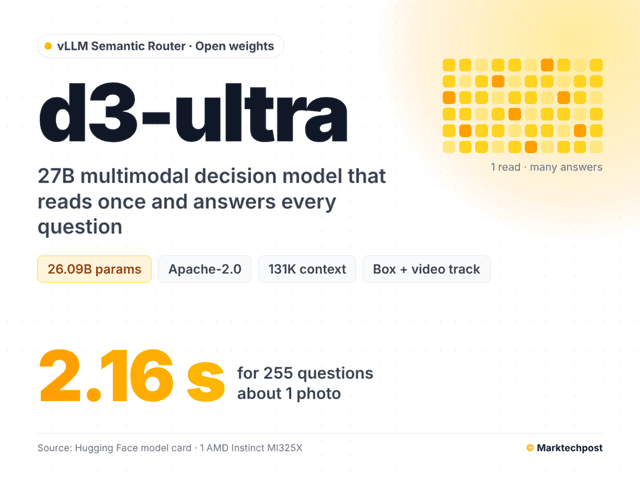
เปิดตัว d3-ultra โมเดลการตัดสินใจ Multimodal โอเพนซอร์สขนาด 27B

เปิดตัว d3-ultra โมเดลการตัดสินใจ Multimodal โอเพนซอร์สขนาด 27B

· By: TanasakP
vLLM Semantic Router เปิดตัว d3-ultra โมเดลแบบ open-weight ขนาด 27B ที่สามารถประมวลผลข้อความ รูปภาพ และวิดีโอได้ในครั้งเดียวเพื่อส่งคืนค่าความน่าจะเป็นสำหรับการตัดสินใจโดยเฉพาะ
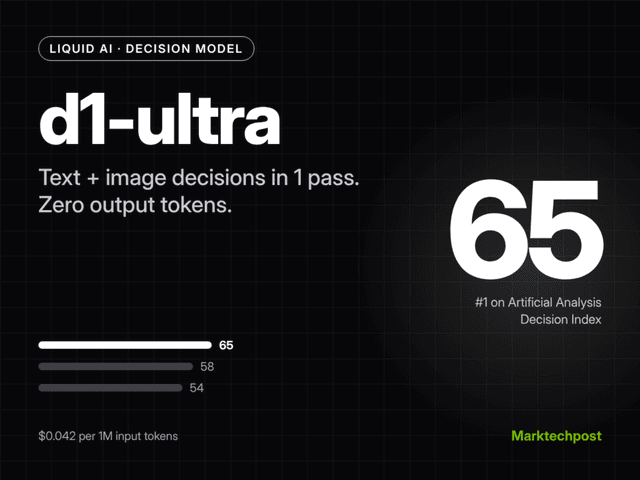
Liquid AI เปิดตัว d1-ultra โมเดลตัดสินใจ Multimodal ทุบสถิติใหม่

Liquid AI เปิดตัว d1-ultra โมเดลตัดสินใจ Multimodal ทุบสถิติใหม่

· By: AttapolK
Liquid AI เปิดตัว d1-ultra โมเดลตัดสินใจสำหรับข้อความและรูปภาพที่รันแบบ one forward pass โดยไม่ต้องสร้าง output tokens ทำคะแนนสูงสุดอันดับ 1 บน Artificial Analysis Decision Index
Liquid AI เปิดตัว Open d1 โมเดลตัดสินใจแบบ Multimodal ไร้ Output Token

Liquid AI เปิดตัว Open d1 โมเดลตัดสินใจแบบ Multimodal ไร้ Output Token

· By: NatapolK
Liquid AI เปิดตัว Open d1 โมเดล Multimodal แบบ open-weight สองรุ่นใหม่ d1-3B และ d1-omni-600M ชูจุดเด่นการส่งคืนคำตอบแบบความน่าจะเป็นได้ทันทีโดยไม่ต้องสร้างข้อความ ช่วยให้ตัดสินใจได้แบบเรียลไทม์
Google เปิดตัว AI Edge Foresight บน Mac จดบันทึกอัจฉริยะแบบออฟไลน์

Google เปิดตัว AI Edge Foresight บน Mac จดบันทึกอัจฉริยะแบบออฟไลน์

· By: SirilukP
Google เปิดตัวโมเดล EmbeddingGemma 2 พร้อมแอป AI Edge Foresight สำหรับ Mac ชูจุดเด่นด้านการเปลี่ยนบันทึกสั้นให้เป็นสรุปเนื้อหาฉบับเต็มจากการบันทึกเสียง โดยประมวลผลบนตัวเครื่องทั้งหมดเพื่อความเป็นส่วนตัว
Google เปิดตัว EmbeddingGemma 2 โมเดล Multimodal ขนาดจิ๋ว

Google เปิดตัว EmbeddingGemma 2 โมเดล Multimodal ขนาดจิ๋ว

· By: TanasakP
Google เปิดตัว EmbeddingGemma 2 โมเดล Open Model ขนาดไม่ถึง 1B ที่รองรับการค้นหาข้ามรูปแบบทั้งข้อความ โค้ด ภาพ วิดีโอ และเสียง พร้อมเทคโนโลยีประหยัดพื้นที่จัดเก็บข้อมูล
เปิดตัว EmbeddingGemma 2 โมเดล Multimodal ขนาดเล็กประสิทธิภาพสูง

เปิดตัว EmbeddingGemma 2 โมเดล Multimodal ขนาดเล็กประสิทธิภาพสูง

· By: SirilukP
Google เปิดตัว EmbeddingGemma 2 โมเดล Multimodal Embedding น้ำหนักเบาที่รองรับทั้งข้อความ โค้ด รูปภาพ วิดีโอ และเสียง ออกแบบมาเพื่อการประมวลผลบนอุปกรณ์โดยเฉพาะด้วยพารามิเตอร์เพียง 740 ล้านตัว
Reka AI เปิดตัว Rho-1 โมเดล Omni ตัวเดียวคุมทั้งภาพ วิดีโอ และหุ่นยนต์

Reka AI เปิดตัว Rho-1 โมเดล Omni ตัวเดียวคุมทั้งภาพ วิดีโอ และหุ่นยนต์

· By: NatapolK
Rho-1 คือ omni-model ขนาด 1.9 หมื่นล้านพารามิเตอร์ที่ประมวลผลได้ทั้งข้อความ ภาพ วิดีโอ และการสั่งการหุ่นยนต์ในระบบเดียวโดยไม่ต้องพึ่งพาโมเดลภายนอก
เปิดผลงาน 4 นักพัฒนาสุดล้ำที่สร้างสรรค์ด้วย Gemini 3.8 Flash

เปิดผลงาน 4 นักพัฒนาสุดล้ำที่สร้างสรรค์ด้วย Gemini 3.8 Flash

· By: SirilukP
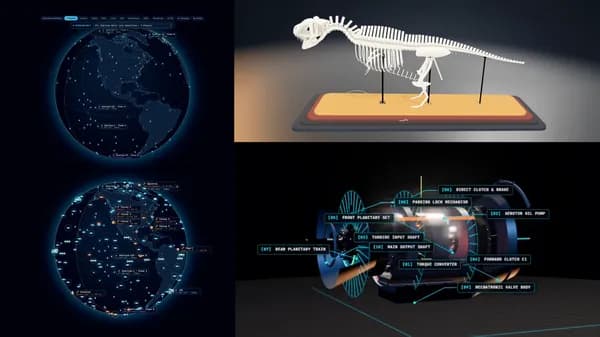
สรุปผลงานการใช้ Gemini 3.8 Flash ในการสร้างแบบจำลอง 3D ทั้งวิถีโคจรดาวเทียม โครงกระดูกไดโนเสาร์ และระบบเกียร์อัตโนมัติที่ซับซ้อนด้วยความสามารถในการให้เหตุผลหลายขั้นตอน
NeoMME: สถาปัตยกรรม Single-Tower Multimodal Encoder แบบใหม่ที่ทั้งเร็วและประหยัดพื้นที่

NeoMME: สถาปัตยกรรม Single-Tower Multimodal Encoder แบบใหม่ที่ทั้งเร็วและประหยัดพื้นที่

NeoMME เป็นตระกูลโมเดล Multimodal Encoder รุ่นใหม่ที่ใช้ Transformer เพียงตัวเดียวประมวลผลทั้งภาพและข้อความ ให้ประสิทธิภาพสูงในการค้นหาเอกสารภาพและรองรับหลายภาษา
สร้างระบบ Video และ Audio Multimodal ด้วย MiniMax-H3 ผ่าน ComfyUI API

สร้างระบบ Video และ Audio Multimodal ด้วย MiniMax-H3 ผ่าน ComfyUI API

· By: TanasakP
คู่มือการสร้างระบบผลิตสื่อมัลติโมดัลด้วย MiniMax-H3 โดยใช้ ComfyUI เป็นระบบหลังบ้านแบบ Headless เพื่อควบคุมการทำงานอัตโนมัติ ตั้งแต่การตรวจสอบฮาร์ดแวร์จนถึงการถอดรหัสวิดีโอและเสียง
Meta AI เปิดตัว Muse Glimmer โมเดล Agentic ขนาด 30B รันบน GPU ผู้บริโภคตัวเดียวได้สำเร็จ

Meta AI เปิดตัว Muse Glimmer โมเดล Agentic ขนาด 30B รันบน GPU ผู้บริโภคตัวเดียวได้สำเร็จ

· By: SirilukP
Meta เปิดตัว Muse Glimmer โมเดล multimodal แบบ Open-Weights ขนาด 30B ภายใต้ลิขสิทธิ์ Apache 2.0 ที่ถูกปรับแต่งให้มีความเร็วสูงและใช้ VRAM ต่ำเพียง 24 GB เหมาะสำหรับงาน Agent ในพื้นที่
ByteDance Seed เปิดตัว SeedRealtime: โมเดล LLM แบบ Full-Duplex รับรู้ภาพและเสียงจบในตัวเดียว

ByteDance Seed เปิดตัว SeedRealtime: โมเดล LLM แบบ Full-Duplex รับรู้ภาพและเสียงจบในตัวเดียว

· By: TanasakP
ทีม Seed ของ ByteDance เปิดตัว SeedRealtime โมเดลภาษาขนาดใหญ่ที่รวมการประมวลผลเสียง วิดีโอ และข้อความเข้าด้วยกันในสถาปัตยกรรมเดียว ช่วยให้โต้ตอบแบบมัลติโมดัลได้ต่อเนื่องและเป็นธรรมชาติเสมือนมนุษย์
MiniMax เปิดตัว MiniMax H3 โมเดล Omni-Modal เจนวิดีโอ 2K พร้อมเสียงสเตอริโอในตัว

MiniMax เปิดตัว MiniMax H3 โมเดล Omni-Modal เจนวิดีโอ 2K พร้อมเสียงสเตอริโอในตัว

· By: AttapolK
MiniMax เปิดตัวโมเดล AI ใหม่ MiniMax H3 ที่สามารถประมวลผลข้อความ ภาพ วิดีโอ และเสียงได้ในบริบทเดียวกัน เพื่อสร้างวิดีโอความละเอียด 2K ความยาวสูงสุด 15 วินาทีพร้อมเสียงสเตอริโอคุณภาพสูง
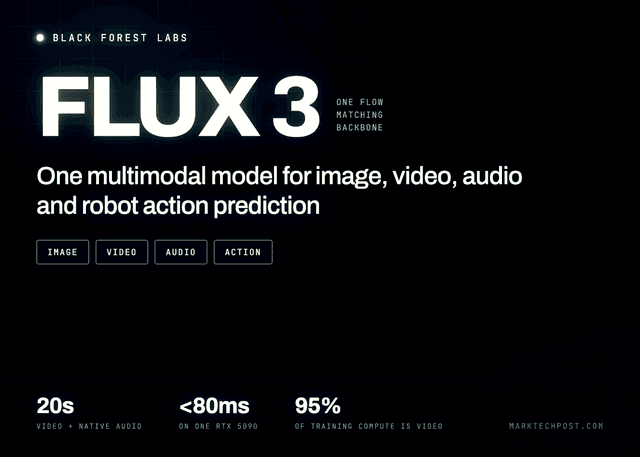
Black Forest Labs เปิดตัว FLUX 3 โมเดล Multimodal ล้ำสมัย รองรับทั้งภาพ วิดีโอ เสียง และหุ่นยนต์ในตัวเดียว

Black Forest Labs เปิดตัว FLUX 3 โมเดล Multimodal ล้ำสมัย รองรับทั้งภาพ วิดีโอ เสียง และหุ่นยนต์ในตัวเดียว

· By: SirilukP
Black Forest Labs เปิดตัว FLUX 3 โมเดลพื้นฐานแบบ Multimodal รุ่นแรกที่สามารถทำนายวิดีโอ เสียง และการเคลื่อนไหวของหุ่นยนต์ได้จากชุดน้ำหนักเพียงชุดเดียว โดยใช้สถาปัตยกรรม Self-Flow เพื่อความสมจริงระดับสูงสุด
Meta Superintelligence Labs เปิดตัว Muse Spark 1.1: โมเดลการให้เหตุผล Multimodal สำหรับระบบ Agent อัจฉริยะ

Meta Superintelligence Labs เปิดตัว Muse Spark 1.1: โมเดลการให้เหตุผล Multimodal สำหรับระบบ Agent อัจฉริยะ

Meta เปิดตัว Muse Spark 1.1 พร้อม Meta Model API ในเวอร์ชัน Public Preview ชูจุดเด่นด้านการใช้เครื่องมือ (Tool Use) และ Context Window ขนาด 1 ล้านโทเค็นที่บีบอัดข้อมูลได้เอง แม้ด้านการเขียนโค้ดยังเป็นรองคู่แข่งรายใหญ่