
NeoMME: สถาปัตยกรรม Single-Tower Multimodal Encoder แบบใหม่ที่ทั้งเร็วและประหยัดพื้นที่
TL;DR
เราขอแนะนำ NeoMME ตระกูลโมเดล Multilingual Multimodal Encoder ขนาด 260M และ 800M ที่มาพร้อมความแตกต่างจากโมเดล Generative ทั่วไป โดย NeoMME ไม่จำเป็นต้องใช้ Vision Tower แยกต่างหากหรือ Causal Language Model แต่ใช้สถาปัตยกรรม Bidirectional Transformer เพียงตัวเดียวในการประมวลผลทั้ง Text Tokens และ Image Patches ดิบ ซึ่งเราเทรนโมเดลทั้งหมดตั้งแต่ต้น (From Scratch) ด้วยเทคนิค Masked Discrete-diffusion Objective
เราได้ทำการ Fine-tuned NeoMME เพื่อใช้ในการค้นหาเอกสารภาพ (Visual Document Retrieval) ตามแนวทางของ ColPali โดย NeoMME-Retriever สามารถส่งคืน Embeddings ทั้งแบบ Dense และ Late-interaction ได้ในการประมวลผลเพียงครั้งเดียว (Forward Pass)
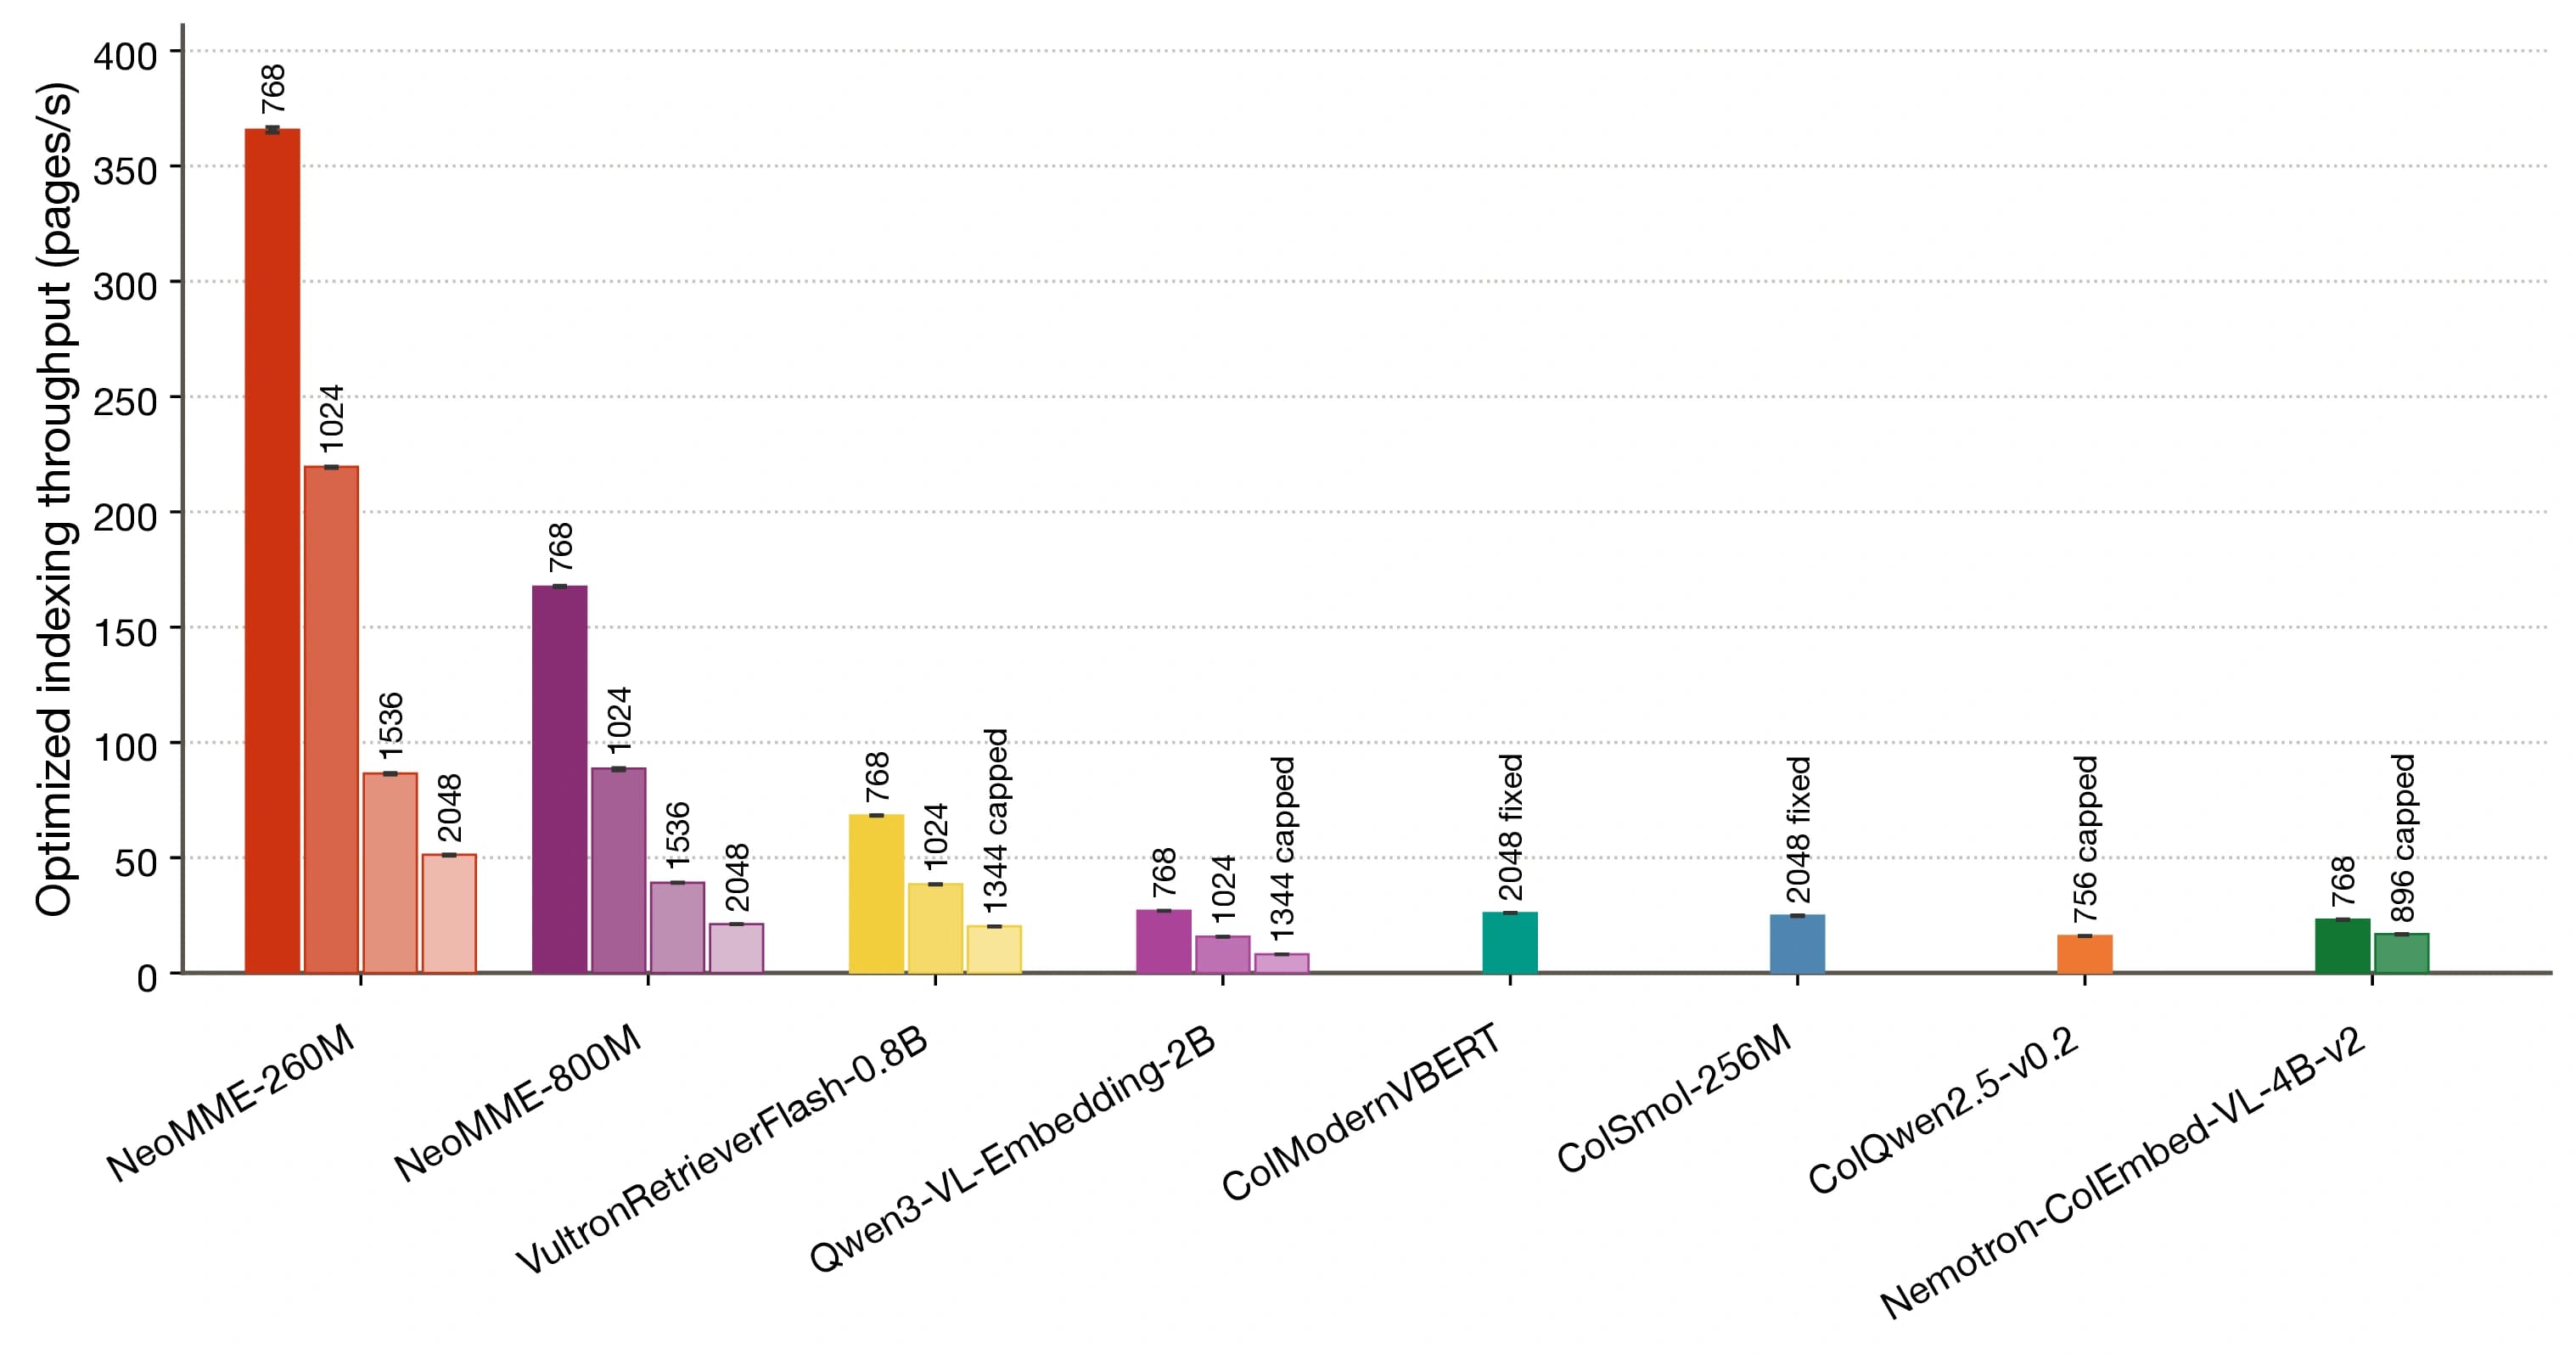
จากการทดสอบด้วย NVIDIA L40S GPU ที่ความละเอียดภาพ 2048×2048 โมเดลขนาด 260M สามารถประมวลผลได้เร็วถึง 51 หน้าต่อวินาที หรือคิดเป็น 2 เท่าของ ColModernVBERT นอกจากนี้การใช้เทคนิค Hierarchical Token Pooling และ Asymmetric Quantization ยังช่วยลดพื้นที่จัดเก็บดัชนีจาก 1.5 MB เหลือเพียง 6 kB ต่อหน้า (ลดลง 255 เท่า) โดยยังรักษาความแม่นยำ nDCG@10 ไว้ได้มากกว่า 95%
NeoMME พร้อมใช้งานแล้วบน Hugging Face Transformers ภายใต้ใบอนุญาต Apache 2.0
ทำไมต้องมี Multimodal Encoder อีกตัว?
เครื่องมือค้นหาเอกสารภาพในปัจจุบันส่วนใหญ่ดัดแปลงมาจากโมเดลภาษาขนาดใหญ่ที่เทรน Vision Encoder แยกต่างหาก แล้วใช้ Projector เชื่อมเข้ากับ Language Model ซึ่งสถาปัตยกรรมแบบ Causal Decoder นี้มักสร้างภาระด้านพารามิเตอร์และการคำนวณที่สูงเกินความจำเป็นสำหรับงานค้นหาหรือจัดประเภทที่ไม่ต้องสร้างข้อความใหม่
ModernBERT ได้นำการปรับปรุงสถาปัตยกรรมที่มีประสิทธิภาพมาสู่ Bidirectional Encoders และต่อยอดมาเป็น ModernVBERT ที่ยังคงใช้ SigLIP2 Vision Tower แยกต่างหาก แต่สำหรับ NeoMME (อ่านว่า "นี-โอ-มี") เราต้องการก้าวข้ามขีดจำกัดนั้นด้วยการรวมทุกอย่างไว้ใน Transformer ตัวเดียว โดยไม่ต้องแบกภาระของโครงสร้างเดิม
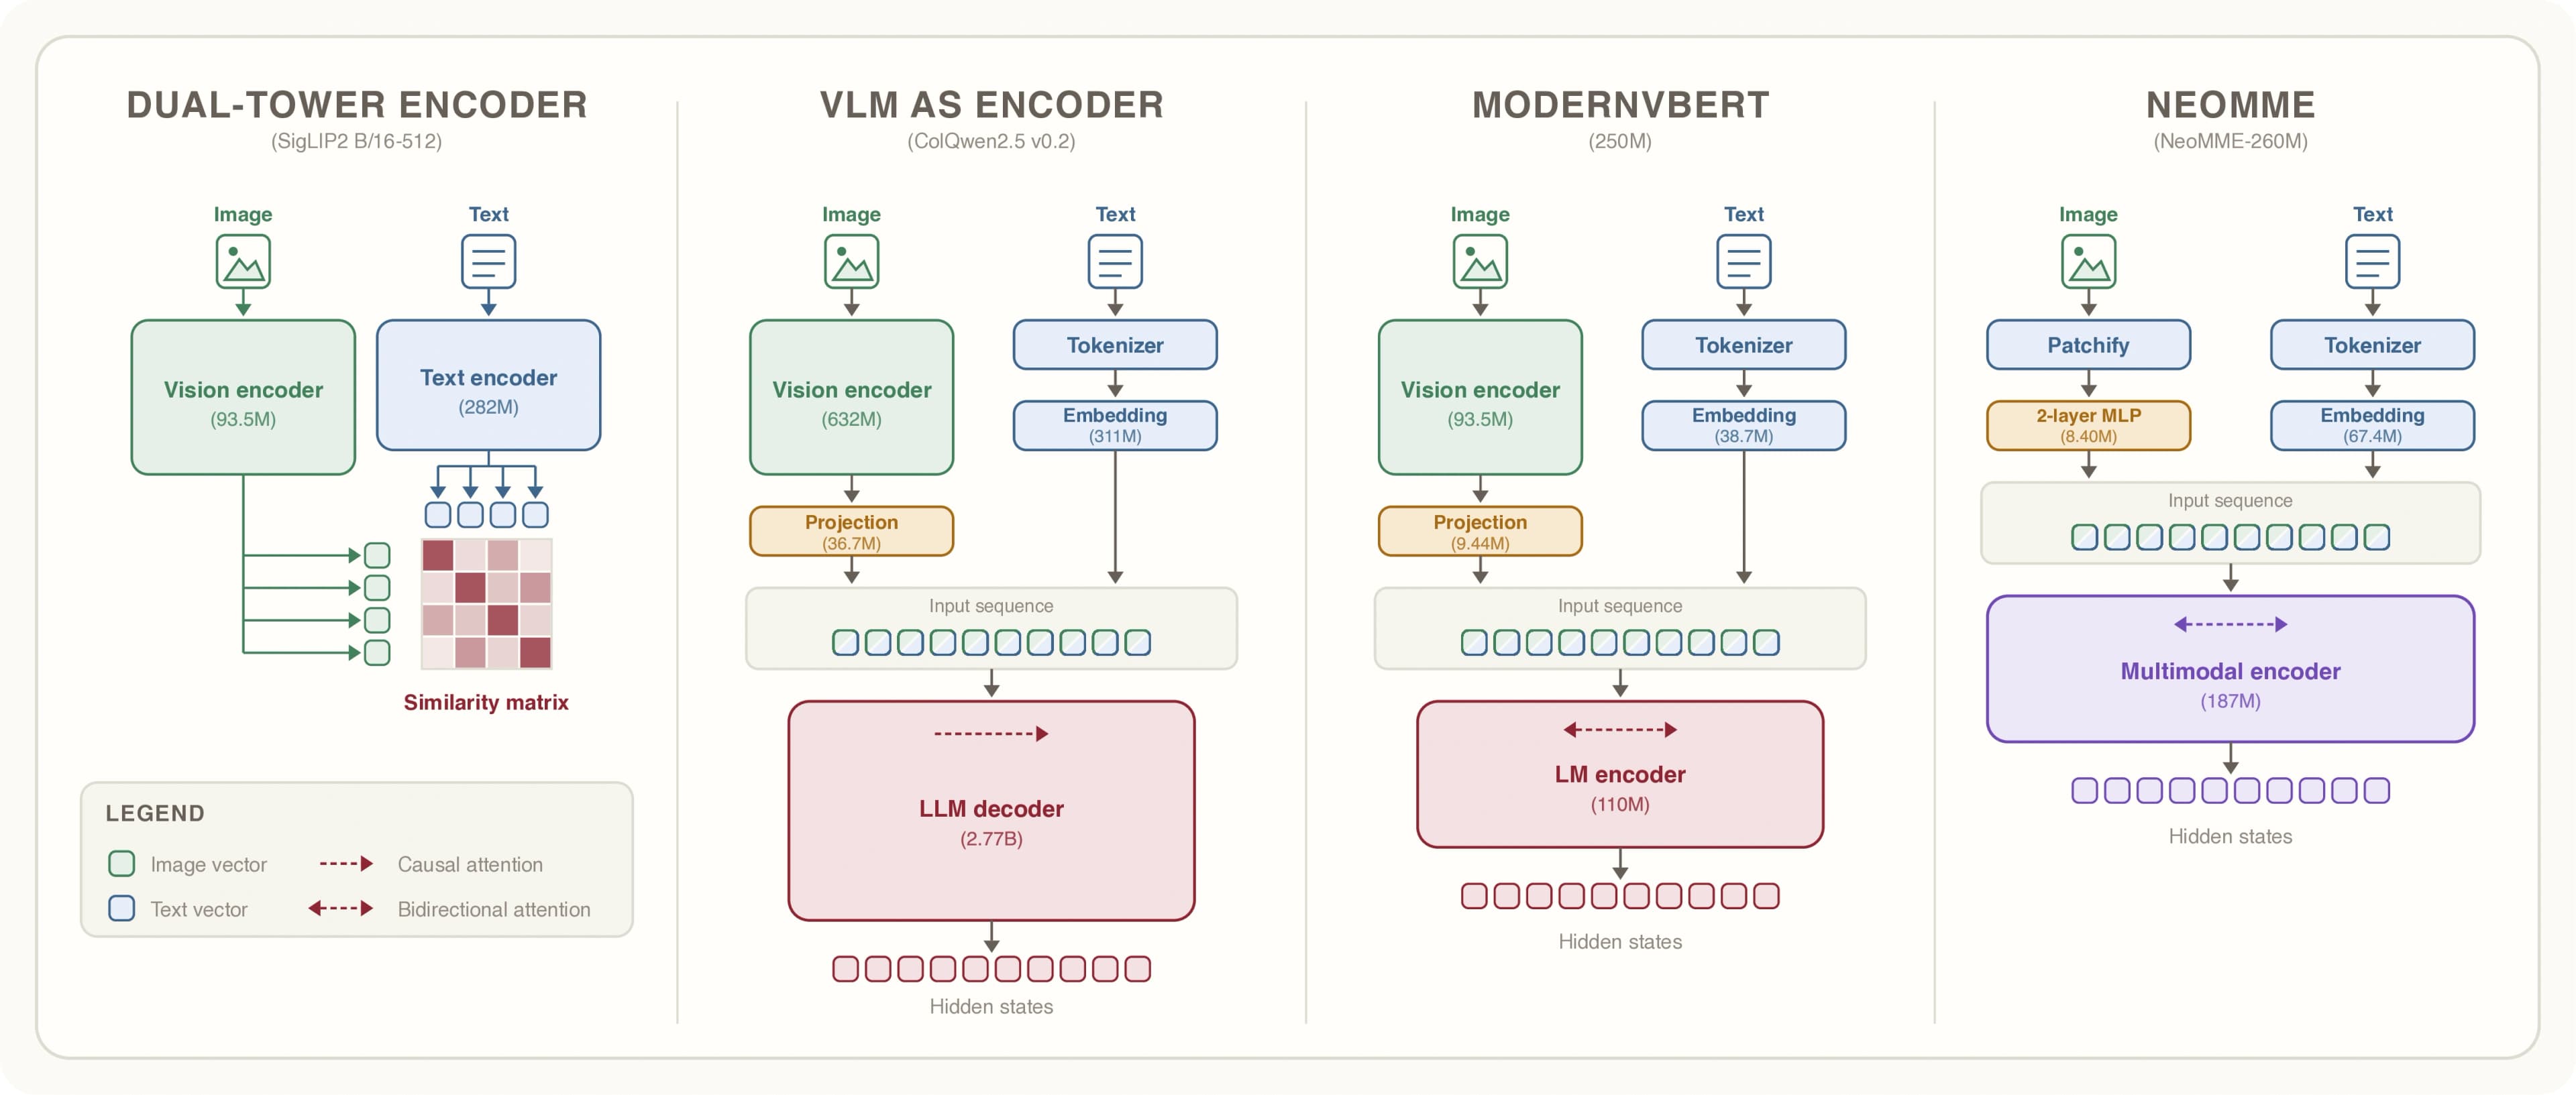
แนวทางของ NeoMME ต่างจากระบบ Dual-tower หรือ VLM ทั่วไปตรงที่ประมวลผลรูปภาพและข้อความผ่านเส้นทางเดียวกัน ทำให้การทำ Pretraining, Fine-tuning และการให้บริการ (Serving) ในทั้งสองรูปแบบทำได้ง่ายและมีประสิทธิภาพมากขึ้น
โครงสร้างหลักของ NeoMME Encoder
Transformer ตัวเดียวสำหรับทั้งภาพและข้อความ
NeoMME มีให้เลือกสองขนาดคือ 260M และ 800M โดยมีคุณสมบัติเด่นดังนี้:
- Native Multimodal Inputs: รับข้อมูลข้อความผ่าน Token Embeddings และรูปภาพผ่านการแบ่งเป็น Patch ขนาด 32×32 โดยใช้ Transformer Encoder ตัวเดียวกัน
- Dynamic Image Resolution: รองรับอัตราส่วนและขนาดภาพเดิม ทำให้โมเดลสามารถเน้นรายละเอียดในหน้าเอกสารที่ซับซ้อนได้อย่างเหมาะสม
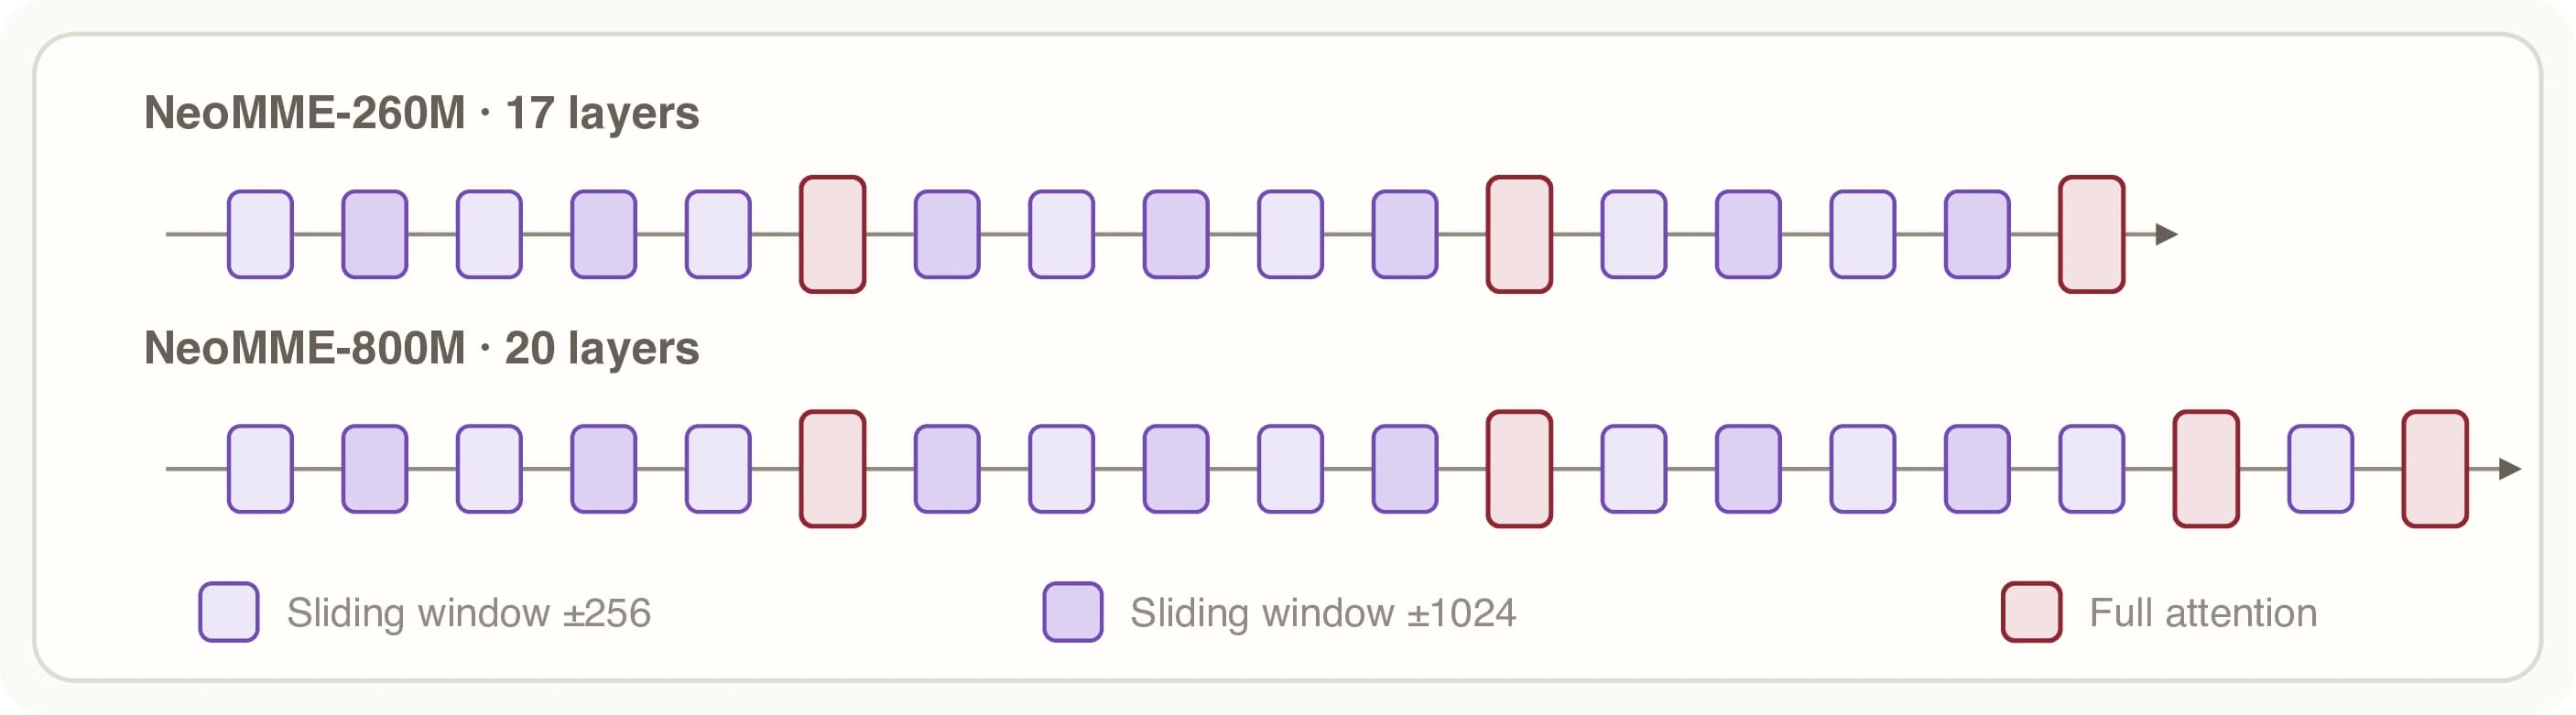
- Long Bidirectional Context: รองรับบริบทสูงสุด 16,384 Tokens (เพียงพอสำหรับภาพ 4K สองรูป) โดยสลับใช้ Sliding-window และ Global Attention เพื่อประสิทธิภาพสูงสุด
- Modern Encoder Stack: ใช้เทคนิคระดับสูง เช่น Grouped-query Attention และ 2D Rotary Position Embeddings พร้อม Tokenizer ที่รองรับหลายภาษา รวมถึง Code และสัญลักษณ์ทางคณิตศาสตร์
การเรียนรู้จากรูปภาพผ่าน Masked Text
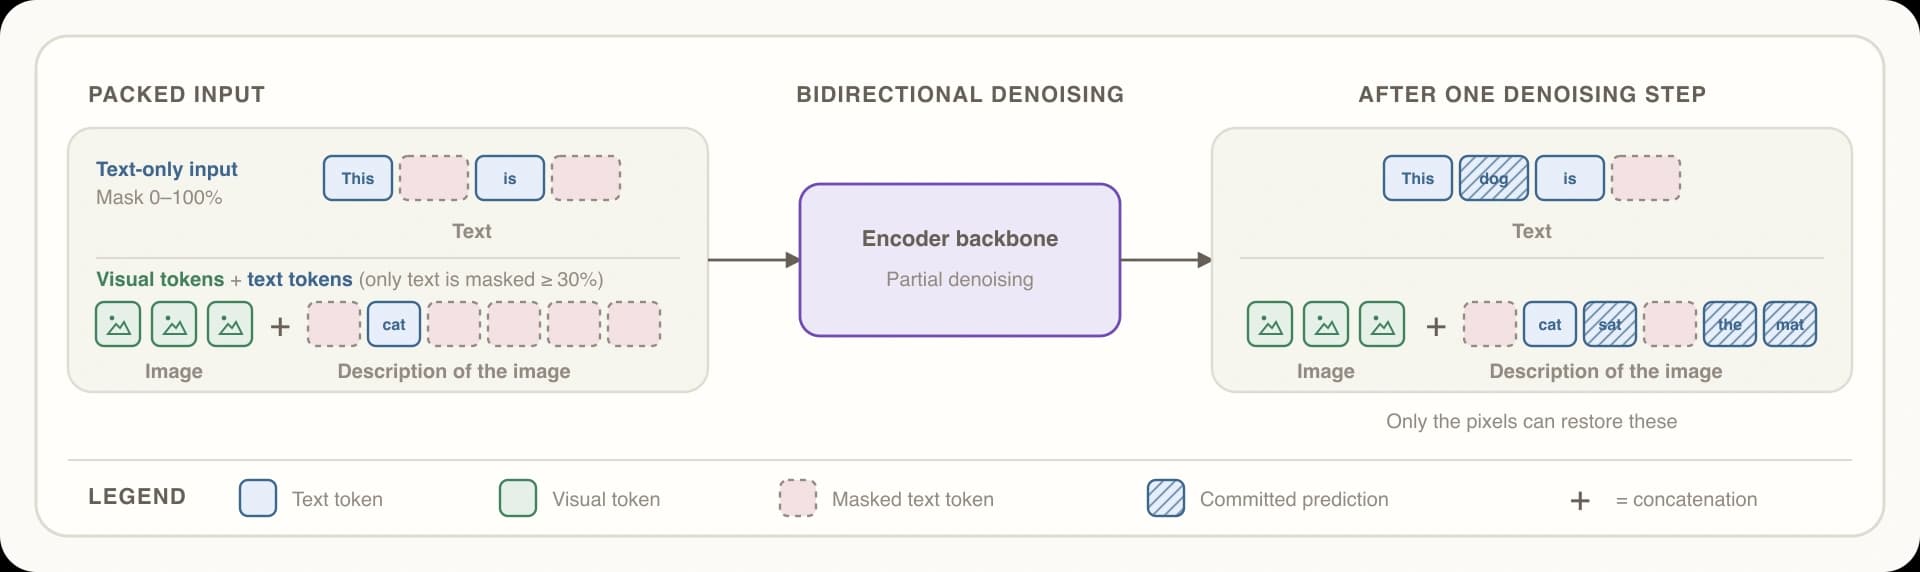
เราเทรน NeoMME ล่วงหน้าในฐานะ Discrete Masked-diffusion Text Denoiser โดยใช้วิธีสุ่มปิดบังข้อความ (Masking) ในระดับที่สูงขึ้นเพื่อบังคับให้โมเดลต้องดึงข้อมูลจากรูปภาพมาช่วยในการกู้คืนคำที่หายไป แทนที่จะใช้เพียงบริบทของภาษาเพียงอย่างเดียว
การฝึกฝนใช้ข้อมูลกว่า 5.24 แสนล้าน Tokens ครอบคลุมทั้งข้อความหลายภาษาและรูปภาพเอกสาร โดยใช้ Optimizer แบบ NorMuon เพื่อช่วยให้การเรียนรู้มีประสิทธิภาพสูงสุดภายใต้งบประมาณการเทรนที่จำกัด
NeoMME-Retriever: ยกระดับการค้นหาเอกสารภาพ เพื่อให้เห็นประสิทธิภาพจริง เราได้ Fine-tune โมเดลสำหรับการค้นหาเอกสารภาพโดยใช้แนวทางจาก ColPali ซึ่งระบบนี้จะประมวลผลหน้าเอกสารโดยตรงเป็นรูปภาพ ช่วยรักษาข้อมูลเลย์เอาต์ แผนภูมิ และรูปแบบฟอนต์ที่มักจะสูญหายไปในกระบวนการ OCR แบบเดิม
การออกแบบ Dual-head เพื่อความยืดหยุ่น
NeoMME-Retriever มาพร้อมหัวการค้นหา 2 รูปแบบที่เทรนร่วมกัน:
- Dense Head: สร้างเวกเตอร์เดียวขนาดกะทัดรัด (Mean Pooling) เหมาะสำหรับการค้นหาที่รวดเร็วด้วยเทคนิค ANN
- Late-interaction Head: สร้างเวกเตอร์สำหรับแต่ละ Token หรือ Patch (ขนาด 128 มิติ) ช่วยให้การจับคู่ระหว่างคำค้นหาและพื้นที่ในรูปภาพมีความแม่นยำสูงขึ้น
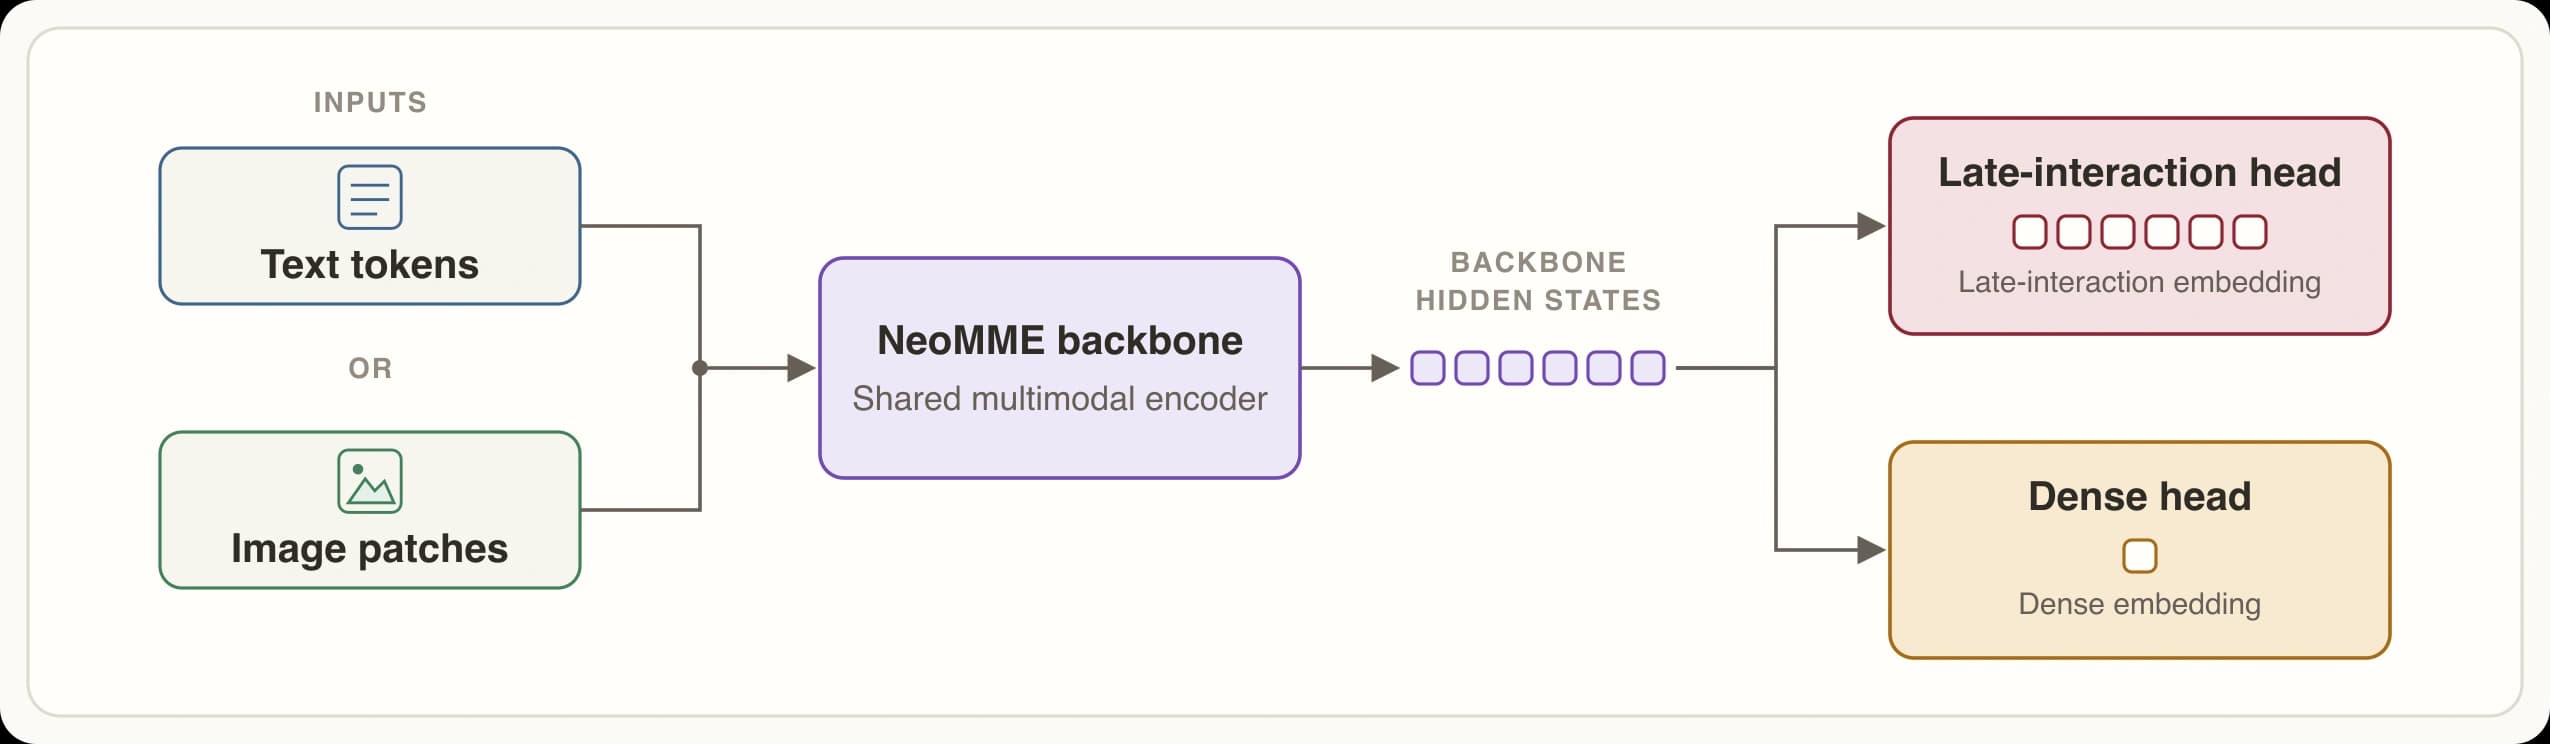
ความสามารถในการส่งคืนค่าทั้งสองแบบในการทำงานครั้งเดียว ช่วยให้นักพัฒนาสามารถใช้ Dense Embedding ในการดึงข้อมูลเบื้องต้นจากชุดข้อมูลมหาศาล แล้วใช้ Late-interaction ในการจัดอันดับใหม่ (Rerank) เพื่อผลลัพธ์ที่แม่นยำที่สุด
ประสิทธิภาพเหนือชั้นในขนาดที่กะทัดรัด
ในการทดสอบบนเกณฑ์มาตรฐาน ViDoRe v3 โมเดล NeoMME-Retriever-260M ทำคะแนนได้สูงสุดในกลุ่มโมเดลที่มีขนาดต่ำกว่า 800M โดยมีประสิทธิภาพใกล้เคียงกับโมเดลที่ใหญ่กว่าถึง 14 เท่า ส่วนรุ่น 800M ก็สามารถทำคะแนนได้เหนือกว่า ColPali v1.3 แม้จะมีพารามิเตอร์น้อยกว่าถึง 3.6 เท่า
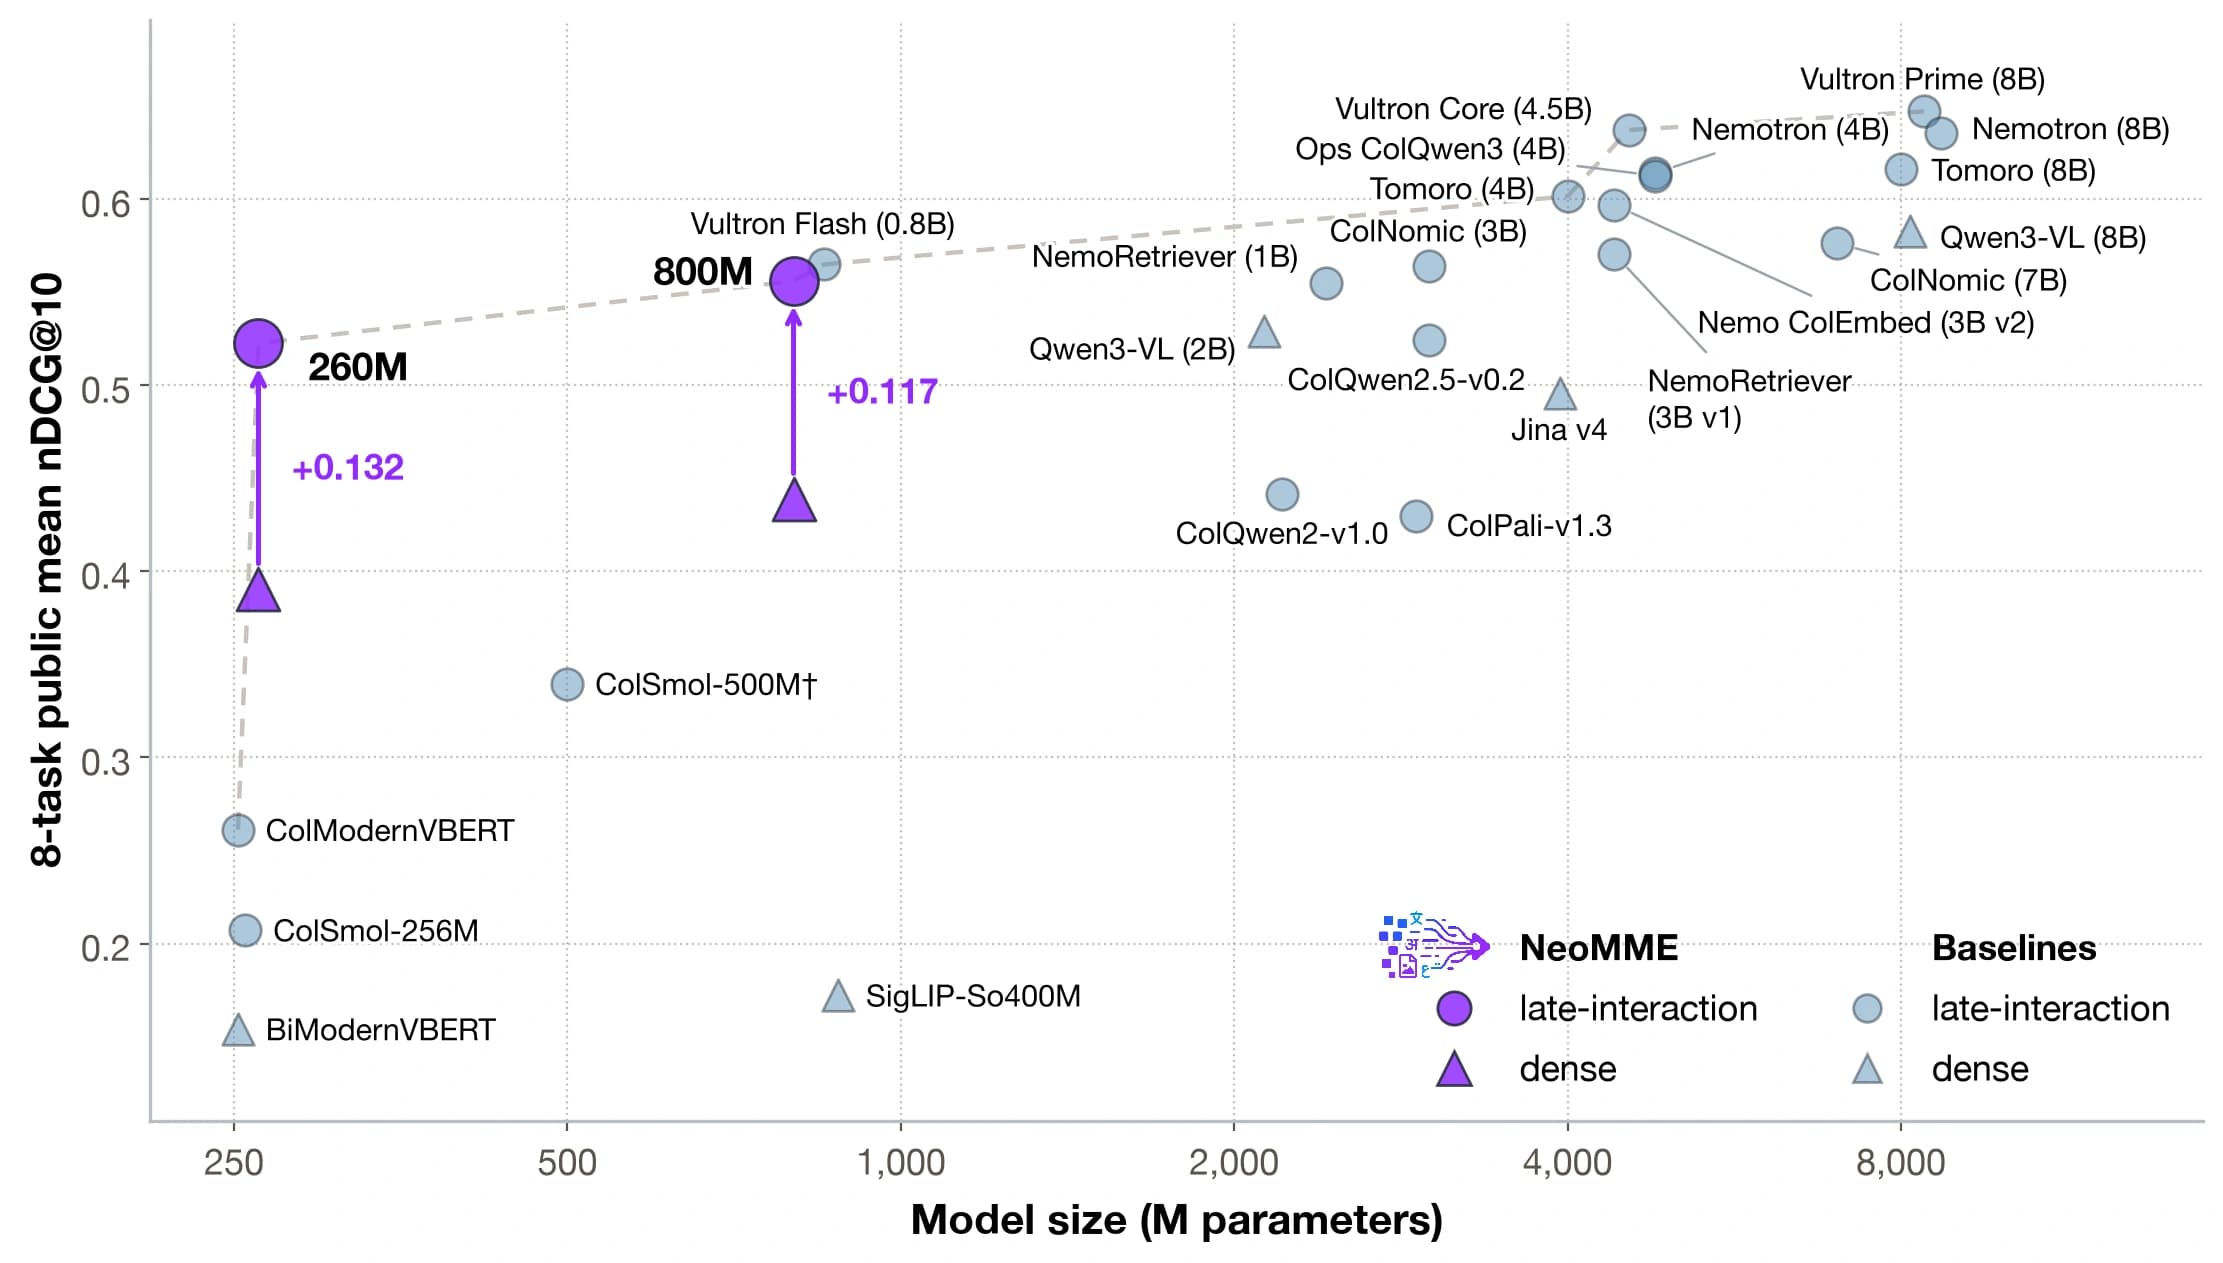
ตารางเปรียบเทียบประสิทธิภาพบน ViDoRe
| โมเดล | พารามิเตอร์ | v3 (@10) | v2 (@5) | v1 (@5) |
|---|---|---|---|---|
| ColModernVBERT | 250M | 0.261 | 0.407 | 0.806 |
| NeoMME-260M | 260M | 0.523 | 0.522 | 0.860 |
| NeoMME-800M | 800M | 0.556 | 0.559 | 0.874 |
| ColPali v1.3 | 2.92B | 0.430 | 0.547 | 0.848 |
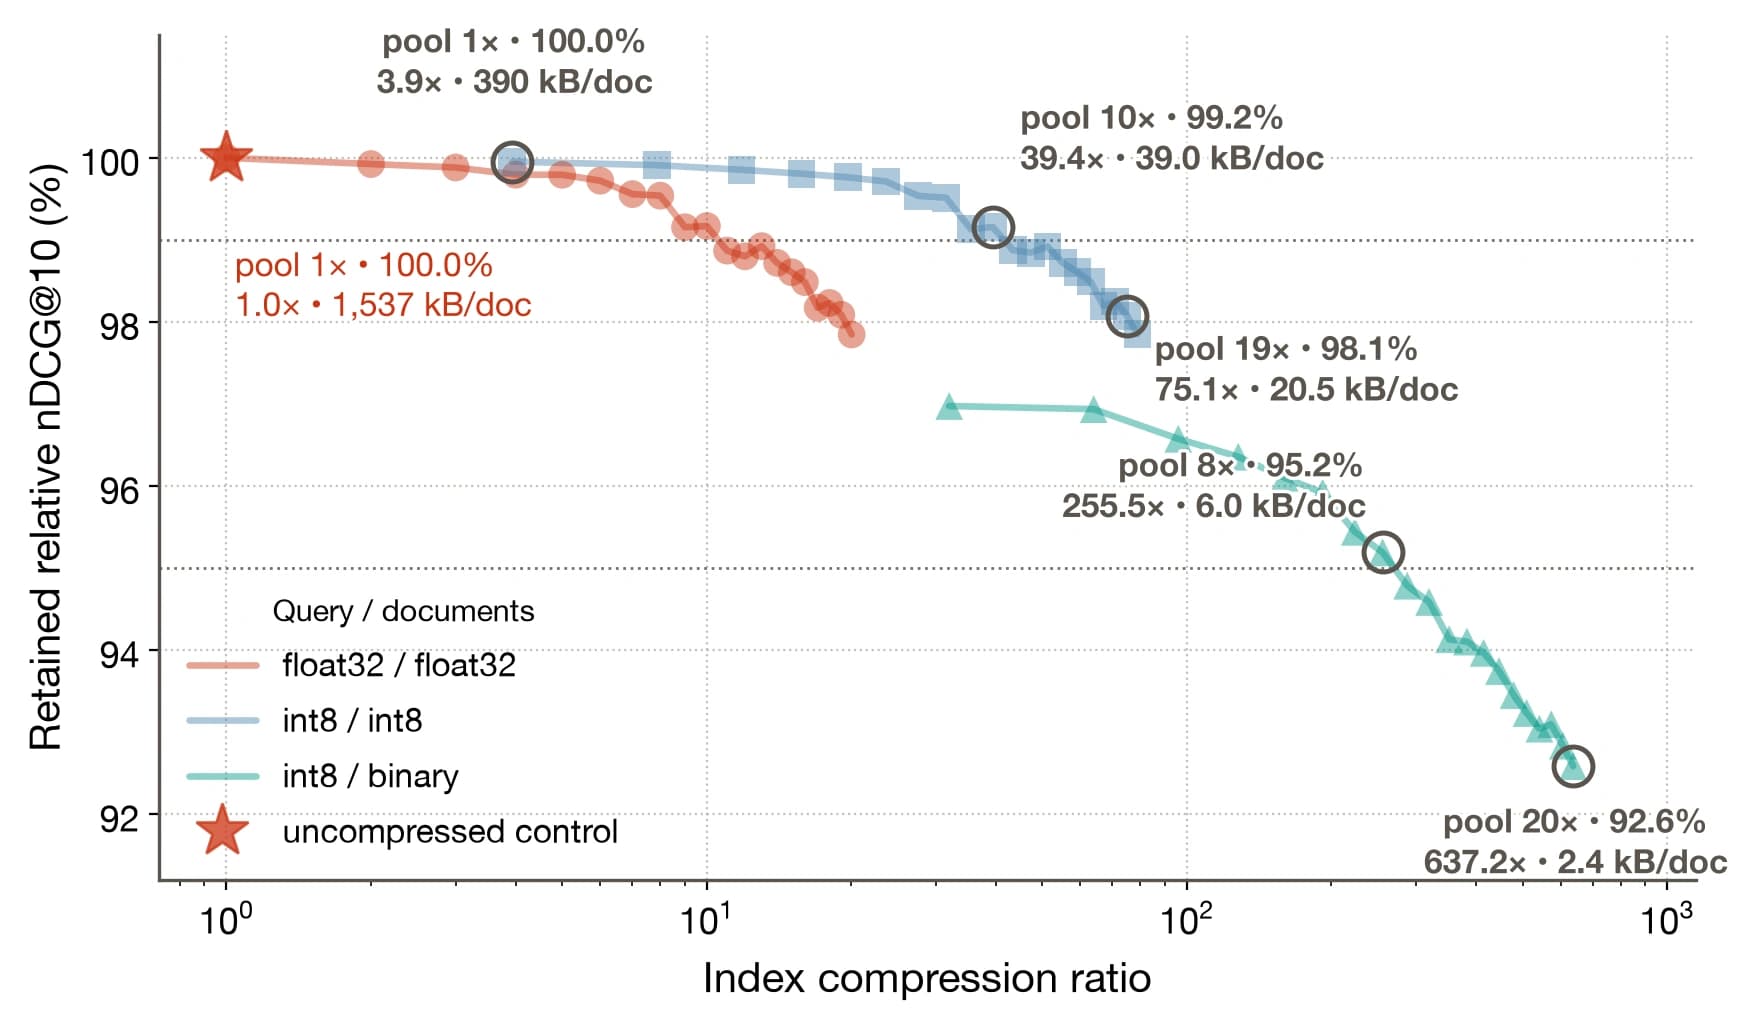
นวัตกรรมการบีบอัดข้อมูลสำหรับการใช้งานจริง เพื่อแก้ปัญหาพื้นที่จัดเก็บ Late-interaction Index ที่มักมีขนาดใหญ่ เราได้นำเทคนิค Hierarchical Token Pooling มาใช้ร่วมกับ Asymmetric Quantization ซึ่งช่วยลดขนาดข้อมูลลงได้มหาศาลจาก 1.5 MB เหลือเพียง 6 kB ต่อหน้า (บีบอัด 255 เท่า) โดยที่คุณภาพการค้นหายังคงยอดเยี่ยม
ในด้านความเร็วการ Encoding โมเดล NeoMME-Retriever-260M สามารถประมวลผลได้เร็วถึง 51 หน้าต่อวินาทีบน NVIDIA L40S ซึ่งเร็วกว่าคู่แข่งรายอื่นอย่างเห็นได้ชัด ช่วยลดต้นทุนในการสร้างดัชนีสำหรับคลังข้อมูลขนาดใหญ่
เริ่มต้นใช้งาน NeoMME-Retriever
ตัวอย่างโค้ดสำหรับการใช้งานผ่านไลบรารี transformers เพื่อดึงข้อมูลทั้งแบบ Dense และ Late-interaction:
pip install -U accelerate "transformers @ git+https://github.com/huggingface/transformers.git@main" "sentence-transformers>=6.0.0"from typing import Any, Literal
import requests
import torch
from PIL import Image
from sentence_transformers.util import cos_sim, mean_maxsim
from transformers import BatchFeature, NeoMMEForRetrieval, NeoMMEProcessor
# โหลดโมเดลและโปรเซสเซอร์
model_name = "Hcompany/NeoMME-260M-Retriever"
processor = NeoMMEProcessor.from_pretrained(model_name)
model = NeoMMEForRetrieval.from_pretrained(model_name, device_map="auto")
# เตรียมข้อมูลรูปภาพและคำค้นหา
image_urls = [
"https://github.com/tonywu71/colpali-cookbooks/blob/6ef1332da6bcb48c7ef1f19b25bfa555be7031a8/examples/data/shift_kazakhstan.jpg?raw=true",
"https://github.com/tonywu71/colpali-cookbooks/blob/6ef1332da6bcb48c7ef1f19b25bfa555be7031a8/examples/data/energy_electricity_generation.jpg?raw=true",
]
documents = [Image.open(requests.get(url, stream=True).raw) for url in image_urls]
queries = ["ตัวอย่างคำถามภาษาฝรั่งเศส...", "Which hour had the highest generation?"]
# ประมวลผลและค้นหา
# (ดูรายละเอียดเพิ่มเติมได้ในเอกสารประกอบฉบับเต็ม)จากการค้นหาไปสู่ Visual RAG
NeoMME-Retriever สามารถนำไปสร้างระบบ Visual Retrieval-Augmented Generation (RAG) ที่ดึงภาพหน้าเอกสารดั้งเดิมส่งให้ VLM ประมวลผลได้โดยตรง ช่วยให้ AI เข้าใจตารางหรือไดอะแกรมที่ซับซ้อนได้ดีกว่าการดึงข้อมูลเฉพาะข้อความ คุณสามารถทดลองใช้งานได้ที่ HF Space: 🤗 tonywu71/neomme-retriever-demo
[
บทสรุป
NeoMME คือก้าวสำคัญของการพัฒนา Multimodal Encoder ที่รวมความสามารถในการประมวลผลภาพและข้อความหลายภาษาไว้ในโครงสร้างเดียวที่เรียบง่ายแต่ทรงพลัง ด้วยความเร็วที่สูงกว่าเดิมเท่าตัวและการบีบอัดข้อมูลที่ยอดเยี่ยม เราเชื่อว่าโมเดลนี้จะเป็นรากฐานสำคัญให้แก่นักพัฒนาในการสร้างระบบค้นหาและทำความเข้าใจข้อมูลแบบ Multimodal ที่มีประสิทธิภาพต่อไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร