
Liquid AI เปิดตัว d1-ultra โมเดลตัดสินใจ Multimodal ทุบสถิติใหม่
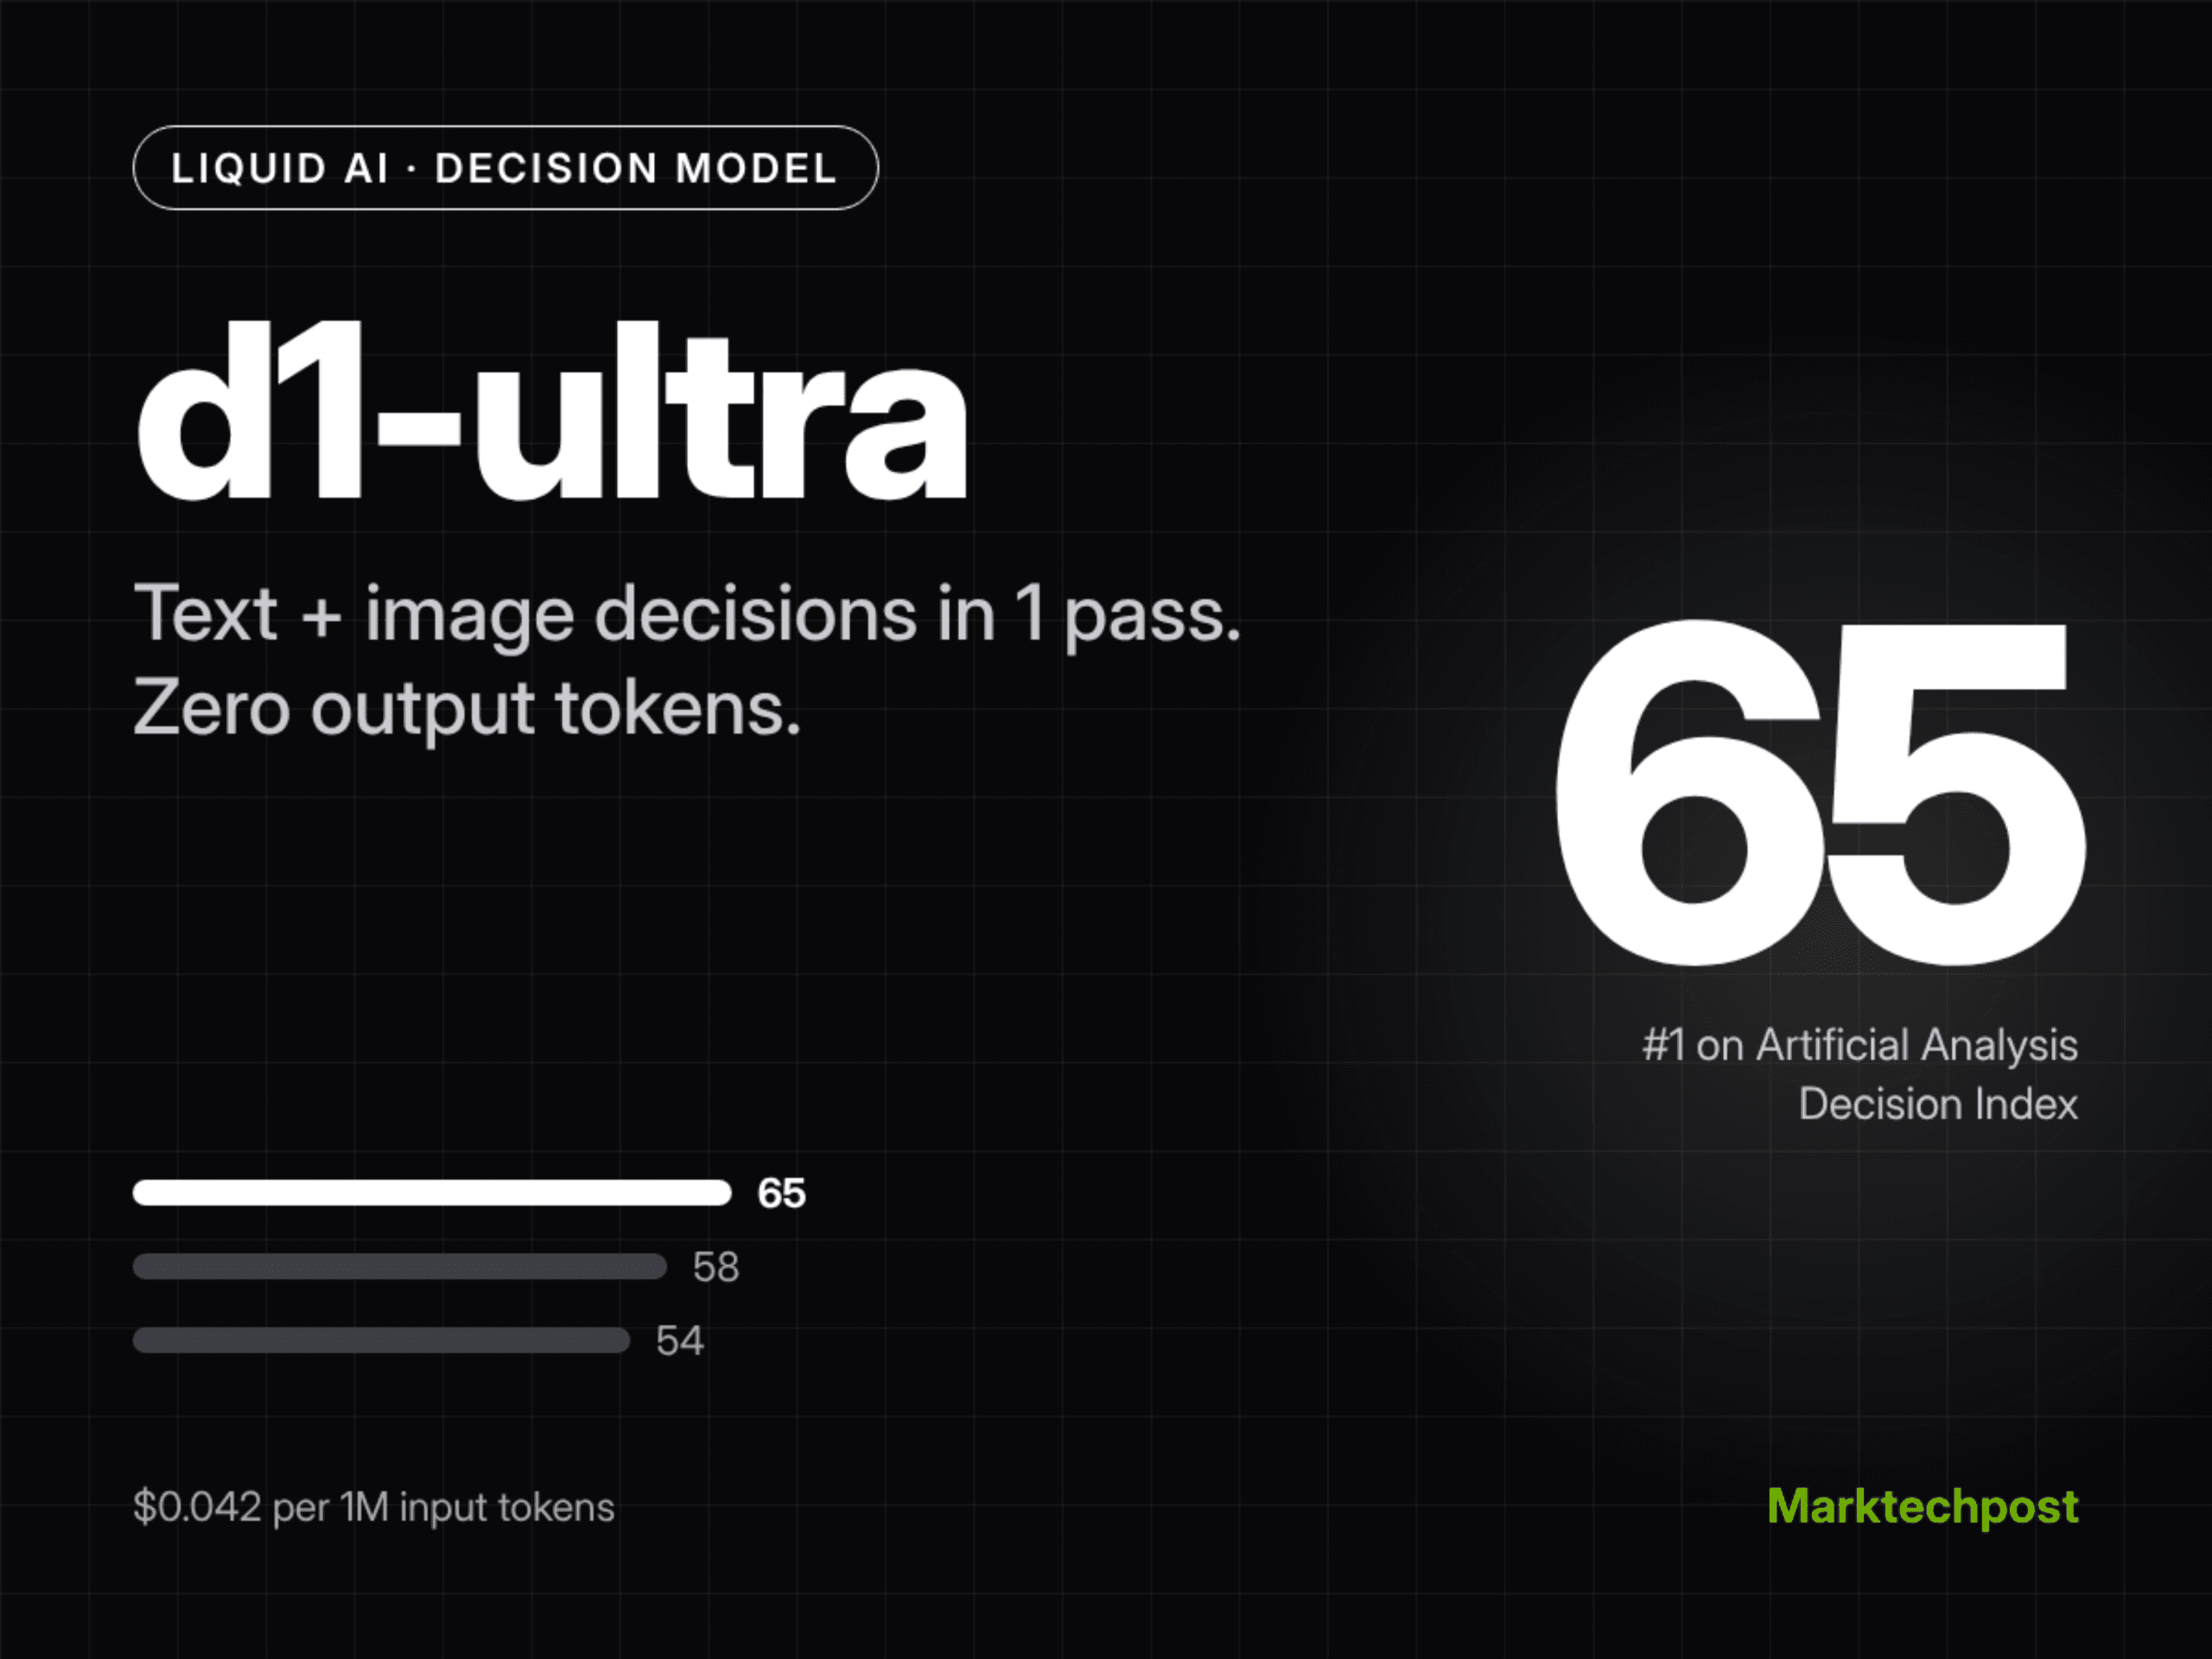
Liquid AI เปิดตัว d1-ultra โมเดลการตัดสินใจ (Decision Model) ที่ทรงพลังที่สุดเท่าที่เคยมีมา โดยมีความสามารถในการประมวลผลทั้งข้อความและรูปภาพ เพื่อตอบคำถามด้วยค่าความน่าจะเป็นของแต่ละคำตอบที่เป็นไปได้
จุดเด่นสำคัญของโมเดลนี้คือการทำงานแบบการประมวลผลรอบเดียว (one forward pass) และไม่มีการสร้าง output tokens เลย ช่วยให้นักพัฒนาสามารถใช้งานในด้านการจำแนกประเภท (classification), การจัดเส้นทาง (routing) และการให้คะแนน (scoring) ได้โดยไม่ต้องเสียค่าใช้จ่ายในส่วนของข้อความที่สร้างขึ้น ปัจจุบัน พร้อมใช้งานแล้วบน Liquid API ในราคา $0.042 ต่อล้าน input tokens
TL;DR
- ขนาด: ไม่เปิดเผยจำนวนพารามิเตอร์และ context length แต่สร้างขึ้นบน open-weight backbone ที่มีขนาดใหญ่กว่า d1
- รันบน: ใช้งานผ่าน Liquid API เท่านั้น ยังไม่มีการปล่อย weights หรือตัวแปรแบบ quantized ให้ดาวน์โหลด
- ประสิทธิภาพ: Liquid ระบุว่าครองอันดับหนึ่งในทั้ง 8 หมวดหมู่จากชุดการประเมิน 112 รายการ
- ดีที่สุด: ทำคะแนนได้ 65 บน Artificial Analysis Decision Index รั้งอันดับ 1 (ตามรายงานของ Liquid)
- แย่ที่สุด: ยังไม่มีการเปิดเผยรายละเอียดราย benchmark หรือจำนวนพารามิเตอร์ต่อสาธารณะอย่างชัดเจน ข้อมูลส่วนใหญ่เป็นรายงานจากผู้ผลิต
โมเดลการตัดสินใจคืออะไร?
โมเดลการตัดสินใจ (decision model) จะตอบคำถามที่มีขอบเขตชัดเจนด้วยค่าความน่าจะเป็น แทนที่จะเป็นการเจนข้อความแบบอิสระ โดยเอกสารของ Liquid ได้อธิบายประเภทคำถามไว้ 3 รูปแบบ:
- Noul: คำถามแบบ ใช่/ไม่ใช่ (yes/no) ที่ส่งคืนค่าความน่าจะเป็นระหว่าง 0 ถึง 1
- Choice: การเลือกป้ายกำกับจากชุดที่กำหนด พร้อมระบุค่าความน่าจะเป็นของแต่ละป้าย
- Score: การให้คะแนนตามเกณฑ์ที่เรียงลำดับไว้ (ordered rubric) โดยถ่วงน้ำหนักด้วยความน่าจะเป็น
Liquid แนะนำให้ใช้โมเดลนี้สำหรับงานจัดเส้นทาง (routing), ตรวจสอบเนื้อหา (moderation), วางเกณฑ์ป้องกัน (guardrails), คัดกรองงาน (triage) และใช้แทน LLM-as-judge ส่วนงานสรุปความ แชท หรือเขียนโค้ด ควรใช้โมเดลภาษา (LLM) แบบปกติจะเหมาะสมกว่า
d1-ultra ทำงานอย่างไร?
ในการส่งคำขอแต่ละครั้งจะประกอบด้วย state (บริบท), รูปภาพ (ถ้ามี) และ คำถาม ที่กำหนดประเภทไว้ 1 ข้อหรือมากกว่า โดยโมเดลจะประเมินทุกคำถามเทียบกับข้อมูลนำเข้าชุดเดียวกันในการเรียกใช้เพียงครั้งเดียว ซึ่ง เอกสารอ้างอิงของ d1 API ระบุชัดเจนว่า output_tokens จะมีค่าเป็น 0 เสมอ
ทีม Liquid AI เผยว่า d1-ultra พัฒนาต่อยอดจาก open-weight backbone ที่ใหญ่กว่า d1 ผสมผสานกับการปรับแต่งเฉพาะตัวของ Liquid อย่างเข้มข้น ส่งผลให้ประสิทธิภาพในงานด้านความรู้เพิ่มขึ้นอย่างก้าวกระโดด เหมาะสำหรับงานซับซ้อน เช่น การตรวจจุดบกพร่องบนแผงวงจรตามสเปก หรือการตรวจสอบความเสียหายจากรูปถ่ายเพื่อเคลมประกัน
ประสิทธิภาพของ d1-ultra บน benchmark เป็นอย่างไร?
จากการเปรียบเทียบกับโมเดล d1 รุ่นเดิม และ Jev 1.14 ของ TypeSafe ผ่านการประเมิน 112 รายการ พบว่า d1-ultra มีประสิทธิภาพเหนือกว่า Jev 1.14 ในทุกงานที่ระดับราคาเดียวกัน ตามข้อมูลใน การประกาศของ Liquid AI
นอกจากนี้ ในการทดสอบบน Artificial Analysis Decision Index โมเดล d1-ultra คว้าอันดับ 1 ด้วยคะแนน 65 ซึ่งเป็นคะแนนเฉลี่ยจากการประเมิน 4 ด้าน ได้แก่ ความรู้และการลดอาการหลอน (AA-Omniscience-Decision), การใช้เหตุผล (HLE-MultiChoice), การเรียกใช้เครื่องมือ (When2Call) และการจำแนกความปลอดภัย (WildGuardTest)
ทั้งนี้ ข้อมูลจาก Artificial Analysis เมื่อวันที่ 13 ตุลาคม ระบุว่าอันดับก่อนหน้านี้คือ Jev 1.13 ที่ 58 คะแนน ตามมาด้วย GLiDE และ Microsoft-Decision-1 ที่ 54 คะแนนเท่ากัน
การเปรียบเทียบ: d1-ultra เทียบกับโมเดลการตัดสินใจอื่นๆ
| คุณสมบัติ | d1-ultra | d1 | Jev (TypeSafe) | Microsoft-Decision-1 | GLiDE (Fastino) |
|---|---|---|---|---|---|
| ผู้พัฒนา | Liquid AI | Liquid AI | TypeSafe AI | Microsoft | Fastino Labs |
| พารามิเตอร์ | ไม่เปิดเผย | ไม่เปิดเผย | ไม่เปิดเผย | ไม่เปิดเผย | ไม่เปิดเผย |
| Input | ข้อความ, รูปภาพ | ข้อความ, รูปภาพ | ข้อความ | ไม่เปิดเผย | ไม่เปิดเผย |
| Weights | API เท่านั้น | API เท่านั้น | แบบปิด | ไม่เปิดเผย | ไม่เปิดเผย |
| AA Decision Index | 65 (รายงานโดย Liquid) | ไม่เปิดเผย | 58 (v1.13, 13 ต.ค.) | 54 (13 ต.ค.) | 54 (13 ต.ค.) |
| ราคา | $0.042 / 1M input | ไม่เปิดเผย | $0.042 / 1M input | $31 / 1M tasks (AA) | $119 / 1M tasks (AA) |
| คิดเงินค่า Output tokens | ไม่ | ไม่ | ไม่ | ไม่เปิดเผย | ไม่เปิดเผย |
วิธีการใช้งาน d1-ultra และราคาเท่าไหร่?
d1-ultra เปิดให้ใช้งานผ่าน Liquid API ที่ endpoint /decisions/v1/systemone โดยระบุโมเดลเป็น "model": "d1-ultra" และเร็วๆ นี้จะรองรับผ่าน Vercel AI Gateway และ OpenRouter นอกจากนี้ยังสามารถทดลองใช้ได้ที่ d1 Playground
การคิดค่าบริการจะนับเฉพาะ input tokens เท่านั้น โดยรูปภาพมีราคา 1.5 tokens ต่อ patch ขนาด 32×32 พิกเซล (เช่น รูป 1024×1024 จะใช้ 1,536 tokens) อย่างไรก็ตาม แต่ละคำถามจะถูกคิดเงินเหมือนเป็น prompt ใหม่เสมอ หากส่ง 3 คำถามใน 1 รูปภาพ จะมีการคิดเงินค่ารูปภาพนั้น 3 ครั้ง
ตาม เอกสารประกอบ ระบุข้อจำกัดต่อหนึ่งคำขอไว้ที่ 8 รูปภาพ และ 10,000 image patches โดยขนาด JSON body รวมต้องไม่เกิน 4.5 MB
ประเด็นสำคัญ
- d1-ultra ให้ค่าความแม่นยำในการตัดสินใจจากข้อความและรูปภาพโดยไม่มีค่า output tokens
- ทำคะแนนสูงสุดอันดับ 1 (65 คะแนน) บน Artificial Analysis Decision Index ตามรายงานของ Liquid
- ราคาคุ้มค่าเพียง $0.042 ต่อ 1 ล้าน input tokens เทียบเท่ากับคู่แข่งอย่าง Jev ของ TypeSafe
- Liquid เคลมว่ามีค่าความคลาดเคลื่อนในการปรับเทียบ (calibration error) ต่ำที่สุด ซึ่งสำคัญมากสำหรับการตั้งเกณฑ์จัดเส้นทางข้อมูล (routing thresholds)
- ปัจจุบันยังเข้าถึงได้เฉพาะทาง API เท่านั้น โดยยังไม่มีการเปิดเผยขนาดโมเดลหรือโครงสร้าง backbone อย่างละเอียด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร