เจาะลึก Google Gemini Omni: สรุปความสามารถ ราคา และข้อดีเหนือคู่แข่งtag: Gemini Omni, Generative AI, Google, Google DeepMind, Video GenerationOct 27, 2026 · By: SirilukPสรุปข่าว 1:22ทำความรู้จัก Gemini Omni โมเดล AI สายวิดีโอตัวใหม่จาก Google ที่เน้นจุดเด่นเรื่องการแก้ไขผ่านการสนทนาที่ต่อเนื่อง (Conversational editing) โดยยังคงรักษาความสอดคล้องของตัวละครและฟิสิกส์ในฉากไว้ได้แม่นยำ
Kling AI 4.0 เปิดตัว! รองรับวิดีโอ 30 วินาทีพร้อมระบบเสียงสเตอริโอtag: AI Flash Model, AI Video, Kling AI, Omni Reference, Video GenerationOct 20, 2026 · By: SirilukPสรุปข่าว 1:19Kling AI อัปเกรดเวอร์ชัน 4.0 เพิ่มความสามารถในการสร้างวิดีโอยาว 30 วินาที รองรับ Keyframe สูงสุด 10 ภาพ และระบบลิปซิงค์หลายภาษา พร้อมเปิดตัวรุ่น Flash เพื่อการประมวลผลที่รวดเร็วขึ้นในราคาประหยัด
สร้างระบบ Video และ Audio Multimodal ด้วย MiniMax-H3 ผ่าน ComfyUI APItag: ComfyUI, MiniMax H3, Multimodal AI, Python, Video GenerationAug 12, 2026 · By: TanasakPคู่มือการสร้างระบบผลิตสื่อมัลติโมดัลด้วย MiniMax-H3 โดยใช้ ComfyUI เป็นระบบหลังบ้านแบบ Headless เพื่อควบคุมการทำงานอัตโนมัติ ตั้งแต่การตรวจสอบฮาร์ดแวร์จนถึงการถอดรหัสวิดีโอและเสียง
MiniMax เปิดตัว MiniMax H3 โมเดล Omni-Modal เจนวิดีโอ 2K พร้อมเสียงสเตอริโอในตัวtag: Hailuo AI, MiniMax, MiniMax H3, Multimodal AI, Video GenerationAug 2, 2026 · By: AttapolKMiniMax เปิดตัวโมเดล AI ใหม่ MiniMax H3 ที่สามารถประมวลผลข้อความ ภาพ วิดีโอ และเสียงได้ในบริบทเดียวกัน เพื่อสร้างวิดีโอความละเอียด 2K ความยาวสูงสุด 15 วินาทีพร้อมเสียงสเตอริโอคุณภาพสูง
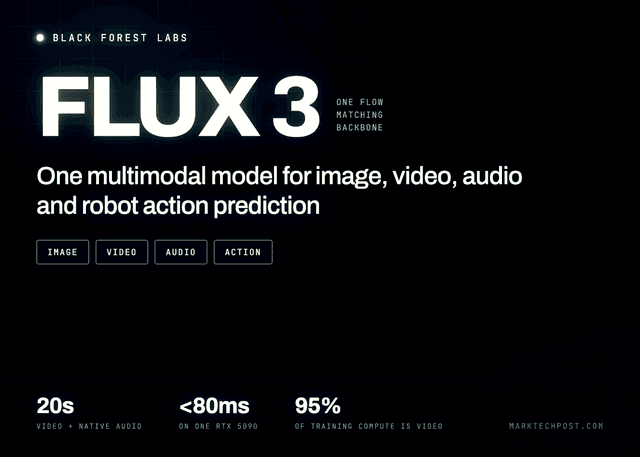
Black Forest Labs เปิดตัว FLUX 3 โมเดล Multimodal ล้ำสมัย รองรับทั้งภาพ วิดีโอ เสียง และหุ่นยนต์ในตัวเดียวtag: Black Forest Labs, FLUX 3, Multimodal AI, Self-Flow, Video GenerationJul 28, 2026 · By: SirilukPBlack Forest Labs เปิดตัว FLUX 3 โมเดลพื้นฐานแบบ Multimodal รุ่นแรกที่สามารถทำนายวิดีโอ เสียง และการเคลื่อนไหวของหุ่นยนต์ได้จากชุดน้ำหนักเพียงชุดเดียว โดยใช้สถาปัตยกรรม Self-Flow เพื่อความสมจริงระดับสูงสุด
Google DeepMind ชี้โมเดลสร้างวิดีโออาจมี World Model ในตัว หลัง GenCeption ทำผลงานด้าน Computer Vision ได้ยอดเยี่ยมtag: Computer Vision, GenCeption, Google DeepMind, Video Generation, World ModelJul 20, 2026 · By: AttapolKGoogle DeepMind นำเสนอ GenCeption ซึ่งพบว่าโมเดลสร้างวิดีโอสามารถทำงานด้าน Computer Vision ได้อย่างยอดเยี่ยมโดยใช้ข้อมูลฝึกสอนน้อยกว่าเดิมมาก ผลลัพธ์นี้ช่วยสนับสนุนสมมติฐานที่ว่าโมเดลสร้างวิดีโออาจมีแบบจำลองความเข้าใจโลกทางกายภาพแฝงอยู่ภายใน