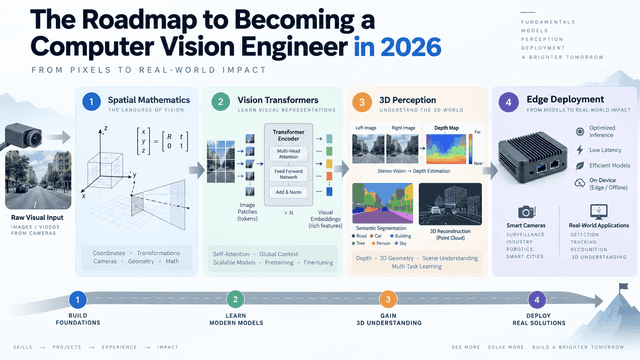
เปิดโรดแมปวิศวกร Computer Vision ปี 2026 สู่ความเชี่ยวชาญtag: Computer Vision, Edge AI, PyTorch, Spatial Computing, TensorRT, Vision TransformersOct 26, 2026 · By: SirilukPสรุปข่าว 1:32เจาะลึก 4 ขั้นตอนการเป็นวิศวกร Computer Vision ยุคใหม่ ตั้งแต่คณิตศาสตร์เชิงพื้นที่ไปจนถึงการปรับแต่งโมเดลบนฮาร์ดแวร์ Edge เพื่อตอบโจทย์อุตสาหกรรมในอนาคต
FLUX.3 Image Klein เปิดตัวสู่ Diffusers รองรับการควบคุมเลย์เอาต์tag: Black Forest Labs, Computer Vision, Diffusers, FLUX.3 Image Klein, Hugging Face, LoRAOct 15, 2026 · By: TanasakPสรุปข่าว 1:17Black Forest Labs เปิดตัว FLUX.3 Image Klein โมเดลสร้างภาพตัวล่าสุดที่รองรับทั้ง text-to-image และการแก้ไขภาพด้วย layout control ผ่าน bounding box ใช้งานได้ทันทีบน Diffusers
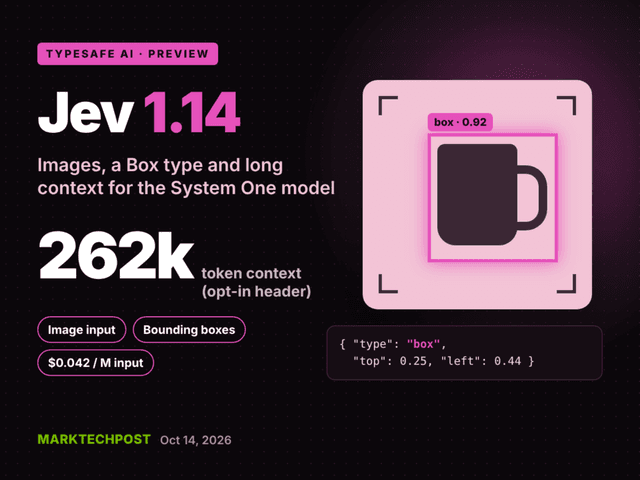
TypeSafe AI เปิดตัว Jev 1.14 รองรับรูปภาพและ Context 262ktag: Computer Vision, Jev 1.14, LLM, System One, TypeSafe AIOct 15, 2026 · By: TanasakPสรุปข่าว 1:24TypeSafe AI ปล่อยโมเดล Jev 1.14 ภายใต้นามแฝง jev-preview เพิ่มฟีเจอร์ทดลองรองรับอินพุตภาพ ประเภทข้อมูล Box สำหรับระบุตำแหน่ง และขยาย Context ได้สูงสุด 262k โทเค็น
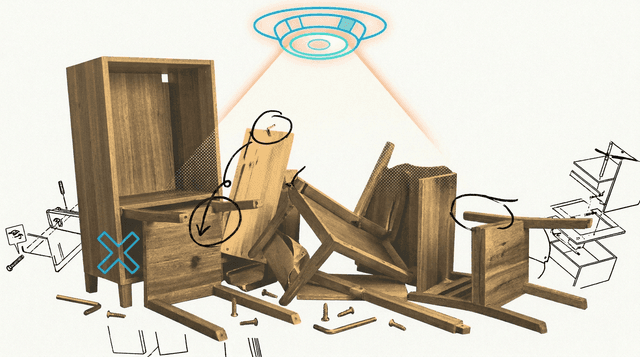
GPT-6 Astra จาก OpenAI โชว์เหนือ ระบุจุดประกอบเฟอร์นิเจอร์ IKEA ผิดได้แม่นยำ 80%tag: Computer Vision, Epoch AI, GPT-6 Astra, IKEA, OpenAISep 26, 2026 · By: AttapolKสรุปข่าว 1:22GPT-6 Astra ของ OpenAI พัฒนาการมองเห็นจนสามารถระบุจุดที่ประกอบเฟอร์นิเจอร์ IKEA ผิดพลาดได้แม่นยำสูงถึง 80 เปอร์เซ็นต์ ก้าวกระโดดจากระดับ 28 เปอร์เซ็นต์เมื่อช่วงปลายปี 2025
Alibaba เปิดตัว Qwen-Image-2.1 ท้าชนโมเดลปิดด้วยขนาดเพียง 7Btag: Alibaba, Computer Vision, Generative AI, Open-weight, Qwen-Image-2.1Sep 21, 2026 · By: SirilukPสรุปข่าว 1:25ทีม Qwen จาก Alibaba เปิดตัวโมเดล open-weight รุ่นใหม่ Qwen-Image-2.1 ที่รองรับการสร้างและแก้ไขภาพแบบโปร่งใส รวมถึงใช้ภาพอ้างอิงได้สูงสุด 10 ภาพ โดยสามารถรันบน GPU ระดับผู้บริโภคได้
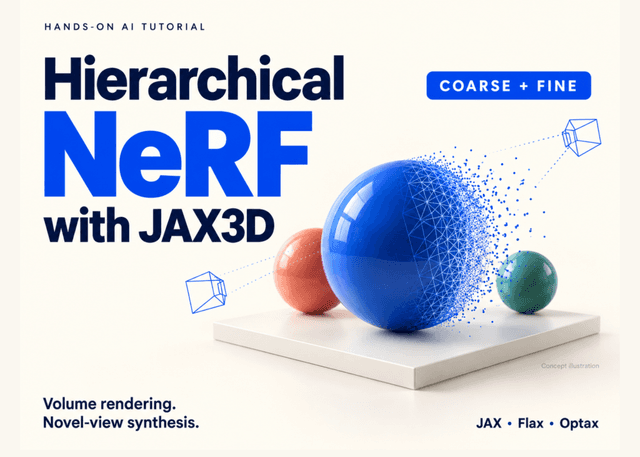
สร้าง Hierarchical NeRF ด้วย JAX3D: เจาะลึกกระบวนการ Volumetric Rendering และการจำลองภาพ 3Dtag: Computer Vision, Flax, JAX, JAX3D, NeRF, Volumetric RenderingSep 14, 2026 · By: NatapolKคู่มือการสร้าง Neural Radiance Field (NeRF) แบบลำดับชั้นตั้งแต่เริ่มต้นด้วย JAX และ Flax โดยใช้ฟังก์ชัน jax3d เพื่อจัดการกระบวนการสร้างโครงสร้าง 3D และการเรนเดอร์ภาพจากมุมมองใหม่ได้อย่างแม่นยำ
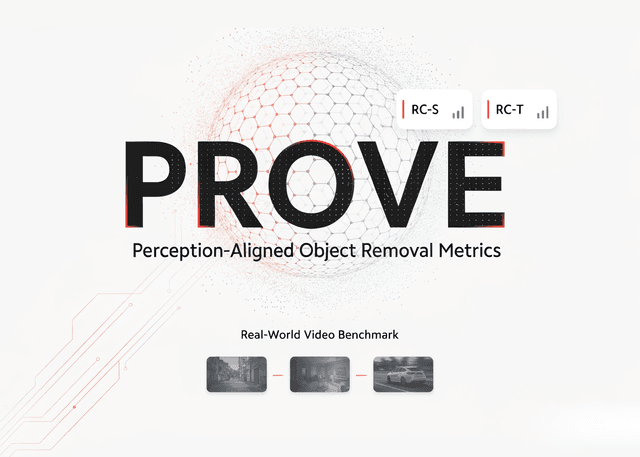
Xiaomi เปิดตัว PROVE: เกณฑ์มาตรฐานใหม่สำหรับประเมินการลบวัตถุในวิดีโอด้วย AItag: Benchmark, Computer Vision, DINOv2, Object Removal, PROVE, XiaomiAug 13, 2026 · By: TanasakPMiLM Plus จาก Xiaomi เปิดตัว PROVE เกณฑ์วัดประสิทธิภาพการลบวัตถุด้วย AI ที่เน้นความสอดคล้องทางสายตาโดยไม่ต้องใช้ภาพต้นฉบับอ้างอิง เพื่อแก้ปัญหาเกณฑ์วัดเดิมที่มักให้คะแนนผิดพลาด
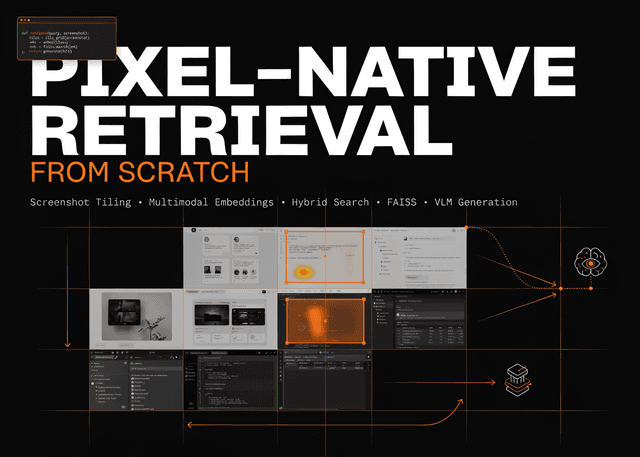
Pixel-Native RAG: คู่มือสร้างระบบ Indexing เอกสารเชิงภาพแบบครบวงจรtag: AI News, Computer Vision, Indexing, PixelRAG, RAGAug 6, 2026 · By: NatapolKเรียนรู้การสร้างระบบ PixelRAG ที่จัดการเอกสาร PDF และหน้าเว็บในรูปแบบรูปภาพโดยไม่ต้องสกัดข้อความ ช่วยเพิ่มประสิทธิภาพการกู้คืนข้อมูลเชิงภาพด้วย Multimodal Embedding และ Hybrid Search
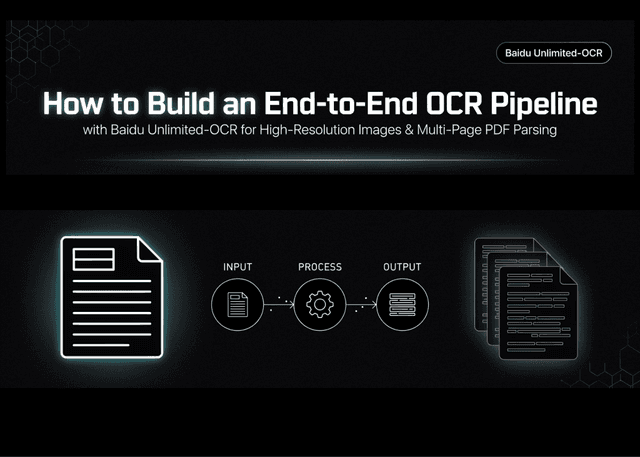
สร้างเวิร์กโฟลว์ End-to-End OCR ด้วย Unlimited-OCR จาก Baidu รองรับ PDF หลายหน้าและความละเอียดสูงtag: Baidu, Computer Vision, OCR, PDF Parsing, Unlimited-OCRJul 25, 2026 · By: TanasakPคู่มือการสร้างระบบ OCR ครบวงจรด้วยโมเดล Unlimited-OCR ของ Baidu ที่รองรับทั้งการประมวลผลรูปภาพความละเอียดสูงผ่านโหมด Gundam และการทำงานกับ PDF หลายหน้าที่ซับซ้อนอย่างมีประสิทธิภาพ
Google DeepMind ชี้โมเดลสร้างวิดีโออาจมี World Model ในตัว หลัง GenCeption ทำผลงานด้าน Computer Vision ได้ยอดเยี่ยมtag: Computer Vision, GenCeption, Google DeepMind, Video Generation, World ModelJul 20, 2026 · By: AttapolKGoogle DeepMind นำเสนอ GenCeption ซึ่งพบว่าโมเดลสร้างวิดีโอสามารถทำงานด้าน Computer Vision ได้อย่างยอดเยี่ยมโดยใช้ข้อมูลฝึกสอนน้อยกว่าเดิมมาก ผลลัพธ์นี้ช่วยสนับสนุนสมมติฐานที่ว่าโมเดลสร้างวิดีโออาจมีแบบจำลองความเข้าใจโลกทางกายภาพแฝงอยู่ภายใน
สร้างระบบสรุปวิดีโอแบบ Local ด้วย SmolVLM2-2.2B: ประมวลผลบนเครื่องส่วนตัวได้อย่างมีประสิทธิภาพtag: Computer Vision, Hugging Face, SmolVLM2, Transformers, Video SummarizationJul 17, 2026 · By: SirilukPSmolVLM2-2.2B คือโมเดลที่ลงตัวทั้งด้านขนาดและความสามารถ โดยมีขนาดเล็กพอที่จะรันบน GPU ระดับผู้บริโภคทั่วไปเพียงตัวเดียว แต่ทรงพลังพอที่จะสรุปเนื้อหาวิดีโอและใช้งานในเวิร์กโฟลว์จริงได้อย่างดีเยี่ยม
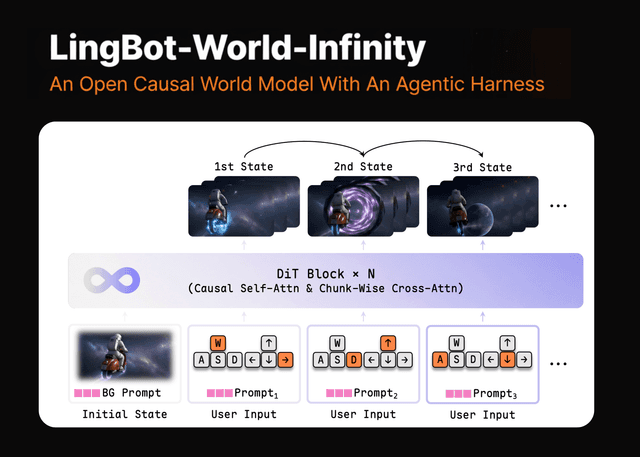
Ant Group เปิดตัว LingBot-World-Infinity: โมเดลโลกแบบ Causal 14B จำลองวิดีโอ 60 นาทีแบบเรียลไทม์tag: Ant Group, Computer Vision, LingBot-World-Infinity, Robbyant, World ModelJul 17, 2026 · By: TanasakPRobbyant หน่วยงานด้านสมองกลอัจฉริยะของ Ant Group เปิดตัว LingBot-World 2.0 เครื่องจำลองโลกเสมือนที่โต้ตอบได้แบบไร้รอยต่อ โดยใช้กลไก MoBA และ DMD เพื่อแก้ปัญหาภาพบิดเบี้ยวในการสร้างวิดีโอระยะยาว