
เปิดโรดแมปวิศวกร Computer Vision ปี 2026 สู่ความเชี่ยวชาญ
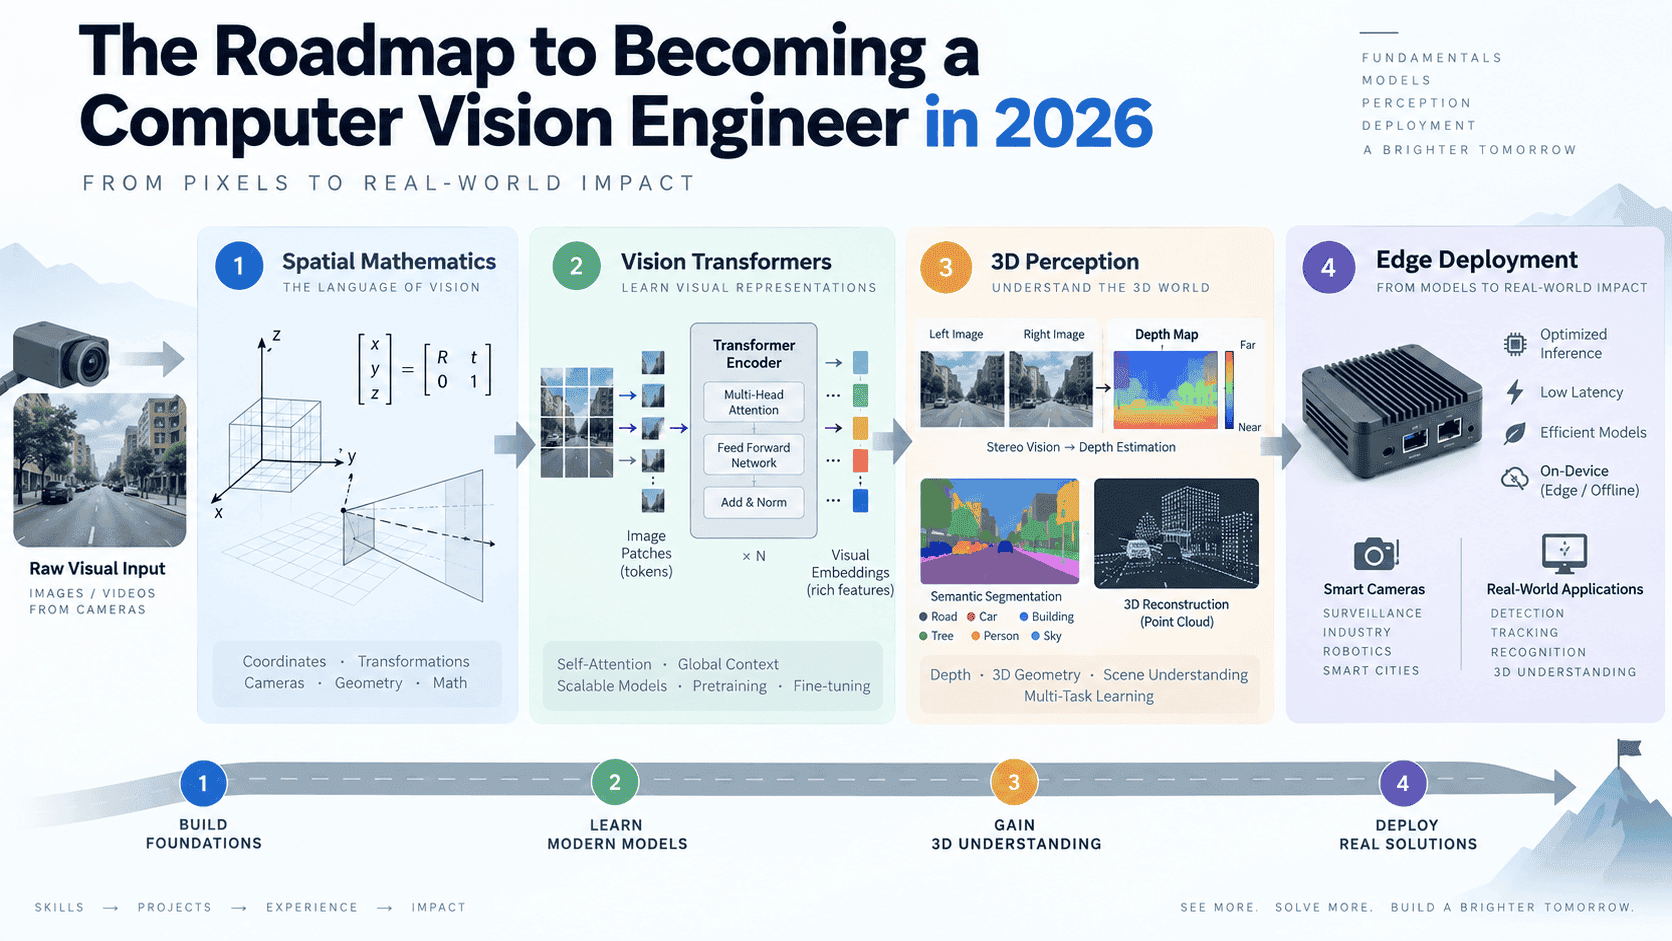
ในปี 2026 เทคโนโลยี Computer vision (CV) ได้ก้าวข้ามขีดจำกัดเดิมๆ อย่างการตรวจจับและจำแนกภาพไปสู่จุดตัดของ foundation models, spatial computing และฮาร์ดแวร์แบบฝังตัว (embedded hardware) เพื่อสร้างระบบที่สามารถรับรู้และตอบสนองต่อโลกจริงได้แบบเรียลไทม์
ความต้องการวิศวกรแบบ full stack ในสายงานนี้กำลังพุ่งสูงขึ้น ไม่ว่าจะเป็นในอุตสาหกรรมยานยนต์ไร้คนขับ หุ่นยนต์คลังสินค้า หรืออุปกรณ์ทางการแพทย์ ซึ่งต้องการผู้เชี่ยวชาญที่เข้าใจระบบตั้งแต่ต้นน้ำอย่างเซ็นเซอร์ ไปจนถึงปลายน้ำอย่าง production inference
โรดแมปนี้จะแบ่งออกเป็น 4 ขั้นตอนสำคัญ เริ่มต้นจากพื้นฐานคณิตศาสตร์เชิงพื้นที่ไปจนถึงการปรับแต่งโมเดลให้ทำงานร่วมกับฮาร์ดแวร์ (hardware-aware optimization) อย่างมีประสิทธิภาพ
Step 1: Spatial Mathematics และ Foundation Vision Primitives
ระบบ CV ทุกระบบมีรากฐานมาจากการให้เหตุผลทางเรขาคณิต ก่อนจะเริ่มทำงานกับโมเดลสมัยใหม่ คุณต้องแม่นยำในเรื่องการนำคณิตศาสตร์มาประยุกต์ใช้เพื่อสร้างการมองเห็นที่สมบูรณ์
หัวใจสำคัญในขั้นนี้ประกอบด้วยการแปลงเมทริกซ์ (matrix transformations), เฟรมพิกัด (coordinate frames) และ projective geometry ซึ่งเป็นตัวกำหนดว่ากล้องจะจำลองโลก 3D ลงบนเซ็นเซอร์ 2D ได้อย่างไร รวมถึงวิธีที่ชุดกล้องหลายตัว (multi-camera rig) ทำงานสอดประสานกันเพื่อสร้างมิติความลึก
สำหรับการลงมือทำจริง ควรเริ่มสร้างความเชี่ยวชาญด้วย PyTorch ซึ่งเป็นมาตรฐานหลักในการจัดการ tensor ควบคู่ไปกับการใช้ Albumentations สำหรับการทำ synthetic data augmentation เพื่อจำลองสภาพแสงและการบดบัง (occlusion) ที่หลากหลายโดยไม่ต้องเก็บข้อมูลใหม่
อีกหนึ่งเสาหลักคือ Feature representation โดยต้องทำความเข้าใจความแตกต่างระหว่าง convolutional backbones และ attention-based backbones รวมถึงเทคนิค Contrastive representation learning ที่ช่วยให้โมเดลเรียนรู้การฝังข้อมูล (embedding) ที่มีประสิทธิภาพก่อนจะนำไปทำ downstream fine-tuning ต่อไป
แหล่งข้อมูลแนะนำ: หนังสือ Multiple View Geometry in Computer Vision โดย Hartley และ Zisserman; บทเรียน Stanford CS231n และเอกสารประกอบของ PyTorch
แบบฝึกหัดพอร์ตโฟลิโอ: พัฒนา pipeline การประมาณความลึกแบบสเตอริโอ (stereo depth estimation) จากภาพที่ผ่านการ Calibrate แล้ว และวิเคราะห์จุดที่การประมาณค่าเกิดความผิดพลาด
Step 2: Vision Transformers และ Multimodal Foundation Models
การเปลี่ยนผ่านจาก CNNs ไปสู่โครงสร้างแบบ transformer-based ได้เปลี่ยนนิยามความรู้ของวิศวกร CV โดย Vision Transformers (ViTs) จะประมวลผลภาพเป็น patch และใช้ self-attention แทนการใช้ local filters แบบเดิม ขณะที่ Swin Transformers ช่วยให้การประมวลผลภาพความละเอียดสูงทำได้จริงในทางปฏิบัติ
เทรนด์ที่สำคัญกว่าคือการเกิดขึ้นของ vision-language models (VLMs) เช่น CLIP ที่เรียนรู้ร่วมกันระหว่างภาพและข้อความ ทำให้เกิดความเข้าใจแบบ open-vocabulary ช่วยให้เราค้นหาสิ่งต่างๆ ในภาพด้วยภาษาธรรมชาติแทนการระบุคลาสที่ตายตัว
เทคนิคนี้ต่อยอดไปสู่ open-vocabulary detection ผ่านโมเดลอย่าง OWL-ViT และ Grounding DINO ที่สามารถระบุตำแหน่งวัตถุตามคำสั่งข้อความได้โดยไม่ต้องฝึกโมเดลใหม่ นอกจากนี้ยังมี SAM 2 จาก Meta ที่ช่วยในการแบ่งส่วนภาพ (segmentation) แบบ zero-shot ได้อย่างแม่นยำทั้งภาพนิ่งและวิดีโอ
การเข้าใจกลไกและข้อจำกัดของ foundation models เหล่านี้ รวมถึงวิธีนำไปประกอบใน pipeline คือทักษะสำคัญที่ขาดไม่ได้
import torch
from PIL import Image
import requests
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection

model_id = "IDEA-Research/grounding-dino-tiny"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id)

image = Image.open("scene.jpg")
text_prompt = "a red forklift. a safety helmet."

inputs = processor(images=image, text=text_prompt, return_tensors="pt")
outputs = model(**inputs)
นี่คือตัวอย่างการรัน open-vocabulary detection เพื่อตรวจจับวัตถุตามคำสั่งข้อความโดยไม่ต้องผ่านการฝึกเฉพาะงาน
แหล่งข้อมูลแนะนำ: บทความวิจัย ViT ฉบับดั้งเดิม; เอกสารประกอบ Hugging Face และ repository SAM 2 ของ Meta AI
แบบฝึกหัดพอร์ตโฟลิโอ: สร้างเดโม zero-shot object detection ด้วย Grounding DINO และทดสอบประสิทธิภาพในโดเมนที่หลากหลายเพื่อหาจุดบกพร่องของระบบ
Step 3: 3D Vision, Neural Rendering และ Spatial Perception
เมื่อระบบ CV เริ่มให้เหตุผลเชิงพื้นที่ ทักษะการจัดการข้อมูล 3D จึงจำเป็นอย่างยิ่ง ไม่ว่าจะเป็นการใช้ point clouds, voxel grids หรือ signed distance fields (SDFs) ซึ่งแต่ละแบบมีจุดเด่นในการประมวลผลและใช้หน่วยความจำต่างกัน
ปัจจุบันการประมาณความลึก (Depth estimation) สามารถทำได้จากภาพเพียงภาพเดียวด้วยโมเดลอย่าง Depth Anything (v2) ขณะที่เทคโนโลยี Neural rendering อย่าง 3D Gaussian Splatting ก็เข้ามาแทนที่ NeRFs ในการสร้างมุมมองใหม่ของฉากได้แบบเรียลไทม์บนฮาร์ดแวร์ทั่วไป
สำหรับงานด้านหุ่นยนต์ การเข้าใจเรื่อง Spatial perception ผ่านเทคนิค Visual Odometry (VO) และ SLAM คือสิ่งสำคัญที่จะช่วยให้ระบบสามารถระบุตำแหน่งตัวเองและสร้างแผนที่สภาพแวดล้อมได้จากกล้องเพียงตัวเดียว
import numpy as np
import open3d as o3d

# Load point cloud from depth map and camera intrinsics
depth = np.load("depth_map.npy")
fx, fy, cx, cy = 525.0, 525.0, 319.5, 239.5

h, w = depth.shape
u, v = np.meshgrid(np.arange(w), np.arange(h))
z = depth
x = (u - cx) * z / fx
y = (v - cy) * z / fy

points = np.stack([x, y, z], axis=-1).reshape(-1, 3)
pcd = o3d.geometry.PointCloud()
pcd.points = o3d.utility.Vector3dVector(points)
o3d.io.write_point_cloud("output.ply", pcd)
ตัวอย่างโค้ดด้านบนแสดงการสร้าง 3D point cloud จากแผนที่ความลึก ซึ่งเป็นพื้นฐานสำคัญของหุ่นยนต์และเทคโนโลยี AR
แหล่งข้อมูลแนะนำ: เอกสารประกอบ Open3D; บทความวิจัย 3D Gaussian Splatting และไลบรารี nerfstudio
แบบฝึกหัดพอร์ตโฟลิโอ: ใช้ Depth Anything สร้างแผนที่ความลึกจากวิดีโอแล้วแปลงเป็น point cloud เพื่อจำลองภาพ 3D
Step 4: Inference Optimization และ Edge Deployment
ขั้นตอนสุดท้ายคือการนำโมเดลไปใช้งานจริง (production) บนฮาร์ดแวร์ที่มีข้อจำกัด การทำให้ระบบมีความหน่วงต่ำ (low latency) โดยไม่เสียความแม่นยำคือศาสตร์ที่มีมูลค่าสูงมากในปัจจุบัน
เทคนิคหลักในการบีบอัดโมเดล ได้แก่ การทำ Post-training quantization เพื่อลดความละเอียดของน้ำหนักโมเดล, การทำ Pruning เพื่อตัดส่วนที่ไม่จำเป็นออก และการทำ Knowledge distillation เพื่อสร้างโมเดลขนาดเล็กที่มีประสิทธิภาพใกล้เคียงโมเดลใหญ่
นอกจากนี้ต้องมีความเข้าใจในเฟรมเวิร์กอย่าง TensorRT และ ONNX Runtime สำหรับ GPU/CPU หรือ OpenVINO ของ Intel รวมถึงการจัดการ pipeline วิดีโอผ่าน NVIDIA DeepStream เพื่อให้ได้อัตราเฟรมที่ 30+ FPS ภายใต้ภาระงานหนัก
import tensorrt as trt
import numpy as np

logger = trt.Logger(trt.Logger.WARNING)
with open("model.trt", "rb") as f, trt.Runtime(logger) as runtime:
    engine = runtime.deserialize_cuda_engine(f.read())

context = engine.create_execution_context()
# Allocate buffers and run inference
input_shape = context.get_tensor_shape("input")
print(f"Engine input shape: {input_shape}")
การใช้ TensorRT engine คือมาตรฐานในการนำโมเดล vision ไปใช้งานจริงบนฮาร์ดแวร์ NVIDIA
แหล่งข้อมูลแนะนำ: คู่มือ TensorRT และ ONNX Runtime; แหล่งข้อมูลจาก Hailo และ NVIDIA Jetson
แบบฝึกหัดพอร์ตโฟลิโอ: นำโมเดล YOLOv8 ไปทำ quantization ด้วย TensorRT แล้วเปรียบเทียบความเร็วและความแม่นยำระหว่างเวอร์ชัน FP32 และ INT8
แหล่งเรียนรู้ที่แนะนำ
- หนังสือ: Multiple View Geometry in Computer Vision และ Programming Computer Vision with Python
- คอร์สเรียน: Stanford CS231n และ fast.ai
- เครื่องมือ: PyTorch, Hugging Face, Open3D, TensorRT
- ชุมชน: Papers With Code และ PyImageSearch
ข้อคิดส่งท้าย
การเป็นวิศวกร Computer Vision ในปี 2026 ต้องมีความรู้ที่ครอบคลุม ตั้งแต่คณิตศาสตร์พื้นฐาน เรขาคณิตของกล้อง ไปจนถึงโครงสร้างโมเดลซับซ้อนอย่าง ViT และการปรับแต่งบนฮาร์ดแวร์ Edge
ความสามารถรอบด้านนี้ต้องใช้เวลาในการฝึกฝน การทำโปรเจกต์จริงในแต่ละขั้นตอนจะช่วยปิดช่องว่างทักษะและสร้างเส้นทางอาชีพที่มั่นคงในโลกเทคโนโลยีอนาคต
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร