
Tsinghua เปิดตัว AKV ระบบจัดการ KV Cache ลดต้นทุน AI Agent เกือบ 28%
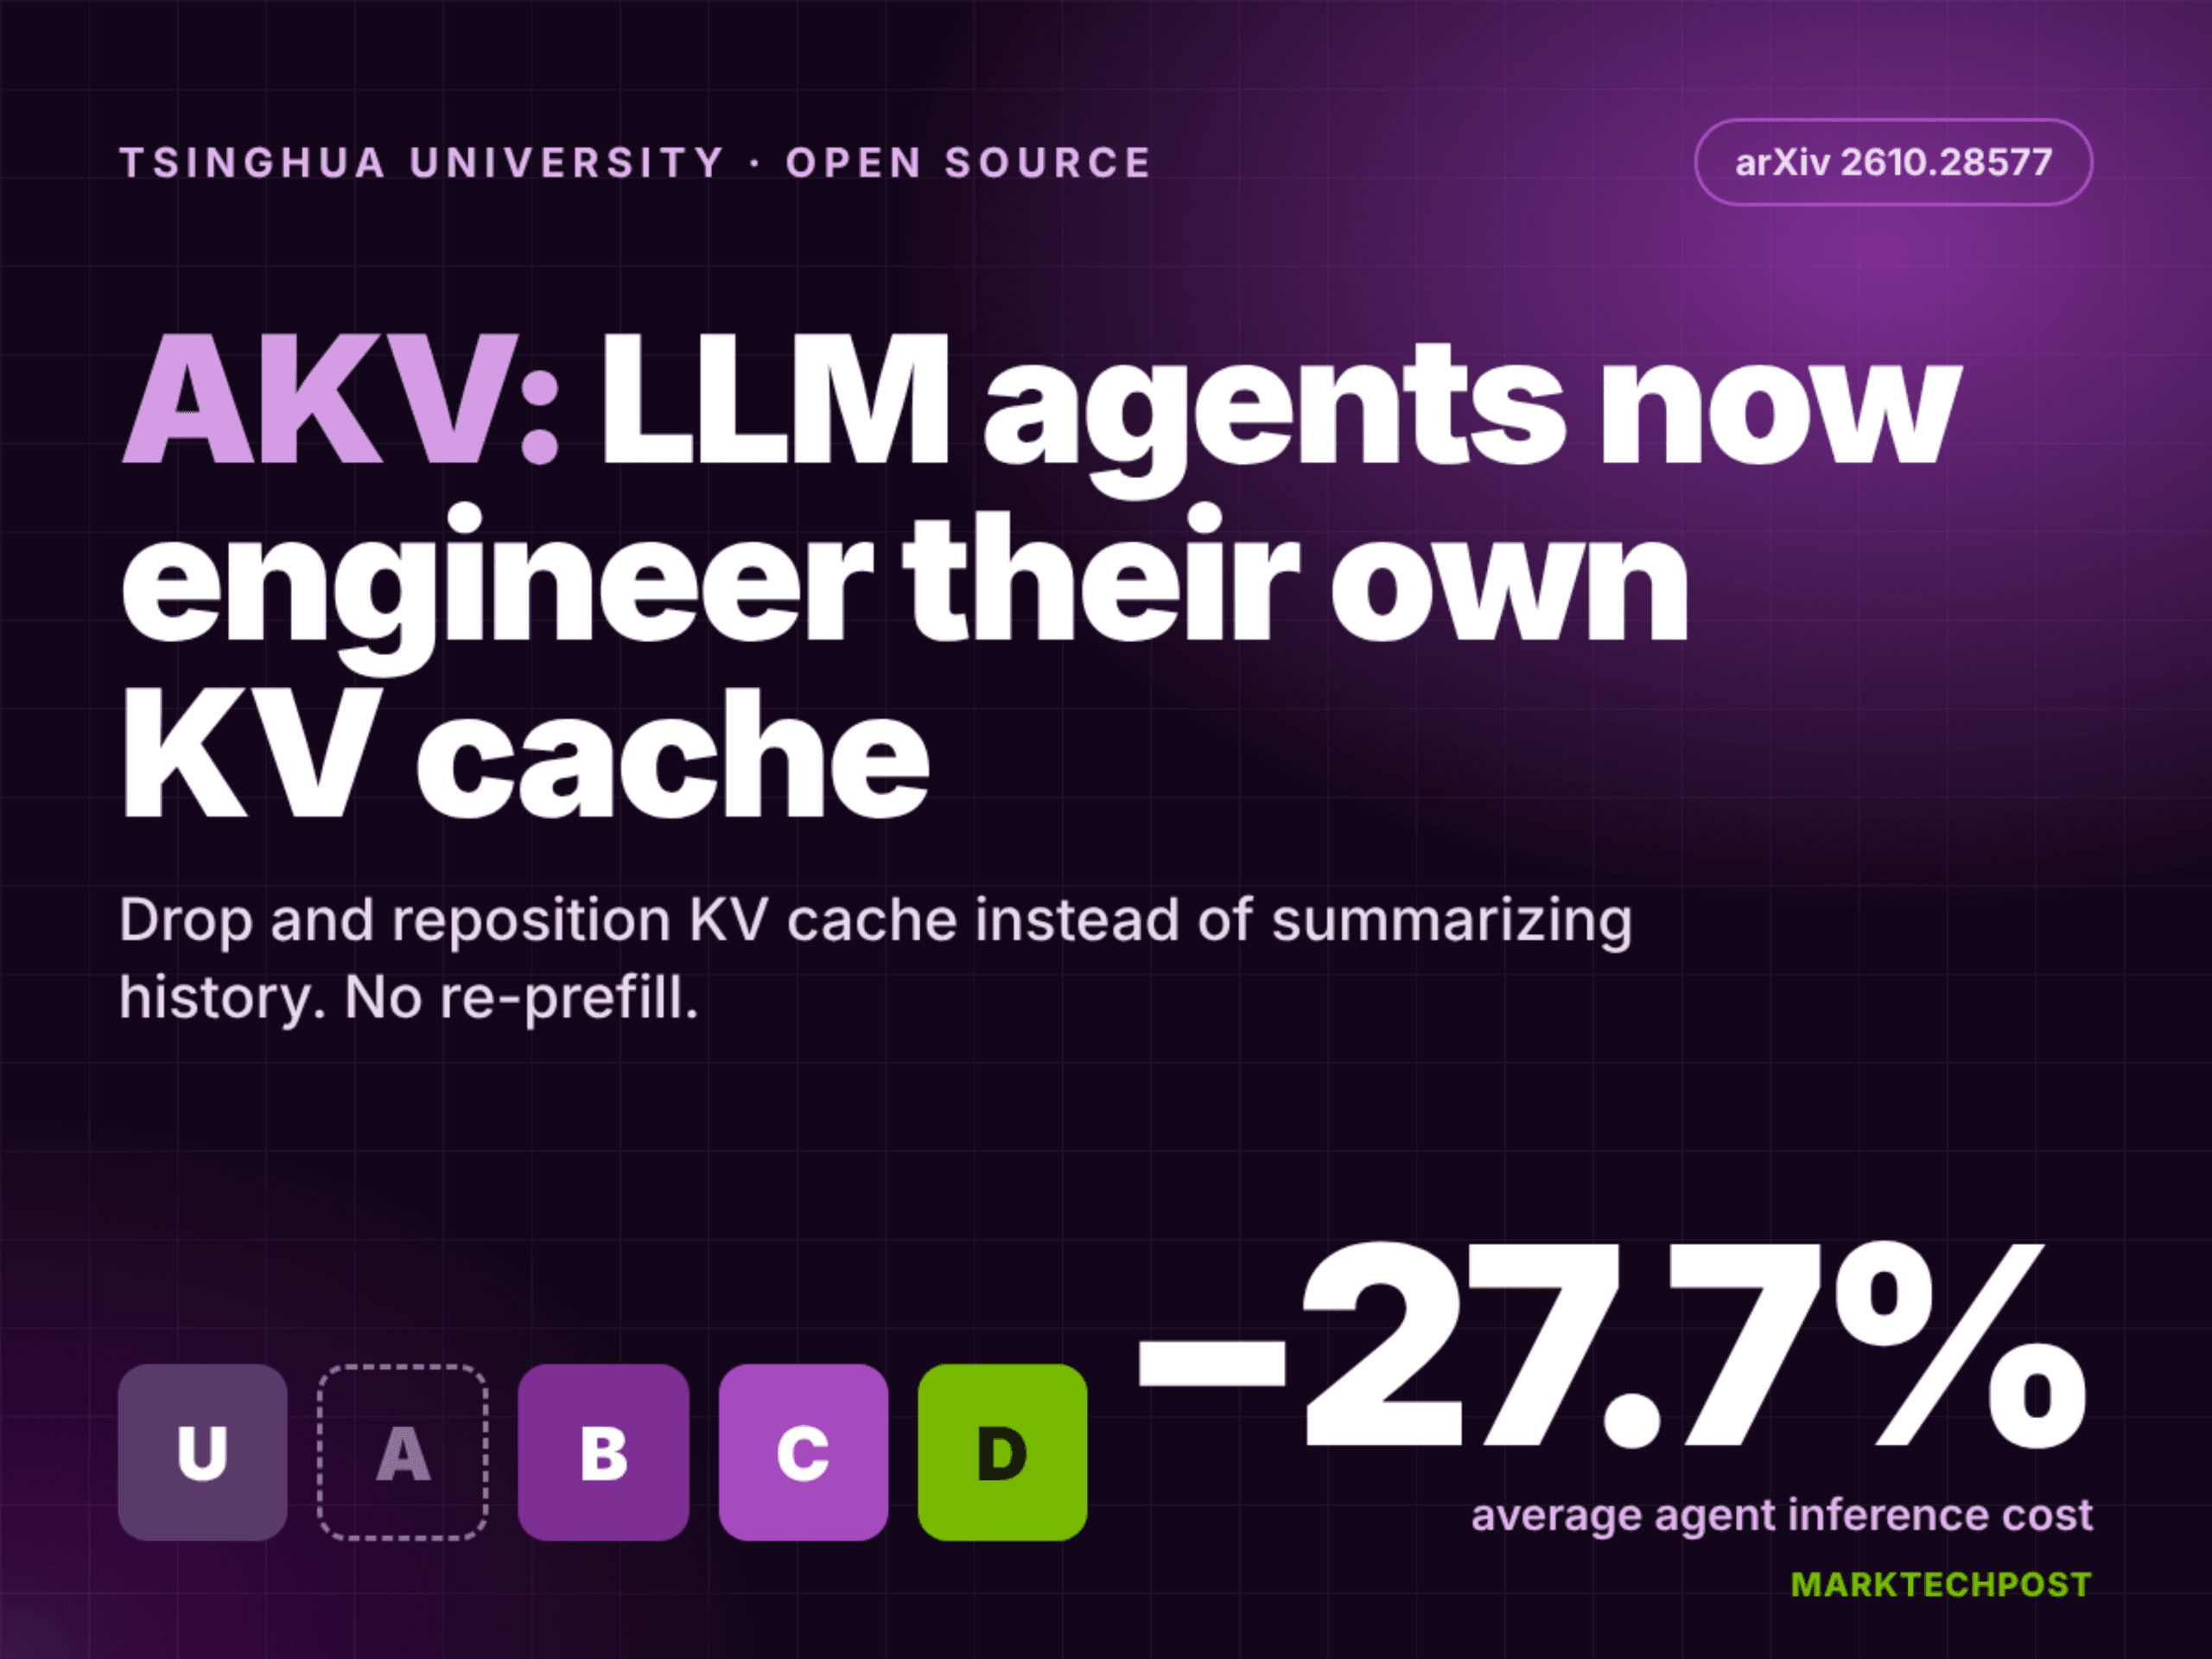
ทีมนักวิจัยจากมหาวิทยาลัย Tsinghua และ CUHK เปิดตัวโอเพนซอร์ส AKV ระบบ Serving สำหรับจัดการ KV cache engineering ใน LLM Agents โดยเปลี่ยนจากการสรุปประวัติข้อความแบบเดิม มาเป็นการเลือกเนื้อหา KV cache เพื่อลบหรือนำกลับมาใช้ใหม่แทน
จากการทดสอบกับ 3 โมเดลบน 4 เกณฑ์มาตรฐาน พบว่า AKV ช่วยลดต้นทุนเฉลี่ยลงได้ถึง 27.7% และมีคะแนนการทำงานเพิ่มขึ้นเฉลี่ย 1.7 คะแนน โดยตัวโปรเจกต์พัฒนาต่อยอดจาก SGLang และใช้สัญญาอนุญาตแบบ Apache-2.0
TL;DR
- มันคืออะไร: ระบบ Serving พร้อมคลังนโยบายจัดการแคช (Policy Library) ทดสอบกับโมเดล GPT-OSS-120B, MiniMax-M2.7 และ MiroThinker-1.7-Mini
- การใช้งาน: รันบน NVIDIA GPU ผ่าน SGLang โดยรองรับโหมด BF16 และสามารถรัน GPT-OSS-120B บน GPU 2 ตัวได้
- ประสิทธิภาพ: ลดต้นทุนเฉลี่ย 27.7% และเพิ่มคะแนนความถูกต้องเฉลี่ย 1.7 คะแนน เมื่อเทียบกับวิธี Threshold Summarization
- ผลลัพธ์เด่น: GPT-OSS-120B บน SWE-bench Verified ลดต้นทุนจาก 20.0 เหลือ 9.7 เซนต์ต่อหนึ่งงาน และคะแนนเพิ่มจาก 40.0 เป็น 43.2
Cache engineering แตกต่างจาก context engineering อย่างไร?
AKV คือระบบ Serving ที่อนุญาตให้ LLM Agents ลบและจัดตำแหน่ง KV cache ของตัวเองได้โดยตรง ซึ่งแตกต่างจาก Context engineering ที่เน้นการตัดแต่งหรือสรุปประวัติข้อความ (text history)
ในระบบเดิม การแก้ไขส่วนต้นของข้อความจะทำให้สถานะ KV หลังจากนั้นทั้งหมดใช้งานไม่ได้ และต้องคำนวณใหม่ (re-prefill) ส่งผลให้รายละเอียดสำคัญในระหว่างการสนทนามักสูญหายไปจากการสรุปเนื้อหาที่รุนแรงเกินไป
แต่สำหรับ Cache engineering จะไม่มีการแตะต้องวิถีของข้อความ (text trajectory) แต่จะเลือกเฉพาะรายการ KV ที่จำเป็นสำหรับการทำ attention มาใช้ใหม่โดยไม่ต้องคำนวณซ้ำ ซึ่งผลวิจัยพบว่าการอ่าน KV cache คิดเป็นต้นทุนสูงถึง 82.4% ของค่า API ทั้งหมด
กลไกการทำงานของ AKV
AKV กำหนดการจัดการแคชเป็น 3 รูปแบบหลัก ได้แก่ Append (อัปเดต token ใหม่), Drop (นำรายการที่ไม่ใช้ออก) และ Repos (การเขียนตำแหน่ง Key ใหม่โดยใช้การหมุนแบบ RoPE) ซึ่งการเพิ่มฟีเจอร์ Repos ช่วยเพิ่มอัตราความสำเร็จ (pass rate) ของ GPT-OSS-120B ได้อย่างมีนัยสำคัญ
ความท้าทายสำคัญคือการ Serving เนื่องจากระบบต้องจัดการกับสถานะแคชที่ต่างกันแม้จะเป็น token ชุดเดียวกัน AKV จึงขยายโครงสร้าง Radix Tree ของ SGLang ด้วยโหนด drop และ reposition เพื่อคืนพื้นที่ KV เฉพาะเมื่อไม่มีการใช้งานแล้วเท่านั้น
อินเทอร์เฟซและการรองรับ API
ระบบออกแบบมาให้เป็นแบบไร้สถานะ (stateless) และรองรับการทำงานร่วมกับ OpenAI โดยนักพัฒนาสามารถระบุดัชนีข้อความที่ต้องการลบหรือจัดตำแหน่งใหม่ผ่านฟิลด์ drop_message และ reposition
นอกจากนี้ยังมี CachePolicy ที่เตรียมกฎการจัดการแคชสำเร็จรูปไว้ให้เลือกใช้ ทั้งแบบอิงตามรอบการสนทนา หรืออิงตามตัวโมเดล และยังมี CacheTool ที่เปิดทางให้ตัว AI Agent สามารถสั่งจัดการหน่วยความจำแคชได้ด้วยตนเอง
ประสิทธิภาพเหนือกว่าในงานระยะยาว
| โมเดล | คะแนน Standard / ต้นทุน | คะแนน Text Eng. / ต้นทุน | คะแนน AKV / ต้นทุน |
|---|---|---|---|
| MiniMax-M2.7 | 52.4 / 5.0 | 52.8 / 5.7 | 53.7 / 4.4 |
| GPT-OSS-120B | 51.0 / 11.2 | 48.3 / 10.2 | 53.1 / 7.3 |
| MiroThinker-1.7-Mini | 44.1 / 20.4 | 37.1 / 18.1 | 45.8 / 14.8 |
ตาราง: ค่าเฉลี่ย pass rate (%) และต้นทุน (USD ต่อหนึ่งงาน) จาก 4 เกณฑ์มาตรฐาน ที่มา: งานวิจัย AKV
ในงานที่มีบริบทขนาดยาวกว่า 96K tokens AKV แสดงให้เห็นถึงความแม่นยำที่สูงกว่าวิธีทั่วไปอย่างชัดเจน ขณะเดียวกันยังช่วยเพิ่ม Throughput และลดความหน่วง (latency) ลงได้อย่างมาก โดยเฉพาะที่ระดับ Concurrency 16 ซึ่งความหน่วง P95 ลดลงจาก 229.90 วินาที เหลือเพียง 30.63 วินาทีเท่านั้น
บทสรุปและทิศทางต่อไป
AKV พิสูจน์ให้เห็นว่าการให้ Agent ควบคุม KV cache เองช่วยลดต้นทุนและเพิ่มความแม่นยำได้จริง โดยเฉพาะการใช้ฟีเจอร์ Repos ที่ช่วยรักษาประสิทธิภาพในงานซับซ้อน ปัจจุบันระบบรองรับโมเดลตระกูล Qwen, GPT-OSS และ MiniMax-M2 เป็นหลัก และเป็นก้าวสำคัญในการเพิ่มประสิทธิภาพ AI Agent สำหรับใช้งานในระดับองค์กร
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร