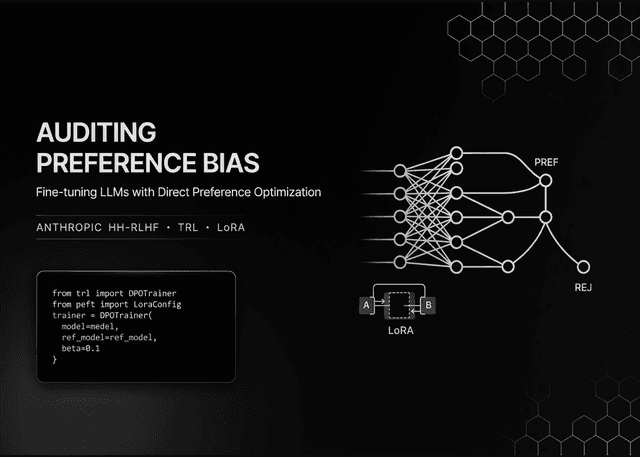
เจาะลึกการตรวจสอบอคติและ Fine-Tuning โมเดลภาษาด้วย DPO ผ่านเฟรมเวิร์ก TRL และ LoRAtag: Anthropic, DPO, Fine-tuning, LoRA, Qwen, TRLAug 20, 2026 · By: AttapolKแนวทางการทำ Fine-tuning โมเดลภาษาด้วยเทคนิค Direct Preference Optimization (DPO) พร้อมระบบตรวจสอบอคติทางโครงสร้างและความยาวในชุดข้อมูล Anthropic HH-RLHF เพื่อป้องกันโมเดลเรียนรู้จากทางลัดทางคำศัพท์
คู่มือ Fine-Tuning LLM สำหรับ Tool-Calling ด้วย XYZ-Aquila-SFT และ Qwen3tag: Fine-tuning, LLM, LoRA, Qwen3, Tool-Calling, XYZ-Aquila-SFTAug 16, 2026 · By: AttapolKนำเสนอขั้นตอนการ Fine-tuning โมเดลภาษาแบบ end-to-end เพื่อรองรับการเรียกใช้เครื่องมือ (tool-calling) ครอบคลุมตั้งแต่การจัดการชุดข้อมูล XYZ-Aquila-SFT ไปจนถึงการปรับแต่ง LoRA บนโมเดล Qwen3
สร้าง LLM สายเหตุผล: คู่มือเทรนโมเดลขนาดเล็กด้วย SupraLabs Reasoning Corpustag: Fine-tuning, Hugging Face, LoRA, Reasoning Model, SmolLM2, SupraLabsAug 15, 2026 · By: TanasakPบทความนี้สรุปเวิร์กโฟลว์การพัฒนาโมเดลภาษาขนาดกะทัดรัดที่เน้นการให้เหตุผล โดยใช้ข้อมูลจาก SupraLabs Reasoning Corpus ร่วมกับเทคนิค LoRA บน SmolLM2 เพื่อประสิทธิภาพสูงสุดภายใต้ทรัพยากรที่จำกัด
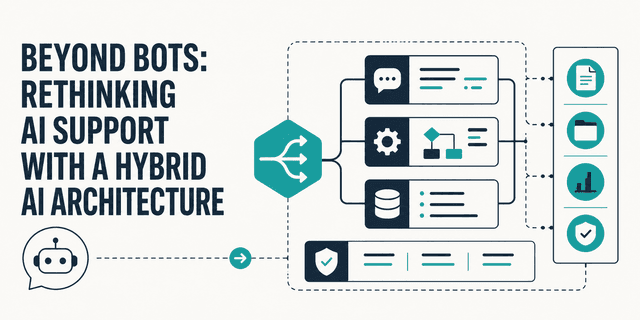
ก้าวข้ามขีดจำกัดบอท: เจาะลึกสถาปัตยกรรม Hybrid AI ที่ผสมผสาน RAG และ Fine-tuningtag: AI Architecture, Fine-tuning, IBM, LoRA, Qwen, RAGAug 6, 2026 · By: SirilukPการสร้างระบบสนับสนุนด้วย AI ในระดับองค์กรให้มีประสิทธิภาพสูงสุด จำเป็นต้องใช้สถาปัตยกรรมแบบไฮบริดที่แยกส่วน 'ข้อมูล' ออกจาก 'วิธีการตอบ' เพื่อแก้ปัญหาความแม่นยำและโทนเสียงของแบรนด์
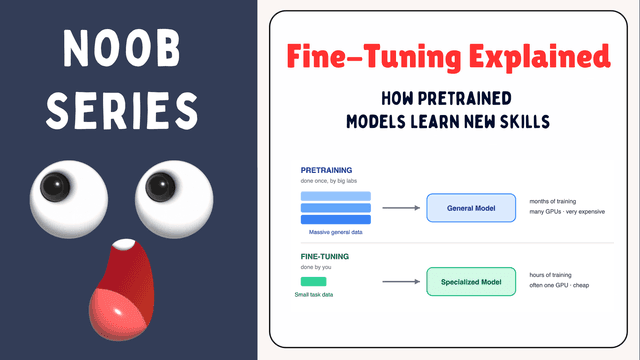
เจาะลึกการ Fine-Tuning ฉบับมือใหม่: เปลี่ยน AI ให้เก่งเฉพาะทางอย่างมืออาชีพtag: Fine-tuning, LLM, LoRA, Machine Learning, PEFT, PretrainingJul 17, 2026 · By: SirilukPทำความรู้จักขั้นตอนพื้นฐานของการปรับจูนโมเดลภาษาขนาดใหญ่ (LLM) ตั้งแต่กระบวนการ Pretraining ไปจนถึงเทคนิค Fine-Tuning รูปแบบต่างๆ ที่ช่วยให้ AI เรียนรู้ทักษะใหม่ได้อย่างมีประสิทธิภาพ