
ก้าวข้ามขีดจำกัดบอท: เจาะลึกสถาปัตยกรรม Hybrid AI ที่ผสมผสาน RAG และ Fine-tuning
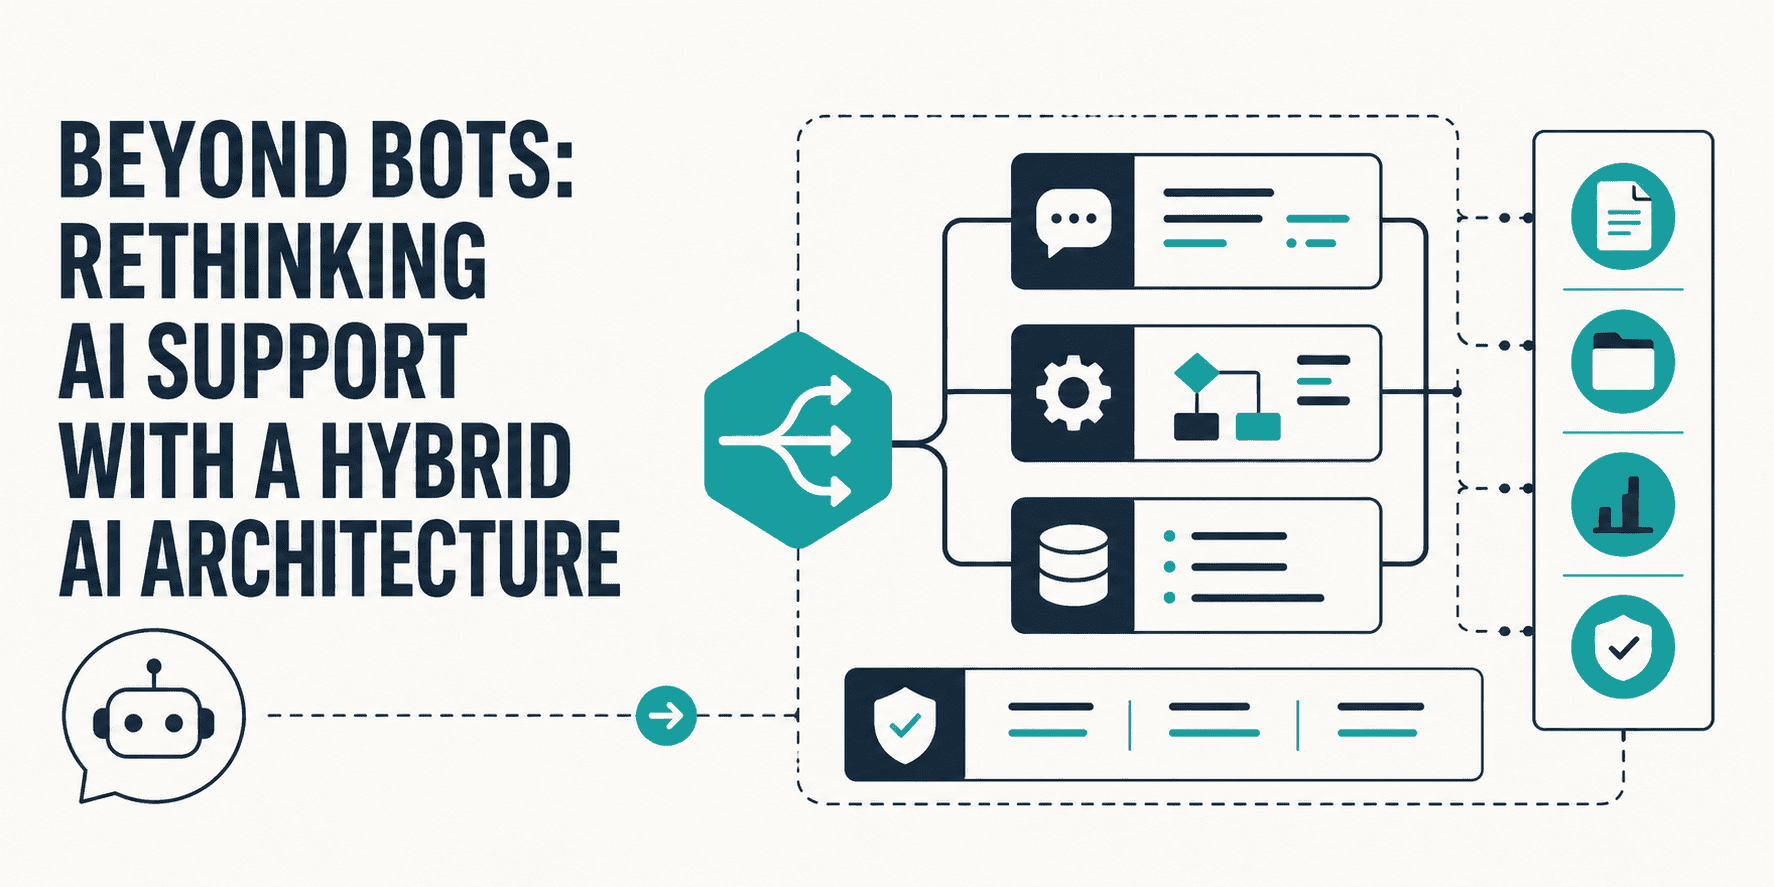
Beyond Bots
เมื่อเร็วๆ นี้ มีลูกค้ารายหนึ่งต้องการพัฒนาแชทบอทที่ ปลอดภัย แม่นยำ และตอบสนองได้เกือบเรียลไทม์ โจทย์คือระบบ AI ต้องตอบคำถามสนับสนุนลูกค้าได้อย่างไร้ที่ติ โดยไม่เปิดเผยข้อมูลที่ละเอียดอ่อนหรือหลุดจากโทนเสียงของบริษัท ความต้องการเช่นนี้กลายเป็นมาตรฐานใหม่ในปัจจุบัน เนื่องจาก ความปลอดภัยของข้อมูล ความหน่วง (latency) และคุณภาพการตอบกลับ ส่งผลกระทบโดยตรงต่อผลกำไรของธุรกิจ
ระบบ AI ที่ทำงานผิดพลาดจะสูญเสียความไว้วางใจอย่างรวดเร็วและสร้างความเสียหายทางการเงินอย่างมหาศาล โดย รายงานปี 2025 ของ IBM ประมาณการว่ามูลค่าความเสียหายเฉลี่ยจากการรั่วไหลของข้อมูลทั่วโลกพุ่งสูงถึง 4.44 ล้านดอลลาร์
อย่างไรก็ตาม แชทบอททั่วไปและโมเดลภาษาขนาดใหญ่ (LLMs) สำเร็จรูปมักไม่สามารถตอบโจทย์ระดับองค์กรได้ แม้ LLM จะทรงพลัง แต่ก็มีข้อจำกัดด้าน ขีดจำกัดของ Token, การทำความเข้าใจบริบท (context) และอาการประสาทหลอน (hallucinations) สิ่งเหล่านี้กลายเป็นอุปสรรคสำคัญเมื่อต้องรับมือกับความรู้เฉพาะทางที่ต้องการความแม่นยำสูง คำถามคือเราจะสร้าง AI ที่ตอบคำถามแบบผู้เชี่ยวชาญ รวดเร็ว ปลอดภัย และควบคุมได้จริงได้อย่างไร?
จากประสบการณ์การพัฒนาโมเดลของผม คำตอบไม่ใช่การใช้เทคนิคใดเทคนิคหนึ่งเพียงอย่างเดียว แต่มันต้องการสถาปัตยกรรมที่กว้างขึ้น ซึ่งแยก "สิ่งที่โมเดลรู้" ออกจาก "วิธีที่มันตอบสนอง" โดยผสมผสานการเรียนรู้เข้ากับการดึงข้อมูล (retrieval) อย่างลงตัว
ความท้าทายหลัก
ในช่วงเริ่มต้นของการออกแบบ เราพบความท้าทายพื้นฐาน 4 ประการที่ต้องแก้ไข:
// ขีดจำกัดของบริบทที่มีประสิทธิภาพ (นอกเหนือจากจำนวน Token)
แม้ LLM สมัยใหม่จะโฆษณาว่ามี context window ขนาดใหญ่ตั้งแต่ 16K ไปจนถึง 128K tokens แต่ในเชิงปฏิบัติ ความแม่นยำจะเริ่มลดลงเมื่อได้รับข้อมูลมหาศาล โมเดลมักจะละเลยข้อมูลที่อยู่ตรงกลาง prompt ซึ่งเป็นปรากฏการณ์ที่เรียกว่า primacy-recency bias ดังนั้นการเพิ่มขนาดบริบทเพียงอย่างเดียวจึงไม่ใช่ทางออกสำหรับฐานข้อมูลระดับองค์กรที่มีข้อมูลนับล้าน
// การใช้ข้อมูลแบบ Long-Tail ที่ไม่มีประสิทธิภาพ
โมเดลอาจเพิกเฉยหรือตีความข้อมูลสำคัญผิดพลาดแม้จะมีเนื้อหาที่ถูกต้องอยู่ใน prompt ก็ตาม งานวิจัย Lost in the Middle ยืนยันว่าอินพุตที่ยาวเกินไปนำไปสู่ การใช้เหตุผลที่ไม่สมบูรณ์ ทำให้กลยุทธ์การอัดข้อมูลทุกอย่างลงใน prompt ใช้ไม่ได้ผลกับระบบสนับสนุนที่ซับซ้อน
// การแลกเปลี่ยนระหว่างความแม่นยำและประสิทธิภาพในการดึงข้อมูล
การดึงข้อมูล (Retrieval) มีต้นทุนด้านเวลาและทรัพยากร หากดึงข้อมูลมากเกินไปจะทำให้ระบบตอบสนองช้าและโมเดลเสียสมาธิ แต่ถ้าดึงน้อยเกินไปก็จะเสี่ยงต่อการเกิดอาการประสาทหลอน ความท้าทายที่แท้จริงคือ การดึงข้อมูลที่แม่นยำ (precision retrieval) เพื่อให้ได้บริบทที่เพียงพอโดยไม่ทำให้ระบบทำงานหนักเกินไป
// อาการประสาทหลอนภายใต้บริบทที่ขาดหายไป
LLM มักจะไม่ยอมแพ้แม้ไม่มีข้อมูลที่เกี่ยวข้อง แต่มันจะสร้างคำตอบที่ดูมั่นใจขึ้นมาเอง ซึ่งในงานสนับสนุนลูกค้า พฤติกรรมนี้เป็นสิ่งที่ยอมรับไม่ได้เพราะส่งผลต่อ ความไว้วางใจและความถูกต้องตามกฎระเบียบ การส่งบริบทเพิ่มจึงไม่ใช่ทางออก แต่เราต้องการสถาปัตยกรรมที่ชาญฉลาดกว่าเดิม
คำตอบ: สถาปัตยกรรมแบบไฮบริด
แนวทางที่เราค้นพบคือการรวม Retrieval Augmented Generation (RAG) เข้ากับ โมเดลที่ผ่านการ Fine-tuned โดยมีหลักการสำคัญคือ Fine-tuning มีหน้าที่ สอนโมเดลว่าควรตอบอย่างไร ส่วนการดึงข้อมูล (RAG) ช่วยให้ข้อมูลว่า ควรตอบอะไร การแยกหน้าที่เช่นนี้ช่วยให้แต่ละส่วนทำงานตามจุดแข็งของตัวเอง
การใช้ RAG เพื่อความแม่นยำผ่านการดึงข้อมูล
เราสร้างฐานความรู้ที่คัดสรรมาอย่างดีจากคู่มือผลิตภัณฑ์และนโยบายต่างๆ แทนการส่งเอกสารดิบให้โมเดล เมื่อมีการถามคำถาม ตัวดึงข้อมูล (retriever) จะคัดเลือกเฉพาะส่วนที่เกี่ยวข้องที่สุดใส่ใน prompt เพื่อให้คำตอบตั้งอยู่บนข้อเท็จจริงที่ตรวจสอบได้
วิธีนี้ช่วยลดอาการประสาทหลอนและเพิ่มความเร็วได้จริง แต่ RAG เพียงอย่างเดียวกลับมีปัญหาเรื่องโทนเสียงและโครงสร้างการตอบที่ไม่สม่ำเสมอ ผลการทดสอบพบว่าแม้โมเดลขนาดเล็กจะเข้าถึงบริบทได้แม่นยำเกือบ 100% แต่ความถูกต้องของผลลัพธ์กลับอยู่ที่ 70% เพราะโมเดลไม่สามารถรักษาโทนการสนทนาหรือนำทางผู้ใช้ได้อย่างมืออาชีพ
การ Fine-Tuning Qwen: การสอนโมเดลว่าควรตอบอย่างไร เพื่อแก้ปัญหาเรื่องโทนเสียง เราได้ทำการ fine-tuned โมเดล Qwen ด้วยคู่คำถาม-คำตอบคุณภาพสูงประมาณ 1,000 ชุด เป้าหมายคือการสอนให้โมเดลใช้ภาษาเฉพาะด้าน รักษาภาพลักษณ์องค์กร และรู้วิธีจัดการกับกรณีพิเศษในงานสนับสนุน
เราเลือกใช้เทคนิค Low-Rank Adaptation (LoRA) เพื่อปรับพฤติกรรมโมเดลโดยไม่ให้เกิดปัญหาการลืมข้อมูลเดิม (catastrophic forgetting) และช่วยลดการใช้หน่วยความจำ GPU ผลลัพธ์ที่ได้คือโมเดลมีความสม่ำเสมอมากขึ้น แต่ยังคงมีจุดอ่อนเมื่อต้องตอบคำถามเกี่ยวกับข้อมูลใหม่ๆ หรือนโยบายที่เพิ่งอัปเดต
ทำไม RAG หรือ Fine-Tuning เพียงอย่างเดียวจึงไม่พอ
จากการทดลองเราพบข้อสรุปที่ชัดเจนดังนี้:
- RAG อย่างเดียว: ข้อมูลแม่นยำและเป็นปัจจุบัน แต่โทนเสียงไม่สม่ำเสมอและความหน่วงสูง
- Fine-tuning อย่างเดียว: โทนเสียงดีเยี่ยมและโครงสร้างเป๊ะ แต่ล้มเหลวเมื่อข้อมูลเปลี่ยนแปลงหรือเป็นเรื่องเฉพาะทางมากๆ (long-tail)
เมื่อรวมทั้งสองเข้าด้วยกัน ความแม่นยำของโทนเสียงขยับขึ้นเป็น 75% และความถูกต้องของข้อเท็จจริงเพิ่มเป็น 73% ซึ่งสูงกว่าการแยกใช้ทีละวิธีอย่างเห็นได้ชัด การมีโมเดลที่ผ่านการ fine-tuned ช่วยให้ AI เข้าใจบริบทและรูปแบบผลลัพธ์ที่คาดหวัง ทำให้มันนำข้อมูลที่ดึงมาจาก RAG มาประยุกต์ใช้ได้อย่างมีประสิทธิภาพสูงสุด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร