Fyxer ปั้น AI ผู้ช่วยบริหารมือโปร ด้วยเบื้องหลังเวิร์กโฟลว์กว่า 5 แสนชั่วโมงtag: AI Executive Assistant, Business Automation, Fine-tuning, Fyxer, Machine Learning, OpenAISep 15, 2026 · By: SirilukPFyxer พัฒนา AI ผู้ช่วยบริหารที่สามารถร่างอีเมลและจัดการงานสื่อสารด้วยน้ำเสียงเฉพาะตัวของผู้ใช้ โดยผสานโมเดล OpenAI เข้ากับข้อมูลการทำงานจริงจาก EA มืออาชีพ
ปฏิวัติการฝึก AI ด้วย Tunix: เมื่อ AI Agent ช่วยทำ Post-training แบบอัตโนมัติบน Google TPUstag: Cloud TPU, Fine-tuning, Gemma, Google, LLM, TunixSep 11, 2026 · By: TanasakPGoogle เปิดตัวแนวคิดการใช้ AI Agent เพื่อทำ LLM Fine-tuning แบบอัตโนมัติผ่านโปรเจกต์ autofinetune ช่วยลดขั้นตอนการปรับจูน Hyperparameters ที่ยุ่งยากให้กลายเป็นกระบวนการที่รันได้เองตลอด 24 ชั่วโมง
เทคนิค GRPO: ปรับจูนโมเดล 350M ให้สร้างข้อมูลแบบโครงสร้างได้แม่นยำใน 100 ขั้นตอนtag: Fine-tuning, GRPO, Language Models, Policy Optimization, Structured OutputsSep 3, 2026 · By: TanasakPเจาะลึกการใช้ Group Relative Policy Optimization (GRPO) เพื่อ Fine-tuning โมเดลภาษาขนาดเล็กให้รองรับ Structured Outputs ได้อย่างมีประสิทธิภาพด้วยการฝึกฝนเพียง 100 ขั้นตอน
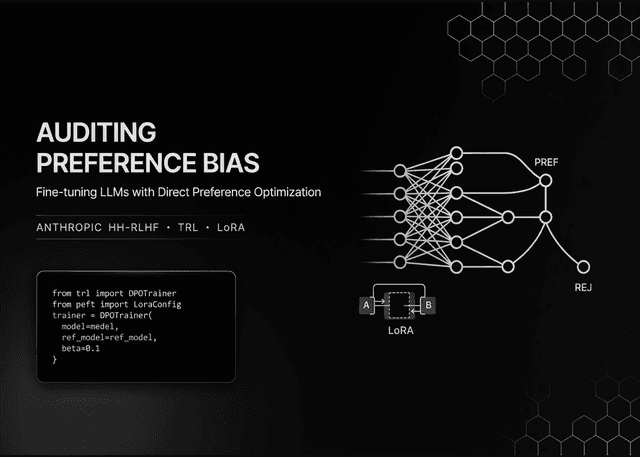
เจาะลึกการตรวจสอบอคติและ Fine-Tuning โมเดลภาษาด้วย DPO ผ่านเฟรมเวิร์ก TRL และ LoRAtag: Anthropic, DPO, Fine-tuning, LoRA, Qwen, TRLAug 20, 2026 · By: AttapolKแนวทางการทำ Fine-tuning โมเดลภาษาด้วยเทคนิค Direct Preference Optimization (DPO) พร้อมระบบตรวจสอบอคติทางโครงสร้างและความยาวในชุดข้อมูล Anthropic HH-RLHF เพื่อป้องกันโมเดลเรียนรู้จากทางลัดทางคำศัพท์
คู่มือ Fine-Tuning LLM สำหรับ Tool-Calling ด้วย XYZ-Aquila-SFT และ Qwen3tag: Fine-tuning, LLM, LoRA, Qwen3, Tool-Calling, XYZ-Aquila-SFTAug 16, 2026 · By: AttapolKนำเสนอขั้นตอนการ Fine-tuning โมเดลภาษาแบบ end-to-end เพื่อรองรับการเรียกใช้เครื่องมือ (tool-calling) ครอบคลุมตั้งแต่การจัดการชุดข้อมูล XYZ-Aquila-SFT ไปจนถึงการปรับแต่ง LoRA บนโมเดล Qwen3
สร้าง LLM สายเหตุผล: คู่มือเทรนโมเดลขนาดเล็กด้วย SupraLabs Reasoning Corpustag: Fine-tuning, Hugging Face, LoRA, Reasoning Model, SmolLM2, SupraLabsAug 15, 2026 · By: TanasakPบทความนี้สรุปเวิร์กโฟลว์การพัฒนาโมเดลภาษาขนาดกะทัดรัดที่เน้นการให้เหตุผล โดยใช้ข้อมูลจาก SupraLabs Reasoning Corpus ร่วมกับเทคนิค LoRA บน SmolLM2 เพื่อประสิทธิภาพสูงสุดภายใต้ทรัพยากรที่จำกัด
เจาะลึก SmolLM3: โมเดลภาษาขนาดเล็กประสิทธิภาพสูง พร้อมวิธีสร้างระบบ Support Ticket อัจฉริยะtag: Fine-tuning, Hugging Face, Natural Language Processing, SLM, SmolLM3, TransformersAug 7, 2026 · By: SirilukPSmolLM3 คือโมเดลขนาด 3B จาก Hugging Face ที่ออกแบบมาเพื่อทำงานเฉพาะทางแทนโมเดลใหญ่ 70B ด้วยต้นทุนที่ถูกกว่ามาก โดยรองรับการเรียกใช้เครื่องมือ การให้เหตุผล และการจัดการภาษาที่หลากหลาย
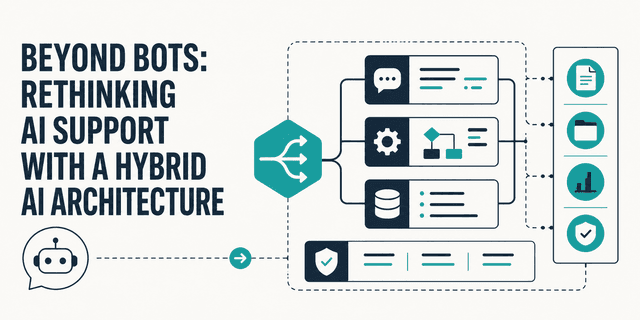
ก้าวข้ามขีดจำกัดบอท: เจาะลึกสถาปัตยกรรม Hybrid AI ที่ผสมผสาน RAG และ Fine-tuningtag: AI Architecture, Fine-tuning, IBM, LoRA, Qwen, RAGAug 6, 2026 · By: SirilukPการสร้างระบบสนับสนุนด้วย AI ในระดับองค์กรให้มีประสิทธิภาพสูงสุด จำเป็นต้องใช้สถาปัตยกรรมแบบไฮบริดที่แยกส่วน 'ข้อมูล' ออกจาก 'วิธีการตอบ' เพื่อแก้ปัญหาความแม่นยำและโทนเสียงของแบรนด์
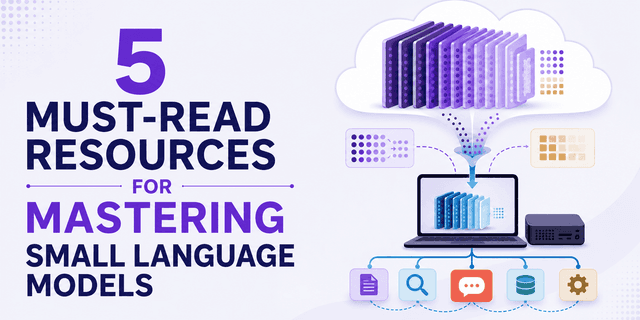
5 แหล่งความรู้ต้องอ่าน เพื่ออัปสกิลการพัฒนา Small Language Models (SLMs)tag: AI agents, Fine-tuning, Hugging Face, Nvidia, PyTorch, Small Language ModelsJul 29, 2026 · By: SirilukPเจาะลึก 5 แหล่งข้อมูลสำคัญที่ครอบคลุมตั้งแต่สถาปัตยกรรม การทำ Fine-tuning ไปจนถึงการปรับใช้ Small Language Models ในงานวิศวกรรมข้อมูลระดับมืออาชีพ
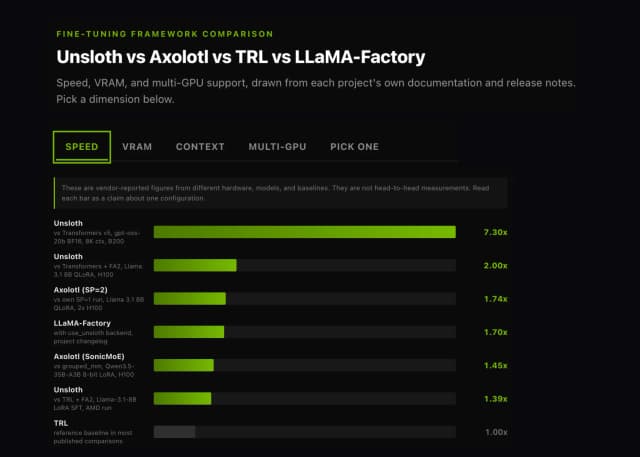
เปรียบเทียบ 4 สุดยอด Framework สำหรับ Fine-Tuning LLM: เลือกตัวไหนให้เร็ว แรง และประหยัด VRAMtag: Axolotl, Fine-tuning, LLaMA-Factory, LLM, TRL, UnslothJul 23, 2026 · By: AttapolKเจาะลึกความต่างระหว่าง Unsloth, Axolotl, TRL และ LLaMA-Factory สี่โครงการโอเพนซอร์สชั้นนำสำหรับการปรับแต่งโมเดลภาษาขนาดใหญ่ที่วิศวกร AI ต้องรู้จัก
NVIDIA จับมือ Hugging Face เปิดตัว NeMo Automodel ยกระดับการ Fine-tune โมเดลวิดีโอและรูปภาพระดับสเกลtag: Diffusers, Diffusion Model, Fine-tuning, Hugging Face, NeMo Automodel, NvidiaJul 18, 2026 · By: SirilukPNVIDIA และ Hugging Face ร่วมมือกันเปิดตัว NeMo Automodel ไลบรารีโอเพนซอร์สที่ช่วยให้การเทรนและ Fine-tuning โมเดล Diffusion ขนาดใหญ่บน Hugging Face Hub ทำได้ง่ายและมีประสิทธิภาพสูงขึ้นโดยไม่ต้องแปลง Checkpoint
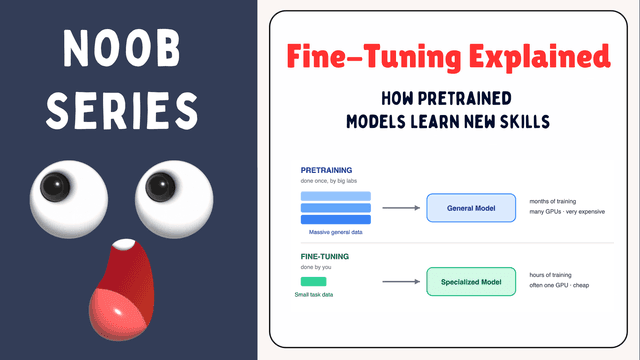
เจาะลึกการ Fine-Tuning ฉบับมือใหม่: เปลี่ยน AI ให้เก่งเฉพาะทางอย่างมืออาชีพtag: Fine-tuning, LLM, LoRA, Machine Learning, PEFT, PretrainingJul 17, 2026 · By: SirilukPทำความรู้จักขั้นตอนพื้นฐานของการปรับจูนโมเดลภาษาขนาดใหญ่ (LLM) ตั้งแต่กระบวนการ Pretraining ไปจนถึงเทคนิค Fine-Tuning รูปแบบต่างๆ ที่ช่วยให้ AI เรียนรู้ทักษะใหม่ได้อย่างมีประสิทธิภาพ
เมื่อ GPT และ Claude ตกวิชาการเงิน: Bridgewater และสตาร์ทอัพของ Mira Murati โชว์พลัง Fine-tuning โมเดลเจาะจงเฉพาะทางtag: Bridgewater, Fine-tuning, Mira Murati, Open-weight, Qwen3-235B, Thinking Machines LabJul 7, 2026 · By: AttapolKBridgewater ร่วมกับ Thinking Machines Lab ของอดีต CTO OpenAI เผยแพร่ผลทดสอบโมเดล Qwen3-235B ที่ผ่านการ Fine-tune พบว่ามีความแม่นยำด้านการเงินถึง 84.7% แซงหน้าโมเดลระดับแนวหน้าอย่าง GPT และ Claude ด้วยต้นทุนที่ถูกกว่า 14 เท่า