
เมื่อ GPT และ Claude ตกวิชาการเงิน: Bridgewater และสตาร์ทอัพของ Mira Murati โชว์พลัง Fine-tuning โมเดลเจาะจงเฉพาะทาง
Hedge fund ระดับโลกอย่าง Bridgewater และ Thinking Machines Lab ระบุว่าโมเดลแบบ open-weight ที่ผ่านกระบวนการ fine-tune มีประสิทธิภาพเหนือกว่าโมเดล AI ที่ทรงพลังที่สุดในการวิเคราะห์เอกสารทางการเงิน โดยใช้ต้นทุนเพียงเศษเสี้ยวเดียว ซึ่งข้อมูลเหล่านี้มาจากการประเมินภายในของพวกเขาเอง
ในแต่ละวัน นักลงทุนต้องรับมือกับข้อมูลมหาศาล ทั้งข่าวสาร บทวิเคราะห์ เอกสารบริษัท และอีเมลจำนวนมาก รายงานจาก AIA Labs ของ Bridgewater และ Thinking Machines Lab สตาร์ทอัพที่ก่อตั้งโดย Mira Murati อดีต CTO ของ OpenAI ระบุว่า งานที่ยากแท้จริงไม่ใช่แค่การอ่าน แต่คือกระบวนการตัดสินใจย่อยๆ ที่เกิดขึ้นซ้ำๆ ว่าข้อมูลใดสำคัญ ซึ่งเป็นขั้นตอนการคัดกรอง (triage) ที่เหล่านักวิจัยต้องการทำให้เป็นระบบอัตโนมัติ
ทีมวิจัยได้กำหนดภารกิจ 6 รูปแบบที่จำลองมาจากกิจวัตรของนักลงทุน เช่น การตัดสินใจว่าบทความด้านการเงินเกี่ยวข้องกับผู้บริหารรายนั้นหรือไม่ หรือรายงานจากธนาคารกลางส่งสัญญาณการเปลี่ยนแปลงอัตราดอกเบี้ยในอนาคตอย่างไร สำหรับนักลงทุนมืออาชีพ การตัดสินใจเหล่านี้เป็นเรื่องพื้นฐาน แต่การอธิบายเหตุผลออกมาเป็นคำพูดนั้นทำได้ยาก รายงานยกตัวอย่างว่า พาดหัวข่าวเกี่ยวกับคำกล่าวอ้างของ Trump ต่อดินแดน Greenland ถูกมองว่าไม่เกี่ยวข้อง ในขณะที่คำขู่เรื่องภาษีศุลกากรใหม่ของจีนกลับมีความสำคัญอย่างมาก แม้ทั้งสองเรื่องจะเกี่ยวกับภูมิรัฐศาสตร์และการเงินเหมือนกัน
ผลปรากฏว่าโมเดลระดับแนวหน้า (Frontier models) สอบตกในการทดสอบนี้ โดยรุ่นต่างๆ ของ Gemini, Claude และ GPT มีความแม่นยำเพียงประมาณ 50% เมื่อใช้ prompt พื้นฐาน แม้จะปรับมาใช้คำแนะนำจากผู้เชี่ยวชาญร่วมกับระบบการให้คะแนนสามระดับ (“เกี่ยวข้องและน่าสนใจ”, “เกี่ยวข้องแต่ไม่น่าสนใจ”, “ไม่เกี่ยวข้อง”) ความแม่นยำก็เพิ่มขึ้นเพียงระดับ 70% กลางๆ ซึ่งยังไม่ถึงเกณฑ์ 80% ที่ผู้เขียนตั้งไว้สำหรับการนำไปใช้งานจริง
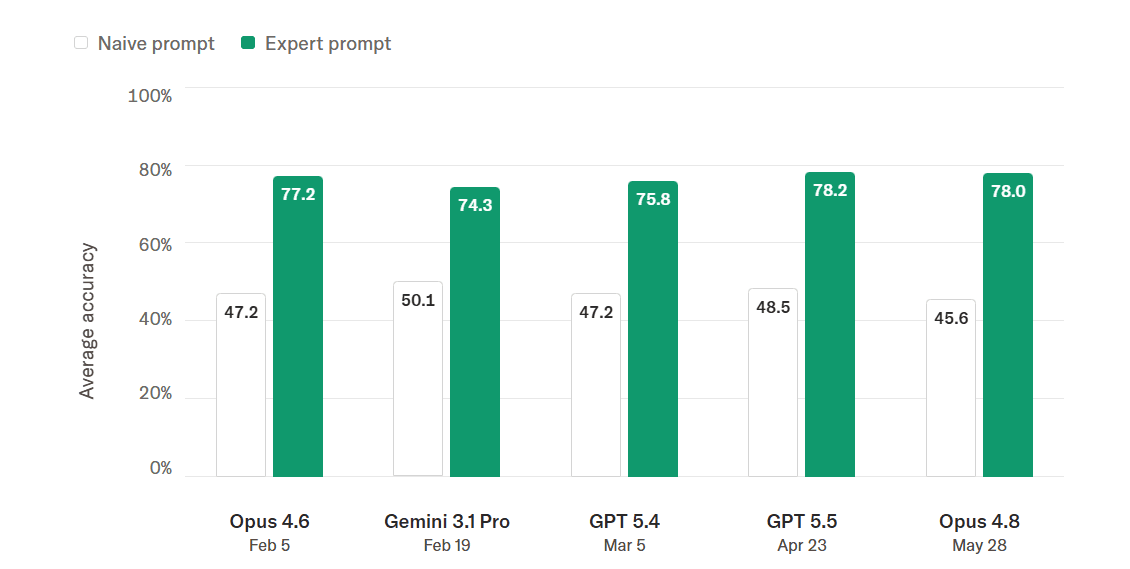
รายงานยังชี้ให้เห็นว่า โมเดลรุ่นใหม่กว่าแทบจะไม่มีการพัฒนาที่คุ้มค่ากับราคาที่จ่ายไป โดย GPT 4o มีราคาแพงกว่ารุ่นก่อนหน้าถึง 43% แต่กลับมีความแม่นยำเพิ่มขึ้นเพียงเล็กน้อยเท่านั้น
มูลค่าที่แท้จริงอยู่ในหัวของผู้ลงทุน
กุญแจสำคัญคือการ fine-tuning ซึ่งเป็นการนำโมเดล open-weight มาฝึกฝนใหม่ด้วยข้อมูลเฉพาะของบริษัท โดยใช้ “วิจารณญาณ” ของนักลงทุนจาก Bridgewater เป็นส่วนผสมหลัก ในช่วงแรกมีการจ้างคนภายนอกราคาถูกเพื่อระบุป้ายกำกับ (label) เอกสาร แต่พบข้อผิดพลาดจำนวนมาก เพื่อให้นักลงทุนระดับผู้เชี่ยวชาญไม่ต้องลงมาตรวจสอบทุกแผ่นด้วยตัวเอง นักวิจัยจึงใช้วิธีให้โมเดลแรกเรียนรู้จากป้ายกำกับที่มีข้อบกพร่องนั้น แล้วนำมาประเมินเอกสารชุดเดิมซ้ำ จุดใดที่โมเดลและป้ายกำกับเดิมมีความเห็นขัดแย้งกัน จุดนั้นมีแนวโน้มที่จะผิดพลาด และจะถูกส่งไปให้มนุษย์ที่เป็นผู้เชี่ยวชาญตัวจริงแก้ไขเท่านั้น
การฝึกฝนนี้ทำบน Tinker platform ของ Thinking Machines Lab ซึ่งพัฒนาขึ้นบนฐานโมเดลเปิด Qwen3-235B จากการประเมินเบื้องต้นพบว่าโมเดลที่ผ่านการ fine-tune มีความแม่นยำสูงถึง 84.7% เมื่อเทียบกับ 78.2% ของโมเดลที่ดีที่สุดในกลุ่ม Frontier นอกจากนี้ยังมีค่าใช้จ่ายในการใช้งานถูกกว่าเกือบ 14 เท่า อย่างไรก็ตาม ข้อมูลนี้เป็นการทดสอบภายใน ซึ่งทั้งสองบริษัทต่างมีส่วนได้เสียในการจำหน่ายผลิตภัณฑ์ของตน
ถึงกระนั้น สิ่งที่น่าสนใจยิ่งกว่าตัวเลขคือการพิสูจน์ให้เห็นว่า ห้องแล็บยักษ์ใหญ่อย่าง OpenAI ยังไม่ได้รับข้อมูลทั้งหมดที่มีอยู่ในโลก ข้อมูลกรรมสิทธิ์และองค์ความรู้เฉพาะทางของมนุษย์ที่ยังไม่เคยถูกนำมาฝึกฝนมีอยู่อีกมหาศาล และเป็นสิ่งที่พัฒนาต่อยอดได้จริง โดยเฉพาะในกรณีที่บริษัทต้องการเก็บข้อมูลที่มีค่าที่สุดไว้เป็นส่วนตัว เพราะใครก็ตามที่ส่งข้อมูลลับให้ห้องแล็บภายนอก ย่อมเสี่ยงที่จะต้องเผชิญกับการแข่งขันจากผลิตภัณฑ์ที่สร้างขึ้นโดยใช้ข้อมูลของตนเองเป็นฐาน
การใช้เครื่องมืออย่าง Tinker เพื่อ fine-tune โมเดลแบบเปิด ช่วยให้บริษัทต่างๆ มีทางเลือกอิสระ พวกเขาสามารถเป็นเจ้าของน้ำหนักโมเดล (weights) ข้อมูล และอาจรวมถึงการบริหารจัดการ GPU ด้วยตัวเอง ทั้งหมดนี้ขึ้นอยู่กับการวางระบบของแต่ละองค์กร
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร