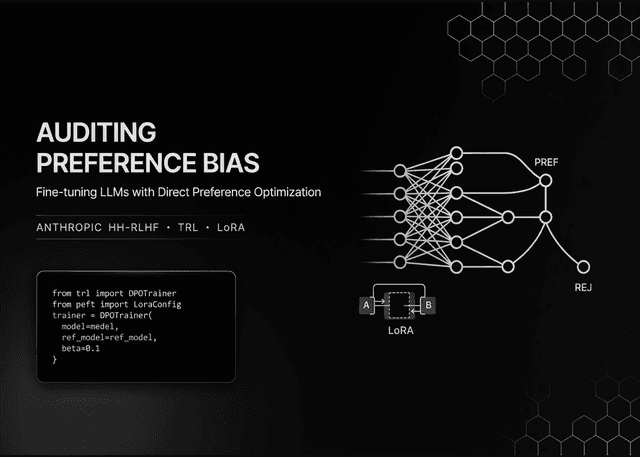
เจาะลึกการตรวจสอบอคติและ Fine-Tuning โมเดลภาษาด้วย DPO ผ่านเฟรมเวิร์ก TRL และ LoRAtag: Anthropic, DPO, Fine-tuning, LoRA, Qwen, TRLAug 20, 2026 · By: AttapolKแนวทางการทำ Fine-tuning โมเดลภาษาด้วยเทคนิค Direct Preference Optimization (DPO) พร้อมระบบตรวจสอบอคติทางโครงสร้างและความยาวในชุดข้อมูล Anthropic HH-RLHF เพื่อป้องกันโมเดลเรียนรู้จากทางลัดทางคำศัพท์
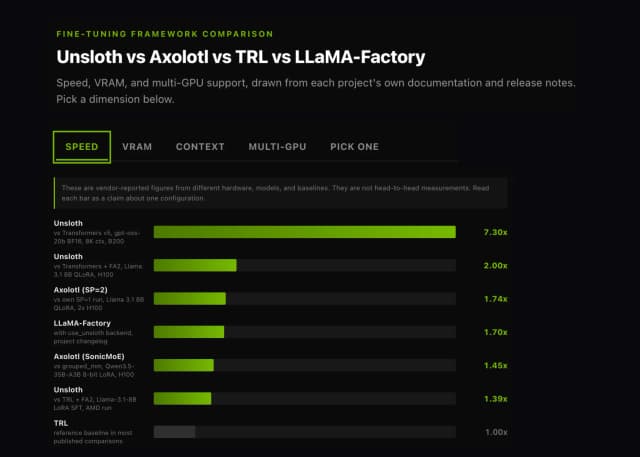
เปรียบเทียบ 4 สุดยอด Framework สำหรับ Fine-Tuning LLM: เลือกตัวไหนให้เร็ว แรง และประหยัด VRAMtag: Axolotl, Fine-tuning, LLaMA-Factory, LLM, TRL, UnslothJul 23, 2026 · By: AttapolKเจาะลึกความต่างระหว่าง Unsloth, Axolotl, TRL และ LLaMA-Factory สี่โครงการโอเพนซอร์สชั้นนำสำหรับการปรับแต่งโมเดลภาษาขนาดใหญ่ที่วิศวกร AI ต้องรู้จัก