
เปรียบเทียบ 4 สุดยอด Framework สำหรับ Fine-Tuning LLM: เลือกตัวไหนให้เร็ว แรง และประหยัด VRAM
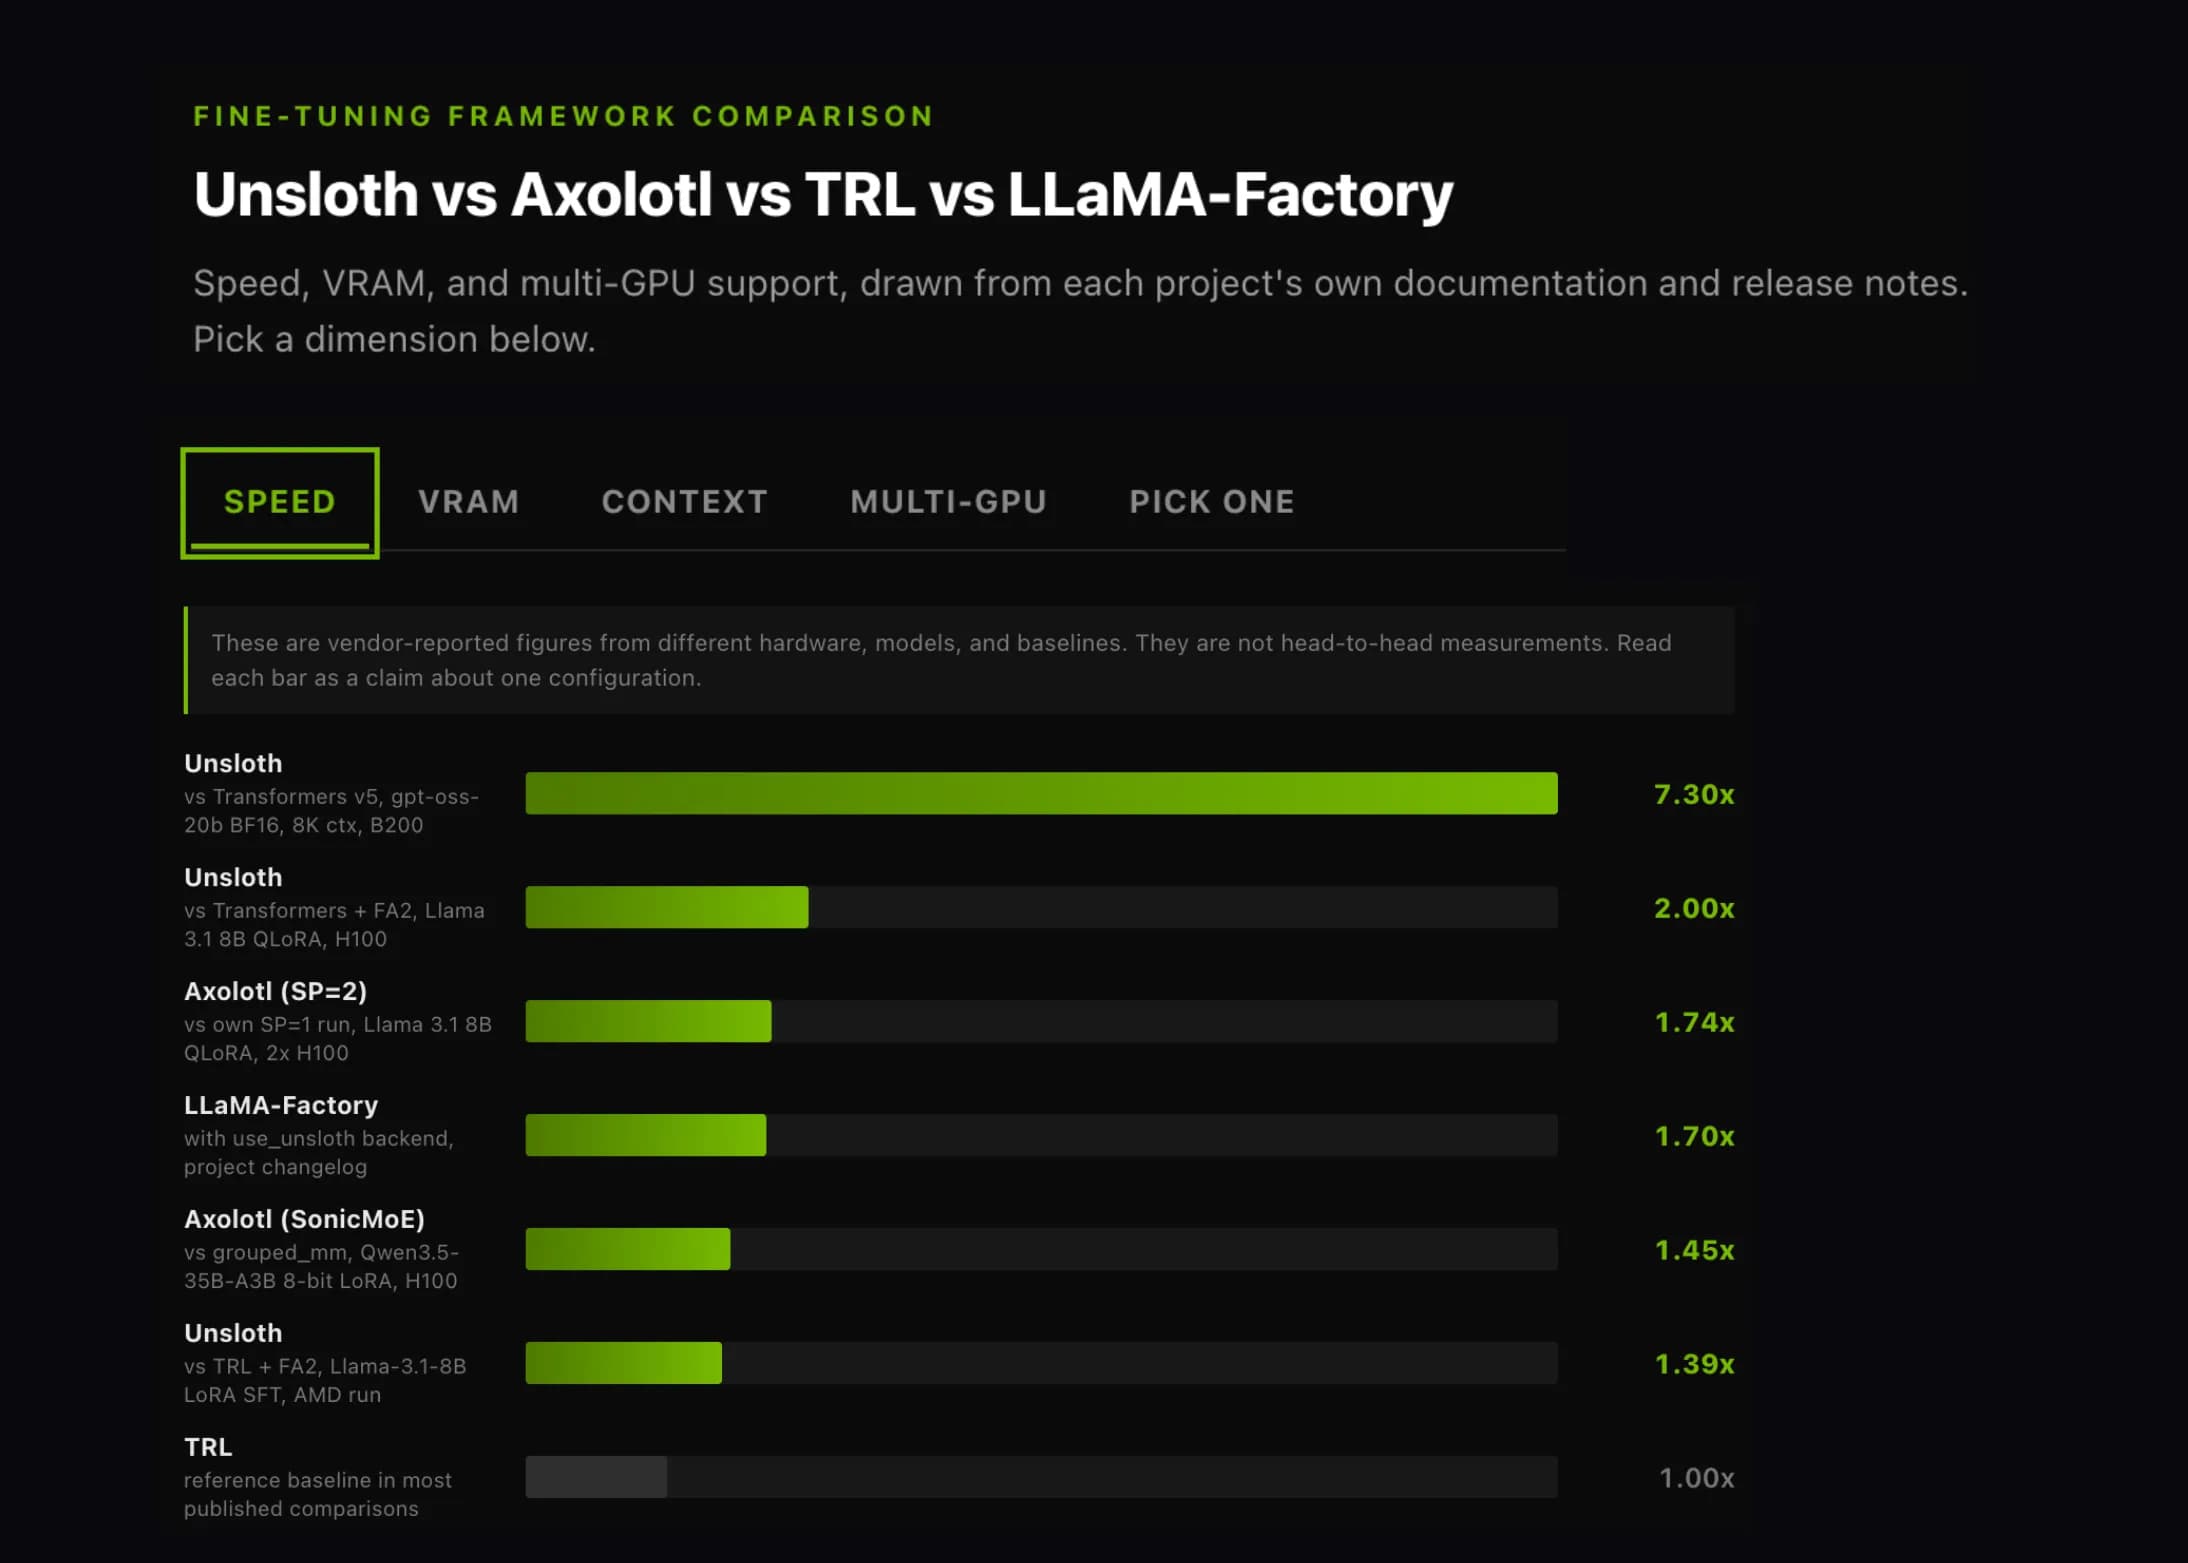
ปัจจุบันมีโครงการโอเพนซอร์ส 4 โครงการที่ครองตลาดการ Fine-tuning โมเดล LLM ได้แก่ Unsloth, Axolotl, TRL และ LLaMA-Factory โดยทั้งหมดพัฒนาอยู่บนพื้นฐานของ PyTorch และ Hugging Face เหมือนกัน แต่มีความโดดเด่นในด้านวิศวกรรมที่แตกต่างกันอย่างชัดเจน
Unsloth เน้นการเขียน Kernel ใหม่เพื่อประสิทธิภาพสูงสุด ขณะที่ Axolotl รวบรวมกลยุทธ์การประมวลผลแบบขนาน (Parallelism) ไว้ด้วยกัน ส่วน TRL ทำหน้าที่กำหนดมาตรฐาน Trainer APIs ที่ผู้อื่นนำไปต่อยอด และ LLaMA-Factory มุ่งเน้นความครอบคลุมของโมเดลที่หลากหลายพร้อมการใช้งานแบบไม่ต้องเขียนโค้ด (Zero-code)
การเปรียบเทียบในครั้งนี้จะพิจารณาจาก 3 ปัจจัยหลักที่วิศวกรใช้งานจริง ได้แก่ ความเร็วในการฝึก (Throughput), การใช้หน่วยความจำวิดีโอสูงสุด (VRAM) และความสามารถในการขยายขีดความสามารถแบบหลาย GPU (Multi-GPU)
ทำความเข้าใจแต่ละ Framework
TRL เปรียบเสมือนเลเยอร์อ้างอิงสำหรับการเรียนรู้ที่ใช้ชุดฟังก์ชันอย่าง SFTTrainer, DPOTrainer และอื่นๆ ซึ่งทั้ง Axolotl และ LLaMA-Factory ต่างเรียกใช้งานฟังก์ชันเหล่านี้ โดยในปัจจุบันคือเวอร์ชัน v1.8.0
Unsloth แตกต่างด้วยการแทนที่โค้ดส่วนประกอบของโมเดลด้วย Triton Kernels ที่เขียนขึ้นด้วยมือ และใช้การคำนวณ Backpropagation เองแทนการใช้ autograd-generated ซึ่ง บทความจาก Hugging Face เอง ยืนยันว่าให้ความแม่นยำเท่าเดิม 100% เมื่อเทียบกับ QLoRA มาตรฐาน
Axolotl ทำหน้าที่เป็น Wrapper ที่ควบคุมผ่านไฟล์ YAML ครอบทับชุดเครื่องมือต่างๆ เช่น Transformers และ PEFT โดยจุดเด่นอยู่ที่การบริหารจัดการกลยุทธ์การประมวลผลแบบขนานเป็นหลัก ส่วน LLaMA-Factory ซึ่งเป็น บทความนำเสนอระบบ ACL 2024 มาพร้อม UI ชื่อ LlamaBoard ที่รองรับโมเดลกว่า 100 รุ่น
ความเร็ว
Unsloth: การเพิ่มประสิทธิภาพระดับ kernel บน GPU ตัวเดียว
ผลทดสอบที่เผยแพร่ ระบุว่า Unsloth ช่วยให้การฝึกโมเดล Llama 3.1 8B และ 70B เร็วขึ้นถึง 2 เท่า โดยเฉพาะในโมเดลแบบ MoE (Mixture of Experts) ที่ทำความเร็วได้เหนือกว่า Transformers v5 ถึง 7.3 เท่าในบางกรณี เนื่องจากมีการใช้ Flex Attention และ MoE kernels ที่ปรับแต่งมาโดยเฉพาะ
อย่างไรก็ตาม ประสิทธิภาพนี้ยังขึ้นอยู่กับรุ่นของโมเดลและฮาร์ดแวร์ เช่น Qwen3-30B-A3B บน B200 อาจให้ความเร็วเพิ่มขึ้นไม่มากนัก แต่ช่วยประหยัดหน่วยความจำได้ถึง 15% ขณะที่การรันบน H100 หรือ RTX PRO 6000 ยังคงให้ผลลัพธ์ที่น่าประทับใจมากกว่า 1.7 เท่าขึ้นไป
Axolotl: ยืมใช้งาน kernel มาพร้อมระบบขนานในตัว
Axolotl ได้เพิ่ม custom Triton kernels และฟังก์ชัน autograd สำหรับ LoRA เมื่อต้นเดือนกุมภาพันธ์ 2025 โดยได้รับแรงบันดาลใจจาก Unsloth ซึ่งผู้ใช้สามารถเลือกเปิดใช้งานผ่านการตั้งค่าในระบบได้ทันที
บันทึกการอัปเดต ล่าสุดระบุว่าการรองรับ SonicMoE LoRA ช่วยเพิ่มความเร็วได้สูงสุด 1.45 เท่า และลดการใช้หน่วยความจำลง 30% นอกจากนี้ยังรองรับเทคโนโลยีล้ำสมัยอื่นๆ เช่น FlashAttention 2/3/4 และ Liger Kernel
TRL และ LLaMA-Factory: มาตรฐานและความอเนกประสงค์
TRL มักถูกใช้เป็นจุดอ้างอิงมาตรฐาน โดยเน้นการจัดหาเครื่องมือควบคุมความเร็วและหน่วยความจำที่หลากหลาย เช่น packing และ padding-free batching นอกจากนี้ TRL ยังมี การเชื่อมต่อกับ Unsloth โดยตรง ทำให้ทั้งคู่สามารถทำงานร่วมกันได้
ด้าน LLaMA-Factory จะเน้นการดึงความสามารถจากงานของผู้อื่นมาใช้งาน เช่น การเปิด use_unsloth: true เพื่อเพิ่มความเร็วได้ถึง 170% รวมถึงการเปิดใช้งาน Liger Kernel และ FlashAttention-2 ได้ง่ายๆ ผ่านการตั้งค่า config
VRAM
รายงานความต้องการหน่วยความจำขั้นต่ำ
Unsloth ระบุความต้องการ VRAM สำหรับ 4-bit QLoRA ของโมเดล 8B ไว้ที่ 6 GB และ 41 GB สำหรับ 70B ส่วน LLaMA-Factory ก็ให้ตัวเลขที่ใกล้เคียงกัน แต่ต้องอย่าลืมว่า batch size และ context length จะเป็นปัจจัยสำคัญที่ทำให้ความต้องการ VRAM เพิ่มสูงขึ้น
Context length คือจุดต่างที่ชัดเจนกว่า
ความโดดเด่นของ Unsloth อยู่ที่การรองรับ context length ที่ยาวกว่ามาตรฐานมาก ตัวอย่างเช่นบน GPU 24 GB Unsloth สามารถรับได้ถึง 78,475 tokens ในขณะที่ Transformers + FA2 รับได้เพียง 5,789 tokens เท่านั้น ซึ่งเกิดจากการรวมอัลกอริทึม gradient checkpointing เข้ากับ Cut Cross Entropy
| GPU VRAM | Unsloth context | Transformers + FA2 context |
|---|---|---|
| 8 GB | 2,972 | OOM (หน่วยความจำเต็ม) |
| 16 GB | 40,724 | 2,551 |
| 24 GB | 78,475 | 5,789 |
| 48 GB | 191,728 | 15,502 |
| 80 GB | 342,733 | 28,454 |
สำหรับการฝึก MoE นั้น Unsloth ใช้เทคนิค split-LoRA เพื่อเลี่ยงการสร้างค่าประมวลผลมหาศาล ขณะที่ Axolotl ใช้ MoE expert quantization เพื่อลดขนาดน้ำหนักโมเดลขณะโหลด ซึ่งช่วยลดหน่วยความจำสำรองจาก 127 GiB เหลือเพียง 23 GiB ได้ในบางรุ่น
Multi-GPU
ในด้านการทำงานแบบหลาย GPU อันดับจะเปลี่ยนไปทันที โดย Unsloth ที่เคยนำในด้าน GPU เดี่ยวจะเสียเปรียบในจุดนี้
Axolotl: ความลึกของระบบขนาน
Axolotl มี คู่มือ multi-GPU ที่รองรับกลยุทธ์การแบ่งส่วนข้อมูล (sharding) ที่หลากหลายที่สุด ทั้ง DeepSpeed ZeRO 1-3 และ FSDP2 นอกจากนี้ยังสามารถทำ N-D Parallelism ที่รวบรวมงานขนานทั้งด้าน data, tensor, context และ expert เข้าด้วยกันได้
TRL และ LLaMA-Factory: ทางเลือกสำหรับระดับองค์กร
TRL แบ่งการฝึกแบบกระจายออกเป็น Context Parallelism (Ring Attention บน FSDP2) และ Sequence Parallelism (ALST/Ulysses บน DeepSpeed) ซึ่งเหมาะสำหรับการฝึกที่มี sequence ยาวระดับหลายแสนถึงล้าน tokens
LLaMA-Factory รองรับการกระจายงานมาตรฐานครบถ้วน และเพิ่มความสามารถในการฝึกแบบ Megatron-core ผ่าน mcore_adapter ในปี 2025 ช่วยให้การ Fine-tune โมเดล 70B บน GPU 24 GB สองตัวกลายเป็นเรื่องที่เป็นไปได้ด้วยวิธี FSDP+QLoRA
Unsloth: ช่องว่างที่รอยกเครื่อง
แม้ เอกสาร multi-GPU ของ Unsloth จะระบุว่าทำงานร่วมกับ Accelerate และ DeepSpeed ได้ แต่การตั้งค่ายังค่อนข้างซับซ้อนและต้องใช้การปรับจูนด้วยมือเป็นหลัก โดยยังไม่มีเมทริกซ์การทำงานขนานที่ปรับแต่งได้ละเอียดเท่าคู่แข่ง
สรุปการเลือกใช้งาน
- Unsloth: เหมาะสำหรับ GPU ตัวเดียว เน้นความเร็วและต้องการ context length ยาวๆ
- Axolotl: ตัวเลือกที่ดีที่สุดสำหรับ 2-8 GPU และการทำ Full fine-tuning หรือ RLHF
- TRL: เหมาะสำหรับนักพัฒนาที่ต้องการเขียนลูปการฝึกเองหรือสร้างอัลกอริทึมใหม่ๆ
- LLaMA-Factory: ดีที่สุดสำหรับผู้ที่ต้องการความรวดเร็ว รองรับโมเดลเยอะ และเน้นใช้งานผ่าน UI
Asif Razzaq ซีอีโอของ Marktechpost Media Inc. และวิศวกรรุ่นใหม่ มุ่งหวังที่จะถ่ายทอดความรู้ด้าน Machine Learning และ AI ผ่านแพลตฟอร์มที่เข้าถึงง่าย ซึ่งปัจจุบันมียอดผู้เข้าชมกว่า 2 ล้านครั้งต่อเดือน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร