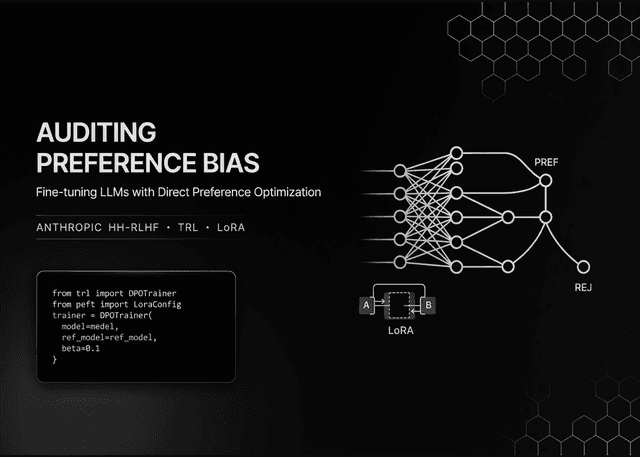
เจาะลึกการตรวจสอบอคติและ Fine-Tuning โมเดลภาษาด้วย DPO ผ่านเฟรมเวิร์ก TRL และ LoRAtag: Anthropic, DPO, Fine-tuning, LoRA, Qwen, TRLAug 20, 2026 · By: AttapolKแนวทางการทำ Fine-tuning โมเดลภาษาด้วยเทคนิค Direct Preference Optimization (DPO) พร้อมระบบตรวจสอบอคติทางโครงสร้างและความยาวในชุดข้อมูล Anthropic HH-RLHF เพื่อป้องกันโมเดลเรียนรู้จากทางลัดทางคำศัพท์
ทำไม DharmaOCR ถึงยังครองแชมป์ภาษาโปรตุเกส แม้คู่แข่งจะออกโมเดลใหม่กว่า?tag: DharmaOCR, DPO, Mistral OCR4, OCR, Portuguese, Unlimited-OCRJul 17, 2026 · By: AttapolKDharmaOCR พิสูจน์ให้เห็นว่าความเชี่ยวชาญเฉพาะด้านและการฝึกฝนแบบ DPO ช่วยให้มีประสิทธิภาพเหนือกว่าโมเดลภาษาขนาดใหญ่รุ่นใหม่อย่าง Mistral OCR4 และ Unlimited-OCR ในการประมวลผลเอกสารภาษาโปรตุเกสแบบบราซิล