
ทำไม DharmaOCR ถึงยังครองแชมป์ภาษาโปรตุเกส แม้คู่แข่งจะออกโมเดลใหม่กว่า?
แม้จะมีสถาปัตยกรรมใหม่กว่า แต่ DharmaOCR ก็มีประสิทธิภาพเหนือกว่า Mistral OCR4 และ Unlimited-OCR ในภาษาโปรตุเกสแบบบราซิล ด้วยความเชี่ยวชาญเฉพาะด้านและการฝึกฝนที่ตรงเป้าหมาย บทความนี้จะนำเสนอหลักฐานและกลไกเบื้องหลังความได้เปรียบนั้น
เมื่อสามเดือนที่แล้ว เราได้เผยแพร่ paper on DharmaOCR และ open-sourced one of the models โดยมีเป้าหมายที่ชัดเจนคือ การพัฒนาระบบอ่านอักขระด้วยแสง (OCR) ที่ออกแบบมาเพื่อภาษาโปรตุเกสแบบบราซิลโดยเฉพาะ
กระบวนการฝึกฝนถูกแบ่งออกเป็นสองขั้นตอน ขั้นตอนแรกคือการปรับจูนแบบมีผู้สอน (supervised fine-tuning) โดยใช้ชุดข้อมูลภาษาโปรตุเกสจำนวนมากจากหลากหลายแหล่งและระดับความซับซ้อน เพื่อปรับค่าน้ำหนักของโมเดลให้เข้ากับคำศัพท์ ไวยากรณ์ และโครงสร้างเอกสารเฉพาะทาง ซึ่งเป็นการมุ่งเน้นศักยภาพของโมเดลไปที่ภาษาเดียวแทนที่จะกระจายทรัพยากรไปยังหลายภาษา ขั้นตอนที่สองคือการนำ Direct Preference Optimization (DPO) มาประยุกต์ใช้ แทนที่จะฝึกแค่การถอดความให้ถูกต้องเพียงอย่างเดียว โมเดลจะได้เรียนรู้จากข้อมูลความพึงพอใจเชิงเปรียบเทียบ เพื่อเลือกผลลัพธ์ที่ดีที่สุดในระหว่างการประมวลผล (inference) ขั้นตอนนี้ช่วยแก้ปัญหาเรื่องความเสถียร โดยการยับยั้งความผิดพลาดประเภทการสร้างข้อความซ้ำซากหรือไม่ต่อเนื่อง ซึ่งช่วยลดทั้งเวลาและต้นทุนในการใช้งานจริงอย่างมีนัยสำคัญ
ผลลัพธ์ที่ได้คือโมเดลที่มีคุณภาพการดึงข้อมูลสูงสุดและมีอัตราความผิดพลาดต่ำสุดในชุดทดสอบมาตรฐาน (benchmark) ของภาษาโปรตุเกส ทั้งนี้ขั้นตอน fine-tuning ช่วยสร้างความเชี่ยวชาญในโดเมนหลัก ขณะที่ DPO ช่วยรักษาความแม่นยำนั้นไว้แม้ในสภาวะที่โมเดลทั่วไปมักจะล้มเหลว
แม้เทคโนโลยีโมเดล OCR จะพัฒนาไปอย่างรวดเร็ว แต่โจทย์ตั้งต้นของ DharmaOCR ในด้านคุณภาพการดึงข้อมูลจากเอกสารซับซ้อนและความเสถียรนั้นยังคงเป็นหัวใจสำคัญ และยิ่งทวีความชัดเจนมากขึ้นเมื่ออุตสาหกรรมเปลี่ยนผ่านไปสู่ยุคใหม่
การแพร่หลายของ multimodal generative models ทำให้ OCR ที่ใช้พื้นฐานจาก language model เข้าถึงได้ง่ายขึ้น แต่เทคโนโลยีนี้ยังคงทำงานบนพื้นฐานของความน่าจะเป็น (probabilistic) ซึ่งย่อมมีข้อผิดพลาดแฝงอยู่ สิ่งที่แบ่งแยกประสิทธิภาพของแต่ละโมเดลคือจำนวนและประเภทของข้อผิดพลาด ซึ่งกำหนดโดยโครงสร้าง (architecture) และวิธีการฝึกฝนค่า parameter
Architecture และจำนวน parameter คือตัวกำหนดเพดานการเรียนรู้ ส่วนการฝึกฝนคือตัวกำหนดว่าจะจัดสรรขีดความสามารถนั้นอย่างไร
ความแตกต่างนี้ทำให้ "ความเชี่ยวชาญเฉพาะด้าน" (specialization) กลายเป็นเรื่องของโครงสร้างมากกว่าแค่ความชอบส่วนตัว เมื่อโมเดลถูกฝึกในโดเมนที่จำกัด เช่น ภาษาเดียวหรือประเภทเอกสารเฉพาะ parameter ทั้งหมดจะถูกทุ่มเทให้กับงานนั้น ขณะที่โมเดลหลายภาษา (multilingual) ต้องกระจาย parameter ชุดเดียวกันไปยังหลายโดเมน ตามหลักการ neuron superposition แม้ parameter หนึ่งตัวจะประมวลผลได้หลายอย่าง แต่การแบ่งทรัพยากรย่อมส่งผลกระทบต่อประสิทธิภาพอย่างหลีกเลี่ยงไม่ได้ โมเดลที่ครอบคลุมกว้างกว่าจึงมักให้ความสำคัญกับรายละเอียดเฉพาะจุดได้น้อยลง
DharmaOCR เลือกยอมรับข้อจำกัดนี้ในทิศทางตรงกันข้าม โดยไม่ได้พยายามจะเป็นตัวเลือกที่ดีที่สุดสำหรับทุกภาษา แต่ทุ่ม parameter ทุกตัวไปที่คำศัพท์และรูปแบบอักขระของภาษาโปรตุเกสแบบบราซิล ซึ่งเป็นการใช้ทรัพยากรที่ตรงเป้าหมายที่สุด
ความเข้มข้นเชิงโครงสร้างนี้เองคือรากฐานความได้เปรียบเหนือโมเดลทั่วไป ความสำเร็จนี้ไม่ได้ขึนอยู่กับ architecture ที่ใหญ่กว่าหรือเทคนิคที่ซับซ้อนกว่าคู่แข่ง แต่อยู่ที่ว่าทรัพยากรเหล่านั้นถูกนำไปใช้ที่จุดใด
สามเดือนผ่านไป มีโมเดลใหม่ๆ ที่มีความสามารถสูงขึ้นปรากฏตัวขึ้น คำถามคือความเชี่ยวชาญเฉพาะด้านยังคงให้ผลลัพธ์ที่เหนือกว่าอยู่หรือไม่?
หลังการเปิดตัว DharmaOCR ได้ไม่นาน มีโมเดล OCR ใหม่สองรุ่นที่น่าสนใจคือ Mistral OCR4 และ Unlimited-OCR ทั้งคู่ถือเป็นความก้าวหน้าทางเทคนิคที่แท้จริง ทั้งในด้านวิธีการฝึกและชุดข้อมูลที่แข็งแกร่งในหลายภาษา
อย่างไรก็ตาม เมื่อทดสอบด้วย benchmark ของ DharmaOCR สำหรับภาษาโปรตุเกสโดยเฉพาะ ผลลัพธ์กลับชัดเจนดังนี้:
- DharmaOCR ทำได้ 0.925
- Mistral OCR4 ทำได้ 0.798
- Unlimited-OCR ทำได้ 0.7587
ส่วนต่างนี้มีนัยสำคัญมาก โดย Mistral OCR4 ตามหลังอยู่ 13 จุด และ Unlimited-OCR ตามหลังกว่า 16 จุด แม้ทั้งสองจะเป็นโมเดลที่ออกทีหลังและมีทรัพยากรการวิจัยมหาศาล แต่ความจดจ่อเฉพาะจุดของ DharmaOCR ก็ยังคงสร้างความได้เปรียบที่วัดผลได้จริง
Benchmark เป็นเพียงจุดเริ่มต้น แต่ในเชิงปฏิบัติเราจะเห็นภาพชัดขึ้นว่าทำไมช่องว่างนี้จึงเกิดขึ้น
การประมวลผลเอกสารภาษาโปรตุเกสที่มีความเฉพาะตัว เช่น เรียงความสอบ ENEM ของบราซิล เผยให้เห็นจุดอ่อนของโมเดลหลายภาษา เอกสารเหล่านี้มีทั้งลายมือและบริบททางวัฒนธรรมที่เฉพาะตัว ซึ่งเป็นจุดที่การฝึกฝนเฉพาะทางให้ผลลัพธ์ที่ดีกว่าชัดเจน
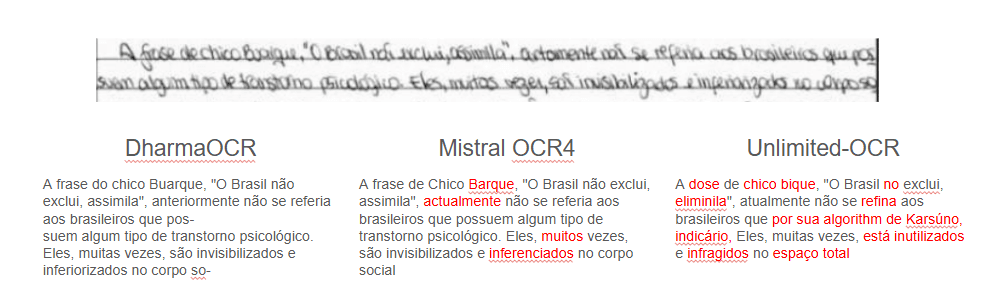
Figure 1: ENEM essay manuscript used in benchmark evaluation with outputs of the each model. Misreads marked in red.
Mistral OCR4 ถอดความชื่อ Chico Buarque (ศิลปินชื่อดังของบราซิล) ผิดเป็น "Chico Barque" ส่วน Unlimited-OCR ผิดเป็น "chico bique" และเมื่อเจอประโยค "O Brasil não exclui, assimila" ที่เป็นคำคมในเอกสาร Unlimited-OCR ถึงกับให้ผลลัพธ์ที่อ่านไม่รู้เรื่อง
ข้อผิดพลาดเหล่านี้ไม่ใช่เรื่องบังเอิญ แต่มันคือการวินิจฉัยว่าการฝึกฝนเข้าไม่ถึงคำศัพท์และชื่อเฉพาะที่แยกภาษาโปรตุเกสแบบบราซิลออกจากคลังข้อมูลทั่วไป ในขณะที่ DharmaOCR จัดการกรณีเหล่านี้ได้อย่างถูกต้อง เพราะทรัพยากรของโมเดลถูกใช้ไปกับการทำความเข้าใจข้อมูลเฉพาะถิ่นอย่างเต็มที่
ตัวอย่างเหล่านี้ยืนยันว่าช่องว่างใน benchmark ไม่ได้เกิดจากความสามารถทั่วไป แต่เกิดจากการขาดความเข้าใจเฉพาะภาษา
นอกจากความแม่นยำแล้ว "ความเสถียร" ภายใต้ข้อจำกัดทางสายตา เช่น ตัวอักษรจางหรือลายมือหวัด ก็เป็นสิ่งสำคัญ เมื่อ generative model เจอสัญญาณภาพที่คลุมเครือ โมเดลที่มีพื้นฐานการทำนายโทเค็นถัดไป (next-token prediction) มักจะสร้างข้อมูลขึ้นมาเองตามความคุ้นเคยเดิม แทนที่จะดึงข้อมูลจากต้นฉบับ นำไปสู่ปัญหา "การเสื่อมโทรมของข้อความ" (text degeneration) ที่ผลลัพธ์จะซ้ำซากและไม่ต่อเนื่อง
เมื่อทดสอบกับเอกสารตัวอักษรเล็ก Mistral OCR4 กลับสร้างข้อความที่ไม่เกี่ยวข้องกับต้นฉบับเลย
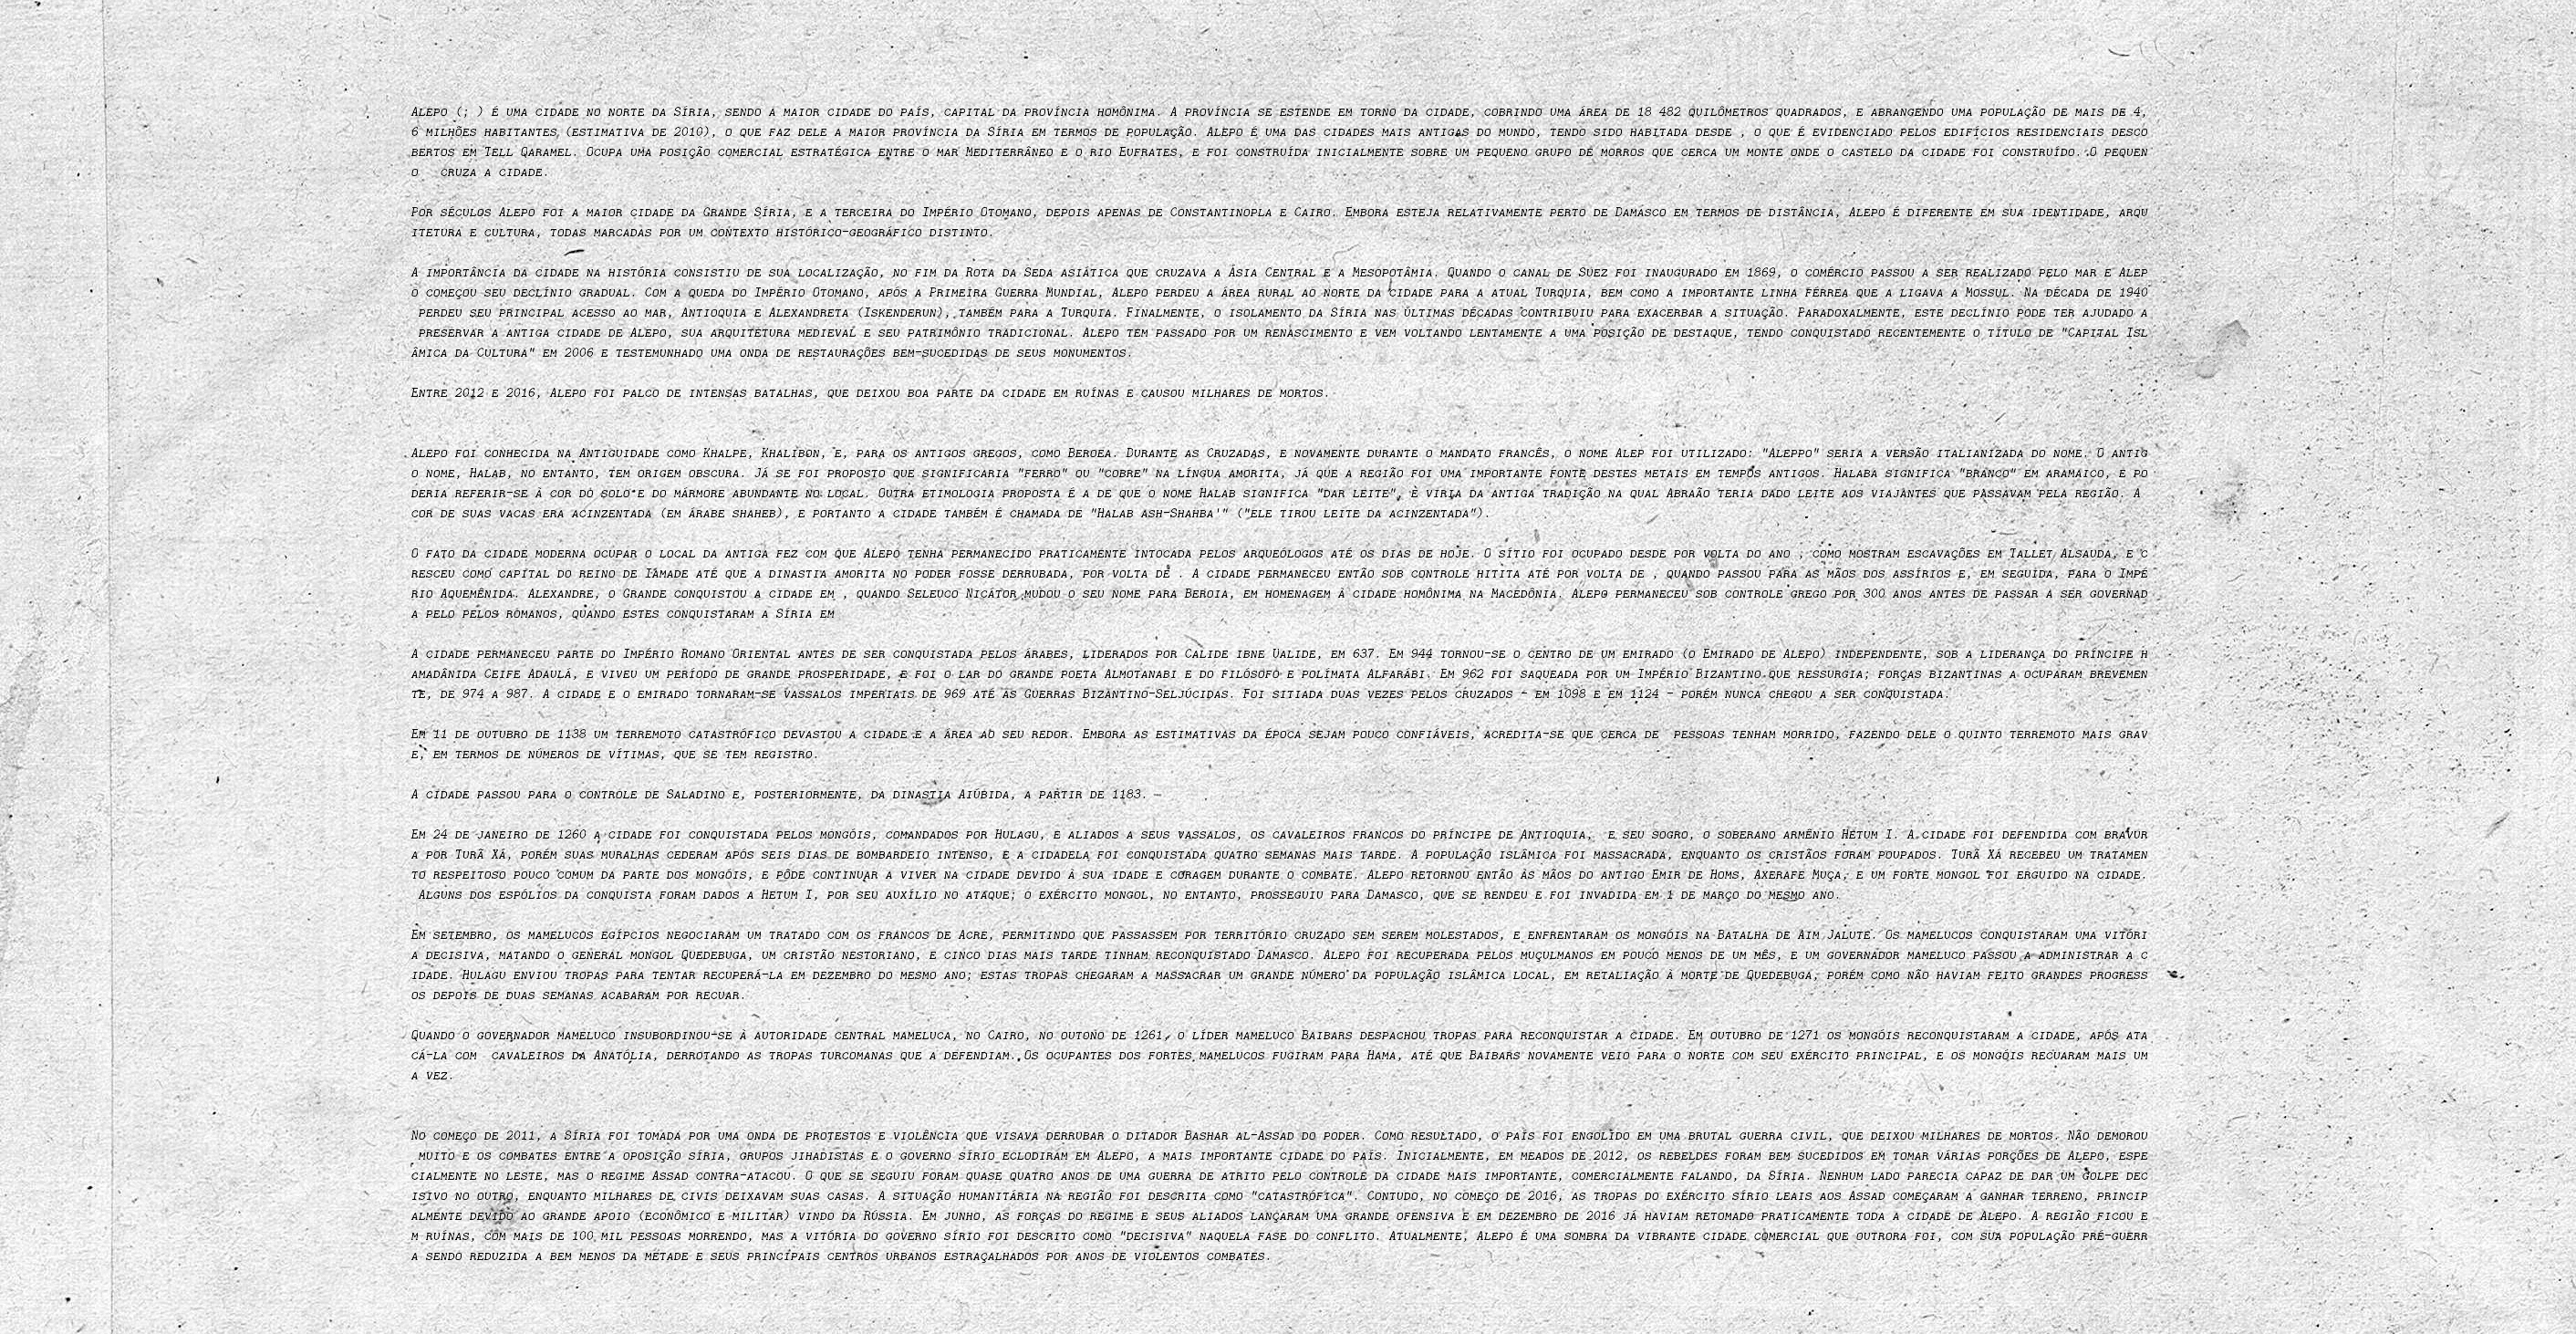
Figure 2: small-font document
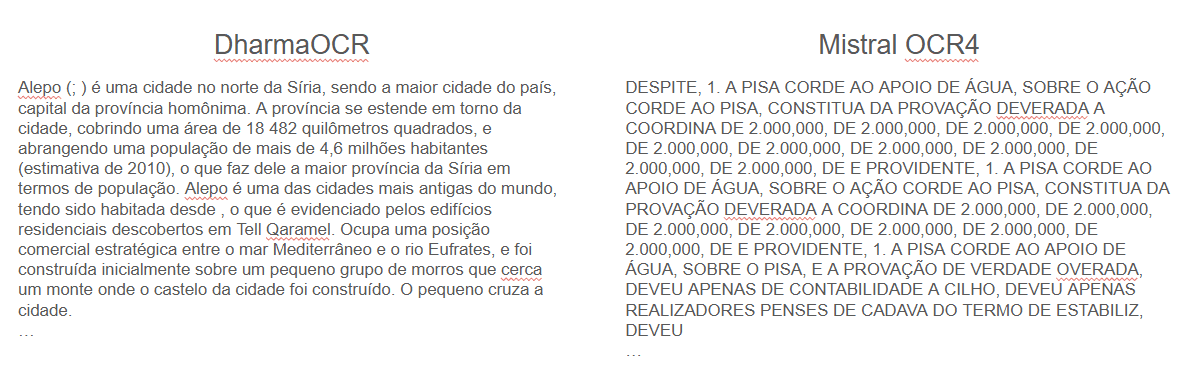
Figure 3: DharmaOCR output and Mistral OCR4 degenerated output
นี่ไม่ใช่แค่การถอดความผิดพลาด แต่เป็นความล้มเหลวเชิงโครงสร้างที่ทำให้ข้อมูลใช้งานไม่ได้ในกระบวนการถัดไป (downstream processes) เช่น การจัดประเภทเอกสารหรือการทำเวิร์กโฟลว์อัตโนมัติ
Mistral OCR4 และ Unlimited-OCR แม้จะเป็นโมเดลที่ดี แต่ยังมีปัญหาเรื่องการจัดการสภาวะล้มเหลวในโดเมนเฉพาะนี้ แล้ววิถีการฝึกฝนที่ถูกต้องควรเป็นอย่างไร?
คำตอบของ DharmaOCR คือขั้นตอน DPO
ในขณะที่ SFT ฝึกให้โมเดลทำนายโทเค็นถัดไป ซึ่งเสี่ยงต่อการเกิดความผิดพลาดแบบลูปลำดับในกรณีที่เริ่มต้นผิด DPO จะฝึกกับสัญญาณที่ต่างออกไป โดยมองที่คุณภาพของผลลัพธ์โดยรวม เพื่อสอนให้โมเดลแยกแยะผลลัพธ์ที่ดึงข้อมูลได้ต่อเนื่องและถูกต้องสมบูรณ์ ผลที่ได้คือความเสถียรที่มากขึ้น แม้ในเอกสารที่ยากและซับซ้อน โมเดลก็มีโอกาสหลุดออกนอกลู่นอกทางน้อยลง
สิ่งนี้พิสูจน์ได้จาก benchmark ที่แสดงให้อัตราการเสื่อมโทรมของข้อความต่ำกว่าอย่างเห็นได้ชัด
อย่างไรก็ตาม Benchmark ในวันนี้ไม่ได้การันตีถึงอนาคตในอีกสองปีข้างหน้า
มีความเป็นไปได้สูงที่โมเดลทั่วไปในอนาคตจะก้าวข้ามประสิทธิภาพของ DharmaOCR รุ่นปัจจุบัน ด้วย architecture และชุดข้อมูลที่ใหญ่ขึ้น ซึ่งถือเป็นเรื่องที่ดีต่อวงการ
แต่สิ่งที่ไม่เปลี่ยนคือ "ตรรกะเชิงโครงสร้าง" ทรัพยากรที่มีจำกัดจะแสดงผลได้ดีที่สุดเมื่อมุ่งเน้นไปยังจุดเดียว ระบบเฉพาะทาง (specialist) ย่อมดึงศักยภาพได้มากกว่าระบบทั่วไป (generalist) ในโดเมนเดียวกันเสมอ ความสัมพันธ์นี้จะยังคงอยู่ไม่ว่าโลก AI จะพัฒนาไปเพียงใด ดังที่ได้กล่าวไว้ในเรื่อง Why Specialization Is Inevitable
เป้าหมายของ Dharma ไม่ใช่การปกป้องอันดับหนึ่งตลอดกาล แต่คือการนำเทคโนโลยีล่าสุดมาปรับใช้เพื่อเป้าหมายเดิม นั่นคือการสร้างระบบ OCR ภาษาโปรตุเกสแบบบราซิลที่มีประสิทธิภาพสูงสุด ด้วยต้นทุนและเวลาที่ต่ำที่สุด
เครื่องมือที่ทันสมัยไม่ได้ทำให้ความเชี่ยวชาญหมดความสำคัญลง แต่มันช่วยขยายขอบเขตความสำเร็จของความเชี่ยวชาญนั้นให้กว้างไกลกว่าเดิม
Source
- Cardoso, Gabriel Pimenta de Freitas, et al. "DharmaOCR: Specialized Small Language Models for Structured OCR that outperform Open-Source and Commercial Baselines." arXiv preprint arXiv:2604.14314 (2026).
Further Reading
- Why Specialization Is Inevitable — รากฐานเชิงโครงสร้างของความเชี่ยวชาญเฉพาะด้านที่ชนะความครอบคลุมภายใต้ทรัพยากรที่จำกัด
- Specialization Beats Scale: A Strategic Variable Most AI Procurement Decisions Overlook — บทวิเคราะห์ว่าทำไมความเชี่ยวชาญจึงมีประสิทธิภาพดีกว่าในทางปฏิบัติ และทำไมตลาดยังคงประเมินค่ามันต่ำไป
- Text Degeneration: A Production Failure Mode That Most Benchmarks Do Not Track — เจาะลึกความล้มเหลวแบบการเสื่อมโทรมของข้อความในโมเดลภาษา
- Direct Preference Optimization Beyond Chatbots — การใช้เทคนิค DPO ในโดเมนเฉพาะทางเพื่อประสิทธิภาพที่เหนือกว่า
เข้าไปที่ Dharma AI on Hugging Face เพื่อ ลองใช้ตัวอย่างปฏิสัมพันธ์ของเรา, ดาวน์โหลดโมเดลโอเพนซอร์สของเรา, และร่วมค้นหาว่าทำไมระบบ AI เฉพาะด้านถึงตอบโจทย์การใช้งานระดับองค์กรได้ดีที่สุด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร