tag: RAG

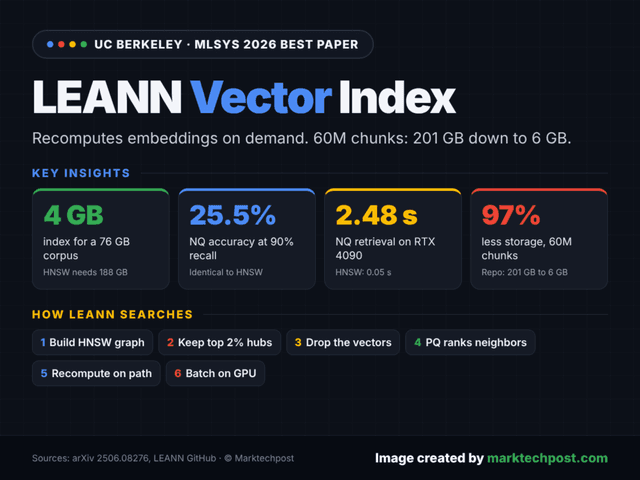
รู้จัก LEANN: Vector Index ชูจุดเด่นลดพื้นที่จัดเก็บ RAG ได้ถึง 97%

รู้จัก LEANN: Vector Index ชูจุดเด่นลดพื้นที่จัดเก็บ RAG ได้ถึง 97%

· By: NatapolK
ทีมนักวิจัย UC Berkeley พัฒนา LEANN Vector Index โอเพนซอร์สที่ลดขนาดดัชนีข้อมูลจาก 201 GB เหลือเพียง 6 GB โดยใช้วิธีคำนวณ Embedding ใหม่ขณะค้นหา เพื่อการใช้งานบนแล็ปท็อป
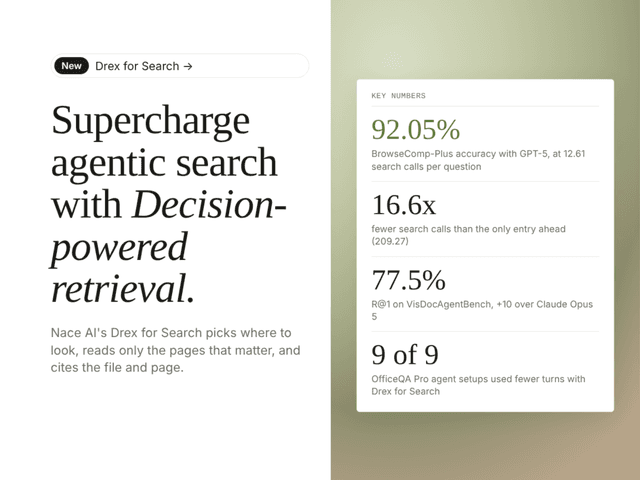
Nace AI เปิดตัว Drex for Search ยกระดับ AI Agents ค้นหาแม่นยำ 92.05%

Nace AI เปิดตัว Drex for Search ยกระดับ AI Agents ค้นหาแม่นยำ 92.05%

· By: SirilukP
Nace AI เปิดตัว Drex for Search เลเยอร์การดึงข้อมูลใหม่สำหรับ AI agents ที่ทำคะแนนแม่นยำสูงถึง 92.05% บน BrowseComp-Plus โดยใช้จำนวนรอบการค้นหาต่ำเพียง 12.6 ครั้ง
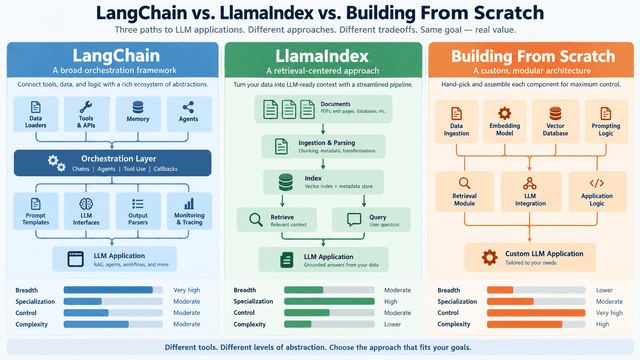
LangChain vs LlamaIndex vs สร้างเอง: เลือกแบบไหนดีสำหรับแอป LLM

LangChain vs LlamaIndex vs สร้างเอง: เลือกแบบไหนดีสำหรับแอป LLM

· By: SirilukP
สรุปแนวทางการเลือกเครื่องมือสำหรับพัฒนาแอปพลิเคชัน LLM ระหว่างการใช้ framework ยอดนิยมกับการเขียนระบบขึ้นเอง เพื่อตอบโจทย์การใช้งานจริงที่มีประสิทธิภาพสูงสุด
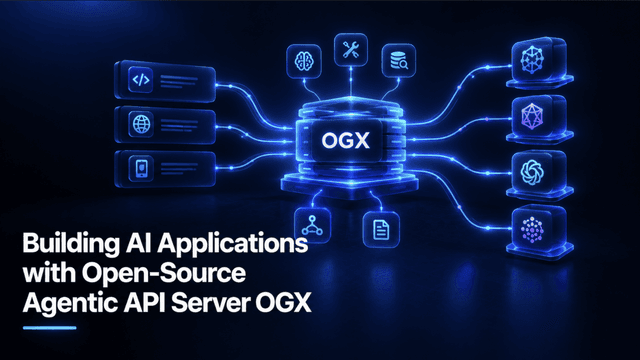
สร้างแอป AI ด้วย OGX: Agentic API Server แบบ Open-Source

สร้างแอป AI ด้วย OGX: Agentic API Server แบบ Open-Source

· By: SirilukP
OGX คือการรีแบรนด์ของ Llama Stack เพื่อเป็น Agentic API Server ที่รองรับมาตรฐาน OpenAI สามารถเชื่อมต่อได้กับทุกโมเดลและโครงสร้างพื้นฐาน พร้อมระบบ RAG ในตัว
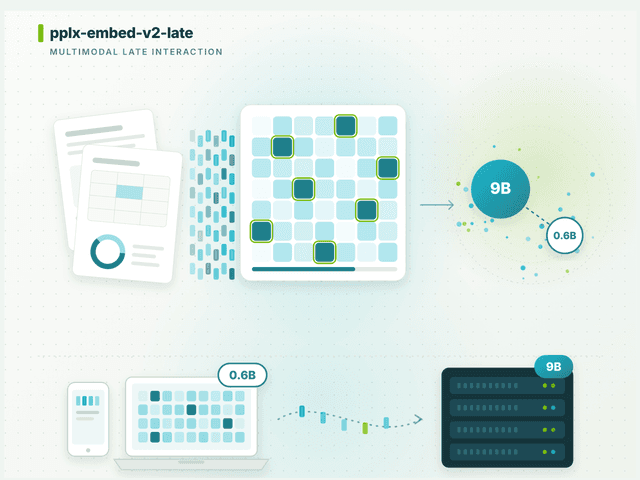
Perplexity เปิดตัว pplx-embed-v2-late โมเดลจิ๋ว 0.6B และ 9B

Perplexity เปิดตัว pplx-embed-v2-late โมเดลจิ๋ว 0.6B และ 9B

· By: TanasakP
Perplexity AI เปิดตัวโมเดล multimodal embedding ชุดใหม่ pplx-embed-v2-late ชูจุดเด่นขนาด 0.6B ที่รันบนอุปกรณ์ edge ได้ และขนาด 9B ที่ทำคะแนน MADQA สูงถึง 92.4% พร้อมแจกฟรีแบบ MIT License
Google เปิดตัว EmbeddingGemma 2 โมเดล Multimodal ขนาดจิ๋ว

Google เปิดตัว EmbeddingGemma 2 โมเดล Multimodal ขนาดจิ๋ว

· By: TanasakP
Google เปิดตัว EmbeddingGemma 2 โมเดล Open Model ขนาดไม่ถึง 1B ที่รองรับการค้นหาข้ามรูปแบบทั้งข้อความ โค้ด ภาพ วิดีโอ และเสียง พร้อมเทคโนโลยีประหยัดพื้นที่จัดเก็บข้อมูล
เปิดตัว EmbeddingGemma 2 โมเดล Multimodal ขนาดเล็กประสิทธิภาพสูง

เปิดตัว EmbeddingGemma 2 โมเดล Multimodal ขนาดเล็กประสิทธิภาพสูง

· By: SirilukP
Google เปิดตัว EmbeddingGemma 2 โมเดล Multimodal Embedding น้ำหนักเบาที่รองรับทั้งข้อความ โค้ด รูปภาพ วิดีโอ และเสียง ออกแบบมาเพื่อการประมวลผลบนอุปกรณ์โดยเฉพาะด้วยพารามิเตอร์เพียง 740 ล้านตัว
Cohere เปิดตัว Embed 5 โมเดล Embedding ประสิทธิภาพสูงเพื่อธุรกิจ

Cohere เปิดตัว Embed 5 โมเดล Embedding ประสิทธิภาพสูงเพื่อธุรกิจ

· By: SirilukP
Cohere เปิดตัว Embed 5 ตระกูลโมเดล Embedding ใหม่ที่รองรับข้อความและรูปภาพในกว่า 100 ภาษา มาพร้อมรุ่น Pro เน้นคุณภาพสูงสุด และรุ่น Fast ที่เน้นความเร็วและประหยัดต้นทุน
Perplexity เปิดตัว pplx-embed-v2-context โมเดล AI ค้นหาแม่นยำกว่าเดิม

Perplexity เปิดตัว pplx-embed-v2-context โมเดล AI ค้นหาแม่นยำกว่าเดิม

· By: TanasakP
Perplexity Research ร่วมกับ turbopuffer เปิดตัวโมเดล Contextual Embedding รุ่นใหม่ pplx-embed-v2-context-9b-preview ที่ออกแบบมาเพื่อดึงข้อมูลในระบบ RAG ได้แม่นยำขึ้น โดยสามารถระบุได้ทั้งคำตอบและบริบทสนับสนุนพร้อมกัน
แนะนำ 5 คอร์สเรียนฟรี ปั้นทักษะวิศวกรรม AI แบบมืออาชีพ

แนะนำ 5 คอร์สเรียนฟรี ปั้นทักษะวิศวกรรม AI แบบมืออาชีพ

· By: SirilukP
เจาะลึก 5 หลักสูตรฟรีครอบคลุมตั้งแต่พื้นฐาน LLM, RAG ไปจนถึง MLOps เพื่อพัฒนาทักษะวิศวกร AI และ Machine Learning ที่ตลาดต้องการ
5 ประเด็นร้อน AI จาก GitHub: อนาคตของ RAG, MCP และการอ่านโค้ด

5 ประเด็นร้อน AI จาก GitHub: อนาคตของ RAG, MCP และการอ่านโค้ด

· By: SirilukP
สรุปประเด็นร้อนวงการ AI จาก GitHub Podcast ตอนล่าสุด ที่จะพาทุกคนไปเจาะลึกข้อถกเถียงยอดฮิต ตั้งแต่อนาคตของ RAG, ระบบ MCP ไปจนถึงความจำเป็นในการตรวจทานโค้ดที่สร้างโดย AI
จาก RAG สู่ Agentic AI: วิวัฒนาการสู่ระบบจัดการความรู้ในองค์กรที่ฉลาดและแม่นยำกว่าเดิม

จาก RAG สู่ Agentic AI: วิวัฒนาการสู่ระบบจัดการความรู้ในองค์กรที่ฉลาดและแม่นยำกว่าเดิม

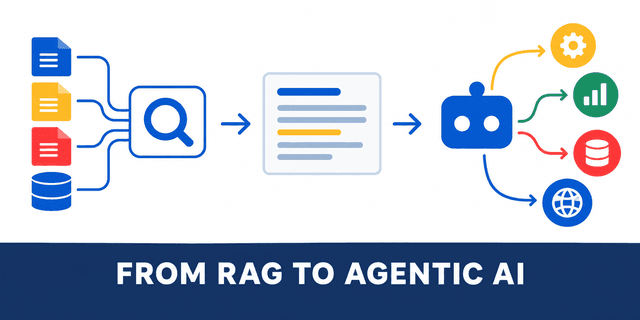
เจาะลึกบทเรียนจากประสบการณ์การสร้างระบบการค้นคืนอัจฉริยะ 3 ยุค เพื่อแก้ไขจุดบอดของ RAG แบบเดิม และแนวทางการสร้าง Agentic AI ที่ตอบโจทย์การใช้งานจริงในระดับองค์กร
Cohere เปิดตัว Parse (v5.0) โมเดล Vision Language 2.3B เปลี่ยนเอกสารองค์กรเป็น Markdown แม่นยำสูง

Cohere เปิดตัว Parse (v5.0) โมเดล Vision Language 2.3B เปลี่ยนเอกสารองค์กรเป็น Markdown แม่นยำสูง

· By: NatapolK
Cohere เปิดตัว Parse (v5.0) โมเดลขนาด 2.3 พันล้านพารามิเตอร์ที่เปลี่ยนไฟล์ PDF สไลด์ และรูปภาพเป็น Markdown พร้อมรองรับตาราง HTML และการระบุพิกัดวัตถุ ในราคาเริ่มต้น 1.50 ดอลลาร์ต่อ 1,000 หน้า
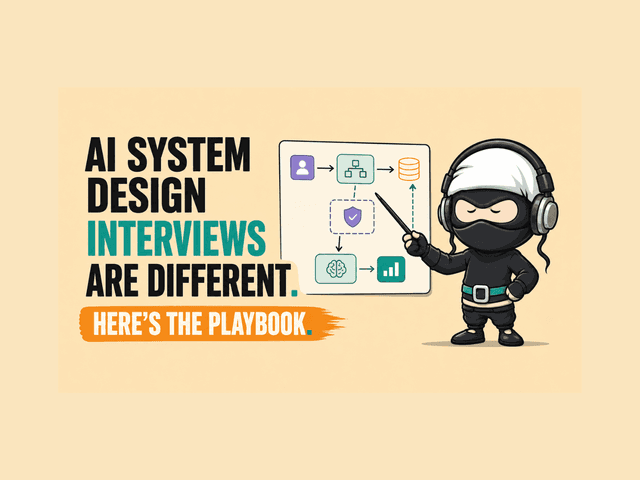
เจาะลึกเฟรมเวิร์กตอบคำถามสัมภาษณ์งาน AI System Design สำหรับวิศวกรรุ่นใหม่

เจาะลึกเฟรมเวิร์กตอบคำถามสัมภาษณ์งาน AI System Design สำหรับวิศวกรรุ่นใหม่

· By: SirilukP
เปลี่ยนจากโจทย์ 'Design YouTube' สู่ 'Design ChatGPT' ด้วยเฟรมเวิร์ก 7 ขั้นตอนเพื่อรับมือการสัมภาษณ์งานในตำแหน่ง AI Engineer และ Applied Scientist อย่างมืออาชีพ
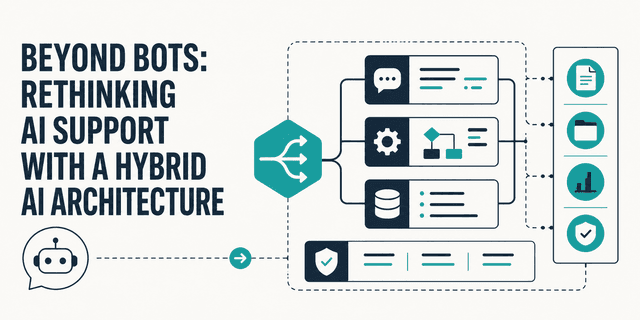
ก้าวข้ามขีดจำกัดบอท: เจาะลึกสถาปัตยกรรม Hybrid AI ที่ผสมผสาน RAG และ Fine-tuning

ก้าวข้ามขีดจำกัดบอท: เจาะลึกสถาปัตยกรรม Hybrid AI ที่ผสมผสาน RAG และ Fine-tuning

· By: SirilukP
การสร้างระบบสนับสนุนด้วย AI ในระดับองค์กรให้มีประสิทธิภาพสูงสุด จำเป็นต้องใช้สถาปัตยกรรมแบบไฮบริดที่แยกส่วน 'ข้อมูล' ออกจาก 'วิธีการตอบ' เพื่อแก้ปัญหาความแม่นยำและโทนเสียงของแบรนด์
7 สุดยอดเครื่องมือและ API สำหรับ Web Crawling แห่งปี 2026

7 สุดยอดเครื่องมือและ API สำหรับ Web Crawling แห่งปี 2026

· By: SirilukP
เจาะลึกเครื่องมือ Web Crawling ชั้นนำสำหรับการดึงข้อมูลเว็บไซต์เพื่อสร้างชุดข้อมูลที่สะอาด รองรับการใช้งาน AI Agents และระบบ RAG อย่างมีประสิทธิภาพ
Pixel-Native RAG: คู่มือสร้างระบบ Indexing เอกสารเชิงภาพแบบครบวงจร

Pixel-Native RAG: คู่มือสร้างระบบ Indexing เอกสารเชิงภาพแบบครบวงจร

· By: NatapolK
เรียนรู้การสร้างระบบ PixelRAG ที่จัดการเอกสาร PDF และหน้าเว็บในรูปแบบรูปภาพโดยไม่ต้องสกัดข้อความ ช่วยเพิ่มประสิทธิภาพการกู้คืนข้อมูลเชิงภาพด้วย Multimodal Embedding และ Hybrid Search
รวม 10 แพลตฟอร์ม AI แบบ No-Code โอเพนซอร์ส สำหรับสร้างแอป LLM, ระบบ RAG และ AI Agents

รวม 10 แพลตฟอร์ม AI แบบ No-Code โอเพนซอร์ส สำหรับสร้างแอป LLM, ระบบ RAG และ AI Agents

· By: TanasakP
แนะนำ 10 แพลตฟอร์มโอเพนซอร์สแบบ No-Code สำหรับสร้างแอปพลิเคชัน LLM ระบบ RAG และ AI Agents ที่ใช้งานง่ายผ่านอินเทอร์เฟซแบบ Visual ช่วยให้ผู้ใช้สามารถโฮสต์ระบบได้เองเพื่อความปลอดภัยของข้อมูล
NVIDIA เปิดตัว Nemotron 3 Embed: คอลเลกชันโมเดล Embedding ประสิทธิภาพสูงรุ่นเปิด ครองอันดับ #1 บน RTEB

NVIDIA เปิดตัว Nemotron 3 Embed: คอลเลกชันโมเดล Embedding ประสิทธิภาพสูงรุ่นเปิด ครองอันดับ #1 บน RTEB

· By: AttapolK
NVIDIA เปิดคอลเลกชัน Nemotron 3 Embed รุ่นใหม่ 3 ขนาด ชูจุดเด่นรุ่น 8B ครองอันดับหนึ่งบน Benchmark RTEB และรุ่น 1B-NVFP4 ที่ออกแบบมาเพื่อชิป Blackwell โดยเฉพาะ พร้อมรองรับ input ยาวสูงสุด 32,768 token
12 วิธีลด Latency และต้นทุนการรัน LLM ในระดับ Production อย่างมีประสิทธิภาพ

12 วิธีลด Latency และต้นทุนการรัน LLM ในระดับ Production อย่างมีประสิทธิภาพ

· By: SirilukP
การปรับสเกล LLM ไม่ใช่แค่การอัด GPU แต่คือการตัดงานส่วนเกินในทุกคำสั่ง เพื่อลดระยะเวลารอคอยและค่าใช้จ่ายในการประมวลผล